Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Important
Dieses Feature befindet sich in der Betaversion. Kontoadministratoren können den Zugriff auf diese Funktion über die Kontokonsolen-Vorschauenseite über den Umschalter "Umgebungen für Standard Compute " steuern. Siehe Manage Azure Databricks Previews.
Auf einer klassischen Compute-Ressource, die den Environments-Abhängigkeitsmodus verwendet, verwaltet man Abhängigkeiten auf Workload-Ebene mit Basisumgebungen , anstatt compute-scoped-Bibliotheken zu installieren.
Umgebungseinstellungen bleiben von Änderungen auf Rechenebene isoliert, sodass Workloads nicht brechen, wenn sich die Rechenleistung darunter ändert. Und da Azure Databricks Basisumgebungen cachet, lösen und installieren sich Abhängigkeiten nicht beim Start, sodass die Rechenleistung schneller startet und Fehler bei der Paketauflösung, der Verfügbarkeit des Repositoriums oder der Netzwerkzuverlässigkeit vermieden werden.
In einem Notizbuch, das an eine klassische Compute-Ressource angeschlossen ist, die den Environments-Abhängigkeitsmodus nutzt, wählen Sie eine Basisumgebung aus und fügen Abhängigkeiten aus dem Environment-Seitenfenster des Notizbuchs hinzu. Für Jobaufgaben konfigurieren Sie Abhängigkeiten mit einer Jobumgebungsspezifikation.
Anforderungen
Die Einstellung für den Abhängigkeitsmodus ist nur für Compute-Ressourcen verfügbar, die die folgenden Anforderungen erfüllen:
- Databricks Runtime 19 (Beta) oder höher
- Standard-Zugangsmodus
- All-Purpose Compute oder klassisches Jobs Compute
Für Unterstützungsdetails siehe Einschränkungen.
Setzen Sie den Abhängigkeitsmodus ein
Um eine klassische Compute-Ressource zu erstellen, die den Abhängigkeitsmodus Environments verwendet:
Klicken Sie in der Seitenleiste des Arbeitsbereichs auf das
 Compute und öffnen Sie dann den Reiter Allzweck-Compute .
Klicken Sie auf "Compute erstellen".
Wählen Sie unter Performance19 Beta oder höher im Databricks Runtime-Versions-Dropdown-Menü aus.
Erweitern Sie den Abschnitt Erweitert und klicken Sie dann auf Abhängigkeiten.
Für den Abhängigkeitsmodus lassen Sie Auto aktiviert, damit Azure Databricks den Modus auflösen kann, oder klicken Sie auf Manuell und wählen Sie Umgebungen, um ihn selbst einzustellen. Siehe Abhängigkeitsmodus-Optionen.
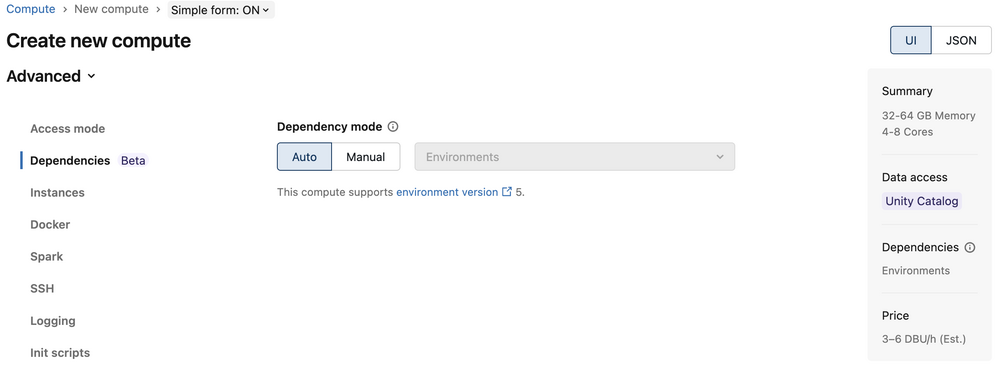
Konfigurieren Sie den Rest der Berechnung und klicken Sie dann auf Erstellen.
Nachdem die Berechnung ausgeführt ist, hängen Sie ein Notizbuch an und konfigurieren Sie seine Umgebung wie beschrieben in "Umfelder im Notizbuch verwenden".
Abhängigkeitsmodus-Optionen
Die Abhängigkeitsmodus-Steuerung hat zwei Einstellungen, die bestimmen, wie der Modus gewählt wird:
- Auto: Azure Databricks bestimmt den Modus anhand der Rechenkonfiguration. Wird automatisch in Umgebungen aufgelöst, es sei denn, der Compute spezifiziert Docker, Spark-Umgebungsvariablen oder Init-Skripte, in diesem Fall wird er in Cluster-Bibliotheken aufgelöst.
- Handbuch: Du wählst selbst Umgebungen oder Cluster-Bibliotheken aus.
Wenn du Manuell auswählst, wähle den Modus, der zu deinen Bedürfnissen passt:
- Umgebungen: Verwalten Sie Abhängigkeiten auf Arbeitslastebene mithilfe von Basisumgebungen. Cluster-Bibliotheken, Docker, Spark-Umgebungsvariablen und Init-Skripte sind deaktiviert. Nutzen Sie diesen Modus, um Abhängigkeiten für jede Arbeitslast zu isolieren.
- Cluster-Bibliotheken: Das klassische Verhalten. Installieren Sie Abhängigkeiten von der Berechnung mit Cluster-Bibliotheken, Init-Skripten oder Docker. Nutze diesen Modus, wenn deine Arbeitsbelastung eine dieser Einstellungen erfordert.
Aktualisieren Sie eine bestehende Berechnung
Wenn Sie die Einstellungen für bestehende Rechenleistungen bearbeiten, ist der Wechsel in den Umgebungsmodus blockiert, wenn die Berechnung inkompatible Einstellungen wie Init-Skripte, Cluster-Bibliotheken oder Docker hat. Wenn du zuerst die inkompatiblen Einstellungen entfernst, kannst du dann den Abhängigkeitsmodus bearbeiten.
Wenn Sie vom Umgebungsmodus in den Cluster-Bibliotheksmodus wechseln, behalten die angeschlossenen Notizbücher ihre Umgebungsauswahlen, aber diese werden inaktiv. Wenn du die Berechnung wieder auf den Umgebungsmodus zurückstellst, werden diese Auswahlen wieder aktiv.
Nutze Umgebungen in einem Notizbuch
Um Umgebungen in einem Notizbuch zu nutzen, hängen Sie das Notizbuch an eine klassische Compute-Ressource an, die den Environments-Abhängigkeitsmodus verwendet. Nachdem du das Notizbuch angefügt hast, konfiguriere die Abhängigkeiten des Notizbuchs im Seitenbereich „Umgebung“ .
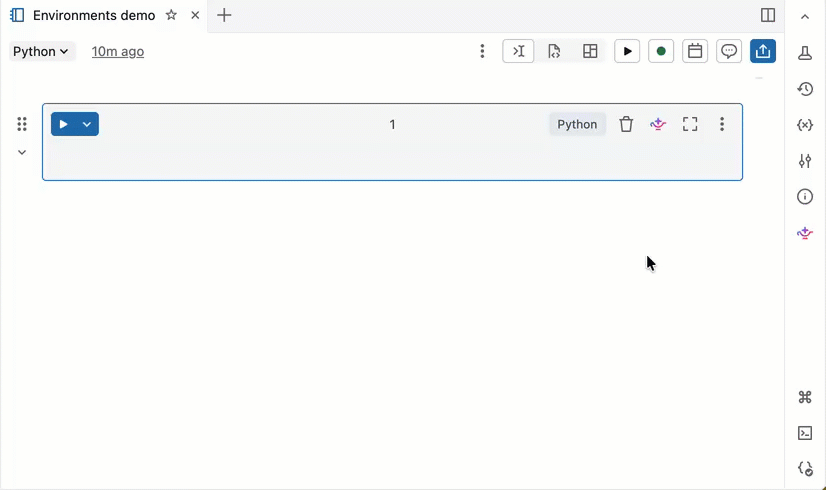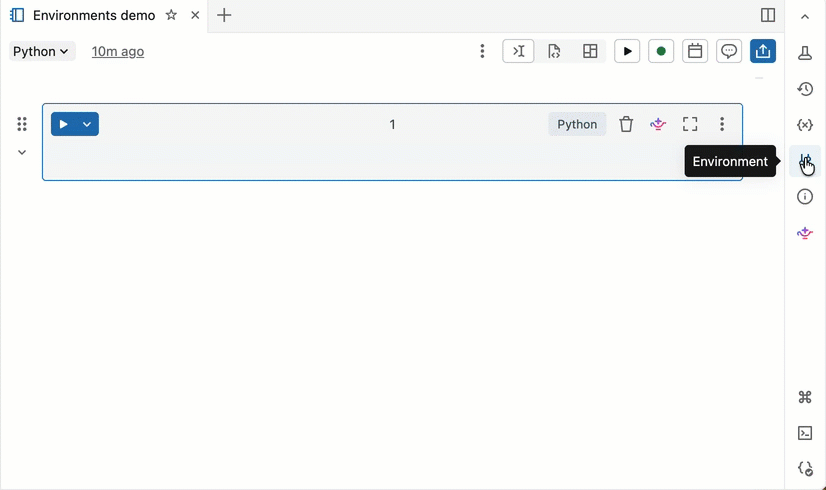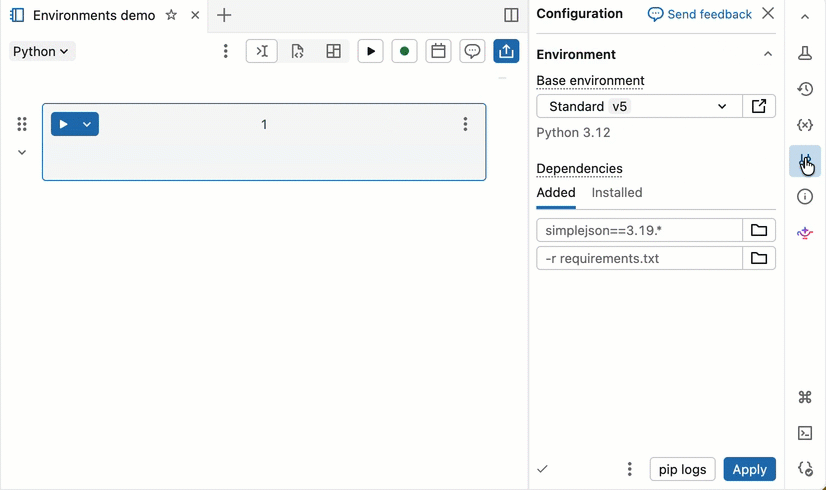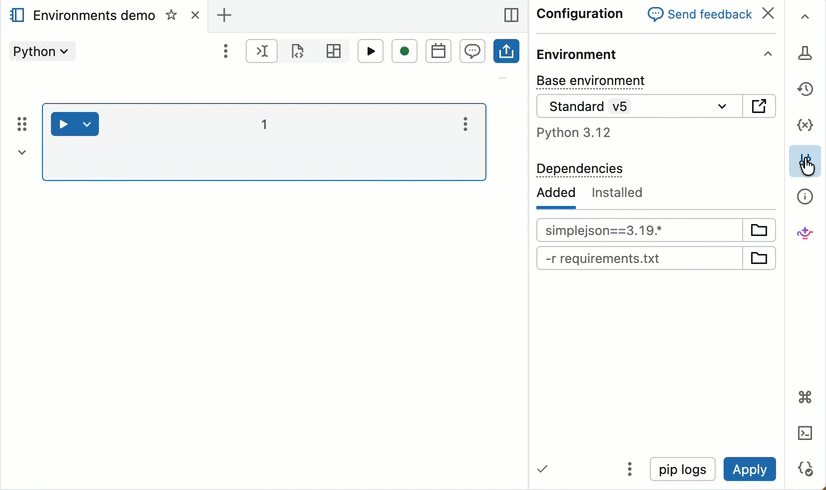
Wählen Sie eine Basisumgebung aus
Eine Basisumgebung bestimmt die vorinstallierten Bibliotheken und die Umgebungsversion, die für dein Notizbuch verfügbar sind. Die Basisumgebungsauswahl im Seitenbereich "Umgebung " ist der Ort, an dem Sie Ihre Umgebung auswählen. Databricks empfiehlt die Verwendung der neuesten Version, um die meisten up-to-date-Notizbuchfunktionen zu erhalten. Um Details zu jeder Umgebungsversion zu sehen, siehe Umgebungsversionen.
Die Auswahl der Basisumgebung umfasst die folgenden Optionen:
- Standard: Die Standardbasisumgebung mit von Databricks bereitgestellten Bibliotheken.
- ML: Eine Basisumgebung mit den Python und Systempaketen von Databricks Runtime für Machine Learning vorinstalliert.
-
Weitere Optionen: Erweitert, um weitere Optionen anzuzeigen:
- Frühere Versionen von Standard- und ML-Umgebungen.
- Benutzerdefiniert: Geben Sie eine benutzerdefinierte Umgebung mithilfe einer YAML-Datei an.
- Arbeitsumgebungen: Listet alle kompatiblen Basisumgebungen auf, die von Arbeitsflächenadministratoren für Ihren Arbeitsbereich konfiguriert wurden.
Hinzufügen von Abhängigkeiten zum Notizbuch
Azure Databricks die virtuelle Umgebung Ihres Notizbuchs zwischenspeichert, sodass Abhängigkeiten nicht jedes Mal neu installiert werden, wenn Sie ein Notizbuch erneut öffnen oder nach inaktivität fortsetzen.
So installieren Sie eine Abhängigkeit einzeln:
Im Abschnitt Abhängigkeiten geben Sie den Pfad der Abhängigkeit im Feld ein und klicken dann auf +Abhängigkeit hinzufügen. Sie können eine Abhängigkeit in einem beliebigen Format angeben, das in einer Datei vom Typ requirements.txt gültig ist. Python-Wheel-Dateien oder Python-Projekte (z. B. das Verzeichnis mit einem
pyproject.tomloder einemsetup.py) können sich in Arbeitsbereichsdateien oder Unity-Katalog-Volumen befinden.- Wenn Sie eine Datei des Arbeitsbereichs verwenden, sollte der Pfad absolut sein und mit
/Workspace/beginnen. - Wenn Sie eine Datei in einem Unity-Katalogvolume verwenden, sollte der Pfad im folgenden Format vorliegen:
/Volumes/<catalog>/<schema>/<volume>/<path>.whl
- Wenn Sie eine Datei des Arbeitsbereichs verwenden, sollte der Pfad absolut sein und mit
Klicken Sie auf Apply, um die Abhängigkeiten zu installieren und den Python Prozess neu zu starten.
Important
Installiere PySpark oder irgendeine Bibliothek, die PySpark als Abhängigkeit von deinen Notizbüchern installiert, nicht. Das Ausführen dieser Aktion wird Ihre Sitzung beenden und einen Fehler verursachen. Tritt dies auf, entfernen Sie die Bibliothek und setzen Sie Ihre Umgebung zurück.
Um installierte Abhängigkeiten anzuzeigen, klicken Sie auf den Reiter Installiert im Seitenfenster Umgebung . Öffnen Sie die pip-Installationsprotokolle für die Notebook-Umgebung, indem Sie am unteren Rand des Bereichs auf pip-Logs klicken.
Nutze Umgebungen in einem Job
Für Job-Aufgaben, die auf einer klassischen Compute-Ressource laufen, die den Environments-Abhängigkeitsmodus nutzt, konfigurieren Sie Abhängigkeiten mit einer Job-Umgebungsspezifikation. Eine Jobumgebung spezifiziert eine Basisumgebung und alle zusätzlichen Abhängigkeiten, auf die eine oder mehrere Aufgaben verweisen können.
Um eine Umgebung für eine Job-Aufgabe zu konfigurieren, führen Sie die folgenden Schritte durch:
- Erstellen oder bearbeiten Sie eine Aufgabe in einem Job.
- Wählen Sie unter Compute eine bestehende klassische Compute-Ressource aus, die den Environments-Abhängigkeitsmodus verwendet, oder fügen Sie Classic Jobs Compute hinzu.
- Wenn Sie klassisches Jobs Compute hinzufügen, erweitern Sie Erweitert.
- Klicken Sie auf Abhängigkeiten.
- Für Abhängigkeitsmodus wählen Sie Manuell und Umgebungen oder behalten Sie Auto bei, wenn dies zu Umgebungen aufgelöst wird.
- Unter Environment and Libraries in der Aufgabenkonfiguration konfigurieren Sie eine Umgebung für die Aufgabe. Siehe Umgebung konfigurieren für Job-Aufgaben für die verfügbaren Optionen für jeden Aufgabentyp.
Aufgaben, die auf einer klassischen Computeressource ausgeführt werden, die den Abhängigkeitsmodus Environments verwendet, unterstützen die Aufgabeneinstellung Abhängige Bibliotheken nicht. Fügen Sie stattdessen Abhängigkeiten in die Umgebung hinzu.
Einschränkungen
Der Environments-Abhängigkeitsmodus unterstützt Python-Workloads und Abhängigkeiten in interaktiven Notizbüchern und Job-Aufgaben. Es gelten die folgenden Einschränkungen:
- Spark JAR-Aufgaben werden auf einer klassischen Compute-Ressource, die den Environments-Abhängigkeitsmodus nutzt, nicht unterstützt.
- Das Ausführen des
%scalaCodes schlägt fehl. - Alle Standard-Zugriffsmodus-Einschränkungen gelten, einschließlich der fehlenden Unterstützung für R. Siehe Standard-Rechenanforderungen und -beschränkungen.
Inkompatible Einstellungen
Wenn der Environments-Abhängigkeitsmodus aktiviert ist, sind die folgenden Recheneinstellungen deaktiviert:
- Docker (Azure Databricks Container Services)
- Spark-Umgebungsvariablen
- Initialisierungsskripte
- Clusterbibliotheken