Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Diese Seite beschreibt, wie man Daten mit SQL- und Spark-APIs in Databricks Lakeflow Connect aufnimmt, die höhere Anpassungsmöglichkeiten für die Aufnahmepipeline bieten als die verwalteten Connectors. Nutzen Sie es, um einen Ingestionsansatz nach Datenquelle und Grad der Pipeline-Anpassung zu wählen.
Ebenen des ETL-Stapels
Einige Verbinder arbeiten auf einer Ebene des ETL-Stapels. Beispielsweise bietet Databricks vollständig verwaltete Connectors für Unternehmensanwendungen wie Salesforce und Datenbanken wie SQL Server. Andere Verbinder funktionieren auf mehreren Ebenen des ETL-Stapels. Zum Beispiel kannst du SQL- und Spark-APIs entweder im Structured Streaming für vollständige Anpassung oder in Lakeflow-Pipelines für ein besser verwaltetes Erlebnis verwenden.
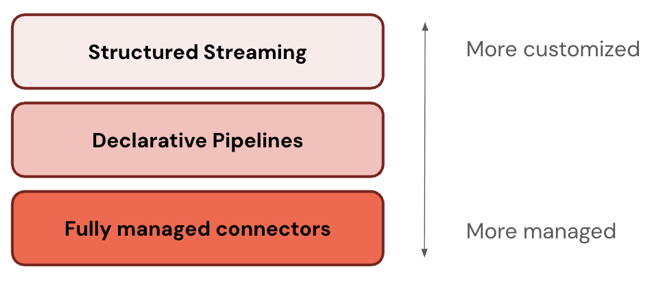
Databricks empfiehlt, mit der am häufigsten verwalteten Ebene zu beginnen. Wenn dies Ihre Anforderungen nicht erfüllt (z. B. wenn Ihre Datenquelle nicht unterstützt wird), gehen Sie zur nächsten Ebene.
In der folgenden Tabelle werden die drei Ebenen der Aufnahmeprodukte beschrieben, sortiert von den meisten anpassbaren bis zu den meisten verwalteten Produkten:
| Ebene | BESCHREIBUNG |
|---|---|
| Strukturiertes Streaming | Apache Spark Structured Streaming ist eine Streaming-Engine, die End-to-End-Fehlertoleranz mit Garantien für genau eine Verarbeitung unter Verwendung von Spark-APIs bietet. |
| Lakeflow-Pipelines | Lakeflow-Pipelines erweitern strukturiertes Streaming und bieten ein deklaratives Framework zum Erstellen von Datenpipelines. Sie können die Transformationen definieren, die für Ihre Daten ausgeführt werden sollen, und Lakeflow-Pipelines verwalten Orchestrierung, Überwachung, Datenqualität, Fehler und vieles mehr. Sie bieten mehr Automatisierung und weniger Aufwand als strukturiertes Streaming. |
| Verwaltete Connectors | Vollständig verwaltete Konnektoren basieren auf Lakeflow-Pipelines und bieten ein noch höheres Maß an Automatisierung für die beliebtesten Datenquellen. Sie erweitern Lakeflow-Pipelines-Funktionen, um auch quellspezifische Authentifizierung, CDC, Edge case Handling, langfristige API-Wartung, automatisierte Wiederholungen, automatisierte Schemaentwicklung usw. zu umfassen. Daher bieten sie noch mehr Automatisierung für alle unterstützten Datenquellen. |
Option wählen
Die folgende Tabelle listet SQL- und Spark-Aufnahmeoptionen nach Datenquelle und Niveau der Pipeline-Anpassung auf. Verwenden Sie für ein vollständig automatisiertes Erfassungserlebnis stattdessen verwaltete Connectors.
SQL-Beispiele für die inkrementelle Erfassung von Cloudobjektspeichern verwenden CREATE STREAMING TABLE Syntax. Es bietet SQL-Nutzern eine skalierbare Ingestionserfahrung und ist daher die empfohlene Alternative zu COPY INTO.
| Quelle | Weitere Anpassungen | Einige Anpassungen | Mehr Automatisierung |
|---|---|---|---|
| Cloudobjektspeicher |
Automatisches Laden mit strukturiertem Streaming (Python, Scala) |
Auto Loader mit Lakeflow-Pipelines (Python, SQL) |
Automatisches Laden mit Databricks SQL (SQL) |
| SFTP-Server |
Aufnehmen von Dateien von SFTP-Servern (Python, SQL) |
N/A | N/A |
| Apache Kafka |
Strukturiertes Streaming mit Kafka-Quelle (Python, Scala) |
Lakeflow-Pipelines mit Kafka-Quelle (Python, SQL) |
Databricks SQL mit Kafka-Quelle (SQL) |
| Google Pub/Sub (Nachrichtendienst) |
Strukturiertes Streaming mit Pub/Sub-Quelle (Python, Scala) |
Lakeflow-Pipelines mit Pub/Sub-Quelle (Python, SQL) |
Databricks SQL mit Pub/Sub-Quelle (SQL) |
| Apache-Pulsar |
Strukturiertes Streaming mit Pulsar-Quelle (Python, Scala) |
Seeflussleitungen mit Pulsarquelle (Python, SQL) |
Databricks SQL mit Pulsar-Quelle (SQL) |
Erfassungszeitpläne
Sie können Aufnahmepipelines so konfigurieren, dass sie in einem wiederkehrenden Zeitplan oder kontinuierlich ausgeführt werden.
| Anwendungsfall | Pipelinemodus |
|---|---|
| Batcherfassung | Ausgelöst: Verarbeitet neue Daten gemäß einem Zeitplan oder bei manueller Auslösung. |
| Streamingerfassung | Fortlaufend: Verarbeitet neue Daten, sobald sie in der Quelle eintreffen. |