Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Das sdp-meta Projekt aus Databricks Labs bietet Tools zum Generieren von Pipelines aus Metadaten, die Sie verwalten.
Note
Das Open Source SDP-Meta-Projekt existiert, wie alle Projekte im Databrickslabs GitHub-Konto, ausschließlich zu Erkundungszwecken. Azure Databricks unterstützt dies nicht und bietet hierfür keine Dienstgütevereinbarungen (Service Level Agreements, SLAs). Reichen Sie keine Azure Databricks-Supporttickets bei Problemen im Zusammenhang mit diesem Projekt ein. Stattdessen erstellen Sie ein GitHub-Issue, das geprüft wird, wenn es die Zeit erlaubt.
Was ist SDP-Meta?
Lakeflow-Pipelines ermöglichen es Ihnen, eine Tabelle deklarativ anzugeben und einen Fluss in einer Pipeline zu generieren, die die Tabelle erstellt und bei Änderungen der Quelldaten auf dem neuesten Stand hält. Wenn Ihre Organisation jedoch Hunderte von Tabellen hat, ist das Generieren und Verwalten dieser Pipelines zeitaufwändig und kann zu inkonsistenten Praktiken führen.
Das sdp-meta-Projekt ist ein metadatenbasiertes Metaprogrammierungs-Framework, das für die Arbeit mit Lakeflow-Pipelines entwickelt wurde. Dieses Framework ermöglicht die Automatisierung von Bronze- und Silberdatenpipelinen, indem Metadaten in einer Reihe von JSON- und YAML-Dateien genutzt werden. Zur Laufzeit lesen generische Pipelines deine Metadaten und bauen dynamisch die darin beschriebenen Flows auf. Bronze- und Silberverarbeitung kann in getrennten Pipelines oder gemeinsam in einer kombinierten Pipeline durchgeführt werden. Du erstellst die Metadaten über deine Pipelines, und SDP-Meta generiert deine Pipelines.
Mit ihrer zentralen Logik (metadaten) ist Ihr System schneller, wiederverwendbar und einfacher zu verwalten.
Note
Das sdp-meta-Projekt hieß dlt-metafrüher , nach der älteren Funktion Delta Live Tables in Azure Databricks.
Delta Live Tables wurde durch Lakeflow-Pipelines ersetzt, und sdp-meta arbeitet mit Lakeflow-Pipelines zusammen. Wenn du eine bestehende dlt-meta Installation aufrüstest, sieh dir die Migrationsanleitung in der SDP-Meta-Dokumentation an.
Vorteile von SDP-Meta
Es gibt zwei Hauptanwendungsfälle für SDP-Meta:
- Eine große Anzahl von Tabellen einfach erfassen und bereinigen.
- Erzwingen Sie Datentechnikstandards für mehrere Pipelines und Benutzer.
Die Vorteile der Verwendung eines metadatengesteuerten Ansatzes umfassen:
- Die Verwaltung von Metadaten kann ohne Kenntnisse von Python- oder SQL-Code erfolgen.
- Die Verwaltung von Metadaten anstelle des Codes erfordert weniger Mehraufwand und reduziert Fehler.
- Der Code wird von sdp-meta generiert, bleibt also konsistent und enthält weniger benutzerdefinierten Code über Pipelines und veröffentlichte Tabellen hinweg.
- Sie können Tabellen ganz einfach in Pipelines innerhalb der Metadaten gruppieren und so die Anzahl der Pipelines generieren, die erforderlich sind, um Ihre Daten am effizientesten zu aktualisieren.
Wie SDP-Meta funktioniert
Das folgende Bild zeigt einen Überblick über das SDP-Meta-System:
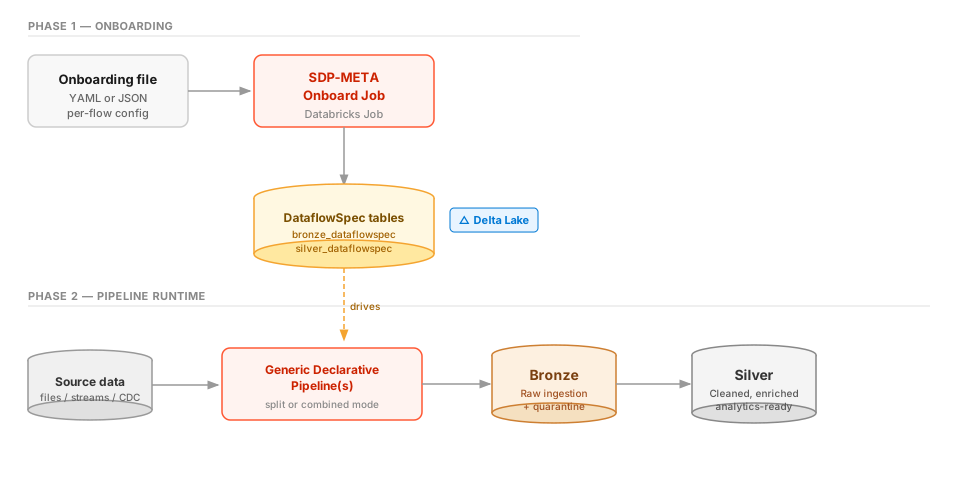
- Du erstellst die Metadatendateien als Eingabe für SDP-Meta, um deine Quelldateien und Ausgaben, Qualitätsregeln und erforderliche Verarbeitung zu spezifizieren. Diese Onboarding-Dateien können in JSON oder YAML geschrieben werden.
- Du führst den sdp-meta Onboarding-Job aus. Die Engine kompiliert die Onboarding-Dateien zu einer Datenfluss-Spezifikation, genannt DataflowSpec, und speichert sie in Delta-Tabellen (
bronze_dataflowspecundsilver_dataflowspec) für die spätere Nutzung. - Während der Laufzeit liest eine generische Pipeline die DataflowSpec und baut dynamisch den Bronze-Verarbeitungsgraphen auf. Es liest deine Quelldaten (Dateien, Streams oder CDC) und wendet die richtigen Datenerwartungen an, um deinen Qualitätsregeln zu entsprechen, generiert deine Bronze-Tabellen und quarantäniert Datensätze, die diese Regeln nicht erfüllen.
- Silver-Verarbeitung kann in einer separaten generischen Pipeline laufen, die standardmäßig für Deklarative Automatisierungsbündel ist, oder in derselben Pipeline, wenn du den kombinierten Modus verwendest. Die Pipeline nutzt die DataflowSpec, um die entsprechenden Transformationen und weiteren Verarbeitungsschritte anzuwenden, wodurch Silbertabellen erzeugt werden, die bereinigt, angereichert und für Analysen bereit sind.
Du führst die von sdp-meta generierten Pipelines aus, um den Output auf dem neuesten Stand zu halten, wenn deine Quelldaten aktualisiert werden.
Get started
Um sdp-meta zu verwenden, musst du:
- Deploye und konfiguriere die SDP-Meta-Lösung.
- Bereiten Sie die Metadaten für Ihre Bronze- und Silberschichttabellen vor.
- Erstellen Sie einen Einzelvorgang zum Onboarding der Metadaten.
- Verwenden Sie die Metadaten, um Pipelines für Ihre Tabellen zu erstellen.
Das SDP-Meta-Projekt unterstützt mehrere Bereitstellungsschnittstellen: Bundles (empfohlen), eine interaktive CLI, eine Databricks-App mit browserbasierter GUI, einen MCP-Server für KI-unterstützte Einrichtung und eine portable Agent Skill für skill-bewusste KI-Agenten.
Die SDP-Meta-Dokumentation auf GitHub enthält ein Tutorial, das dir hilft, mit diesem Prozess zu beginnen. Weitere Informationen finden Sie unter "Start mit sdp-meta" auf GitHub.