Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Von Bedeutung
Dieses Feature befindet sich in der Public Preview.
AI Runtime integriert sich mit MLflow, um Experimentverfolgung und Observability bereitzustellen. MLflow bietet einen zentralen Ort für die Parameter, Metriken eines Laufs, GPU-Systemmetriken, Logs und Artefakte – egal, ob Sie in einem Notebook entwickeln, eine Arbeitslast mit der databricks air CLI einreichen oder einen Auftrag planen.
Was MLflow bietet
Ein MLflow-Experiment gruppiert verwandte Trainingsläufe, und jeder Durchlauf liefert eine persistente Aufzeichnung der Trainingskonfiguration und der Ergebnisse.
- Kennzahlen und Parameter: Erfassen Sie Trainingsverluste, Bewertungsmetriken, Lernraten und Hyperparameter und vergleichen Sie sie dann über die Läufe hinweg.
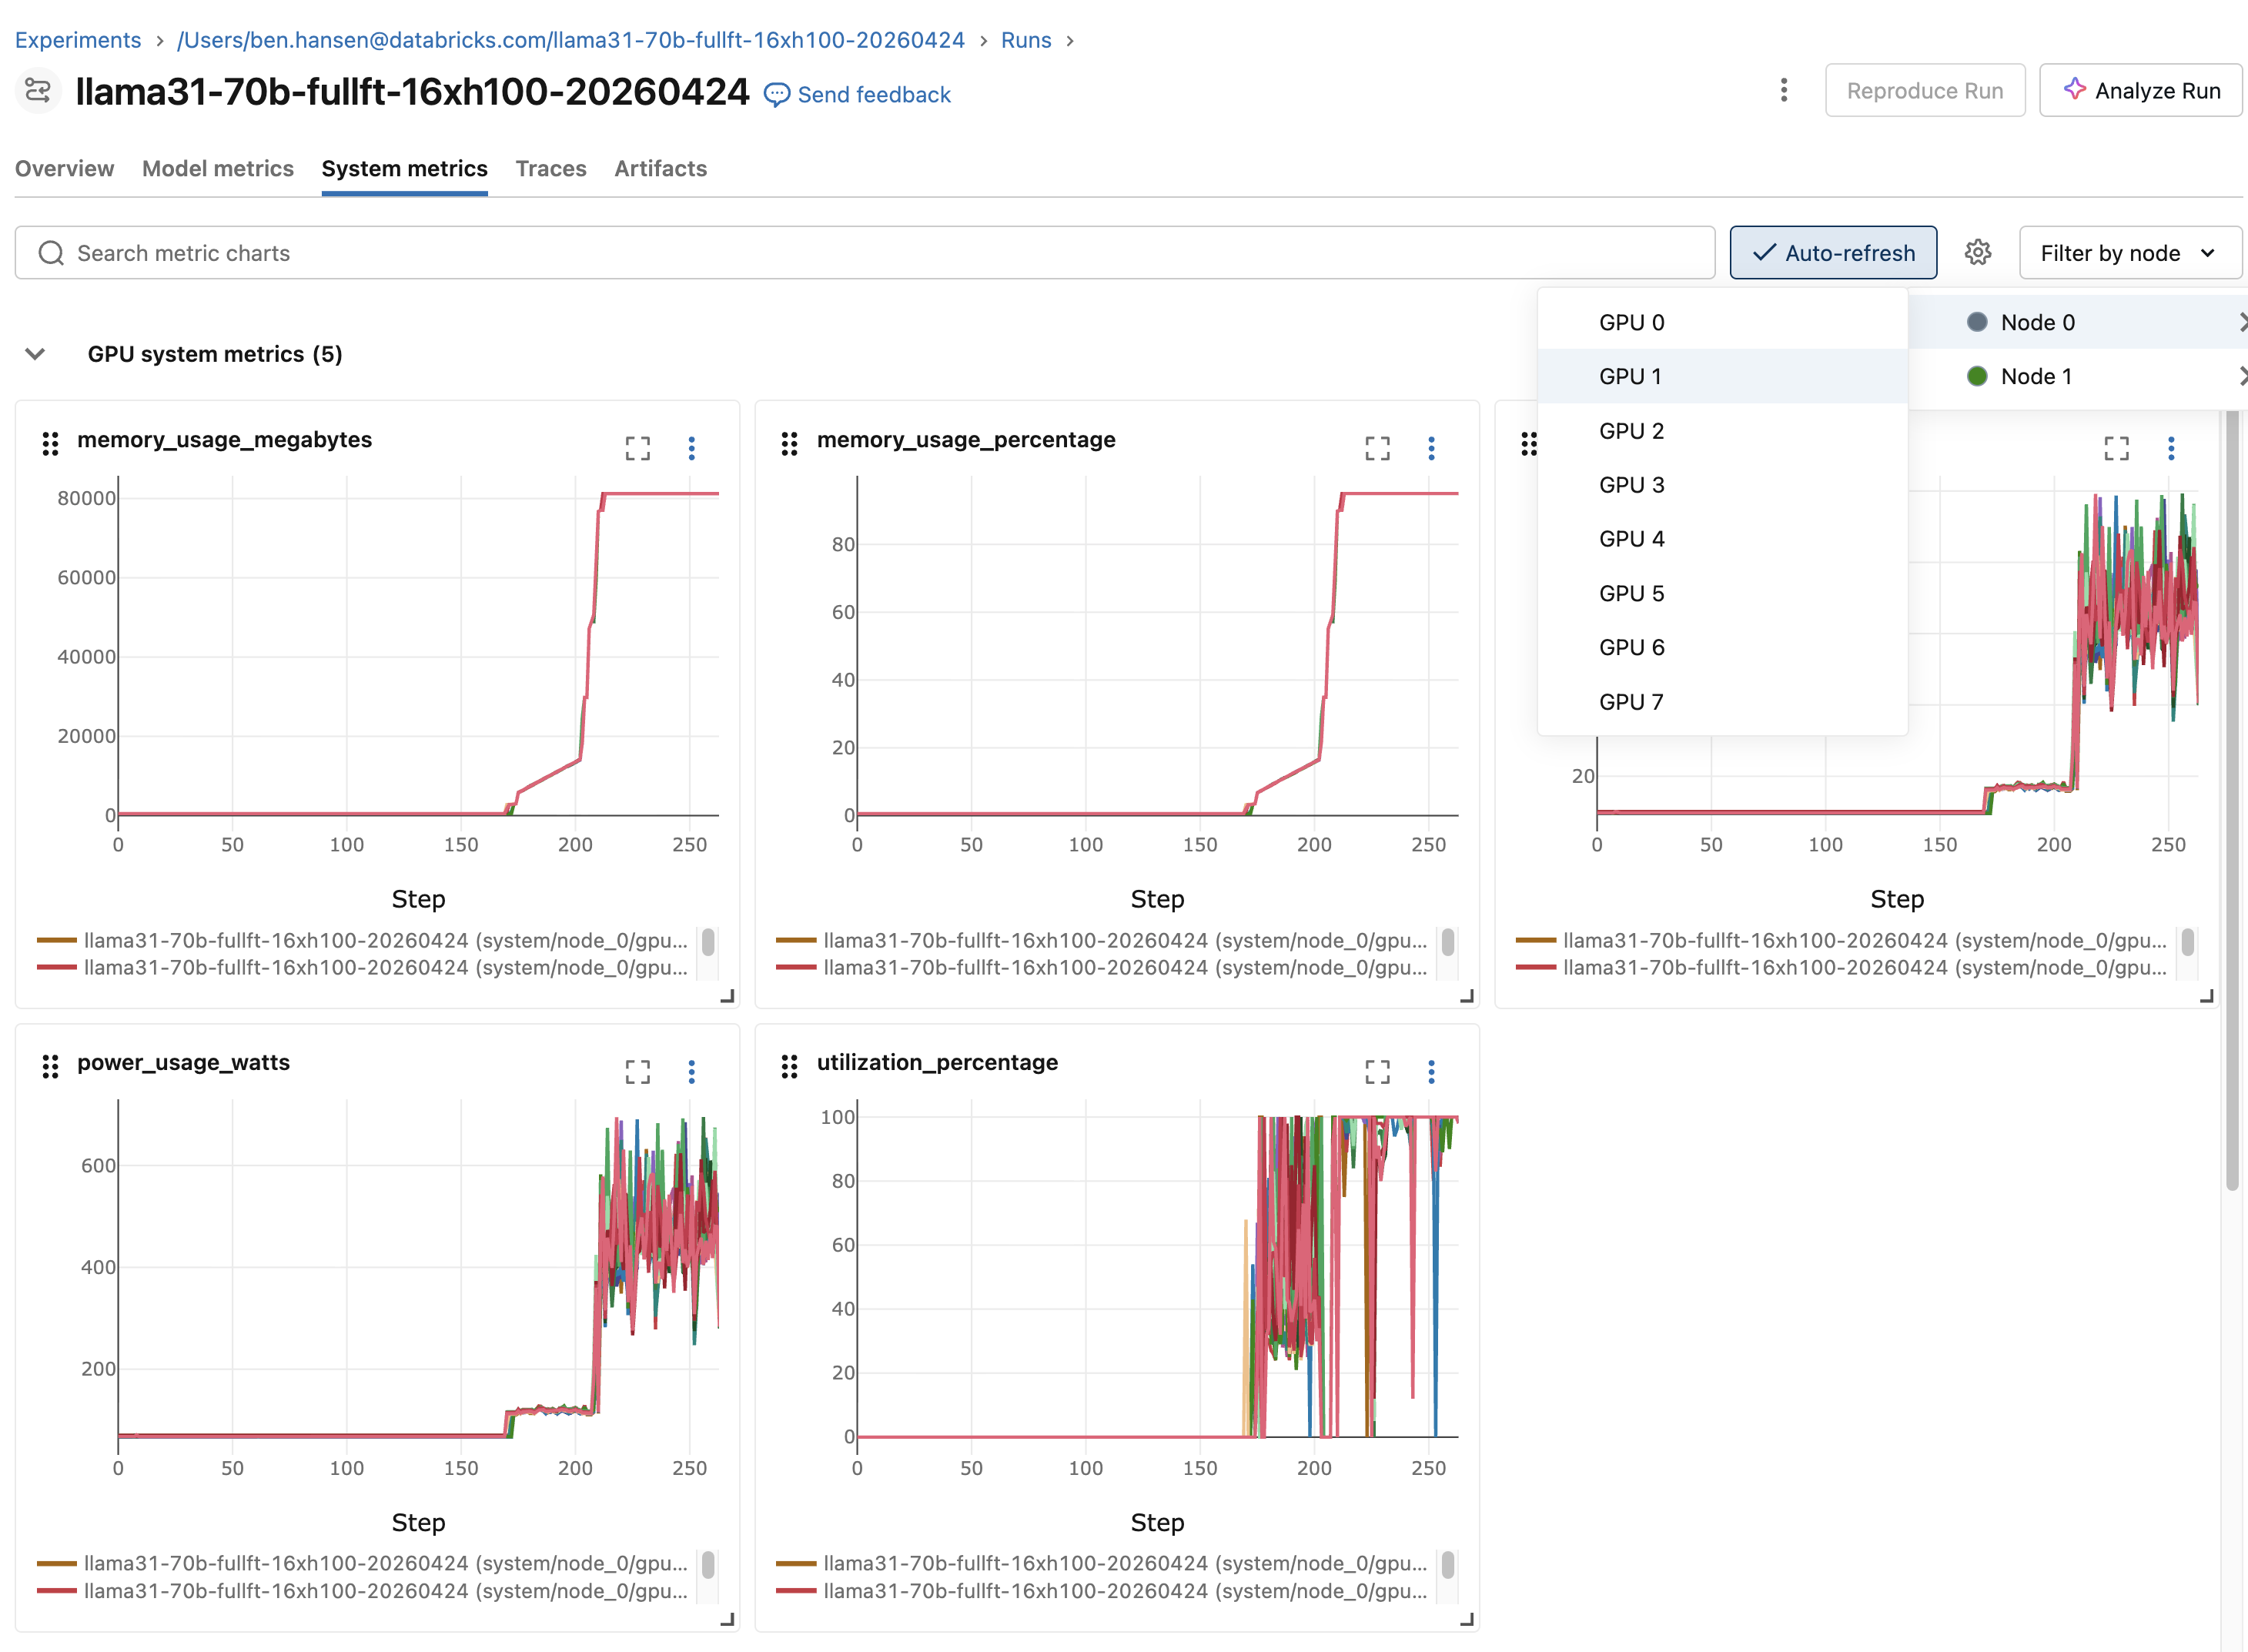
- Systemmetriken: Sehen Sie sich die GPU-, CPU- und Speicherauslastung für verwaltete Läufe auf der Registerkarte Systemmetriken an.
- Logs: Sehen Sie die Treiberausgabe für eine jobgestützte Arbeitslast im Logs-Tab des Laufs an.
- Artefakte und Modelle: Speichern Sie Modelldateien, Konfigurationen und andere Ausgaben mit dem Lauf. Verwenden Sie ein Unity-Katalog-Volume für große oder langlebige Artefakte.
- Freigabe und Zusammenarbeit: Gewähren Sie Zugang zu einem Experiment, damit andere Workspace-Nutzer dessen Läufe ansehen und vergleichen können. Weitere Informationen finden Sie unter Organisieren von Trainingsausführungen mit MLflow-Experimenten.
- Framework-Integrationen: Verwenden Sie MLflow-Integrationen mit Hugging Face Transformers, PyTorch Lightning und anderen unterstützten Bibliotheken.
Für jobgestützte Workloads, wie etwa Workloads, die mit databricks air run eingereicht werden, ergänzt der Azure Databricks-Joblauf MLflow, indem er Ausführungsstatus, Rechenleistung, Versuche und Treiberausgaben aufzeichnet.
Wie MLflow-Läufe erstellt werden
Wie du einen MLflow-Run startest oder daran teilnimmst, hängt davon ab, wie du die Arbeitslast startest:
| Wie du die Workload ausführst | Wie der MLflow-Lauf beginnt | Wie man das Experiment auswählt |
|---|---|---|
Databricks CLI (databricks air run) |
Jeder Versuch erzeugt automatisch eine Ausführung. | Setze experiment_name in der Workload-YAML. |
Notebook mit dem Databricks AI Runtime SDK (.distributed()) |
Jeder Aufruf erzeugt automatisch eine Ausführung. | Ruf mlflow.set_experiment() vor .distributed(), oder setze MLFLOW_EXPERIMENT_NAME. |
| Code läuft direkt in einem angehängten Notebook | Kein Durchlauf wird automatisch erstellt. Nutzen mlflow.start_run() oder autologging. |
Rufe mlflow.set_experiment() im Notebook auf. |
Geplant ai_runtime_task |
Die Aufgabe erstellt automatisch einen Run. | Legen Sie experiment in der Aufgabenkonfiguration fest. Siehe AI Runtime task. |
Nachdem dein Code den richtigen Run startet oder ihm beitritt, nutze die MLflow-Tracking-API, um benutzerdefinierte Trainingsdaten aufzuzeichnen. Für unterstützte Frameworks kann man Autologging verwenden, anstatt einzelne Logging-Aufrufe hinzuzufügen. Zu Deep-Learning-Anwendungsfällen siehe MLflow 3 deep learning workflow.
Verwenden Sie die folgenden Praktiken bei der Konfiguration des MLflow-Trackings:
- Setzen Sie
stepauf einen sinnvollen Wert wie die globale Charge oder Epoche. Protokollieren Sie in Intervallen statt bei jedem Batch. MLflow begrenzt die Anzahl der Metrikschritte pro Run. Sie Ressourceneinschränkungen. - Protokollieren Sie beim verteilten Training eine Metrik nur von Rang 0, sodass jeder Wert einmal aufgezeichnet wird.
- Für Notebook-Workflows verwenden Sie absolute Experimentpfade, wie zum Beispiel
/Users/<username>/my-experimentoder/Workspace/Shared/<team>/my-experiment. Lege Experimente, die du teilen möchtest, in einen Ordner für den gemeinsamen Arbeitsbereich. - Speichern Sie große, langlebige Checkpoints in einem Unity-Katalog-Volume. Für Checkpointing-Muster siehe Trainingsleistung und Resilienz auf AI Runtime verbessern.
Note
Verwenden Sie MLflow 3.7 und höher für die Beispiele auf dieser Seite.
Verfolgen Databricks CLI-Workloads
Wenn Sie einen Workload mit databricks air runeinreichen, erstellt AI Runtime einen Azure-Databricks-Joblauf für Ausführungsdetails und einen MLflow-Lauf für Experimentdaten. Die ursprüngliche Übermittlung und ihre erneuten Versuche teilen sich einen Job-Run, während jeder Versuch einen separaten MLflow-Run im selben Experiment erstellt, damit man die Versuche vergleichen kann.
GPU-, CPU- und Speichersystemmetriken werden für jeden verwalteten Lauf automatisch erfasst und erscheinen im Tab MLflow System-Metriken .
Konfigurieren und beim Lauf anmelden
Verwenden Sie das Workload-YAML, um das Experiment auszuwählen und optional den Laufnamen und den Artefaktstandort zu konfigurieren. Das folgende Beispiel zeigt nur die MLflow-Felder:
experiment_name: my-training
mlflow_run_name: baseline-lr3e5
mlflow_artifact_location: /Volumes/main/default/mlflow-artifacts/my-training
Für Feldanforderungen, Standardwerte und unterstützte Werte siehe Workload YAML-Referenz.
AI Runtime stellt die verwaltete Run-ID über MLFLOW_RUN_ID bereit. Um Ihre eigenen Parameter, Metriken und Artefakte für diesen Lauf zu protokollieren, öffnen Sie ihn mit der MLflow-Tracking-API neu:
import os

import mlflow

# Log from rank 0 only because all nodes share the same MLFLOW_RUN_ID.
if os.environ.get("RANK", "0") == "0":
    with mlflow.start_run(run_id=os.environ["MLFLOW_RUN_ID"]):
        mlflow.log_param("learning_rate", 3e-4)
        for step, loss in enumerate(training_losses):
            mlflow.log_metric("train_loss", loss, step=step)
Finden Sie Ausführungen und Protokolle
Logs sind sowohl über die Databricks-CLI als auch über die MLflow-Laufseite verfügbar. Verwenden Sie die folgenden Befehle, um Workloads zu finden, eine Workload zu inspizieren und Logs zu streamen oder herunterzuladen:
databricks air list --all-status
databricks air get <job-run-id>
databricks air logs <job-run-id>
databricks air logs <job-run-id> --node 2
databricks air logs <job-run-id> --download-to ./logs/
Notebook-Workloads verfolgen
Von einem Notizbuch aus können Sie Code direkt in der angehängten Sitzung ausführen oder verteiltes Training über den @distributed Decorator aus dem Databricks AI Runtime SDK durchführen.
Code direkt in einem Notebook ausführen
Code, der direkt in einem angehängten Notizbuch ausgeführt wird, erzeugt nicht automatisch einen MLflow-Run. Wählen Sie ein Experiment aus, starten Sie einen Run oder aktivieren Sie das Autologging:
import mlflow

mlflow.set_experiment("/Users/<username>/my-experiment")

with mlflow.start_run(run_name="baseline"):
    train()
Um das Autologging von PyTorch Lightning zu aktivieren, verwenden Sie folgendes Muster:
mlflow.pytorch.autolog()

with mlflow.start_run(run_name="lightning-baseline"):
    trainer.fit(model, datamodule=datamodule)
Für Hugging Face Transformers konfigurieren Sie TrainingArguments wie folgt:
from transformers import TrainingArguments

args = TrainingArguments(
    output_dir="/Volumes/<catalog>/<schema>/<volume>/checkpoints",
    report_to="mlflow",
    run_name="llama7b-sft-lr3e5",
    logging_steps=50,
)
Verwenden Sie das Databricks AI Runtime SDK
Für verteiltes Training aus einem Notizbuch verwenden Sie den @distributed Decorator aus dem Databricks AI Runtime SDK (databricks-sdk-air). Das SDK ist unter dem databricks.air Namensraum in GPU-Umgebungsversion 6 und höher verfügbar, oder als serverless_gpu in GPU-Umgebungsversion 5 und darunter.
from databricks.air import distributed

@distributed()
def train():
    # Training code
    ...

train.distributed()
Jeder Aufruf .distributed() erzeugt automatisch einen MLflow-Lauf. Das Standardexperiment ist /Users/{WORKSPACE_USER}/{notebook-name}. Um ein weiteres Experiment auszuwählen, setzen Sie es, bevor Sie .distributed() aufrufen:
mlflow.set_experiment("/Users/<username>/my-experiment")
train.distributed()
Wenn Sie .distributed() innerhalb eines aktiven Laufs aufrufen, erstellt AI Runtime einen verschachtelten untergeordneten Lauf:
with mlflow.start_run() as parent_run:
    train.distributed()
Um einen vorherigen Durchlauf fortzusetzen, setzen Sie MLFLOW_RUN_ID vor .distributed():
import os

os.environ["MLFLOW_RUN_ID"] = "<previous-run-id>"
train.distributed()
Nutze den Run-Link in der Zellausgabe oder im Notebook-Experiment-Panel, um den MLflow-Run zu öffnen.
Logbücher ansehen
- Notizbuchausgabe: Standardausgabe und Fehler aus dem Trainingscode erscheinen in der Ausgabe der Notebookzelle.
-
MLflow-Logs: Für jobgestützte Notebook-Workloads wie
.distributed(remote=True)Calls zeigt die MLflow-Registerkarte Logs die Ausgabe des zugehörigen Job-Runs an.
Überwachen Sie Live-GPU-Ressourcen
Der GPU-Ressourcenbereich des Notebooks zeigt die Live-GPU-Auslastung, den Speicher und die Temperatur für Single- und Multi-Node-Workloads. Nutzen Sie den Tab MLflow System-Metriken, wenn Sie einen persistenten Datensatz benötigen, der mit einem Run verknüpft ist.
Um den Bereich zu öffnen, verbinde das Notizbuch mit AI Runtime und klicke dann im rechten Seitenpanel auf  GPU-Ressourcen.
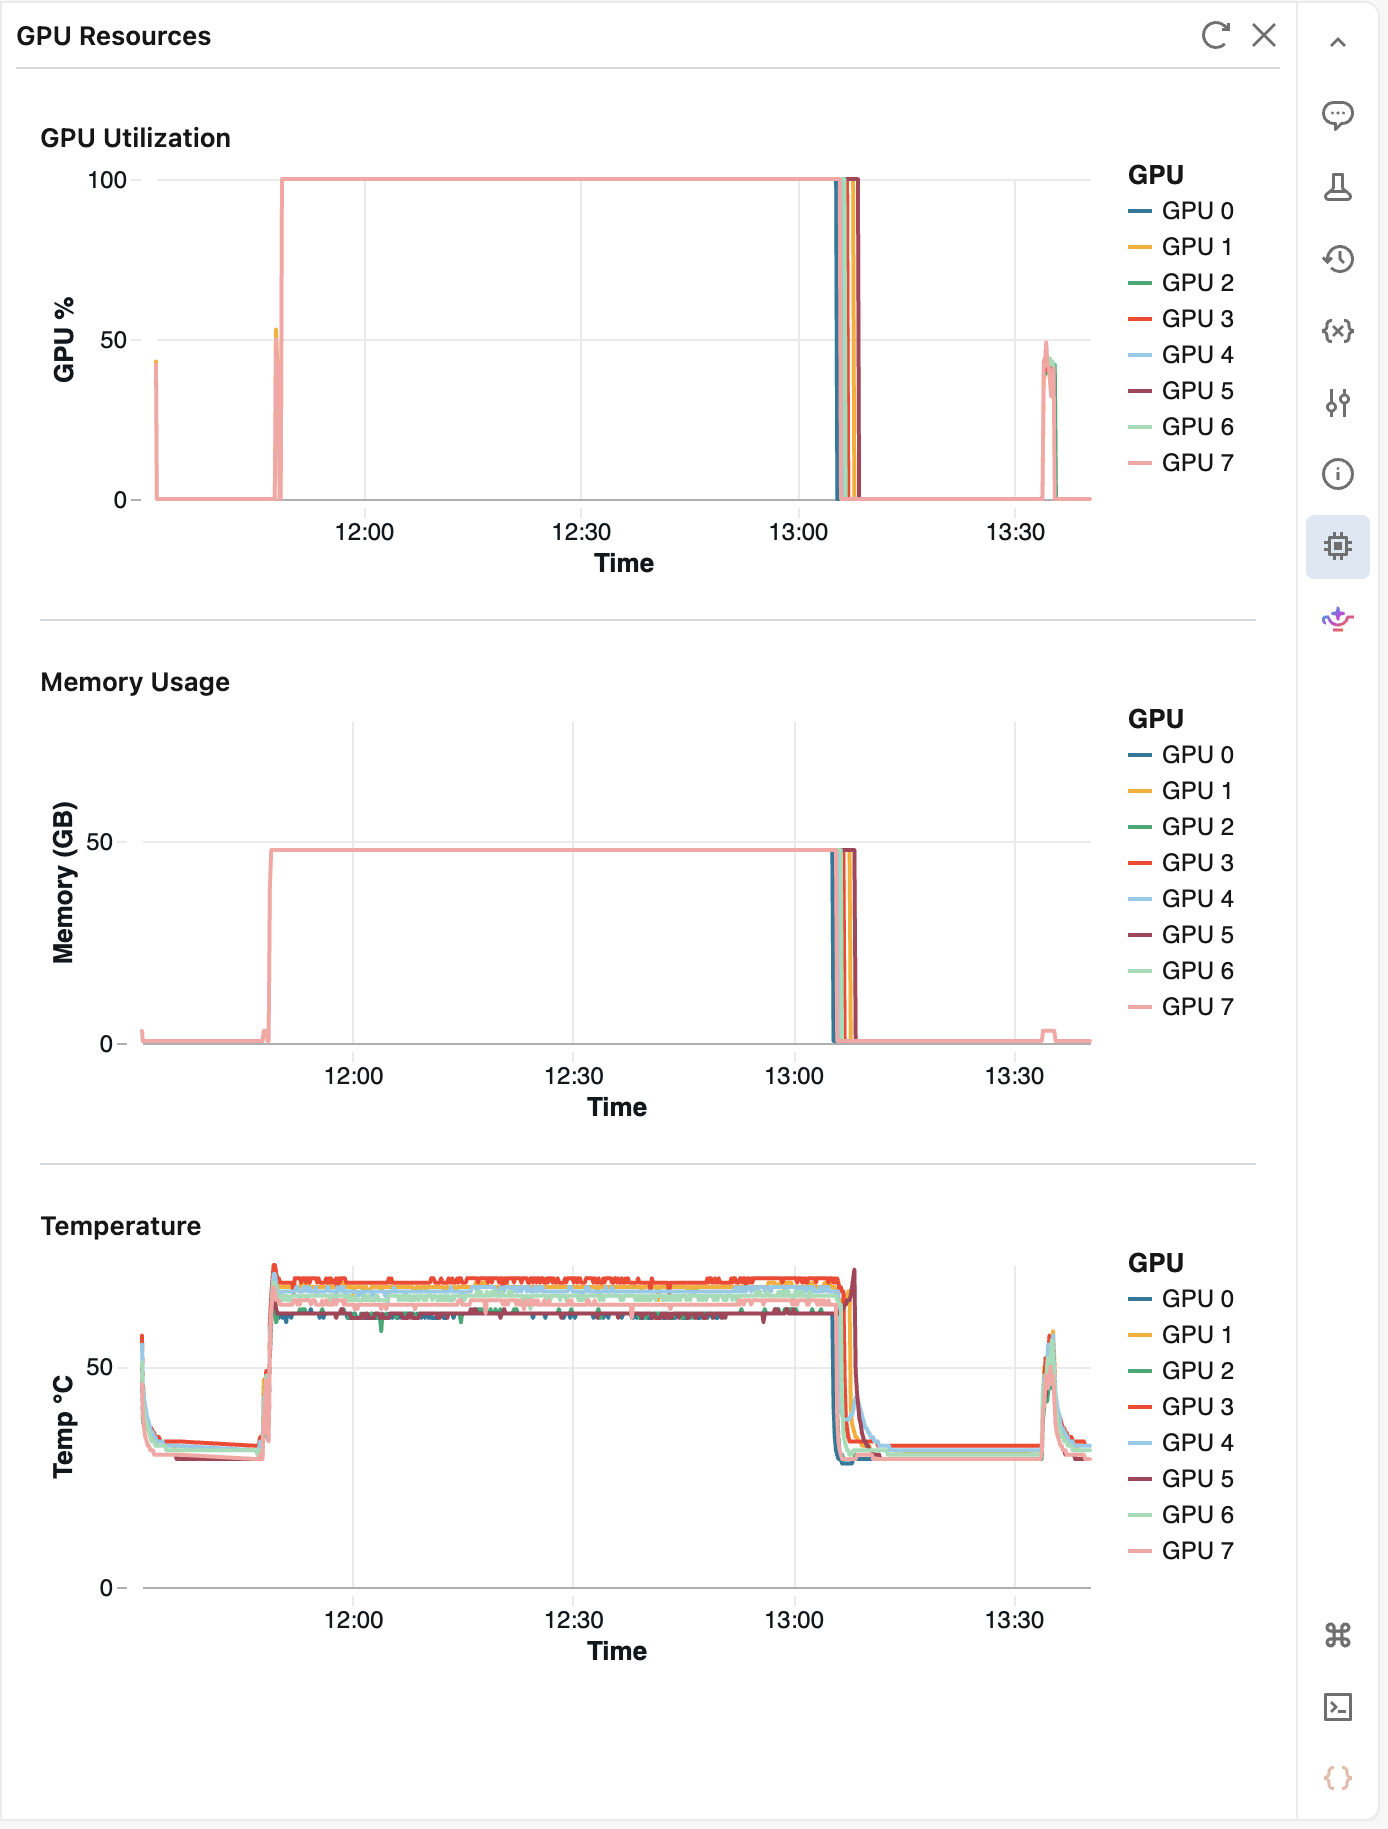
Der Bereich ruft die Metriken alle 10 Sekunden ab und speichert bis zu 2 Stunden Verlauf. Klicken Sie  Aktualisieren, um die neuesten Werte abzurufen. Nach fünf Minuten Inaktivität hält der Bereich an. Öffne es erneut, um die Überwachung fortzusetzen.
Fehlerbehebung des Zugriffs auf die Protokolle
Die Registerkarte Protokolle auf der Seite eines MLflow-Laufs zeigt die Ausgabe des zugehörigen Azure Databricks-Joblaufs in Echtzeit an. Der Zugriff auf das MLflow-Experiment impliziert keinen Zugriff auf den Job.
Wenn der Tab Sie haben keinen Zugriff auf diese Logs anzeigt, bitten Sie einen Benutzer mit Can Manage-Berechtigung oder einen Workspace-Administrator, Ihnen zumindest Can View für den Job zu gewähren. Siehe Steuern des Zugriffs auf einen Auftrag.