Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Spark SQL verwendet einen kostenbasierten Optimierer (CBO), um effiziente Abfragepläne auszuwählen. Das CBO verwendet Tabellen- und Spaltenstatistiken wie Tabellengröße und Datenverteilung, um die Kosten alternativer Pläne zu schätzen und den Plan mit den niedrigsten geschätzten Kosten auszuwählen. Das ist am wichtigsten bei Abfragen mit mehreren Joins, wo ein schlechter Plan um Größenordnungen langsamer sein kann als ein guter.
Das CBO ist standardmäßig aktiviert, hängt aber von den Statistiken ab. Wenn Statistiken fehlen oder veraltet sind, könnte das CBO eine ineffiziente Join-Reihenfolge oder Join-Strategie wählen. Sammeln Sie Tabellen- und Spaltenstatistiken und halten Sie sie aktuell. Siehe Statistiken sammeln.
Bewährte Vorgehensweisen
Um dem CBO bei der Auswahl effizienter Abfragepläne zu helfen, folgen Sie diesen Praktiken:
- Sammeln Sie Statistiken für Tabellen, die in Multi-Join-Abfragen verwendet werden. Wenn Sie prädiktive Optimierung auf von Unity Catalog verwalteten Tabellen verwenden, werden Statistiken für Sie gesammelt. Siehe Statistiken sammeln.
- Überprüfen Sie Abfragepläne, wenn eine Multi-Join-Abfrage langsamer ist als erwartet. Fehlende oder ungenaue Statistiken sind eine häufige Ursache. Siehe Abfragepläne verifizieren.
- Statistiken löschen oder das CBO deaktivieren, nur um ein spezielles Planungsproblem zu beheben, das durch Statistiken verursacht wird. Siehe Deaktivieren des kostenbasierten Optimierers.
Sammeln von Statistiken
Um den vollen Nutzen aus dem CBO zu ziehen, ist es wichtig, sowohl Spaltenstatistiken als auch Tabellenstatistiken zu erfassen. Sie können den ANALYZE TABLE Befehl verwenden, um Statistiken manuell zu sammeln.
Tipp
Führen Sie ANALYZE TABLE nach dem Schreiben in die Tabelle aus, um die Statistiken auf dem neuesten Stand zu halten.
Verwenden Sie ANALYZE
Die Predictive Optimization läuft automatisch aus und führt ANALYZE aus, einen Befehl zum Sammeln von Statistiken auf den von Unity Catalog verwalteten Tabellen. Databricks empfiehlt die Aktivierung der prädiktiven Optimierung für alle verwalteten Tabellen in Unity Catalog, um die Datenwartung zu vereinfachen und die Speicherkosten zu senken. Siehe ANALYZE TABLE ... COMPUTE STATISTICS.
Sie können Optimiererstatistiken entfernen, sodass der Optimierer sie nicht mehr benötigt, z. B. um ein Planungsproblem zu mindern, das durch die Statistiken verursacht wird. Siehe ANALYZE TABLE ... DROP STATISTICS.
Überprüfen von Abfrageplänen
Es gibt mehrere Möglichkeiten, den Abfrageplan zu überprüfen.
EXPLAIN Befehl
Verwenden Sie den SQL-Befehl EXPLAIN, um zu überprüfen, ob der Plan Statistiken verwendet.
Wenn Statistiken fehlen, ist der Abfrageplan möglicherweise nicht optimal.
== Optimized Logical Plan ==
Aggregate [s_store_sk], [s_store_sk, count(1) AS count(1)L], Statistics(sizeInBytes=20.0 B, rowCount=1, hints=none)
+- Project [s_store_sk], Statistics(sizeInBytes=18.5 MB, rowCount=1.62E+6, hints=none)
   +- Join Inner, (d_date_sk = ss_sold_date_sk), Statistics(sizeInBytes=30.8 MB, rowCount=1.62E+6, hints=none)
      :- Project [ss_sold_date_sk, s_store_sk], Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :  +- Join Inner, (s_store_sk = ss_store_sk), Statistics(sizeInBytes=48.9 GB, rowCount=2.63E+9, hints=none)
      :     :- Project [ss_store_sk, ss_sold_date_sk], Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :     :  +- Filter (isnotnull(ss_store_sk) && isnotnull(ss_sold_date_sk)), Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :     :     +- Relation[ss_store_sk,ss_sold_date_sk] parquet, Statistics(sizeInBytes=134.6 GB, rowCount=2.88E+9, hints=none)
      :     +- Project [s_store_sk], Statistics(sizeInBytes=11.7 KB, rowCount=1.00E+3, hints=none)
      :        +- Filter isnotnull(s_store_sk), Statistics(sizeInBytes=11.7 KB, rowCount=1.00E+3, hints=none)
      :           +- Relation[s_store_sk] parquet, Statistics(sizeInBytes=88.0 KB, rowCount=1.00E+3, hints=none)
      +- Project [d_date_sk], Statistics(sizeInBytes=12.0 B, rowCount=1, hints=none)
         +- Filter ((((isnotnull(d_year) && isnotnull(d_date)) && (d_year = 2000)) && (d_date = 2000-12-31)) && isnotnull(d_date_sk)), Statistics(sizeInBytes=38.0 B, rowCount=1, hints=none)
            +- Relation[d_date_sk,d_date,d_year] parquet, Statistics(sizeInBytes=1786.7 KB, rowCount=7.30E+4, hints=none)
Wichtig
Die Statistik rowCount ist besonders für Abfragen mit mehreren Joins wichtig. Wenn rowCount fehlt, bedeutet dies, dass nicht genügend Informationen zur Berechnung vorhanden sind (d. h., einige erforderliche Spalten verfügen nicht über Statistiken).
In Databricks Runtime 16.0 und höher listet die Ausgabe des EXPLAIN Befehls die referenzierten Tabellen auf, die fehlende, teilweise und vollständige Statistiken enthalten, zum Beispiel:
== Optimizer Statistics (table names per statistics state) ==
  missing = date_dim, store
  partial =
  full    = store_sales
Corrective actions: consider running the following command on all tables with missing or partial statistics
  ANALYZE TABLE <table-name> COMPUTE STATISTICS FOR ALL COLUMNS
Spark SQL-Benutzeroberfläche
Verwenden Sie die Spark SQL UI-Seite, um den ausgeführten Plan und die Genauigkeit der Statistiken anzuzeigen.
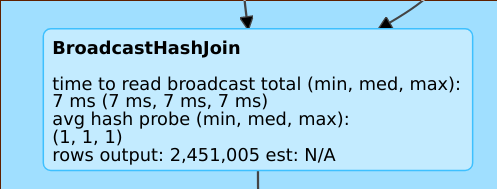
Eine Zeile wie rows output: 2,451,005 est: N/A bedeutet, dass dieser Operator ca. 2 Mio. Zeilen erzeugt und keine Statistiken verfügbar waren.
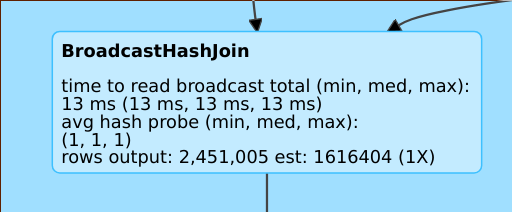
Eine Zeile wie rows output: 2,451,005 est: 1616404 (1X) bedeutet, dass dieser Operator ca. 2 Mio. Zeilen erzeugt, während die Schätzung bei ca. 1,6 Mio. lag und der Schätzungsfehlerfaktor „1“ lautete.
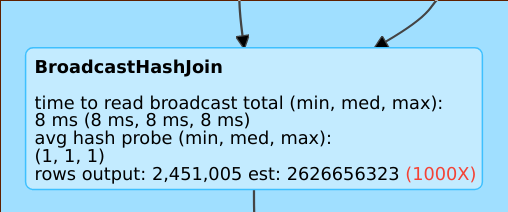
Eine Zeile wie rows output: 2,451,005 est: 2626656323 bedeutet, dass dieser Operator ca. 2 Mio. Zeilen erzeugt, während die Schätzung 2 Bn. Zeilen betrug, sodass der Schätzungsfehlerfaktor „1000“ lautete.
Deaktiviere den kostenbasierten Optimierer
Der CBO ist standardmäßig aktiviert. Sie können den CBO deaktivieren, indem Sie das Flag spark.sql.cbo.enabled ändern.
spark.conf.set("spark.sql.cbo.enabled", false)