Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Important
Dieses Feature befindet sich in der Betaversion. Um sie zu nutzen, muss ein Workspace-Administrator auf der Seite VorschauenEffiziente Spaltenaktualisierungen aktivieren. Siehe Manage Azure Databricks Previews.
Effiziente Spaltenaktualisierungen (ECU) ermöglichen es Ihnen, Spalten in einer Delta Lake-Tabelle hinzuzufügen und nachträglich zu füllen, ohne unveränderte Spalten neu zu schreiben. Verwenden Sie es, um neue Funktionen, Embeddings und andere abgeleitete Werte in bestehenden Datensätzen aufzufüllen.
Das Hinzufügen einer Spalte ändert das Tabellenschema, ohne bestehende Daten neu zu schreiben. Das Befüllen dieser Spalte mit Werten kann es erforderlich machen, die Datendateien mit den betroffenen Zeilen neu zu schreiben, einschließlich der unveränderten Spalten. Effiziente Spaltenaktualisierungen vermeiden diese unveränderten Spaltenumschreibungen, indem die aktualisierten Spaltenwerte in getrennte Parquet-Dateien geschrieben werden.
Dies ist besonders nützlich, wenn Sie eine kleine Anzahl von Spalten zu einer Tabelle hinzufügen, die große Payloads oder Embeddings enthält. Abfragen geben weiterhin eine logische Tabelle zurück, die bestehende Daten mit den aktualisierten Spaltenwerten kombiniert.
Das folgende Diagramm vergleicht das Hinzufügen und Backfilling einer Spalte. Graue Blöcke repräsentieren bestehende Spaltendaten, grüne Blöcke neue Spaltendaten, und rote Umrisse kennzeichnen neu geschriebene Daten.
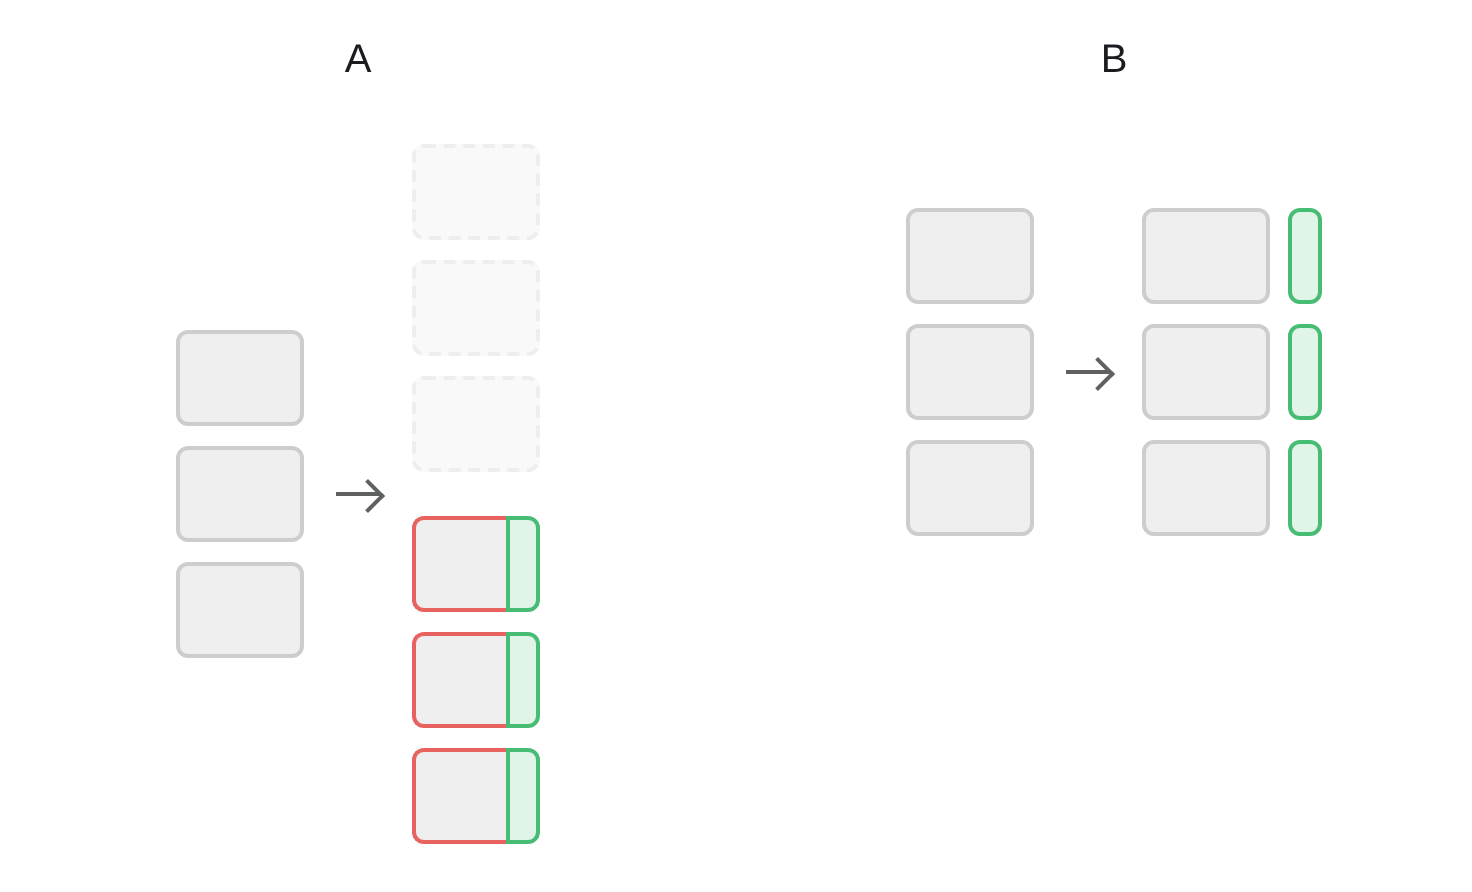
- A: Ohne ECU ersetzt ein Backfill die ursprünglichen Datendateien (gestrichene Konturen) durch Dateien, die sowohl die unveränderten Spalten als auch die neue Spalte enthalten.
- B: Bei ECU werden die Originaldateien beibehalten und die neuen Spaltenwerte in separate Dateien geschrieben.
Anforderungen
- Verwenden Sie Databricks Runtime 19 oder höher, um mit aktivierten Effizienten Spaltenupdates aus einer Tabelle zu lesen oder darauf zu schreiben.
- Verwenden Sie eine vom Unity Catalog verwaltete Delta Lake-Tabelle mit aktivierten Katalog-Commits .
- Aktivieren Sie Zeilenverfolgung und Löschvektoren für die Tabelle.
- Verwenden Sie Spaltenzuordnung im Modus
id('delta.columnMapping.mode' = 'id'). Dieser Modus muss beim Erstellen der Tabelle eingestellt werden. - Aktivieren Sie die Beta über die Seite Previews des Arbeitsbereichs.
Effiziente Spaltenaktualisierungen aktivieren
Sie können effiziente Spaltenaktualisierungen aktivieren, wenn Sie eine Tabelle erstellen oder für eine bestehende Tabelle, die die Anforderungen erfüllt. Überprüfen Sie die Einschränkungen , bevor Sie es aktivieren.
Um eine Tabelle mit aktivierten Effizienten Spaltenaktualisierungen zu erstellen, setzen Sie die Tabelleneigenschaft delta.enableColumnUpdates-preview zusammen mit den Eigenschaften für die erforderlichen Funktionen ein:
CREATE TABLE documents (
  document_id BIGINT,
  description STRING
)
TBLPROPERTIES (
  'delta.feature.catalogManaged' = 'supported',
  'delta.enableRowTracking' = 'true',
  'delta.enableDeletionVectors' = 'true',
  'delta.columnMapping.mode' = 'id',
  'delta.enableColumnUpdates-preview' = 'true'
);
Für eine bestehende Tabelle, die bereits Spaltenzuordnung im Modus id verwendet, aktivieren Sie Katalog-Commits, Zeilenverfolgung und Löschvektoren, falls diese nicht bereits aktiviert sind:
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.feature.catalogManaged' = 'supported',
  'delta.enableRowTracking' = 'true',
  'delta.enableDeletionVectors' = 'true'
);
Aktivieren Sie dann effiziente Spaltenaktualisierungen:
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.enableColumnUpdates-preview' = 'true'
);
Wenn Sie Probleme haben, können Sie zu Standard-Updates zurückkehren.
Eine Spalte hinzufügen und rückwirkend füllen
Das folgende Beispiel verwendet eine bestehende documents Tabelle mit einer document_id Spalte und einer description String-Spalte. Es fügt eine Spalte hinzu, die die Länge jeder Beschreibung enthält:
ALTER TABLE documents ADD COLUMN text_length INT;

UPDATE documents
SET text_length = LENGTH(description);
Nach dem Hinzufügen der Spalte enthalten bestehende Zeilen NULL in text_length, bis die UPDATE ihre Werte einträgt. Effiziente Spaltenaktualisierungen ermöglichen es dem Backfill, die neuen Spaltenwerte zu schreiben, ohne die unveränderten Spalten neu zu schreiben.
Abfragen Sie die Tabelle, um die ausgefüllten Werte zu überprüfen:
SELECT document_id, description, text_length
FROM documents
LIMIT 10;
Effiziente Spaltenaktualisierungen reduzieren die während eines Backfills neu geschriebenen Daten. Das Update liest weiterhin die Eingabespalten aus und berechnet die neuen Werte.
Das Aktivieren effizienter Spaltenaktualisierungen garantiert nicht, dass nicht jedes UPDATE dies nutzt. In manchen Fällen greift Azure Databricks auf ein Standard-Update zurück, das die betroffenen Datendateien neu schreibt. Das Update ist weiterhin erfolgreich und liefert dieselben Ergebnisse.
Zu Standard-Updates zurückkehren
Wenn Sie Probleme mit effizienten Spaltenaktualisierungen haben, deaktivieren Sie neue Spaltenaktualisierungen und konsolidieren Sie bestehende Spaltendateien:
Beenden Sie das Schreiben neuer Spaltendateien:
ALTER TABLE documents SET TBLPROPERTIES (
  'delta.enableColumnUpdates-preview' = 'false'
);
Schreiben Sie Datendateien mit Spaltendateien neu mit REORG TABLE:
REORG TABLE documents APPLY (PURGE);
REORG Schreibt die letzten Spaltenwerte in die neu geschriebenen Datendateien und erstellt eine neue Tabellenversion ohne Spaltendateien. Die aktualisierten Werte werden beibehalten. Frühere Tabellenversionen können weiterhin auf Spaltendateien verweisen.
Die Tabellenfunktion bleibt im Tabellenprotokoll aktiviert, sodass Lese- und Schreibvorgänge weiterhin Databricks Runtime 19 oder höher erfordern.
Limitations
- Effiziente Spalten-Updates sind mit dem Schreibzeit-Änderungsdatenfeed (CDF) nicht kompatibel. Siehe den Legacy-Änderungsdatenfeed.
- Effiziente Spalten-Updates sind mit Universal Format (UniForm) nicht kompatibel.
- Von Apache Iceberg verwaltete Tabellen werden nicht unterstützt.
-
MERGEOperationen verwenden keine effizienten Spaltenaktualisierungen. - Das Entfernen von Effizienten Spaltenaktualisierungen mit
DROP FEATUREwird nicht unterstützt. Databricks empfiehlt, es nicht für kritische Tabellen zu aktivieren. Um die Verwendung von Spalten-Updates zu beenden, lesen Sie unter Zurück zu Standard-Updates nach. - Lakeflow-Pipelines werden nicht unterstützt.