Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Benutzerdefinierte Funktionen (UDFs) im Unity-Katalog erweitern SQL- und Python-Fähigkeiten in Azure Databricks. Sie ermöglichen es Ihnen, benutzerdefinierte Funktionen in Computerumgebungen zu definieren, zu verwenden und sicher zu teilen und zu steuern.
Python-UDFs, die in Unity Catalog als Funktionen registriert sind, unterscheiden sich in Umfang und Unterstützung von PySpark-UDFs, die einem Notebook-Bereich oder SparkSession zugeordnet sind. Siehe Python skalare benutzerdefinierte Funktionen (UDFs).
Informationen zum Registrieren von UDFs, die in Scala oder Java im Unity-Katalog geschrieben wurden, finden Sie unter Scala und Java benutzerdefinierte Funktionen (UDFs) im Unity-Katalog.
Um zu sehen, welche Workloads und Tabellen ein UDF in Unity Catalog referenzieren, bevor Sie es ändern, siehe View UDF Lineage.
Eine vollständige SQL-Sprachreferenz finden Sie CREATE FUNCTION unter (SQL, Python, Scala und Java).
Anforderungen
Um UDFs im Unity-Katalog zu verwenden, müssen Sie die folgenden Anforderungen erfüllen:
- Um Python-Code in UDFs zu verwenden, die im Unity-Katalog registriert sind, müssen Sie ein serverloses oder pro SQL Warehouse oder einen Cluster mit Databricks Runtime 13.3 LTS oder höher verwenden.
- Wenn eine Ansicht ein Unity Catalog Python UDF enthält, schlägt sie bei klassischen SQL-Warehouses fehl.
- Arm-Instanzunterstützung für Scala UDFs auf Unity-Katalogfähigen Clustern ist in Databricks Runtime 15.2 und höher verfügbar.
Skalare und Batch Unity Catalog Python UDFs sind in der Regel auf allen unterstützten Rechenarten verfügbar.
Python UDF-Funktionsanforderungen
Die Anforderungen variieren je nach Funktion. Databricks Runtime 19 und Umgebungsversion 6 sind keine allgemeinen Anforderungen für Unity Catalog Python UDFs.
Für PySpark-Sitzungs-UDFs auf serverlosen Notebooks oder Jobs beziehen sich die Umgebungsanforderungen auf die Sitzungsumgebung. Bei SQL-definierten Python-UDFs verweisen sie in der environment_version-Klausel jeder Funktion auf ENVIRONMENT. Das Ändern der Sitzungsumgebung ändert nicht die Umgebung einer bestehenden Unity-Catalog-Funktion. Zum Beispiel kann eine Sitzung mit Umgebungsversion 6 eine Unity-Katalogfunktion aufrufen, die mit Umgebungsversion 5 definiert ist.
| Funktion | Anforderungen |
|---|---|
ENVIRONMENT Klausel- und benutzerdefinierte Abhängigkeiten |
Serverlose Notizbücher und Jobs; Pro- oder serverlose SQL-Warehouses; Databricks Runtime 16.2 oder höher auf klassischem Compute. Bei klassischer Berechnung mit Databricks Runtime 16.2 bis 18.1 muss environment_version'None' sein. |
| Batch-Unity-Catalog-Python-UDFs | serverlose Rechenleistung; Pro- und serverlose SQL-Warehouses; Databricks Runtime 16.3 oder höher auf klassischer Rechenleistung |
| Benannter Handler für ein skalares Python UDF | Databricks Runtime 18.1 oder höher auf Classic Compute. Legen Sie in serverlosen Rechenumgebungen sowie in Pro- und serverlosen SQL-Warehouses den environment_version der UDF explizit auf 6 oder höher fest. |
| Service-Zugangsdaten in einem skalaren Python UDF | Databricks Runtime 18.1 oder höher auf Classic Compute. Legen Sie in serverlosen Rechenumgebungen sowie in Pro- und serverlosen SQL-Warehouses den environment_version der UDF explizit auf 6 oder höher fest. Classic Compute benötigt keine Umgebungsversion 6. Auf serverlosen SQL-Warehouses aktivieren Sie außerdem das isolierte Workload-Netzwerk Public Preview. |
| Service-Zugangsdaten in einem Batch Unity Catalog Python UDF | Serverlose Rechenleistung; Pro- und serverlose SQL-Warehouses; Databricks Runtime 16.3 oder höher auf klassischer Rechenleistung. Umgebungsversion 6 ist nicht erforderlich. Auf serverlosen SQL-Warehouses aktivieren Sie außerdem das isolierte Workload-Netzwerk Public Preview. |
| Geheimnisse in einem skalaren oder Batch Unity Catalog Python UDF |
environment_version explizit auf 6 oder höher festlegen; serverloses Computing; Pro- und serverlose SQL-Warehouses; Databricks Runtime 19 oder höher mit Standardzugriffsmodus bei klassischem Compute. Der direkte Aufruf wird bei Compute mit dediziertem Zugriffsmodus nicht unterstützt. |
PySpark-kompatibles TIMESTAMP Eingabeverhalten |
Databricks Runtime 18.1 oder höher auf Classic Compute. Legen Sie in serverlosen Rechenumgebungen sowie in Pro- und serverlosen SQL-Warehouses den environment_version der UDF explizit auf 6 oder höher fest. |
| Mehr als fünf UDF-Aufrufe in einer Abfrage | Databricks Runtime 18.1 oder höher auf Classic Compute. Legen Sie bei serverless Compute sowie auf Pro- und serverlosen SQL-Warehouses environment_version für jede UDF explizit auf 6 oder höher fest. |
Bestehende UDFs und Funktionen, die während der öffentlichen Vorschau verfügbar waren, funktionieren weiterhin auf den relevanten früheren Laufzeitversionen.
Die Umgebungsversion bestimmt außerdem, ob Anrufer direkten Zugriff auf Abhängigkeiten benötigen, die in einem Unity-Catalog-Volume gespeichert sind. Siehe Berechtigungen für Abhängigkeiten in Unity-Katalog-Volumes.
Umgebungsversionen auf Classic Compute
Bei klassischer Berechnung erfordert das Setzen von environment_version auf einen anderen Wert als 'None' Databricks Runtime 18.2 oder höher. Setzen Sie auf Databricks Runtime 16.2 bis 18.1 environment_version = 'None' jedes Mal, wenn Sie die ENVIRONMENT Klausel verwenden. Der Wert 'None' verwendet die Standard-Python-Umgebung.
Auf Databricks Runtime 18.2 oder höher empfiehlt Azure Databricks für prognostizierbares Verhalten explizit die Festlegung einer festen environment_version in jeder Unity Catalog Python UDF-Definition. Wählen Sie eine Version, die die Funktionsanforderungen des UDF erfüllt und diesen Kompatibilitätsempfehlungen folgt:
| Databricks Runtime-Version | Maximal empfohlene Umgebungsversion |
|---|---|
| 18.2 bis 18.x | 5 |
| 19.x | 6 |
Erstellen von SQL und Python UDFs im Unity-Katalog
Um eine SQL- oder Python-UDF in Unity Catalog zu erstellen, benötigen Benutzer die USAGE- und die CREATE-Berechtigung für das Schema sowie die USAGE-Berechtigung für den Catalog. Weitere Details finden Sie im Unity-Katalog .
Um eine UDF auszuführen, benötigen Benutzer EXECUTE-Berechtigungen für die UDF. Benutzer benötigen auch die VERWENDUNGsberechtigung für das Schema und den Katalog.
Um eine UDF in einem Unity-Katalogschema zu erstellen und zu registrieren, muss der Funktionsname dem Format catalog.schema.function_nameentsprechen. Alternativ können Sie den richtigen Katalog und das richtige Schema im SQL-Editor auswählen.
In diesem Fall darf Ihrem Funktionsnamen nicht catalog.schema vorangestellt werden:
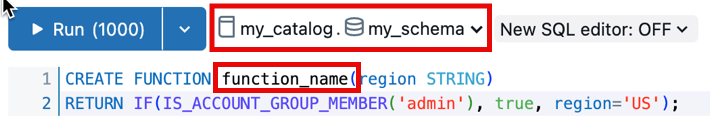
Im folgenden Beispiel wird eine neue Funktion für das my_schema Schema im my_catalog Katalog registriert:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight DOUBLE, height DOUBLE)
RETURNS DOUBLE
LANGUAGE SQL
RETURN
SELECT weight / (height * height);
Python-UDFs für den Unity Catalog verwenden Anweisungen, die durch doppelte Dollarzeichen ($$) versetzt werden. Sie müssen eine Datentypzuordnung angeben. Im folgenden Beispiel wird eine Benutzerdefinierte Funktion (UDF) registriert, die den Körpermasseindex berechnet.
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight_kg DOUBLE, height_m DOUBLE)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
return weight_kg / (height_m ** 2)
$$;
Sie können diese Unity-Katalogfunktion jetzt in Ihren SQL-Abfragen oder PySpark-Code verwenden:
SELECT person_id, my_catalog.my_schema.calculate_bmi(weight_kg, height_m) AS bmi
FROM person_data;
Weitere UDF-Beispiele finden Sie unter Zeilenfilterbeispiele und Spaltenmaskenbeispiele.
Verwenden Sie einen benannten Handler in einem skalaren Python UDF
Bei klassischer Berechnung benötigen benannte Handler Databricks Runtime 18.1 oder höher. Legen Sie in serverlosen Rechenumgebungen sowie in Pro- und serverlosen SQL-Warehouses den environment_version der UDF explizit auf 6 oder höher fest. Im folgenden Beispiel wird die Umgebungsversion 6 verwendet. Lassen Sie bei der klassischen Berechnung mit Databricks Runtime 18.1 die ENVIRONMENT Klausel weg. Folgen Sie bei späteren Laufzeitversionen den Kompatibilitätsempfehlungen, falls Sie die Klausel einfügen.
Verwenden Sie die HANDLER Klausel, um eine Python-Funktion im UDF-Körper als Einstiegspunkt zu benennen. Der benannte Handler akzeptiert die UDF-Argumente und gibt einen Wert zurück, der dem deklarierten Rückgabetyp entspricht. Code außerhalb des Handlers läuft, wenn jede Python-Umgebung das UDF initialisiert, bevor der Handler die Eingaben verarbeitet. Verwenden Sie diesen Code für eine einmalige Initialisierung, die über Handler-Aufrufe hinweg wiederverwendet werden kann.
Das folgende Beispiel initialisiert greeting_prefix vor der Definition greet_handlerder Funktion, die UDF-Eingaben verarbeitet:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.greet(name STRING)
RETURNS STRING
LANGUAGE PYTHON
HANDLER 'greet_handler'
ENVIRONMENT (
  environment_version = '6'
)
AS $$
# Runs once when each Python environment initializes the UDF.
greeting_prefix = "Hello"

def greet_handler(name):
    return f"{greeting_prefix}, {name}!"
$$;
Geheimnisse in einem Python UDF verwenden
Skalare und Batch-Unity-Catalog-Python-UDFs können auf Geheimwerte zugreifen, die in der Klausel SECRETS deklariert sind. Die UDF-Definition muss environment_version explizit auf 6 oder höher festlegen. Ein Unity-Catalog-Geheimnis verwendet einen dreiteiligen Namen (catalog.schema.secret) und unterscheidet sich von einem arbeitsbasierten Azure Databricks-Geheimnis. Für Rechenunterstützung, Berechtigungen und die Dedicated-Compute Column-Mask-Ausnahme siehe UDF-Anforderungen und Berechtigungen.
Um auf ein Geheimnis eines UDF zuzugreifen:
- Fügen Sie den dreiteiligen Namen des Geheimnisses zur Klausel
SECRETSin der UDF-Definition hinzu. Ein UDF kann nur die in dieser Klausel deklarierten Geheimnisse abrufen. - Im UDF-Body rufen Sie
databricks.secrets.get()mit dem Katalog, dem Schema und dem Namen des Secrets auf.
Das folgende skalare UDF-Beispiel verwendet ein Unity-Catalog-Geheimnis als hashbasierten Nachrichten-Authentifizierungscode (HMAC) Signierungsschlüssel. Verwenden Sie dieselbe SECRETS-Klausel mit PARAMETER STYLE PANDAS, um von einem Batch-UDF-Handler aus auf deklarierte Secrets zuzugreifen.
CREATE OR REPLACE FUNCTION main.default.sign_value(value STRING)
RETURNS STRING
LANGUAGE PYTHON
SECRETS (main.default.hmac_key)
ENVIRONMENT (
  environment_version = '6'
)
AS $$
import hashlib
import hmac
from databricks.secrets import get

key = get(catalog="main", schema="default", key="hmac_key")
return hmac.new(key.encode(), value.encode(), hashlib.sha256).hexdigest()
$$;
Warning
Geben Sie keine geheimen Werte von einem UDF zurück. Geheime Schwärzung hilft, versehentliche Sichtbarkeit in Fehlern und Protokollen zu verringern, verhindert aber nicht, dass UDF-Code geheimes Material in den Abfrageergebnissen offenlegt.
Erweitern von UDFs mithilfe von benutzerdefinierten Abhängigkeiten
Hinweis
Um benutzerdefinierte Abhängigkeiten aus dem Internet in einem Serverless SQL-Warehouse zu installieren, muss in Ihrem Arbeitsbereich auf der Seite „Previews“ die Public-Preview-Funktion Enable networking for isolated workloads in Serverless SQL Warehouses aktiviert sein.
Sie können die Funktionen des Unity-Katalogs Python UDFs über die Databricks-Runtime-Umgebung hinaus erweitern, indem Sie benutzerdefinierte Abhängigkeiten für externe Bibliotheken definieren.
Anforderungen
Benutzerdefinierte Abhängigkeiten für Unity Catalog UDFs werden für die folgenden Computetypen unterstützt:
- Serverlose Notizbücher und Jobs
- Klassische All-Purpose Compute mit Databricks Runtime Version 16.2 und höher
- Pro oder serverloses SQL Warehouse
Abhängigkeitsquellen
Installieren Sie Abhängigkeiten aus den folgenden Quellen:
- PyPI-Pakete
- Dateien, die in Unity-Catalog-Volumes gespeichert sind Siehe Berechtigungen für Abhängigkeiten in Unity Catalog-Volumes.
- Dateien, die in öffentlichen URLs verfügbar sind Ihre Arbeitsbereichsnetzwerksicherheitsregeln müssen den Zugriff auf öffentliche URLs zulassen. Siehe Anforderungen.
Hinweis
Wenn Ihr Arbeitsbereich den serverlosen Netzwerkzugriff einschränkt, müssen Sie Netzwerksicherheitsregeln konfigurieren, um die öffentlichen URLs zuzulassen. Siehe Ausgangsregeln festlegen.
Berechtigungen für Abhängigkeiten in Unity-Catalog-Volumes
Der Ersteller der Funktion muss READ VOLUME auf einem Quellvolumen haben, um eine Abhängigkeit von diesem Volumen zu einer UDF hinzuzufügen.
Für eine UDF, deren Definition explizit 6 auf environment_version oder höher festlegt, benötigen Aufrufer EXECUTE für die UDF, benötigen jedoch nicht READ VOLUME für das Quell-Volume. Wenn die UDF-Definition environment_version weglässt, auf None festgelegt ist oder auf eine frühere Version festgelegt ist, müssen Aufrufer auf dem Quellvolume ebenfalls über READ VOLUME verfügen.
Definieren von Abhängigkeiten
Verwenden Sie den ENVIRONMENT Abschnitt der UDF-Definition, um Abhängigkeiten anzugeben:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.mixed_process(data STRING)
RETURNS STRING
LANGUAGE PYTHON
ENVIRONMENT (
  dependencies = '["simplejson==3.19.3", "/Volumes/my_catalog/my_schema/my_volume/packages/custom_package-1.0.0.whl", "https://my-bucket.s3.amazonaws.com/packages/special_package-2.0.0.whl?Expires=2043167927&Signature=abcd"]',
  environment_version = '6'
)
AS $$
import simplejson as json
import custom_package
return json.dumps(custom_package.process(data))
$$;
Der ENVIRONMENT Abschnitt enthält die folgenden Felder:
| Feld | BESCHREIBUNG | Typ | Anwendungsbeispiel |
|---|---|---|---|
dependencies |
Eine Liste der zu installierenden kommagetrennten Abhängigkeiten. Jeder Eintrag ist eine Zeichenfolge, die dem Pip Requirements-Dateiformat entspricht. | STRING |
dependencies = '["simplejson==3.19.3", "/Volumes/catalog/schema/volume/packages/my_package-1.0.0.whl"]'dependencies = '["https://my-bucket.s3.amazonaws.com/packages/my_package-2.0.0.whl?Expires=2043167927&Signature=abcd"]' |
environment_version |
Spezifiziert die Umgebungsversion, in der das UDF ausgeführt werden soll. Dieses Feld ist immer dann erforderlich, wenn die Klausel ENVIRONMENT vorhanden ist. Eine feste Umgebungsversion führt die UDF mit einer bestimmten Python Version und einer Reihe vorinstallierter Pakete aus, unabhängig von der Python Version und Paketen in der zugrunde liegenden Databricks-Runtime.Unterstützte Werte sind eine Umgebungsversion von 3 oder höher, wie z. B. '6', oder die Zeichenkette 'None'. Der Wert 'None' wählt die Standard-Python-Umgebung aus. Bei klassischer Berechnung erfordert das Setzen von environment_version auf einen anderen Wert als 'None' Databricks Runtime 18.2 oder höher. Auf Databricks Runtime 16.2 bis 18.1 wird nur 'None' unterstützt. Wenn feste Umgebungsversionen unterstützt werden, wählen Sie explizit eine für prognostizierbares Verhalten aus.Bei serverless Compute sowie in Pro- und serverless SQL-Warehouses erfordern einige Funktionen eine explizite Umgebungsversion. Legen Sie in jeder UDF-Definition environment_version auf die erforderliche oder eine höhere Version fest. Das Weglassen der gesamten ENVIRONMENT Klausel oder Einstellung environment_version = 'None' aktiviert diese Funktionen nicht. Siehe Python UDF-Funktionsanforderungen.Für die klassische Berechnungsversionskompatibilität siehe Umgebungsversionen auf klassischer Berechnung. Eine Liste der verfügbaren Versionen finden Sie unter Umgebungsversionen. |
STRING |
environment_version = '6' |
Verwenden von Unity-Katalog-UDFs in PySpark
from pyspark.sql.functions import expr

result = df.withColumn("bmi", expr("my_catalog.my_schema.calculate_bmi(weight_kg, height_m)"))
display(result)
Upgrade einer sitzungsbezogenen UDF
Hinweis
Syntax und Semantik für Python-UDFs in Unity Catalog unterscheiden sich von Python-UDFs, die für SparkSession registriert sind. Siehe benutzerdefinierte skalare Funktionen – Python.
Angenommen, Sie haben die folgende sitzungsbasierte UDF in einem Azure Databricks-Notebook:
from pyspark.sql.functions import udf
from pyspark.sql.types import StringType

@udf(StringType())
def greet(name):
    return f"Hello, {name}!"

# Using the session-based UDF
result = df.withColumn("greeting", greet("name"))
result.show()
Um dies als Unity-Katalogfunktion zu registrieren, verwenden Sie wie im folgenden Beispiel eine SQL-Anweisung CREATE FUNCTION :
CREATE OR REPLACE FUNCTION my_catalog.my_schema.greet(name STRING)
RETURNS STRING
LANGUAGE PYTHON
AS $$
return f"Hello, {name}!"
$$
Teilen von UDFs im Unity-Katalog
Die Zugriffssteuerelemente, die auf den Katalog, das Schema oder die Datenbank angewendet werden, in denen Sie die UDF registrieren, verwalten ihre Berechtigungen. Weitere Informationen finden Sie unter Verwalten von Berechtigungen im Unity-Katalog .
Verwenden Sie die Azure Databricks SQL- oder azure Databricks-Arbeitsbereich-UI, um Einem Benutzer oder einer Gruppe Berechtigungen zu erteilen (empfohlen).
Berechtigungen in der Benutzeroberfläche des Arbeitsbereichs
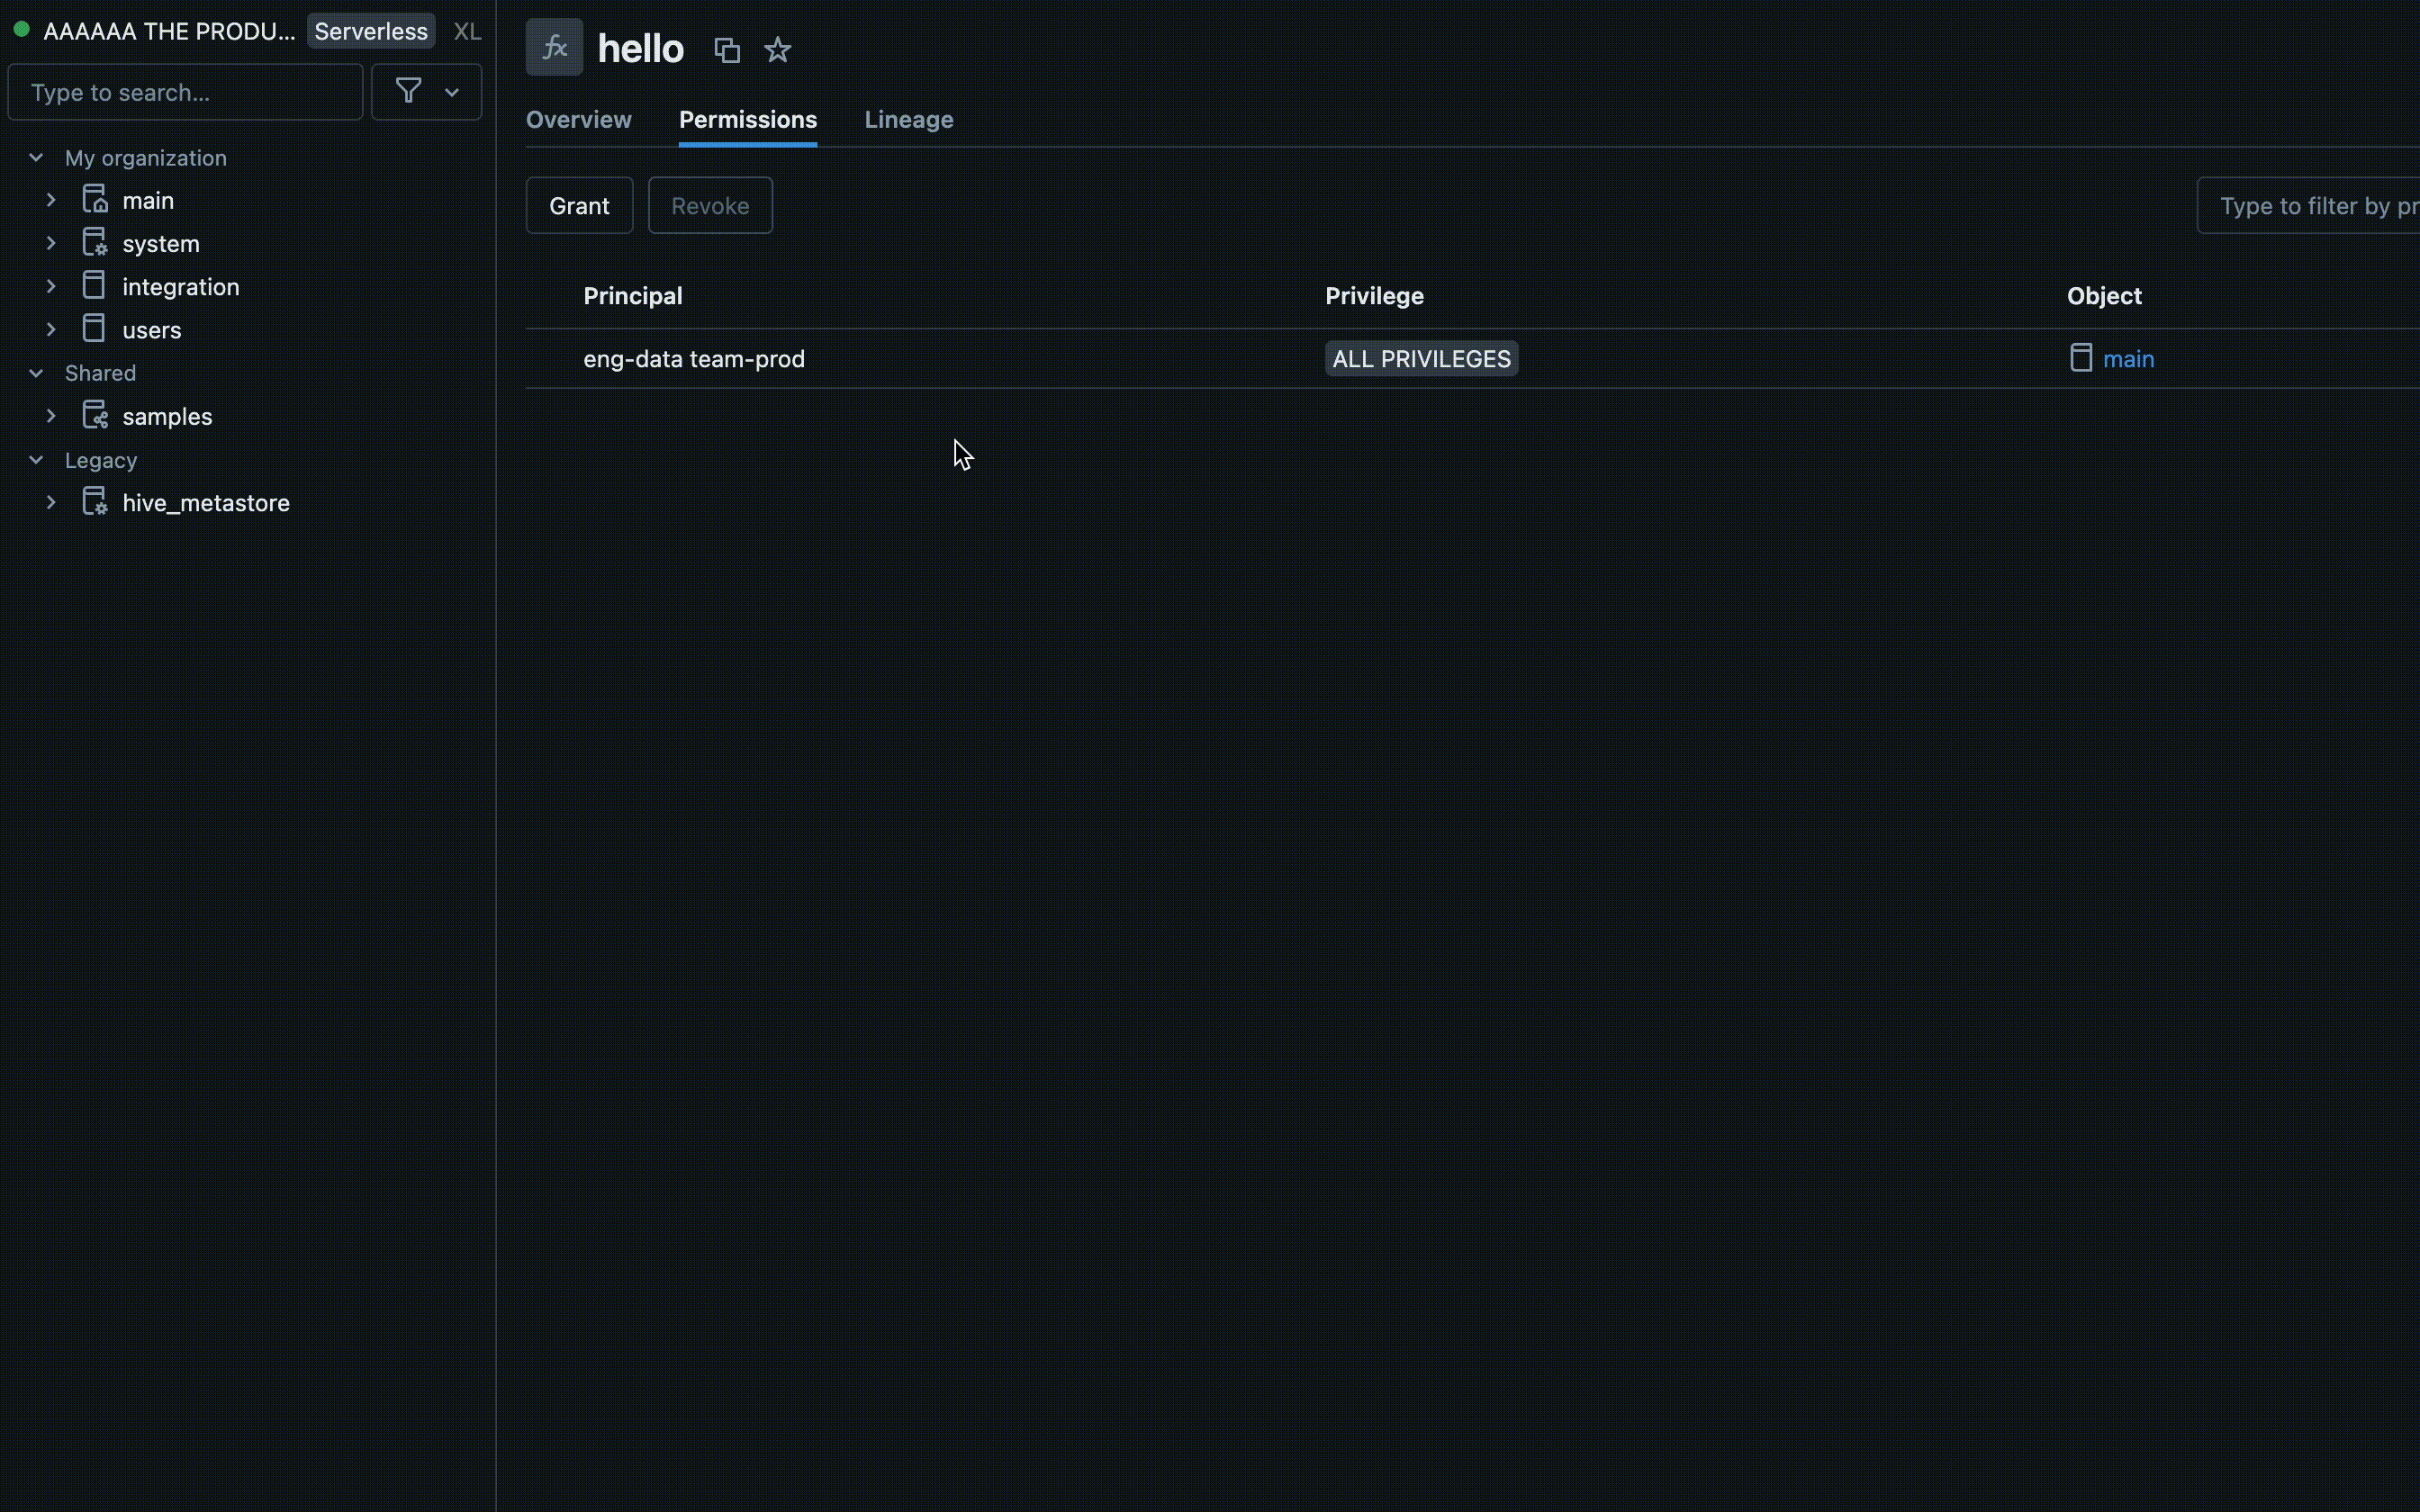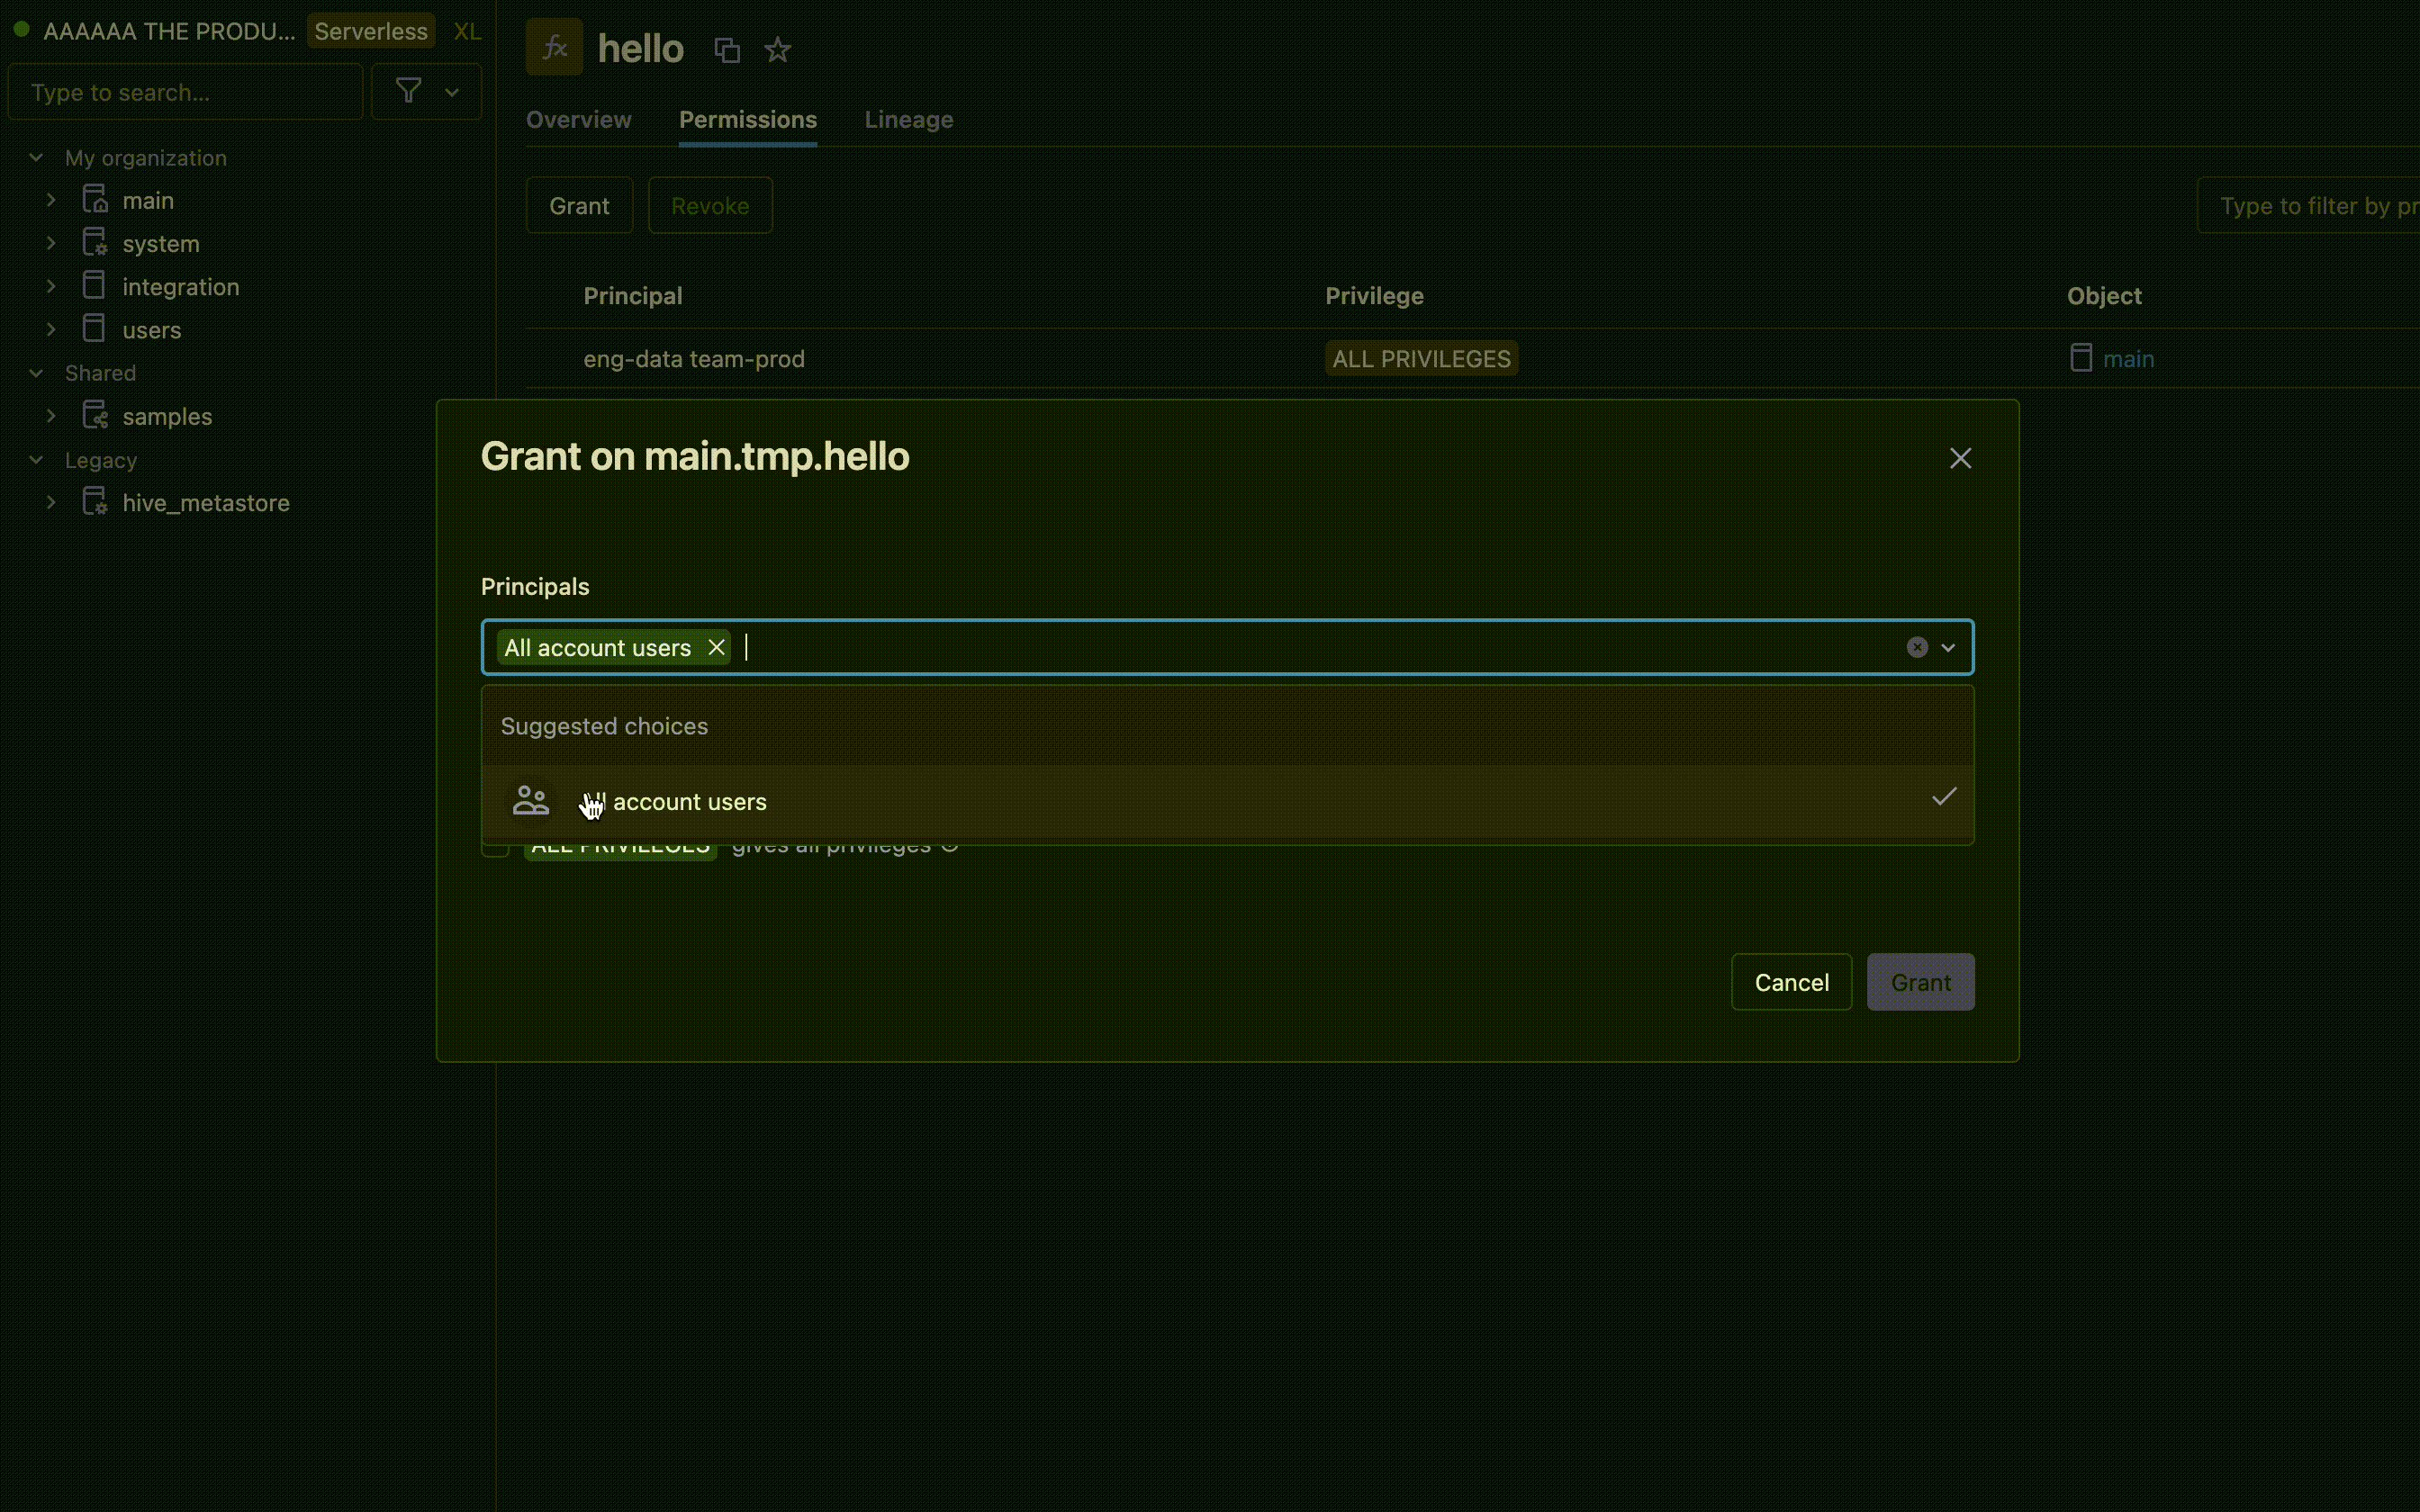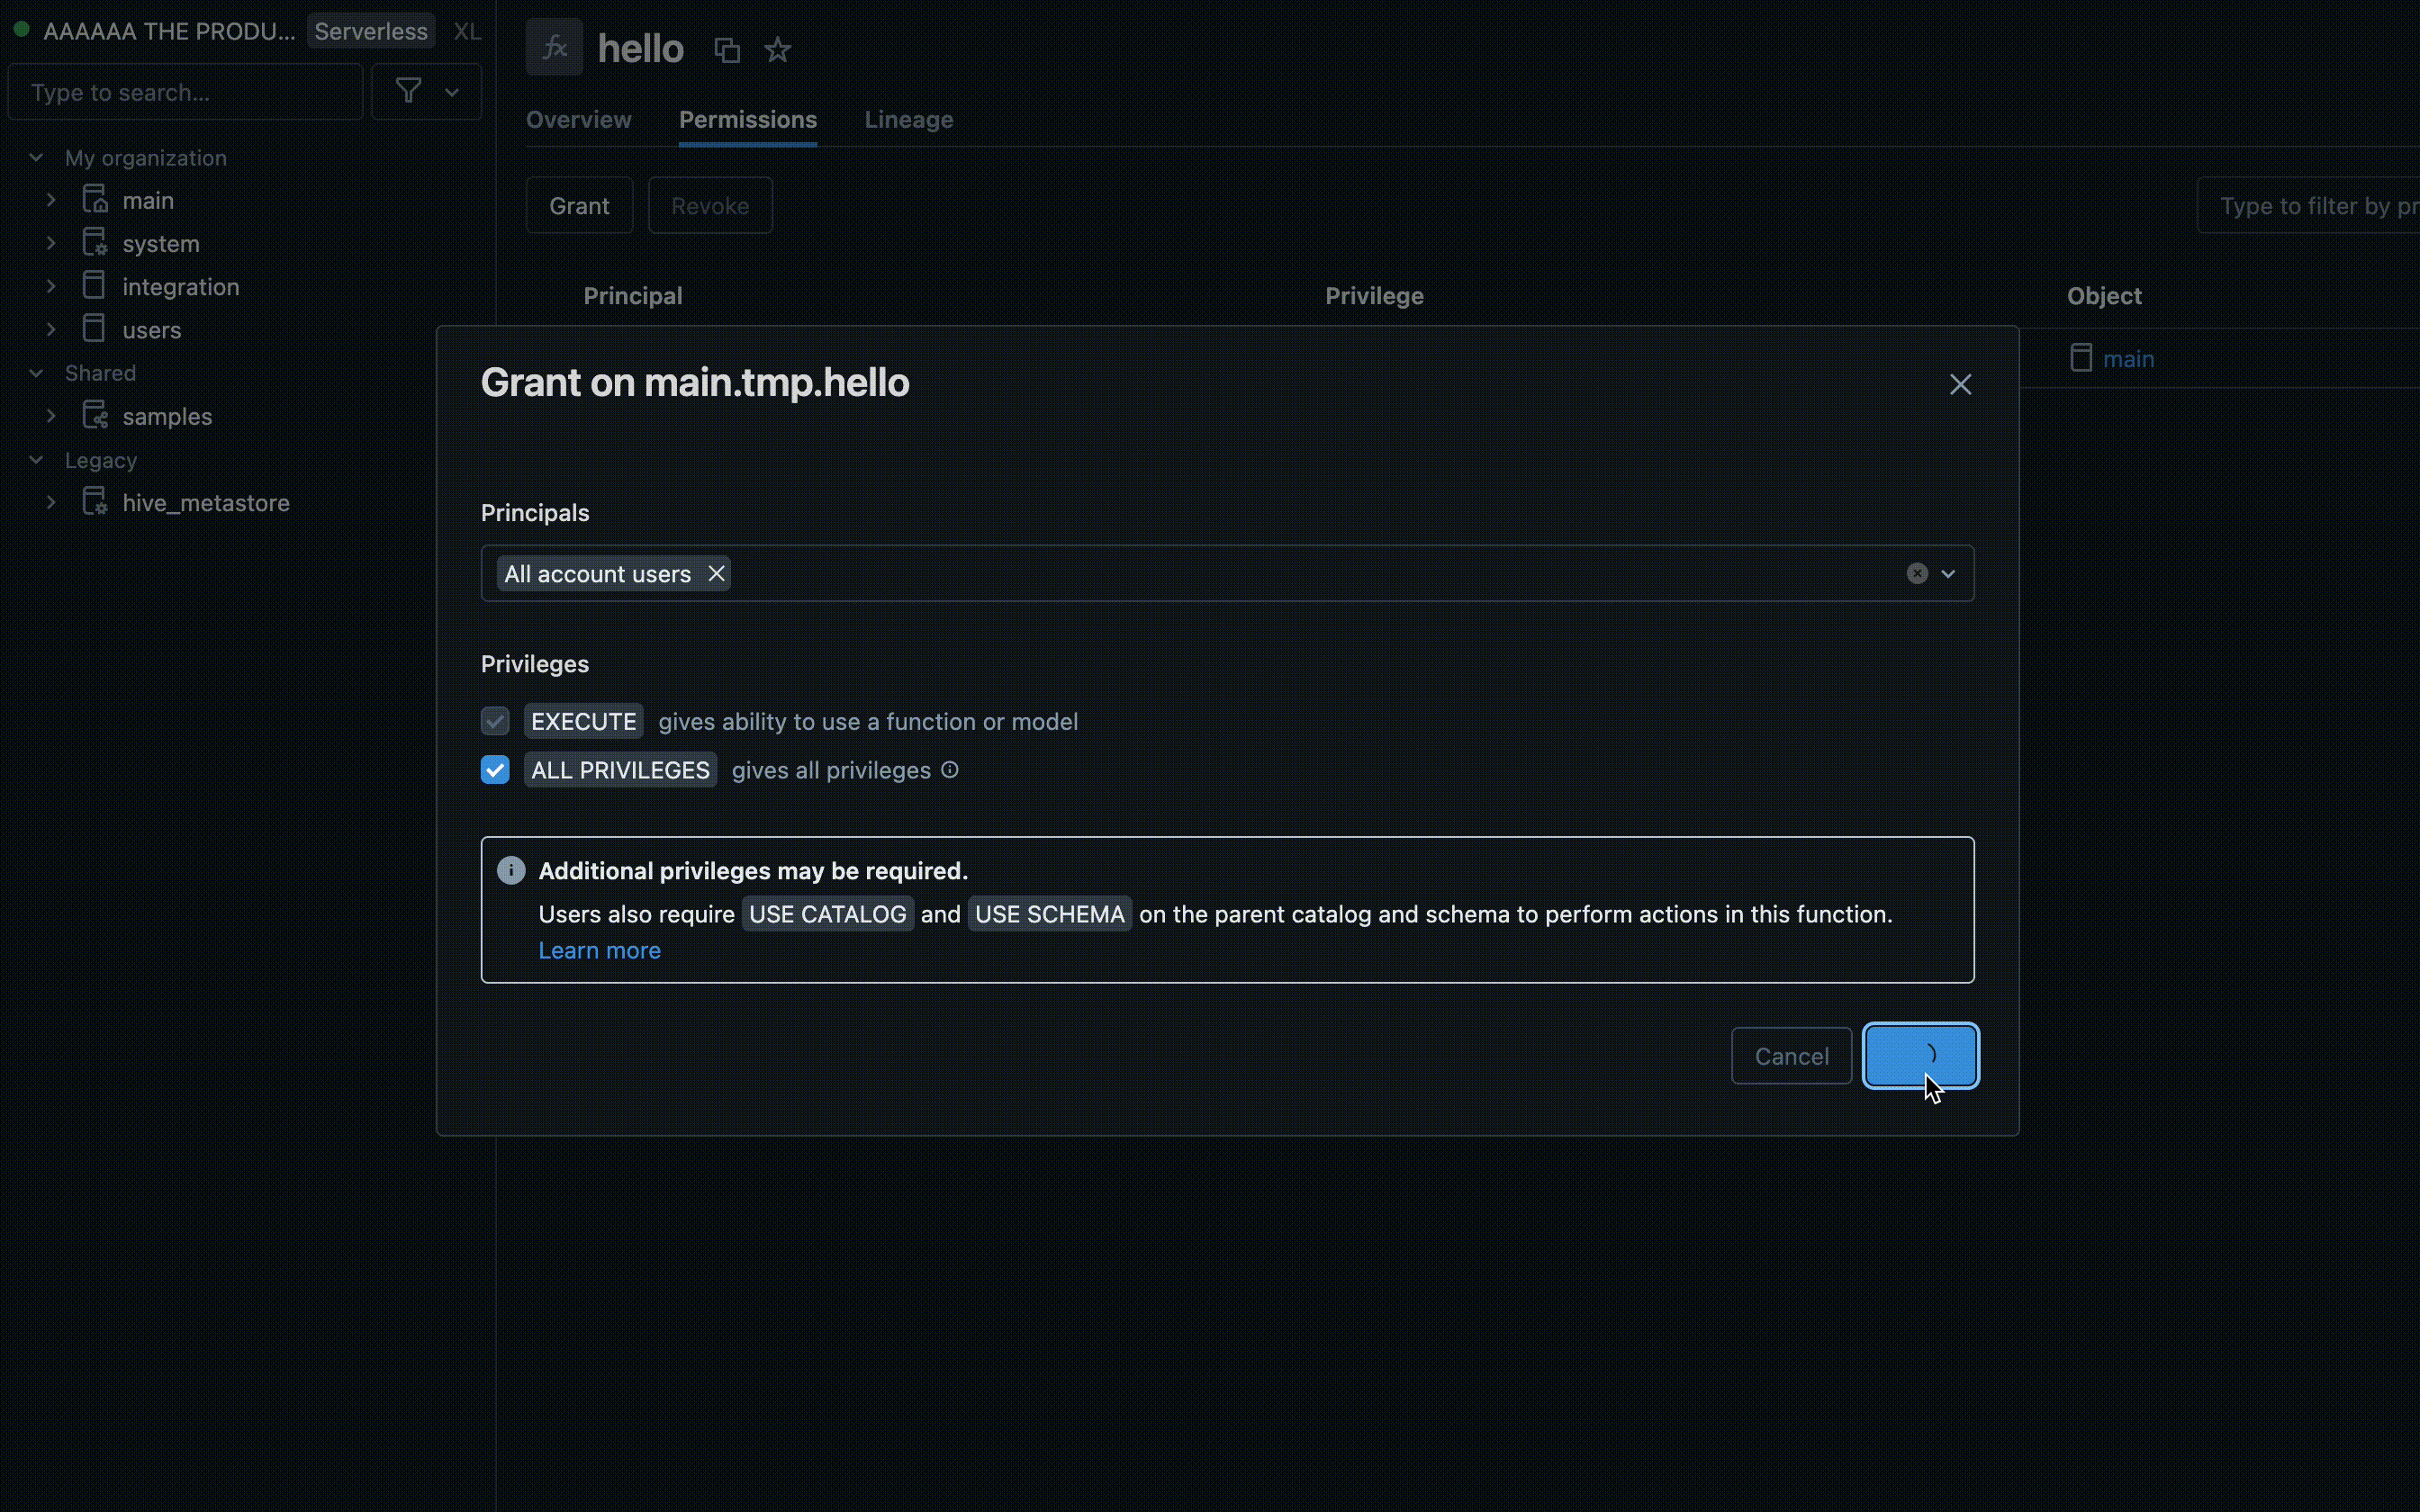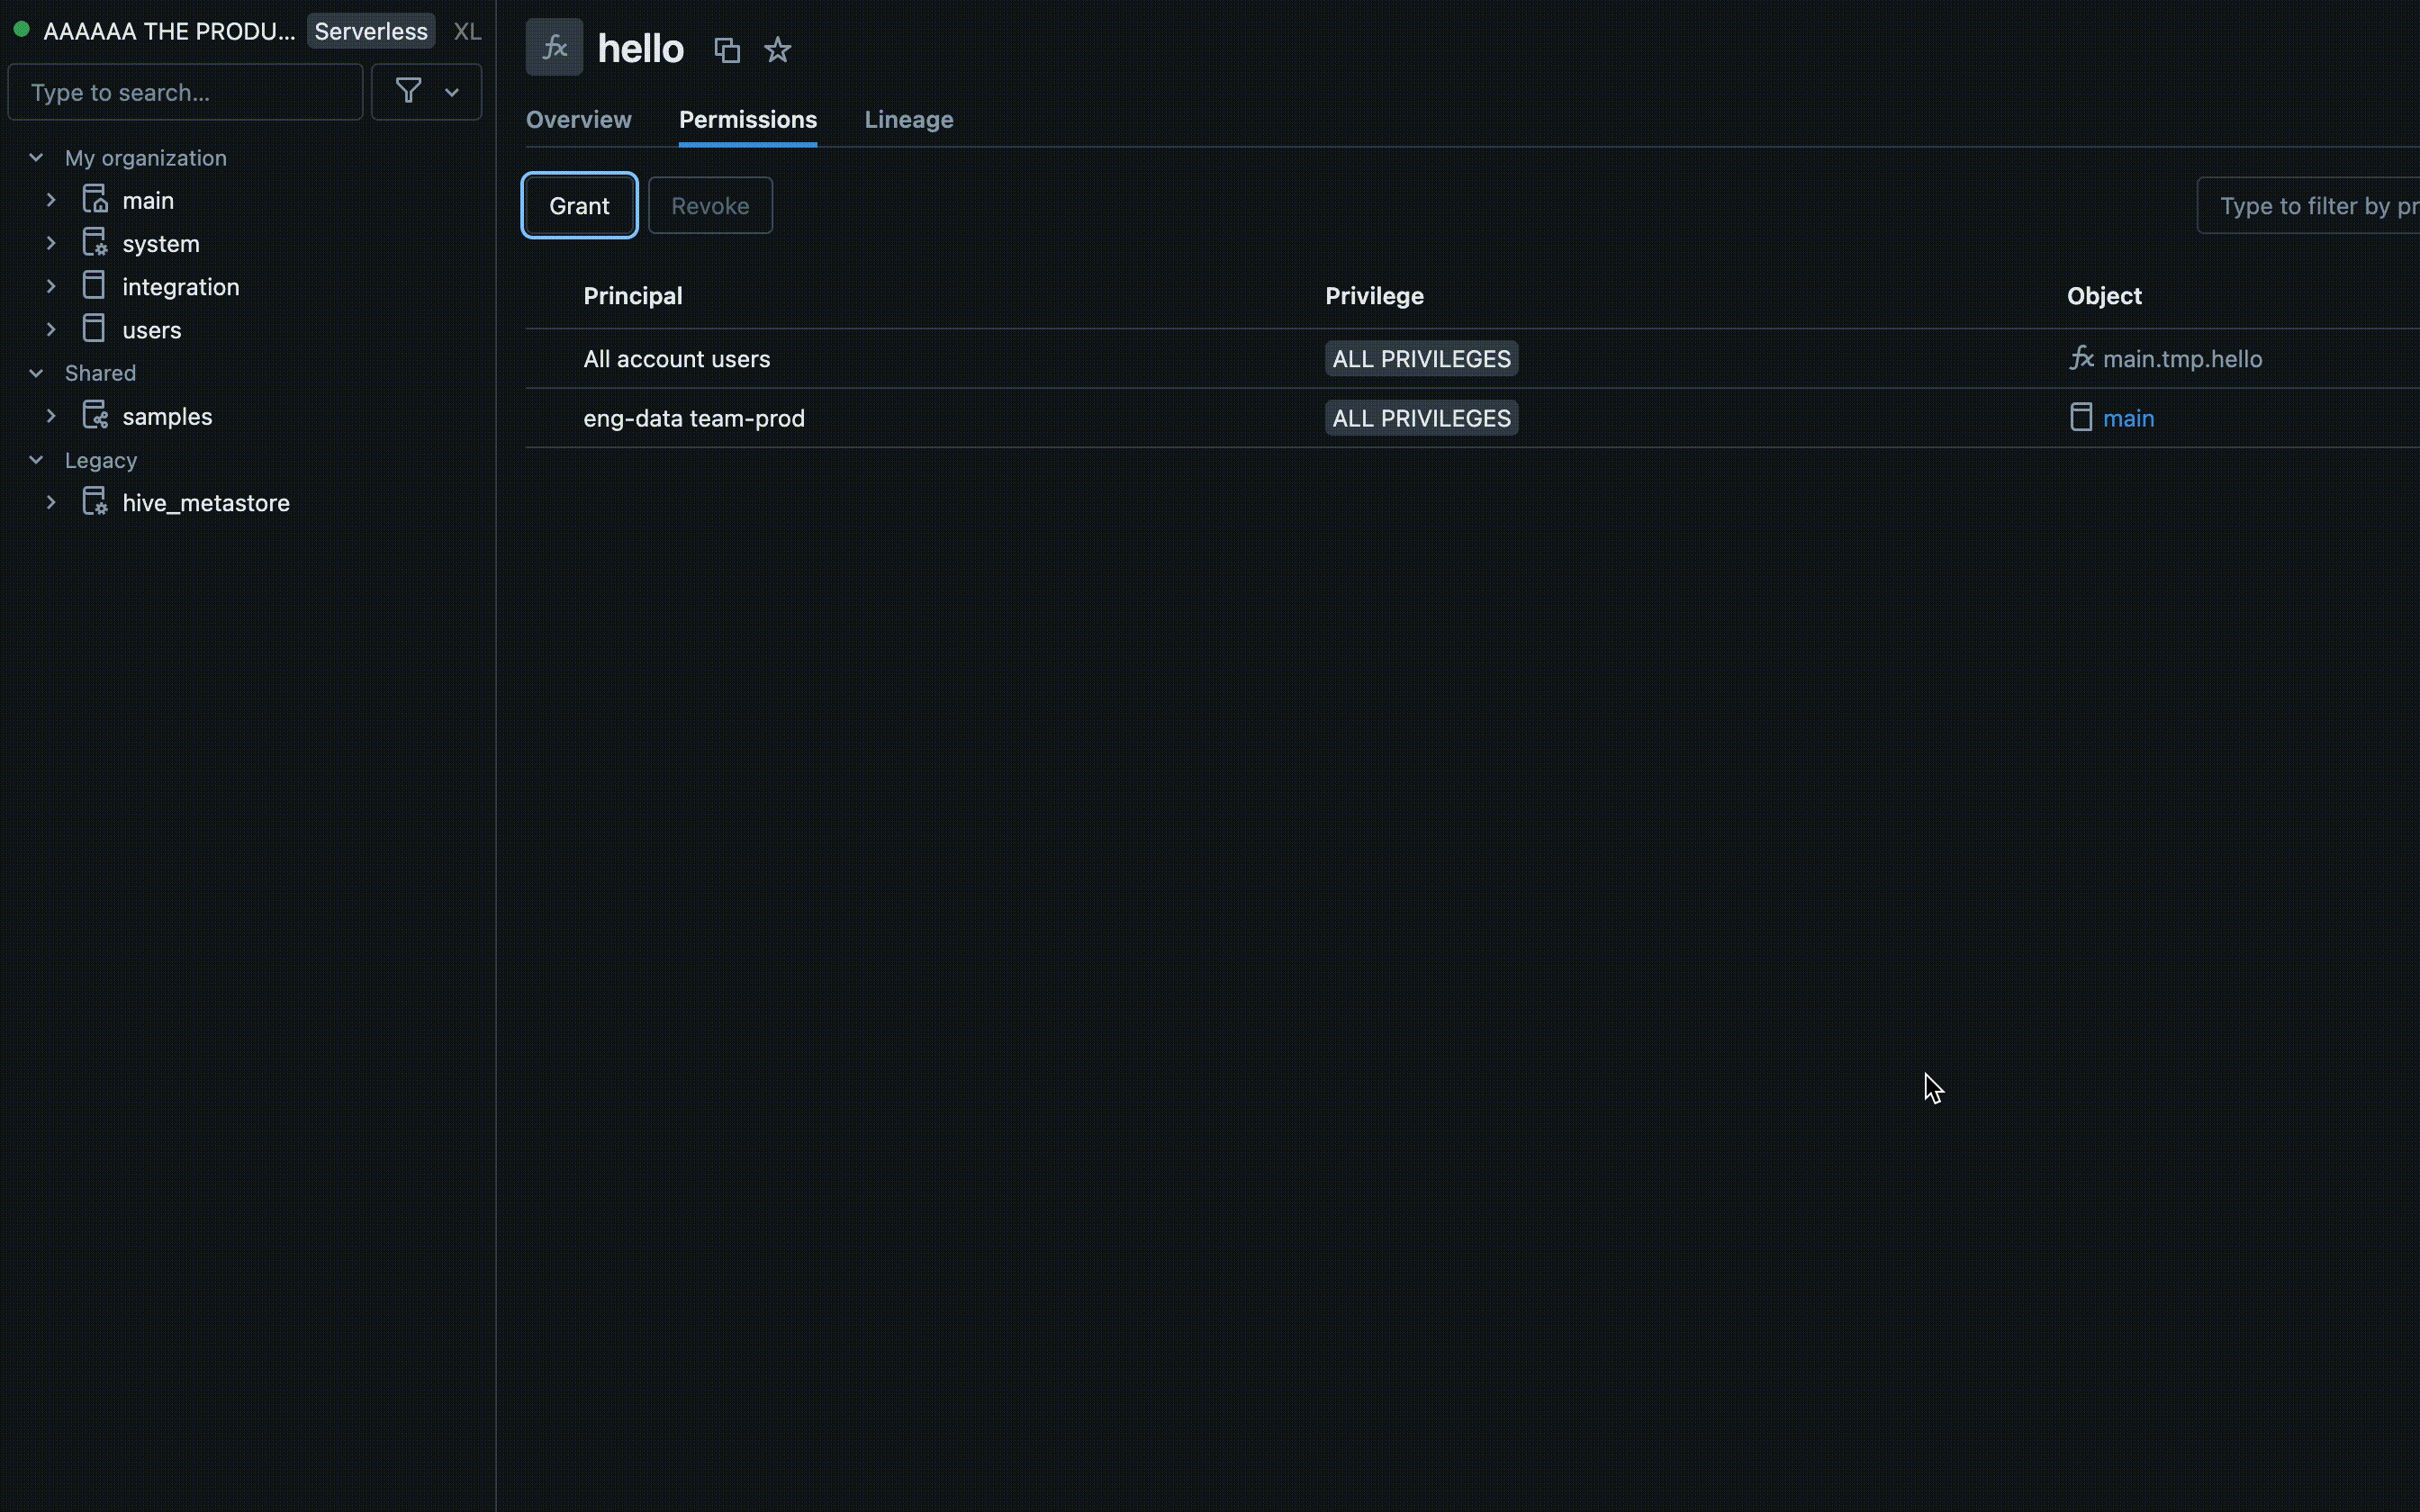
- Suchen Sie den Katalog und das Schema, in dem Ihre UDF gespeichert ist, und wählen Sie die UDF aus.
- Suchen Sie in den UDF-Einstellungen nach einer Berechtigungsoption . Fügen Sie Benutzer oder Gruppen hinzu, und geben Sie den Zugriffstyp an, über den sie verfügen müssen, z. B. EXECUTE oder MANAGE.
Berechtigungen mit Azure Databricks SQL
Im folgenden Beispiel wird einem Benutzer die EXECUTE-Berechtigung für eine Funktion gewährt:
GRANT EXECUTE ON FUNCTION my_catalog.my_schema.calculate_bmi TO `user@example.com`;
Um Berechtigungen zu entfernen, verwenden Sie den REVOKE Befehl wie im folgenden Beispiel:
REVOKE EXECUTE ON FUNCTION my_catalog.my_schema.calculate_bmi FROM `user@example.com`;
Umgebungsisolation
Hinweis
Umgebungen mit gemeinsamer Isolation erfordern Databricks Runtime 18.1 oder höher. In früheren Versionen werden alle Unity Catalog Python UDFs im strikten Isolationsmodus ausgeführt.
Unity Catalog Python UDFs mit demselben Besitzer und derselben Sitzung können standardmäßig eine Isolationsumgebung verwenden. Dies verbessert die Leistung und reduziert die Speicherauslastung, indem die Anzahl der separaten Umgebungen reduziert wird, die gestartet werden müssen.
Strenge Isolierung
Um zu überprüfen, ob eine UDF immer in einer eigenen, vollständig isolierten Umgebung ausgeführt wird, fügen Sie die STRICT ISOLATION Merkmalsklausel hinzu.
Die meisten UDFs benötigen keine strenge Isolierung. Standarddatenverarbeitungs-UDFs profitieren von der standardmäßigen gemeinsamen Isolationsumgebung und können schneller bei geringerer Speichernutzung ausgeführt werden.
Fügen Sie die Merkmalsklausel STRICT ISOLATION zu UDFs hinzu, die:
- Führen Sie Eingaben als Code mithilfe von
eval(),exec()oder ähnlichen Funktionen aus. - Schreiben Sie Dateien in das lokale Dateisystem.
- Ändern sie globale Variablen oder den Systemstatus.
- Zugreifen oder Ändern von Umgebungsvariablen
Der folgende Code zeigt ein Beispiel für eine UDF, die mit STRICT ISOLATION ausgeführt werden muss. Diese UDF führt beliebigen Python Code aus, sodass sie den Systemzustand, Zugriffsumgebungsvariablen oder Schreibzugriff auf das lokale Dateisystem ändern kann. Die Verwendung der STRICT ISOLATION Klausel trägt dazu bei, Störungen oder Datenlecks über UDFs hinweg zu verhindern.
CREATE OR REPLACE TEMPORARY FUNCTION run_python_snippet(python_code STRING)
RETURNS STRING
LANGUAGE PYTHON
STRICT ISOLATION
AS $$
import sys
from io import StringIO

# Capture standard output and error streams
captured_output = StringIO()
captured_errors = StringIO()
sys.stdout = captured_output
sys.stderr = captured_errors

try:
    # Execute the user-provided Python code in an empty namespace
    exec(python_code, {})
except SyntaxError:
    # Retry with escaped characters decoded (for cases like "\n")
    def decode_code(raw_code):
        return raw_code.encode('utf-8').decode('unicode_escape')
    python_code = decode_code(python_code)
    exec(python_code, {})

# Return everything printed to stdout and stderr
return captured_output.getvalue() + captured_errors.getvalue()
$$
Festlegen DETERMINISTIC , ob Ihre Funktion konsistente Ergebnisse erzeugt
Fügen Sie DETERMINISTIC ihrer Funktionsdefinition hinzu, wenn sie dieselben Ausgaben für die gleichen Eingaben erzeugt. Dadurch können Abfrageoptimierungen die Leistung verbessern.
Standardmäßig behandelt Azure Databricks Batch-Unity-Katalog Python UDFs als nicht deterministisch, es sei denn, Sie deklarieren ausdrücklich anders. Beispiele für nicht deterministische Funktionen sind das Generieren von Zufallswerten, der Zugriff auf aktuelle Uhrzeiten oder Datumsangaben oder das Tätigen externer API-Aufrufe.
Siehe CREATE FUNCTION (SQL, Python, Scala und Java)
UDFs für Agenttools
KI-Agents können Unity Catalog UDFs als Tools verwenden, um Aufgaben auszuführen und benutzerdefinierte Logik auszuführen.
Siehe Erstellen von Agent-Tools mit Unity Catalog-Funktionen.
UDFs für den Zugriff auf externe APIs
Sie können UDFs verwenden, um über SQL auf externe APIs zuzugreifen. Im folgenden Beispiel wird die Python-Bibliothek requests verwendet, um eine HTTP-Anforderung zu erstellen.
Hinweis
Python-UDFs ermöglichen TCP/UDP-Netzwerkdatenverkehr über die Ports 80, 443 und 53 bei Verwendung von serverlosem Computing oder von Compute-Konfigurationen im Standardzugriffsmodus.
CREATE FUNCTION my_catalog.my_schema.get_food_calories(food_name STRING)
RETURNS DOUBLE
LANGUAGE PYTHON
AS $$
import requests

api_url = f"https://example-food-api.com/nutrition?food={food_name}"
response = requests.get(api_url)

if response.status_code == 200:
   data = response.json()
   # Assume the API returns a JSON object with a 'calories' field
   calories = data.get('calories', 0)
   return calories
else:
   return None  # API request failed

$$;
UDFs für Sicherheit und Compliance
Verwenden Sie Python UDFs, um benutzerdefinierte Tokenisierung, Datenmasken, Daten redaction oder Verschlüsselungsmechanismen zu implementieren.
Im folgenden Beispiel wird die Identität einer E-Mail-Adresse maskiert, während Länge und Domäne beibehalten werden:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.mask_email(email STRING)
RETURNS STRING
LANGUAGE PYTHON
DETERMINISTIC
AS $$
parts = email.split('@', 1)
if len(parts) == 2:
  username, domain = parts
else:
  return None
masked_username = username[0] + '*' * (len(username) - 2) + username[-1]
return f"{masked_username}@{domain}"
$$
Im folgenden Beispiel wird diese UDF in einer dynamischen Ansichtsdefinition angewendet:
-- First, create the view
CREATE OR REPLACE VIEW my_catalog.my_schema.masked_customer_view AS
SELECT
  id,
  name,
  my_catalog.my_schema.mask_email(email) AS masked_email
FROM my_catalog.my_schema.customer_data;

-- Now you can query the view
SELECT * FROM my_catalog.my_schema.masked_customer_view;
+---+------------+------------------------+------------------------+
| id|        name|                   email|           masked_email |
+---+------------+------------------------+------------------------+
|  1|    John Doe|   john.doe@example.com |  j*******e@example.com |
|  2| Alice Smith|alice.smith@company.com |a**********h@company.com|
|  3|   Bob Jones|    bob.jones@email.org |   b********s@email.org |
+---+------------+------------------------+------------------------+
Bewährte Methoden
Damit UDFs für alle Benutzer zugänglich sind, empfiehlt Databricks, einen dedizierten Katalog und ein dediziertes Schema mit entsprechenden Zugriffssteuerelementen zu erstellen.
Verwenden Sie für teamspezifische UDFs ein dediziertes Schema im Teamkatalog für Speicher und Verwaltung.
Databricks empfiehlt Ihnen, die folgenden Informationen in den UDF-Dokstring einzubeziehen:
- Die aktuelle Versionsnummer
- Ein Änderungsprotokoll zum Nachverfolgen von Änderungen in allen Versionen
- Zweck, Parameter und Rückgabewert der UDF
- Ein Beispiel für die Verwendung der UDF
Das folgende Beispiel zeigt eine UDF, die bewährte Methoden befolgt:
CREATE OR REPLACE FUNCTION my_catalog.my_schema.calculate_bmi(weight_kg DOUBLE, height_m DOUBLE)
RETURNS DOUBLE
COMMENT "Calculates Body Mass Index (BMI) from weight and height."
LANGUAGE PYTHON
DETERMINISTIC
AS $$
 """
Parameters:
calculate_bmi (version 1.2):
- weight_kg (float): Weight of the individual in kilograms.
- height_m (float): Height of the individual in meters.

Returns:
- float: The calculated BMI.

Example Usage:

SELECT calculate_bmi(weight, height) AS bmi FROM person_data;

Change Log:
- 1.0: Initial version.
- 1.1: Improved error handling for zero or negative height values.
- 1.2: Optimized calculation for performance.

 Note: BMI is calculated as weight in kilograms divided by the square of height in meters.
 """
if height_m <= 0:
 return None  # Avoid division by zero and ensure height is positive
return weight_kg / (height_m ** 2)
$$;
Zeitzonenverhalten von Zeitstempeln für zeilenweise Eingaben
Ein TIMESTAMP Eingabewert erreicht eine zeilenweise Python-UDF als zeitzonennaiver datetime Wert in UTC. Bei klassischer Berechnung erfordert dieses Verhalten Databricks Runtime 18.1 oder höher. Legen Sie in serverlosen Rechenumgebungen sowie in Pro- und serverlosen SQL-Warehouses den environment_version der UDF explizit auf 6 oder höher fest. Das Objekt datetime enthält keine Zeitzonen-Metadaten in seinem tzinfo Attribut.
Batch Unity Catalog Python UDFs erhalten Zeitstempel-Eingaben in pandas.Series Objekten und verwenden diese datetime Abbildung nicht.
Diese Änderung vereinheitlicht Unity Catalog Python-UDFs mit Arrow-optimierten Python-UDFs in Apache Spark.
Zum Beispiel setzt die folgende Abfrage explizit die Umgebungsversion 6 und die Sitzungszeitzone auf UTC:
SET TIME ZONE 'UTC';

CREATE FUNCTION timezone_udf(date TIMESTAMP)
RETURNS STRING
LANGUAGE PYTHON
ENVIRONMENT (
  environment_version = '6'
)
AS $$
return f"{type(date)} {date} {date.tzinfo}"
$$;

SELECT timezone_udf(TIMESTAMP '2024-10-23 10:30:00');
Der frühere Ausführungspfad liefert einen zeitzonenbewussten Wert in der Sitzungszeitzone zurück. Dies gilt für klassische Rechenleistungen vor Databricks Runtime 18.1. Es gilt auch für serverlose Rechenleistungen sowie für professionelle und serverlose SQL-Warehouses, wenn man die ENVIRONMENT Klausel weglässt, setzt environment_version = 'None'oder eine Version früher als 6 auswählt. Mit der auf UTC gesetzten Sitzungszeitzone erzeugt der frühere Pfad:
<class 'datetime.datetime'> 2024-10-23 10:30:00+00:00 UTC
Bei der gezeigten Definition verwenden serverloses Computing sowie Pro- und Serverless-SQL-Warehouses das PySpark-kompatible Verhalten. Classic Compute mit Databricks Runtime 18.1 oder höher zeigt dasselbe Verhalten, wenn Sie die ENVIRONMENT-Klausel anpassen oder weglassen:
<class 'datetime.datetime'> 2024-10-23 10:30:00 None
Diese Änderung kann sowohl die Taktfelder als auch tzinfo betreffen. Für den Zeitpunkt 2024-10-23T10:30:00Z erzeugt das frühere Verhalten in einer America/Los_Angeles-Sitzung 2024-10-23 03:30:00-07:00. Das neue Verhalten erzeugt den zeitzonennaiven UTC-Wert 2024-10-23 10:30:00.
Wenn Ihr UDF auf Zeitzoneninformationen angewiesen ist, stellen Sie UTC explizit wieder her:
from datetime import timezone

date = date.replace(tzinfo=timezone.utc)
Das Hinzufügen von UTC-Zeitzoneninformationen stellt die vorherigen Sitzungs-lokalen Uhrfelder nicht wieder her. Wenn deine Logik diese Felder benötigt, konvertiere auch den bewussten Wert in die vorgesehene Sitzungszeitzone. Beispiel:
from zoneinfo import ZoneInfo

date = date.astimezone(ZoneInfo("America/Los_Angeles"))
Begrenzungen
- Sie können eine beliebige Anzahl von Python-Funktionen innerhalb einer Python-UDF definieren, aber alle müssen einen skalaren Wert zurückgeben.
- Python-Funktionen müssen NULL-Werte unabhängig verarbeiten, und alle Typzuordnungen müssen Azure Databricks SQL-Sprachzuordnungen folgen.
- Wenn Sie keinen Katalog oder schema angeben, registriert Azure Databricks Python UDFs im aktuellen aktiven Schema.
- Python UDFs werden in einer sicheren, isolierten Umgebung ausgeführt und haben keinen Zugriff auf Dateisysteme oder interne Dienste.
- Sie können in einer Abfrage auf klassischem Compute mit Databricks Runtime 18.1 oder höher mehr als fünf UDFs aufrufen. Bei serverloser Rechenleistung sowie bei Pro- und serverless SQL-Warehouses muss jede UDF-Definition
6explizit aufenvironment_versionoder höher festlegen.