Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Important
Elemente, die in diesem Artikel als Vorschau gekennzeichnet sind, befinden sich derzeit in der Vorschau. Diese Vorschauversion wird ohne Service Level Agreement bereitgestellt, und Microsoft empfiehlt ihren Einsatz nicht für Produktionsworkloads. Manche Features werden möglicherweise nicht unterstützt oder sind nur eingeschränkt verwendbar. Weitere Informationen finden Sie unter Zusätzliche Nutzungsbedingungen für Microsoft Azure-Vorschauversionen.
Important
Interaktives Training erfordert eine explizite Zugriffsgenehmigung. Fordern Sie den Zugriff über das Vorschau-Registrierungsformular an, und warten Sie vor dem Erstellen einer Schulungssitzung auf die Genehmigung.
Interaktives Training (Vorschau) ist eine API zum Erstellen Ihrer eigenen Post-Training-Schleife für Open-Weight-Modelle in Microsoft Foundry. Sie steuern das Experiment in Python. Foundry führt Modell-Sampling- und LoRA-Updates (Low-Rank Adaption) auf serverlosen GPUs aus.
Für bestärkendes Lernen (RL) steuert Ihr Code die Rollout-Sammlung, Belohnungen, Vorteile und die Planung von Updates. Dieselben Primitiven unterstützen überwachtes Lernen, Präferenzlernen, Wissensdistillation und Workflows für benutzerdefinierte Verlustfunktionen.
Wann wird es verwendet?
Verwenden Sie interaktive Schulungen, wenn die Trainingsschleife selbst Teil Ihrer Forschung ist:
- Sie benötigen ein benutzerdefiniertes Lernsignal. Bereitstellen von Demonstrationen, Berechnen von Belohnungen und Vorteilen oder Erstellen einer lokalen Verlustfunktion für Präferenzlernen oder andere Ziele.
- Ihr Modell interagiert mit einer Umgebung. Koordinieren Sie Modellantworten, Toolaufrufe, Beobachtungen und Belohnungen in Ihrem Treiber.
- Sie müssen einzelne Updates steuern können. Wählen Sie Batches, Tokenmasken, Verlusteinstellungen und Optimiererparameter aus. Entscheiden Sie, wann Gradienten akkumuliert werden sollen, und wenden Sie ein Update an.
- Sie möchten ein Experiment prüfen und anpassen. Erstellen Sie Stichproben aus dem aktuellen Adapter, werten Sie sie anhand zurückgehaltener Prompts aus und wählen Sie die nächsten Prompts auf Grundlage der beobachteten Ergebnisse aus.
- Sie müssen den Fortschritt speichern und fortsetzen. Speichern Sie den Adapter- und Optimiererstatus, und setzen Sie dann in einer kompatiblen Sitzung fort. Behalten Sie die Position des Datasets und den anderen Experimentstatus in Ihrem Treiber bei.
Verwaltete Feinabstimmung unterstützt auch Grader für Reinforcement-Fine-Tuning. Wählen Sie interaktive Schulungen aus, wenn Sie die Kontrolle über die Schleife benötigen, nicht nur über die Grader- oder Jobeinstellungen. Siehe Wählen Sie Ihren Schulungsansatz.
Wer macht was?
Ihr Python Programm ist der Trainingstreiber. Es bereitet Eingaben vor und koordiniert das Experiment. Foundry verwaltet den Modell- und Adapterstatus und führt die angeforderten Vorgänge aus.
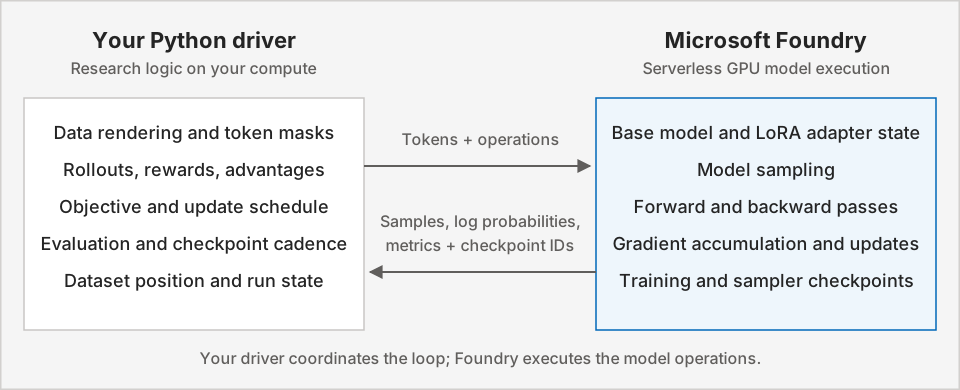
Ihr Treiber kann auf einer CPU ausgeführt werden, einschließlich Ihres eigenen Computers und einer Rechenumgebung. Ein Belohnungsmodell oder eine von Ihnen hinzugefügte Umgebung kann über eigene Computeanforderungen verfügen. Halten Sie den Driver am Laufen, während er die Schleife verwaltet.
Kernkonzepte und Primitive
Eine Sitzung ist zustandsbehaftet: Gradientenberechnung, Optimiereraktualisierungen und Sampling sind separate Vorgänge für ein ausgewähltes Modell und Adapter. Mit dieser Trennung können Sie auswählen, wann Daten gesammelt, Gradienten akkumuliert, aktualisiert und ausgewertet werden sollen.
| Baustein | Was es bewirkt |
|---|---|
| Schulungssitzung und LoRA-Adapter |
FineTuningSession.create initialisiert ein unterstütztes Basismodell mit der Adapterkonfiguration. Die Sitzung enthält den Zustand, der von nachfolgenden Vorgängen verwendet wird. |
| Tokenisierter Stapel und Masken |
Datum trägt Modelleingaben und Loss-Eingaben. Masken wählen aus, welche Token zum Lernen beitragen, z. B. Assistententoken anstelle von Eingabeaufforderungen oder Toolbeobachtungen. |
| Probenahme |
sample generiert Antworten mithilfe eines ausgewählten Sampler-Checkpoints. RL-Eingaben koppeln gesampelte Token mit ihren Rolloutprotokoll-Wahrscheinlichkeiten und von Belohnung abgeleiteten Vorteilen. |
| Vorwärts- und Rückwärtsdurchläufe |
forward gibt die Ausgaben der Verlustfunktion pro Beispiel zurück, ohne Gradienten zu akkumulieren.
forward_backward berechnet das ausgewählte Ziel und akkumuliert Gradienten. Es wird kein Optimiererupdate angewendet. |
| Optimierer-Update |
optim_step wendet akkumulierte Gradienten mit Ihren Adam-Parametern an. Sie entscheiden, wann sie aktualisieren und welche Lernrate verwendet werden soll. |
| Sampler-Checkpoint |
save_weights_for_sampler bereitet die Adaptergewichte für die Generierung vor. Aktualisieren Sie diese Gewichtungen nach einem Update, bevor Sie Stichproben aus dem aktualisierten Adapter ziehen. |
| Schulungskontrollpunkt |
save_weights Behält die Adaptergewichte und den Optimiererzustand bei.
FineTuningSession.create_from_checkpoint setzt das Training in einer kompatiblen Sitzung fort. |
Das SDK umfasst cross_entropy für überwachte Updates und RL-Verluste wie importance_sampling und ppo. Diese Losses sind grundlegende Losses, keine vordefinierten End-to-End-Algorithmen. Zu input contracts und custom-loss composition siehe Key concepts.
Funktionsweise einer RL-Schleife
Betrachten Sie ein Experiment zum mathematischen Schlussfolgern: Ihr Modell generiert mehrere Antworten auf jedes Problem, und Ihr Programm bewertet deren Richtigkeit. Folgen Sie für ein konkretes Beispiel Erste Schritte.
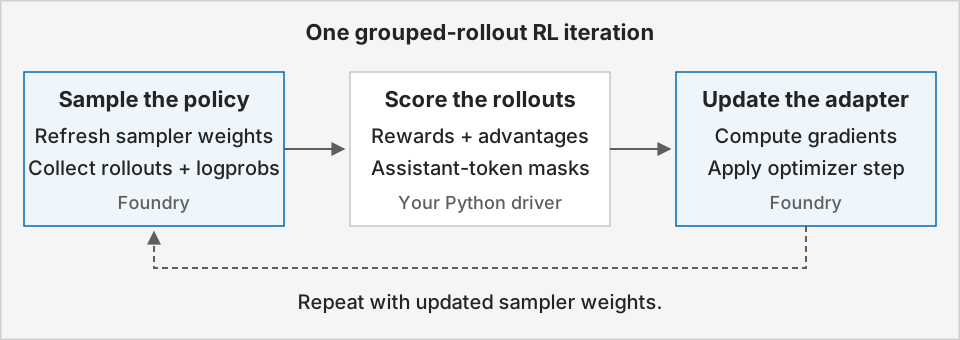
Richten Sie eine Holdout-Basislinie ein und testen Sie Ihre Belohnungsfunktion vor dem ersten Update. Dann wiederholen:
- Bereiten Sie die aktuelle Policy für das Sampling vor. Speichern Sie Samplergewichte vom Schulungsadapter, sammeln Sie dann für jede Aufforderung mehrere Antworten oder Rollouts.
- Bewerten und vergleichen Sie Antworten. Ihre Belohnungsfunktion weist jedem Rollout eine Bewertung zu. Subtrahieren Sie die mittlere Belohnung der Eingabeaufforderungsgruppe, um den advantage jedes Rollouts zu erzeugen.
- Bereiten Sie das Lernsignal vor. Richten Sie gesampelte Assistant-Token mit ihren Rolloutprotokoll-Wahrscheinlichkeiten und Advantage-Werten aus. Schließen Sie Prompts und Umgebungsbeobachtungen vom Lernsignal aus.
- Gradienten berechnen. Senden Sie den Batch an
forward_backwardmitimportance_sampling. Schließen Sie die Gradientenberechnung vor dem Update ab, das sie verwendet. - Aktualisieren Sie den Adapter. Rufen Sie
optim_stepauf, aktualisieren Sie dann die Sampler-Gewichtung, bevor Sie Antworten aus der aktualisierten Richtlinie sammeln. - Fortschritt auswerten und beibehalten. Vergleichen Sie die Validierungsgenauigkeit mit der Baseline und speichern Sie Trainings-Checkpoints in der von Ihnen gewählten Häufigkeit.
Get started
Wählen Sie den Ausgangspunkt aus, der zu Ihrer Aufgabe passt:
- Schnellstart: Folgen Sie dem Schnellstartbeispiel , um das Repository zu klonen und ein kurzes Verstärkungslernrezept auszuführen.
- Probieren Sie andere Rezepte aus: Erkunden Sie das Repository mit Fine-Tuning-Beispielen für weitere Schulungsbeispiele.
- Nachschlagen eines Vorgangs: Verwenden Sie das SDK-Cheatsheet (Vorschau) für Funktionen und Schlüsselparameter.
- Grundlegendes zur Trainingsschleife: Lesen Sie wichtige Konzepte für Belohnungen, Vorteile, Tokenmasken und Checkpoints.
Unterstützte Modelle und Regionen
Weitere Informationen finden Sie in der Feinabstimmungsübersicht für unterstützte Modelle und unterstützte Regionen.