Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Die Flex-Verarbeitung (Vorschau) bietet Inferenz mit 50 % Preisnachlass gegenüber der Standardverarbeitung für Workloads, die längere Antwortzeiten und die gelegentliche Nichtverfügbarkeit von Ressourcen tolerieren können. Wählen Sie die Flex-Verarbeitung für eine einzelne Anfrage an die Responses API oder die Chat Completions API aus, indem Sie service_tier auf flex festlegen.
Verwenden Sie die Flex-Verarbeitung für nichtinteraktive und arbeit mit niedrigerer Priorität, z. B. Modellauswertungen, Datenanreicherung, Dokumentanalyse und asynchrone Anwendungsworkflows. Verwenden Sie für latenzsensitive oder kapazitätsabhängige Workloads stattdessen die Standardverarbeitung, die Prioritätsverarbeitung oder den bereitgestellten Durchsatz.
Important
Mit der Einführung der Flex-Verarbeitung werden Anfragen, die service_tier auf flex setzen, nur verarbeitet, wenn das ausgewählte Modell die Flex-Verarbeitung unterstützt. Ein nicht unterstütztes Modell gibt einen HTTP 400 invalid_request_error zurück und fällt nicht auf die Standardverarbeitung zurück. Für die Flex-Verarbeitung gelten weder eine Latenz-SLA noch eine Service-SLA.
Voraussetzungen
Ein Azure-Abonnement. Erstellen Sie ein kostenloses Konto.
Eine Azure OpenAI-Ressource mit einem unterstützten Modell, das mithilfe des Global Standard-Bereitstellungstyps bereitgestellt wird.
Der Ressourcenendpunkt und ein API-Schlüssel oder Microsoft Entra ID-Anmeldeinformationen. In den Beispielen in diesem Artikel wird ein API-Schlüssel verwendet, der in der Umgebungsvariable
AZURE_OPENAI_API_KEYgespeichert ist.Eine Workload, die variable Latenz und vorübergehende nicht verfügbare Antworten auf Ressourcen tolerieren kann.
Python 3.10 oder höher und das OpenAI Python-Paket für die Python Beispiele:
pip install --upgrade openai
Senden einer Flex-Anforderung
Setzen Sie in jeder Anfrage, die Flex-Verarbeitung verwenden soll, service_tier auf flex. Der model Wert ist der Name ihrer Azure Modellbereitstellung.
Python
Im folgenden Beispiel wird eine Flex-Anforderung mithilfe der Antwort-API gesendet:
import os

from openai import OpenAI

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

# Send a request for Flex processing.
response = openai.responses.create(
    model="YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    input="Analyze these records and summarize the recurring themes.",
    service_tier="flex",
)

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: flex
Die Antwort enthält die generierte Analyse und die Dienstebene, die die Anforderung verarbeitet.
Reference:Responses API
REST
Im folgenden Beispiel wird die gleiche Anforderung direkt an die Antwort-API gesendet:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "flex"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Um zu überprüfen, welche Ebene die Anforderung verarbeitet, überprüfen Sie das service_tier Feld in einer erfolgreichen Antwort.
Referenz:Responses API REST-Referenz
Auswählen einer Verarbeitungsoption
Flex, Standard und Priority Processing sind Optionen auf Dienstebene für Online-API-Anforderungen. Batch- und bereitgestellter Durchsatz sind separate Bereitstellungs- und Einkaufsoptionen.
| Option | Wie Sie es auswählen | Latenz und Verfügbarkeit | Kostenmodell | Am besten geeignet für: |
|---|---|---|---|---|
| Flex-Verarbeitung | Legen Sie die Anforderungsebene service_tier auf flex. |
Variable Latenz. Anforderungen können HTTP 429 zurückgeben, wenn die Flex-Kapazität nicht verfügbar ist. | 50% Rabatt gegenüber den Standardtokensätzen. Zwischengespeicherte Tokenrabatte gelten ebenfalls. | Auswertungen, Anreicherung, Offline-Analyse und verzögerungstolerante Hintergrundaufgaben. |
| Standardverarbeitung | Legen Sie die Anforderungsebene service_tier auf defaultoder verwenden Sie die standardebene, die für die Bereitstellung konfiguriert ist. |
Onlineverarbeitung nach dem Best-Effort-Prinzip für allgemeine Workloads. | Standardzahlungssatz pro Token. | Entwicklungs-, Test- und Produktions-Workloads mit schwankendem Verkehrsaufkommen. |
| Prioritätsverarbeitung | Konfigurieren Sie die Priorität bei der Bereitstellung oder setzen Sie die Einstellung auf Anforderungsebene von service_tier auf priority. |
Niedrigere und konsistentere Latenz mit einem definierten Ziel für unterstützte Modelle. | Prioritätssatz für Zahlung pro Token. | Latenzsensitive Onlineanwendungen ohne Verpflichtung zur reservierten Kapazität. |
| Batch | Übermitteln Sie einen asynchronen Batchauftrag an eine Batch-Bereitstellung. | Die Ergebnisse sollen innerhalb von 24 Stunden vorliegen. Kein Echtzeitlatenzziel. | Ermäßigter Batch-Tarif. | Große Offlineaufträge, für die keine sofortige Antwort erforderlich ist. |
| Bereitgestellter Durchsatz | Erstellen Sie ein bereitgestelltes Deployment und kaufen oder reservieren Sie bereitgestellte Durchsatzeinheiten (PTUs). | Reservierte Kapazität mit vorhersehbarer Durchsatz und Latenz. | Stündliche PTU-Abrechnung oder eine Azure-Reservierung. | Hochvolume, unternehmenskritische Produktionsarbeitslasten. |
Wählen Sie Flex-Verarbeitung aus, wenn alle folgenden Bedingungen gelten:
- Ihre Workload kann längere und schwankende Verarbeitungszeiten verkraften.
- Sie bevorzugen niedrigere Kosten gegenüber vorhersagbarer Latenz.
- Ihre Anwendung kann vorübergehende Fehler wiederholen oder eine fehlgeschlagene Anforderung an die Standardverarbeitung weiterleiten.
- Das ausgewählte Modell und der Anforderungskontext werden unterstützt.
Verwenden Sie Flex nicht, wenn eine der folgenden Bedingungen erfüllt ist:
- Ein Benutzer wartet auf eine interaktive Antwort.
- Die Anforderung muss innerhalb eines strengen Latenzziels abgeschlossen werden.
- Ihre Anwendung kann keine vorübergehenden HTTP 429-Antworten tolerieren oder wiederholen.
- Sie benötigen reservierte Verarbeitungskapazität oder vorhersehbaren Durchsatz.
Flex-Verarbeitung hat die folgenden Merkmale:
-
Auswahl auf Anfrageebene: Setzen Sie
service_tierbei jeder Anfrage, die die Flex-Verarbeitung verwenden soll, aufflex. - Keine separate Bereitstellung: Senden Sie Standard- und Flex-Anforderungen an dieselbe globale Standardbereitstellung, und wählen Sie die Ebene pro Anforderung aus.
- Unterstützte APIs: Verwenden Sie die Antwort-API oder die Chatabschluss-API.
- Synchrone Antwort: Der API-Aufruf bleibt synchron, auch wenn die Arbeitslast mehr Zeit in Anspruch nehmen kann. Die Flex-Verarbeitung ist nicht mit der Batch-API identisch.
- Kapazitätsabhängige Verfügbarkeit: Eine Anforderung kann HTTP 429 zurückgeben, wenn die Flex-Kapazität nicht verfügbar ist.
-
Kein automatischer Standard-Fallback: Ihre Anwendung muss explizit einen erneuten Versuch mit auf
defaultgesetztemservice_tierausführen, wenn eine Standardverarbeitung akzeptabel ist. - Freigegebenes Kontingent: Flex- und Standardanforderungen verwenden das Kontingent, das der globalen Standardbereitstellung zugewiesen ist.
- Gleiche Modellausgabequalität: Flex verwendet das gleiche zugrunde liegende Modell wie Standard. Die Verarbeitungsstufe ändert Latenz, Verfügbarkeit und Preis, nicht modellbezogene Qualität.
Note
Flex-Eingabe- und Ausgabetoken erhalten einen Rabatt von 50% gegenüber den entsprechenden Standardtokenraten. Berechtigte zwischengespeicherte Eingabetoken erhalten auch den entsprechenden Zwischenspeicherungstokenrabatt. Aktuelle Preise finden Sie unter Azure OpenAI-Preise.
Überprüfen unterstützter Modelle
Flex Processing ist zum Start nur für eine begrenzte Anzahl von Modellen verfügbar.
gpt-5.6-sol ist das erste unterstützte Modell. In der folgenden Tabelle sind unterstützte Modelle aufgeführt. Microsoft fügt weitere Modelle hinzu, wenn die Unterstützung verfügbar wird.
| Modell | Version | Bereitstellungstyp | Verfügbarkeit der Region |
|---|---|---|---|
gpt-5.6-sol |
2026-07-09 |
Globaler Standard | Alle Azure Regionen, in denen Global Standard verfügbar ist |
Überprüfen Sie diese Tabelle, bevor Sie eine Flex-Anforderung senden. Gehen Sie nicht davon aus, dass ein Modell oder eine neue Modellversion die Flex-Verarbeitung unterstützt, nur weil es die Standard- oder Prioritätsverarbeitung unterstützt. Ein nicht unterstütztes Modell gibt HTTP 400 zurück. Um Unterbrechungen Ihrer Anwendung zu vermeiden, implementieren Sie einen Fallback auf Anwendungsebene für die Standardverarbeitung, wenn Standardtarife und Leistung akzeptabel sind.
Auf Standardverarbeitung zurückgreifen
Die Flex-Verarbeitung leitet eine Anforderung nicht automatisch an Standard weiter, wenn die Flex-Kapazität nicht verfügbar ist. Wenn das Abschließen der Anfrage wichtiger ist als die Beibehaltung der Flex-Preise, wiederholen Sie die Anfrage mit service_tier, festgelegt auf default.
Das folgende Beispiel verwendet eine Richtlinie, bei der Abschlüsse priorisiert werden. Es versucht zunächst die Flex-Verarbeitung und wiederholt den Vorgang nach einer HTTP-429-Antwort einmal mit der Standardverarbeitung:
import os

from openai import OpenAI, RateLimitError

AZURE_OPENAI_ENDPOINT = "https://YOUR-RESOURCE-NAME.openai.azure.com"

# Create a client with a longer timeout for Flex requests.
openai = OpenAI(
    base_url=f"{AZURE_OPENAI_ENDPOINT}/openai/v1/",
    api_key=os.environ["AZURE_OPENAI_API_KEY"],
    timeout=900.0,
)

request = {
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
}

# Try Flex processing, and fall back to Standard after an HTTP 429 response.
try:
    response = openai.responses.create(**request, service_tier="flex")
except RateLimitError:
    response = openai.responses.create(**request, service_tier="default")

print(response.output_text)
print(f"Processed by service tier: {response.service_tier}")
<generated-analysis>
Processed by service tier: <flex-or-default>
Fallback auf Standard ändert die Preis- und Leistungsmerkmale der Anforderung. Verwenden Sie dieses Muster nur, wenn für die Workload Standardpreise akzeptabel sind.
Eine HTTP 429-Antwort kann auf nicht verfügbare Flex-Kapazität oder ein Kontingentlimit hinweisen. Da Flex- und Standardverarbeitung dasselbe Kontingent nutzen, kann die Standardanfrage ebenfalls fehlschlagen, wenn die ursprüngliche Antwort durch das Kontingent verursacht wurde. Wenden Sie Wiederholungslimits an und verarbeiten Sie ein zweites RateLimitError in Ihrer Anwendung. Wenn der Dienst den Flex-spezifischen Fehlerbezeichner zurückgibt, verwenden Sie ihn, um fallback auf kapazitätsbezogene Antworten zu beschränken.
Für Workloads, bei denen die niedrigsten Kosten im Vordergrund stehen, versuchen Sie die Flex-Verarbeitung mit exponentiellem Backoff erneut, bevor Sie auf eine Ausweichoption zurückgreifen. Bei Arbeitslasten, die die Abschlusszeit priorisieren, können Sie nach dem ersten Flex-Kapazitätsfehler auf Standard zurückgreifen.
Referenz:RateLimitError
Flex-Fehler behandeln
Unterscheiden Sie dauerhafte Anforderungsfehler von vorübergehenden Kapazitätsfehlern.
| HTTP-Status | Fehler | Ursache | Empfohlene Behandlung |
|---|---|---|---|
| 400 | invalid_request_error |
Das ausgewählte Modell, die Modellversion, die Kontextlänge, die API oder die Anforderungskonfiguration unterstützt keine Flex-Verarbeitung. | Wiederholen Sie nicht die gleiche Anforderung unverändert. Wählen Sie ein unterstütztes Modell oder eine unterstützte Kontextlänge aus, oder versuchen Sie es explizit erneut, indem Sie service_tier auf default setzen. |
| 408 | Anforderungszeitlimit | Die Anforderung wird nicht innerhalb des konfigurierten Client- oder Diensttimeouts abgeschlossen. Flex-Anforderungen können länger dauern als Standardanforderungen. | Verwenden Sie ein längeres Timeout für den Client. Versuchen Sie es erneut mit begrenztem exponentiellem Backoff. Wenn die Fertigstellungszeit wichtiger ist als Flex-Preise, versuchen Sie es mit Standard erneut. |
| 429 | Ressource nicht verfügbar oder Rate begrenzt | Flex-Kapazität ist vorübergehend nicht verfügbar, oder die Anforderung hat einen anwendbaren Satzgrenzwert überschritten. Flex-Kapazität ist unterbrechbar, daher ist eine vorübergehende Nichtverfügbarkeit während der Spitzenzeiten wahrscheinlicher. | Wenn die Anfrage ein Ratenlimit überschritten hat, erhöhen Sie das Ratenlimit der Bereitstellung „Global Standard“, indem Sie mehr Kontingent zuweisen. Flex und Standard teilen dieses Kontingent. Wenn das Abonnement nicht über genügend Kontingent für eine Workload mit großem Durchsatz verfügt, fordern Sie eine Kontingenterhöhung an. Wenn die Flex-Kapazität vorübergehend nicht verfügbar ist, versuchen Sie es erneut mit exponentiellem Backoff und Jitter, verteilen Sie aufschiebbare Workloads auf Schwachlastzeiten wie Abende unter der Woche oder Wochenenden, oder versuchen Sie es erneut mit service_tier, das auf default festgelegt ist. Berücksichtigen Sie Retry-After, wenn vorhanden. |
| 500, 502, 503 oder 504 | Vorübergehender Dienstfehler | Ein temporäres Dienst- oder Gatewayproblem verhinderte den Abschluss. | Versuchen Sie es erneut mit begrenztem exponentiellem Backoff. Senden Sie keine unbegrenzte Anzahl von Wiederholungen. |
| 401 oder 403 | Authentifizierung oder Autorisierungsfehler | Die Anmeldeinformation fehlt, ist ungültig, abgelaufen oder berechtigt nicht zum Zugriff auf die Ressource. | Korrigieren Sie die Zuweisung von Anmeldeinformationen oder Rollen. Wiederholen Sie den Vorgang nicht, bis sich die Konfiguration ändert. |
| 404 | Bereitstellung nicht gefunden | Der Bereitstellungsname oder -endpunkt ist falsch. | Stellen Sie sicher, dass model sie mit dem Bereitstellungsnamen übereinstimmt und dass die Basis-URL auf die richtige Azure OpenAI-Ressource verweist. |
Note
Eine Flex-Anfrage, die abgelehnt wird, weil keine Verarbeitungskapazität verfügbar ist, wird nicht in Rechnung gestellt. Möglicherweise stellen Sie jedoch eine geringere verfügbare Rate-Limit-Kapazität fest, da Flex- und Standardanfragen das dem Global-Standard-Deployment zugewiesene Kontingent gemeinsam nutzen.
Verwenden Sie exponentielles Backoff mit zufälligem Jitter bei HTTP-408-, 429- und vorübergehenden 5xx-Antworten. Legen Sie eine maximale Wiederholungsanzahl und maximale Verzögerung fest, sodass eine fehlgeschlagene Anforderung nicht in einer ungebundenen Wiederholungsschleife verbleibt.
- Beachten Sie
Retry-After, wenn es in der Antwort enthalten ist. - Warten Sie andernfalls auf eine exponentiell zunehmende Verzögerung mit zufälligen Jittern.
- Wiederholen Sie Flex nur dann, wenn die Verzögerung für die Arbeitsauslastung akzeptabel bleibt.
- Auf Standard zurückgreifen, wenn das Wiederholungsbudget ausgeschöpft ist und die Anwendung die höheren Standardkosten zulässt.
- Gibt einen expliziten Fehler zurück, wenn weder verzögerte Flexverarbeitung noch Standard-Fallback die Anforderungen der Anwendung erfüllt.
Wiederholen Sie nicht wiederholt die gleiche nicht unterstützte Flex-Anforderung. Ein Wiederholungsversuche ist erst erfolgreich, nachdem Sie das Modell, die Kontextlänge, die API-Konfiguration oder die Dienstebene geändert haben.
Nachverfolgen von Nutzung und Kosten
Verwenden Sie Azure Monitor Metriken, um Flex- und Standarddatenverkehr in derselben Bereitstellung zu vergleichen. Überwachen Sie Anforderungsvolumen, Tokenverbrauch, Latenz, Fehler und die Rate, mit der Flex-Anforderungen in Ihrer Anwendung auf Standard zurückgreifen.
Melden Sie sich im Azure-Portal an.
Wechseln Sie zu Ihrer Azure OpenAI-Ressource, und wählen Sie "Metriken" aus.
Fügen Sie die Metrik Azure OpenAI-Anforderungen hinzu. Sie können auch Azure OpenAI-Latenz, Azure OpenAI-Verwendung und Fehlermetriken hinzufügen.
Fügen Sie einen Filter hinzu, bei dem ServiceTierRequest gleich ist
flex.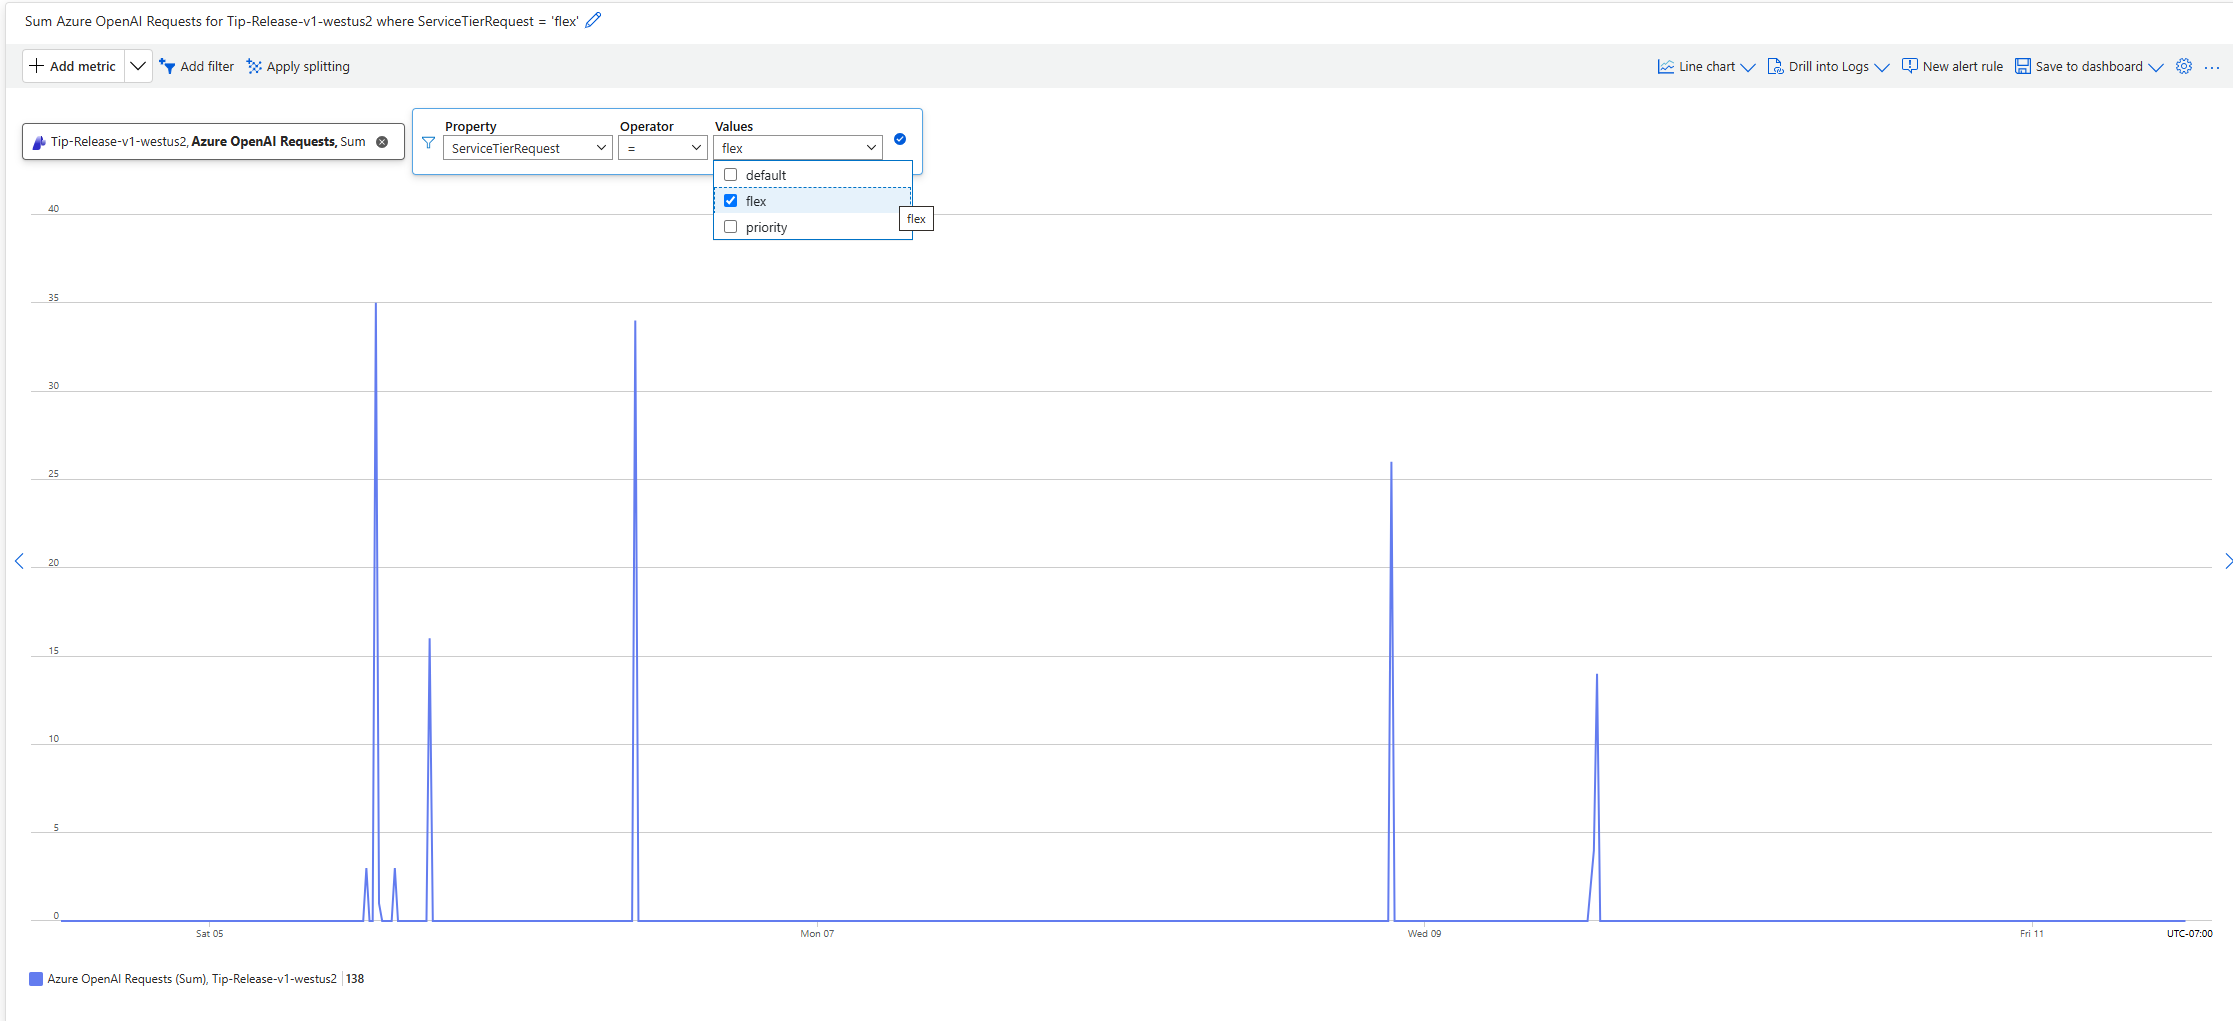
Erstellen Sie Warnungen für dauerhafte HTTP 429-Antworten, erhöhte Fehlerraten und Latenzen, die das Wiederholungsbudget Ihrer Workload überschreiten.
Verfolgen Sie die folgenden Signale für jede Workload:
| Signal | Warum dies wichtig ist |
|---|---|
| Flex-Anforderungsanzahl | Zeigt die Akzeptanz und den zur kostengünstigeren Verarbeitung weitergeleiteten Datenverkehr. |
| Rate erfolgreicher Flex-Anfragen | Zeigt, wie oft die Flex-Kapazität Anforderungen akzeptiert und abschließt. |
| HTTP-429-Anfragerate | Zeigt Zeiträume an, in denen Flex-Kapazität oder Bereitstellungskontingent eingeschränkt ist. |
| Standard-Fallback-Anzahl und -Rate | Zeigt den Zuverlässigkeitsvorteil und die zusätzlichen Kosten aus anwendungsgesteuertem Fallback an. |
| Eingabe-, zwischengespeicherte Eingabe- und Ausgabetoken | Unterstützt die Kostenzuordnung und verifiziert die Wirkung des Prompt-Cachings. |
| End-to-End-Latenz | Hilft dabei festzustellen, ob ein Workload für Flex geeignet bleibt. |
HTTP 400-Anzahl invalid_request_error |
Identifiziert nicht unterstützte Modelle, Modellversionen, Kontextlängen oder Anforderungskonfigurationen. |
Weitere Informationen zur Überwachung von Modellbereitstellungen finden Sie unter Monitor Azure OpenAI.
Flex-Nutzung wird auf dedizierten Flex-Zählern in Rechnung gestellt, sodass Sie sie von der Standardnutzung unterscheiden können. Verwenden Sie die Kostenanalyse, um Flex-Tokenkosten nach Ressource und Bereitstellung zu überprüfen.
- Öffnen Sie im portal Azuredie Kostenverwaltung +Abrechnungskostenanalyse>.
- Filtern Sie nach der Abonnement-, Ressourcengruppe oder Azure OpenAI-Ressource, die die Bereitstellung enthält.
- Gruppieren oder filtern Sie nach Meter , um die Flex-Verwendung von der Standardverwendung zu trennen.
- Fügen Sie einen Filter für Abrechnungs-Tags hinzu, wählen Sie Bereitstellung aus, und wählen Sie den Namen der Bereitstellung aus.
- Vergleichen Sie Flex-Kosteneinsparungen mit Standardfallbackkosten und den Fertigstellungsanforderungen der Workload.
Flex-Eingabe- und -Ausgabe-Token kosten 50 % der entsprechenden Standardpreise. Prompt-Caching kann die Kosten für geeignete zwischengespeicherte Eingabetoken weiter senken. Eine Flex-Anfrage, die abgelehnt wird, weil keine Verarbeitungskapazität verfügbar ist, wird nicht in Rechnung gestellt.
Anwenden bewährter Methoden für die Produktion
- Festlegen eines längeren Timeouts. Flex-Anforderungen können länger dauern als Standardanforderungen. Beginnen Sie mit einem für Ihre Workload geeigneten Clienttimeout, z. B. 15 Minuten, und testen Sie mit repräsentativen Eingabeaufforderungen.
- Verwenden Sie begrenzte Wiederholungsversuche. Beschränken Sie Wiederholungsversuche und die gesamte verstrichene Zeit.
- Fügen Sie Jitter hinzu. Variieren Sie die Backoff-Verzögerungen zufällig, um synchronisierte Spitzen bei erneuten Versuchen zu vermeiden.
- Fallback explizit festlegen. Setzen Sie
service_tieraufdefault, anstatt sich auf implizites Verhalten zu verlassen. - Verfolgen Sie die verarbeitete Stufe. Notieren Sie den Antwortwert
service_tiermit Latenz-, Status-, Tokenverwendungs- und Kostendaten. - Trennen Sie interaktiven und Hintergrunddatenverkehr. Verwenden Sie für benutzerseitige Anfragen Standard, Priority oder bereitgestellten Durchsatz, es sei denn, eine variable Flex-Latenz ist akzeptabel.
- Doppelte Arbeit steuern. Stellen Sie sicher, dass die Anwendung nach clientseitigen Timeouts nicht mehrmals denselben logischen Auftrag übermittelt.
- Testen Sie Fehlerpfade. Validieren Sie den Umgang mit HTTP-400-, HTTP-408-, HTTP-429- und vorübergehenden 5xx-Antworten, bevor Sie die Flex-Verarbeitung in Produktionsworkflows einsetzen.
- Überprüfen Sie die Modellunterstützung vor Upgrades. Ein Ersatzmodell oder eine Modellversion erbt nicht automatisch die Flex-Unterstützung.
Die Dienstebene mit einem Anforderungsheader außer Kraft setzen
Verwenden Sie den Anforderungsheader x-ms-service-tier , wenn ein Gateway, ein Proxy oder eine zentrale Routingebene die Dienstebene auswählen muss, ohne den Anforderungstext zu prüfen oder zu ändern. Der Header kann auch Migrationsänderungen für Anwendungen reduzieren, die bereits eine OpenAI-Dienstebene über einen Anforderungsheader auswählen.
Die Kopfzeile akzeptiert die folgenden Werte:
| Headerwert | Angeforderte Verarbeitungsstufe |
|---|---|
flex |
Flex |
priority |
Priorität |
default |
Standard |
auto |
Priorität |
Wenn der Header vorhanden und gültig ist, hat er Vorrang vor dem service_tier Wert im Anforderungstext.
| Eingabe der Kopfzeile | Anforderungstexteingabe | Verhalten und Ausgabe |
|---|---|---|
| Kopfzeile nicht angegeben | Gültiger service_tier Wert |
Der Anforderungstext wählt die Ebene aus. Eine erfolgreiche Antwort identifiziert die verarbeitete Ebene in service_tier. |
| Gültiger Headerwert | Beliebiger Wert oder weggelassen | Die Kopfzeile wählt die angeforderte Ebene aus. Eine erfolgreiche Antwort identifiziert die verarbeitete Ebene in service_tier. |
| Nicht unterstützter Headerwert | Beliebiger Wert oder weggelassen | Die Anforderung gibt HTTP 400 zurück. Der Dienst greift nicht auf den Wert im Anforderungstext zurück. |
In diesem Beispiel wird die Flex-Verarbeitung über den Header angefordert. Der Header überschreibt den default-Wert im Textkörper der Anforderung:
curl -X POST https://YOUR-RESOURCE-NAME.openai.azure.com/openai/v1/responses \
  -H "Content-Type: application/json" \
  -H "api-key: $AZURE_OPENAI_API_KEY" \
  -H "x-ms-service-tier: flex" \
  -d '{
    "model": "YOUR-GPT-5.6-SOL-DEPLOYMENT-NAME",
    "input": "Analyze these records and summarize the recurring themes.",
    "service_tier": "default"
  }'
{
    "service_tier": "flex",
    "status": "completed",
    "output": [<response-output>]
}
Der Override-Header bietet keinen automatischen Fallback. Ein ungültiger Headerwert oder eine Ebene, die von der ausgewählten Bereitstellung nicht unterstützt wird, gibt HTTP 400 zurück.