Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Azure DocumentDB ist ein vollständig verwalteter NoSQL Datenbankdienst für die moderne Anwendungsentwicklung mit MongoDB-Kompatibilität. Azure DocumentDB unterstützt eine Ha-Konfiguration (High Availability) mit synchron replizierten Hot-Standby-Replikaten und Zonenredundanz. Darüber hinaus bietet es ein optionales Lesereplikat in einer anderen Azure Region und automatische Sicherungen mit Punkt-in-Time-Aufbewahrung, um vor versehentlichem Datenverlust zu schützen.
Wenn Sie Azure verwenden, ist Zuverlässigkeit eine gemeinsame Verantwortung. Microsoft bietet eine Reihe von Funktionen zur Unterstützung von Resilienz und Wiederherstellung. Sie sind dafür verantwortlich, zu verstehen, wie diese Funktionen in allen von Ihnen verwendeten Diensten funktionieren, und die Funktionen auswählen, die Sie benötigen, um Ihre Geschäftsziele und Uptime-Ziele zu erfüllen.
In diesem Artikel wird beschrieben, wie Sie Azure DocumentDB für verschiedene potenzielle Ausfälle und Probleme widerstandsfähig machen, einschließlich vorübergehender Fehler, Verfügbarkeitszonenausfälle, Regionsausfälle und Servicewartung. Außerdem werden das Sicherungsverhalten beschrieben und wichtige Informationen zur HA- und regionsübergreifenden Replikation bereitgestellt.
Empfehlungen für die Produktionsimplementierung für Zuverlässigkeit
Eine Liste der Empfehlungen zur Verbesserung der Zuverlässigkeit Ihres Clusters finden Sie unter Bewährte Methoden für hohe Verfügbarkeit (HA) und die regionsübergreifende Replikation in Azure DocumentDB.
Übersicht über die Zuverlässigkeitsarchitektur
In diesem Abschnitt werden einige der wichtigen Aspekte der Funktionsweise des Diensts beschrieben, die aus Zuverlässigkeitsperspektive am relevantesten sind. Im Abschnitt wird die logische Architektur vorgestellt, die einige der Ressourcen und Features enthält, die Sie bereitstellen und verwenden. Außerdem wird die physische Architektur erläutert, die Details zur Funktionsweise des Diensts unter den Deckeln bereitstellt.
Logische Architektur
Die primäre Ressource, die Sie bereitstellen, ist ein Azure DocumentDB-Cluster. Für jeden Cluster wählen Sie eine Computeebene und konfigurieren den Speicher. Die ausgewählte Ebene bestimmt die verfügbaren Funktionen für Zuverlässigkeitsfeatures wie hohe Verfügbarkeit (High Availability, HA) und wirkt sich auch auf die Planung der Kapazität für Ausfallsicherheitsszenarien aus.
Anwendungen stellen mithilfe von Verbindungszeichenfolgen und Endpunkten eine Verbindung mit einem Cluster her. Azure DocumentDB stellt Verbindungsendpunkte für Lese-/Schreibvorgänge und, wenn konfiguriert, Endpunkte für Lesereplikatcluster bereit. Mit diesen Endpunkten kann Ihre Anwendung weiterhin stabile Verbindungsmuster verwenden, während der Dienst das Failoververhalten hinter den Kulissen verwaltet.
Innerhalb jedes Clusters werden Ihre Daten als Datenbanken, Sammlungen und Dokumente organisiert. Dieses mongoDB-kompatible Datenmodell ist die Grundlage für Entwurfsentscheidungen auf Arbeitsauslastungsebene, wie z. B. Shardingstrategie, Lese- und Schreibmuster sowie Sicherungs- und Wiederherstellungsumfang.
Physische Architektur
Azure DocumentDB führt Ihren Cluster auf Shards aus, die Knoten (virtuelle Computer) darstellen, die den Dienst ausführen. Sie können einen Shard bereitstellen oder auf mehrere Shards skalieren. Die Bereitstellung mehrerer Shards verbessert die Skalierbarkeit, bietet aber für sich genommen keine HA.
Wenn Sie HA aktivieren, stellt Azure DocumentDB einen übereinstimmenden Satz von Standby-Shards bereit. Jeder primäre Shard verfügt über einen Standby-Shard. Der Dienst repliziert Daten synchron zwischen jedem primären Standby-Paar und fördert den Standby-Shard, wenn der primäre Shard fehlschlägt. Weitere Informationen zu HA finden Sie unter "Hohe Verfügbarkeit" in Azure DocumentDB.
Azure DocumentDB verwendet Azure Storage für die Haltbarkeit von Shards. Wenn HA deaktiviert ist, verwendet jeder Shard lokal redundanten Speicher (LRS). LRS verwaltet drei Kopien der Daten, ist jedoch nicht widerstandsfähig für den Verlust einer Verfügbarkeitszone. Ausführliche Informationen zur LRS-Haltbarkeit finden Sie unter "Zusammenfassung der Redundanzoptionen".
Weitere Informationen finden Sie unter Verfügbarkeit und Notfallwiederherstellung (DR) in Azure DocumentDB: Behind the scenes.
Resilienz für vorübergehende Fehler
Vorübergehende Fehler sind kurze, zeitweilige Fehler in Komponenten. Sie treten häufig in einer verteilten Umgebung wie der Cloud auf und sind ein normaler Bestandteil von Vorgängen. Vorübergehende Fehler korrigieren sich nach kurzer Zeit. Es ist wichtig, dass Ihre Anwendungen vorübergehende Fehler behandeln können, in der Regel durch Wiederholen betroffener Anforderungen.
Alle in der Cloud gehosteten Anwendungen sollten die Anleitung zur vorübergehenden Fehlerbehandlung von Azure befolgen, wenn sie mit cloudgehosteten APIs, Datenbanken und anderen Komponenten kommunizieren. Weitere Informationen finden Sie unter Empfehlungen zum Umgang mit vorübergehenden Fehlern.
Azure DocumentDB ist mit dem MongoDB-Protokoll kompatibel, sodass Anwendungen in der Regel mithilfe von MongoDB-Treibern eine Verbindung herstellen. Sie sind für die Konfiguration der Treiber-Wiederholungseinstellungen Ihrer Anwendung verantwortlich, um vorübergehende Fehler zu behandeln, insbesondere Verbindungsunterbrechungen und kurze Schreibunterbrechungen während Failoverereignissen. Befolgen Sie diese Richtlinien:
Verwenden Sie MongoDB-Treiber, die die automatische Wiederholungsbehandlung für vorübergehende Verbindungsfehler unterstützen.
Konfigurieren Sie Wiederholungsversuche mit exponentiellem Backoff, und beschränken Sie die Anzahl der Wiederholungsversuche.
Wenn möglich, entwerfen Sie Schreibvorgänge so, dass sie idempotent sind, damit die Wiederholung sicher ist. Allgemeine Implementierungsanleitungen zur Idempotenz finden Sie im Idempotent Consumer-Muster.
Ausfallsicherheit bei Ausfällen von Verfügbarkeitszonen
Verfügbarkeitszonen sind physisch getrennte Gruppen von Rechenzentren innerhalb einer Azure-Region. Wenn eine Zone ausfällt, erfolgt ein Failover der Dienste zu einer der verbleibenden Zonen.
Um die Verfügbarkeitszonenunterstützung in Azure DocumentDB zu verwenden, aktivieren Sie hohe Verfügbarkeit (HA). Wenn Sie HA in einer Region aktivieren, die Verfügbarkeitszonen unterstützt, wird Ihr Cluster zonenredundant, da Azure DocumentDB die Standby-Shards in einer anderen Verfügbarkeitszone als ihre primären Shards platziert. Standby-Shards empfangen keine Clientanforderungen, es sei denn, ihre primäre Shard schlägt fehl.
Wenn Sie HA deaktivieren, platziert Azure DocumentDB keine Standby-Shards in einer anderen Verfügbarkeitszone, sodass ein Verfügbarkeitszonenfehler ihren Cluster nicht verfügbar machen kann.
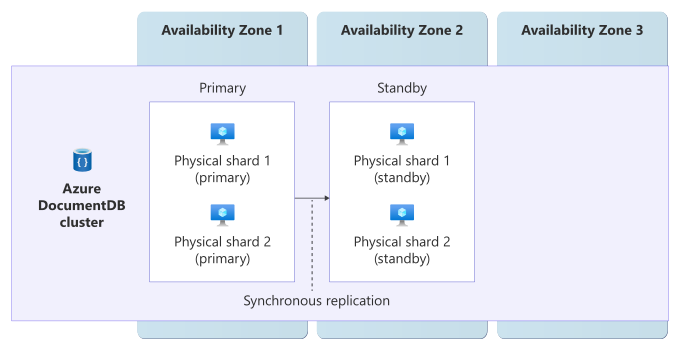
Das Diagramm zeigt einen Azure DocumentDB-Cluster in drei Verfügbarkeitszonen. Zwei primäre physische Shards befinden sich in der Verfügbarkeitszone 1, und ihre entsprechenden Standby-Shards befinden sich in der Verfügbarkeitszone 2. Pfeile zwischen den einzelnen primären und Standby-Shards zeigen synchrone Replikation an. Die Verfügbarkeitszone 3 enthält in diesem Beispiel keine Shards.
Anforderungen
Regionsunterstützung: Wenn Sie Verfügbarkeitszonen mit Azure DocumentDB verwenden möchten, wählen Sie eine Region aus, die sowohl Azure DocumentDB als auch Verfügbarkeitszonen unterstützt. Überprüfen Sie die nach Region verfügbaren Produkte , und vergleichen Sie sie mit Regionen, die Verfügbarkeitszonen unterstützen.
Hohe Verfügbarkeit: Sie müssen HA im Cluster aktivieren. HA erfordert, dass der Cluster die Computeebene M30 (oder höher) verwendet.
Überlegungen
Obwohl einige Azure DocumentDB-APIs Verweise auf Bereitstellungsmodi für dieselbe Zone enthalten, unterstützt Azure DocumentDB keine HA-Bereitstellungen in derselben Zone. Der Dienst unterstützt zonenredundante HA-Bereitstellungen.
Instanzverteilung über Zonen hinweg
Microsoft wählt zwei Verfügbarkeitszonen für den Cluster aus. In zonenredundanten HA-Bereitstellungen platziert Azure DocumentDB alle primären Shards in einer Zone und alle Standby-Shards in der anderen Zone.
Cost
Wenn HA aktiviert ist, stellt Azure DocumentDB einen Standby-Shard für jeden primären Shard bereit, wodurch die Berechnungs- und Speicherkosten ihres Clusters erhöht werden. In Regionen, die Verfügbarkeitszonen unterstützen, macht HA den Cluster außerdem zonenredundant. In einigen Bereitstellungsmodi aktiviert Azure DocumentDB standardmäßig HA. Halten Sie für Produktionsworkloads HA aktiviert. Für Entwicklungs- und Testarbeitslasten können Sie HA deaktivieren, um die Kosten zu senken. Details zu den Preisen finden Sie unter Azure DocumentDB-Preise.
Konfigurieren der Unterstützung von Verfügbarkeitszonen
Erstellen Sie einen neuen zonenredundanten Azure DocumentDB-Cluster: Wenn Sie einen Cluster in einer Region erstellen, die Verfügbarkeitszonen unterstützt, ermöglichen Sie HA, die Clusterzone redundant zu machen. Ausführliche Schritte finden Sie in der Schnellstartanleitung: Erstellen eines Azure DocumentDB-Clusters mithilfe des Azure Portals.
Aktivieren Sie Zonenredundanz für einen vorhandenen Azure DocumentDB-Cluster: Sie können HA für einen vorhandenen Cluster aktivieren. Es gibt keine Datenbankausfallzeiten, wenn hohe Verfügbarkeit in einem Azure DocumentDB-Cluster aktiviert oder deaktiviert ist. Ausführliche Schritte finden Sie unter Skalieren eines Azure DocumentDB-Clusters.
Verhalten, wenn alle Zonen fehlerfrei sind
In diesem Abschnitt wird beschrieben, was Sie erwarten müssen, wenn Sie einen Azure DocumentDB-Cluster für HA in einer Region konfigurieren, die Verfügbarkeitszonen unterstützt, und alle Zonen sind betriebsbereit.
Zonenübergreifender Betrieb: Die primären Shards bearbeiten alle Clientanfragen. Standby-Shards in einer anderen Verfügbarkeitszone erhalten keine Client-Anfragen, es sei denn, der primäre Shard fällt aus.
Zonenübergreifende Datenreplikation: Die Replikation zwischen primären und Standby-Shards ist synchron. Schreibvorgänge werden sowohl auf primären als auch auf Standby-Shards beibehalten, bevor der Dienst eine Antwort zurückgibt.
Verhalten bei einem Zoneausfall
In diesem Abschnitt wird beschrieben, was Sie erwarten müssen, wenn Sie einen Azure DocumentDB-Cluster für HA in einer Region konfigurieren, die Verfügbarkeitszonen unterstützt, und es gibt einen Ausfall in einer der Zonen.
Erkennung und Reaktion: Microsoft überwacht die Integrität von Shard und behandelt Erkennungs- und Failovervorgänge für Sie. Wenn ein primärer Shard aufgrund eines Zonenausfalls nicht verfügbar wird, fördert Azure DocumentDB automatisch den Standby-Shard und erstellt dann Redundanz neu, indem ein neuer Standby-Shard erstellt wird.
Notification: Microsoft benachrichtigt Sie nicht automatisch, wenn eine Zone abfällt. Sie können jedoch Azure Service Health verwenden, um den Gesamtstatus des Diensts zu verstehen, einschließlich aller Zonenfehler, und Sie können Service Health Alerts einrichten, um Sie über Probleme zu informieren.
Aktive Anfragen: Laufende Anfragen, die vor dem Failover nicht bestätigt wurden, können fehlschlagen und müssen vom Client erneut versucht werden. Wenn Ihre Anwendung vorübergehende Fehler behandelt, werden diese Wiederholungen in der Regel automatisch abgeschlossen.
Erwarteter Datenverlust: Azure DocumentDB repliziert Daten synchron zwischen den primären und Standby-Shards, sodass kein Datenverlust erwartet wird.
Erwartete Ausfallzeiten: Für Lesevorgänge wird keine Ausfallzeit erwartet. Bei Schreibvorgängen kann eine kurze Unterbrechung auftreten, während das Failover abgeschlossen ist. Wenn ihre Anwendung vorübergehende Fehler korrekt erneut anschreibt, wird dies in der Regel als kurze Verlangsamung angezeigt.
Umverteilung: Die Verbindungszeichenfolge ändert sich nicht, sodass Clients denselben Endpunkt weiterhin verwenden. Der Dienst leitet den Datenverkehr automatisch an hochgestufte Standby-Shards um und baut neue Standby-Shards neu auf.
Zonenwiederherstellung
Wenn die Verfügbarkeitszone wiederhergestellt wird, stellt Azure DocumentDB automatisch normale Vorgänge in allen vom Cluster verwendeten Zonen wieder her.
Test auf Zonenfehler
Die Azure DocumentDB-Plattform verwaltet Datenverkehrsrouting, Failover und Zonenwiederherstellung für zonenredundante Cluster. Sie müssen keine Fehlerprozesse der Verfügbarkeitszone initiieren oder überprüfen.
Widerstandsfähigkeit bei regionalen Ausfällen
Sie stellen jeden Azure DocumentDB-Cluster in einer einzelnen Azure Region bereit. Um Ausfallsicherheit bei Regionsfehlern zu unterstützen, konfigurieren Sie die regionsübergreifende Replikation, indem Sie einen Replikatcluster in einer anderen Region hinzufügen.
Regionsübergreifende Replikation
Azure DocumentDB unterstützt die regionsübergreifende Replikation über einen Replikatcluster. Der Replikatcluster wird als separater Cluster in Ihrer Ressourcengruppe angezeigt. Sie können diesen Replikatcluster für die Notfallwiederherstellung und die Leseskalierung verwenden. Azure DocumentDB repliziert Datenänderungen automatisch und asynchron aus dem primären Cluster in den Replikatcluster.
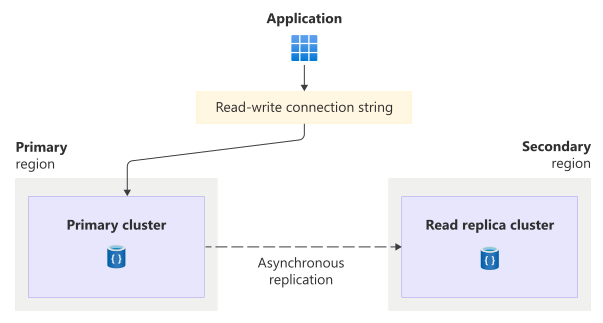
Das Diagramm zeigt eine Anwendung, die über die Lese-/Schreib-Verbindungszeichenfolge eine Verbindung mit dem primären Cluster in der primären Region herstellt. Ein gestrichelter Pfeil zeigt eine asynchrone Replikation vom primären Cluster zu einem Lesereplikatcluster in der sekundären Region.
Wenn Ihre primäre Region ausfällt, kann der Replikatcluster zu einem Cluster mit Lese- und Schreibzugriff hochgestuft werden. Die globale Verbindungszeichenfolge für Lese- und Schreibzugriff wird automatisch aktualisiert, sodass sie auf den heraufgestuften Cluster verweist.
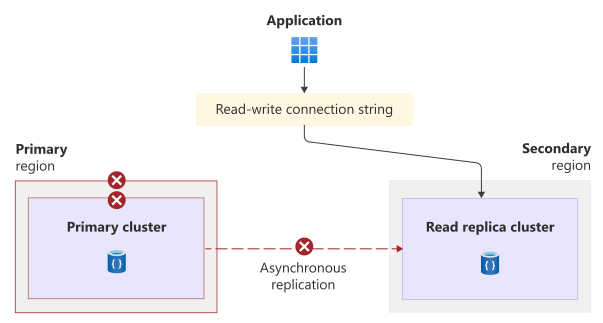
Das Diagramm zeigt eine Anwendung, die nach der Hochstufung über die Verbindungszeichenfolge für Lese- und Schreibzugriff eine Verbindung mit dem Replikatcluster in der sekundären Region herstellt. Fehlersymbole markieren den primären Cluster, die primäre Region und den ehemaligen asynchronen Replikationspfad.
In diesem Abschnitt werden Zuverlässigkeitsüberlegungen für die regionsübergreifende Replikation zusammengefasst. Weitere Informationen finden Sie unter Regionsübergreifende und regionale Replikation in Ihrem Azure DocumentDB-Cluster verwalten und Bewährte Methoden für regionsübergreifende und regionale Replikation in Azure DocumentDB.
Failover zwischen Regionen
Azure DocumentDB unterstützt drei Heraufstufenmodi:
Erzwungene Hochstufung: Stuft den Replikatcluster sofort hoch, damit er Schreibvorgänge akzeptiert, und leitet eingehenden Schreibdatenverkehr über die globale Lese-/Schreib-Verbindungszeichenfolge um. Dieser Modus minimiert Ausfallzeiten, kann jedoch zu Datenverlust führen, da alle nicht replizierten Schreibvorgänge verloren gehen.
Dienstverwaltetes Failover: Sie können Ihren Cluster so konfigurieren, dass ein vom Dienst verwaltetes Failover verwendet wird. Microsoft überwacht Ihren primären Cluster und löst automatisch eine erzwungene Heraufstufung aus, wenn der primäre Cluster fehlerhaft ist.
Graceful-Promotion: Verhindert Datenverlust, erfordert jedoch eine gewisse Ausfallzeit, während nicht replizierte Schreibvorgänge repliziert werden. Für eine ordnungsgemäße Heraufstufung müssen beide Cluster fehlerfrei sein, daher kann dieser Vorgang bei einem Regionsausfall nicht durchgeführt werden.
Weitere Informationen finden Sie unter regionsübergreifende Failovermodi in Azure DocumentDB.
Anforderungen
Regionsunterstützung: Sie können die regionsübergreifende Replikation in allen Azure Regionen verwenden, die Azure DocumentDB unterstützen.
Computeebene: Für die regionsübergreifende Replikation ist die M30-Computeebene oder höher erforderlich.
Überlegungen
Netzwerkzugriff: Replikatcluster erben keine Netzwerkeinstellungen vom primären Cluster. Konfigurieren Sie Firewallregeln oder private Endpunkte separat im Replikatcluster, und testen Sie die Konnektivität vor einem Failover. Weitere Informationen finden Sie unter Kontinuierliche Schreibvorgänge, Lesevorgänge auf Clusterreplikaten und Verbindungszeichenfolgen.
Unterstützte Funktionen: Replikatcluster unterstützen weder Point-in-Time-Wiederherstellung (PITR) noch Hochverfügbarkeit innerhalb einer Region.
Wenn HA auf dem primären Cluster aktiviert ist, sind Sie dafür verantwortlich, HA für den höhergestuften Cluster erneut zu aktivieren.
Weitere Informationen finden Sie unter Azure DocumentDB-Dienstbeschränkungen und -Kontingente.
Cost
Die regionsübergreifende Replikation fügt Kosten für die Compute- und Speicherressourcen des Replikatclusters hinzu. Regionsübergreifende Datenübertragungsgebühren gelten ebenfalls. Details zu den Preisen finden Sie unter Azure DocumentDB-Preise und Bandbreitenpreise.
Konfigurieren der Multiregion-Unterstützung
Erstellen eines Replikatclusters: Um die regionsübergreifende Replikation zu aktivieren, erstellen Sie einen Replikatcluster aus Ihrem primären Cluster. Sie können einen Replikatcluster erstellen, wenn Sie den primären Cluster oder danach erstellen. Die Schritte finden Sie unter Verwalten der regionsübergreifenden Replikation und der Replikation innerhalb derselben Region in Ihrem Azure DocumentDB-Cluster.
Automatisches Failover konfigurieren: Wenn Azure das Replikat während Ausfallen der primären Region automatisch höher stufen soll, aktivieren Sie das vom Dienst verwaltete Failover. Weitere Informationen finden Sie unter Vom Dienst verwaltetes Failover aktivieren.
Note
Microsoft löst das vom Dienst verwaltete Failover in der Regel nur in extremen Ereignissen aus, z. B. einem Ausfall einer gesamten Region oder einer großen Anzahl betroffener Kunden. Es kann eine Verzögerung geben, bevor failover ausgelöst wird. Wenn Sie die Verfügbarkeit schnell wiederherstellen müssen, empfehlen wir Ihnen, den Failoverprozess mithilfe von vom Kunden initiierter erzwungener Heraufstufung zu verwalten.
Verhalten, wenn alle Regionen funktionsfähig sind
In diesem Abschnitt wird beschrieben, was Sie erwarten müssen, wenn Sie einen Azure DocumentDB-Cluster für die regionsübergreifende Replikation konfigurieren und alle Regionen betriebsbereit sind.
Standortübergreifender Betrieb: Der primäre Cluster dient dem gesamten Lese-/Schreibzugriff. Der Replikatcluster bietet schreibgeschützten Datenverkehr, mit dem Sie Lesearbeitslasten horizontal skalieren oder Lesedatenverkehr lokal auf eine bestimmte Region beschränken können. Die globale Lese-/Schreib-Verbindungszeichenfolge verweist immer auf den aktuell schreibbaren Cluster, sodass Clients nicht verfolgen müssen, welche Region primär ist.
Regionsübergreifende Datenreplikation: Die Replikation zwischen dem primären Cluster und dem Replikatcluster ist asynchron. Schreibvorgänge werden im primären Cluster festgeschrieben und dem Client bestätigt, bevor sie auf den Replikatcluster repliziert werden. Dieser Ansatz verhindert, dass die netzwerkübergreifende Latenz die Schreibleistung beeinträchtigt. Da die Replikation asynchron ist, wird eine Gewisse Replikationsverzögerung zwischen den primären und Replikatclustern erwartet, und alle nicht replizierten Schreibvorgänge können während eines erzwungenen Failovers verlorengehen.
Verhalten während eines Regionenausfalls
In diesem Abschnitt wird beschrieben, was Sie erwarten müssen, wenn Sie einen Azure DocumentDB-Cluster für die regionsübergreifende Replikation konfigurieren, und es gibt einen Ausfall in der Region des primären Clusters.
Erkennung und Reaktion: Die Verantwortung für das Erkennen des Ausfalls und der Reaktion hängt vom Typ des Failovers ab, den Ihr Cluster verwendet.
- Wenn das vom Dienst verwaltete Failover aktiviert ist, erkennt Azure DocumentDB den Ausfall und führt automatisch eine erzwungene Heraufufung des Replikatclusters durch.
- Wenn das vom Dienst verwaltete Failover nicht aktiviert ist, sind Sie dafür verantwortlich, den Ausfall zu erkennen und eine erzwungene Heraufstufung auszulösen.
Weitere Informationen finden Sie unter regionsübergreifende Failovermodi in Azure DocumentDB.
Notification: Microsoft benachrichtigt Sie nicht automatisch, wenn eine Region abfällt. Sie können jedoch Azure Service Health verwenden, um die allgemeine Integrität des Diensts zu verstehen, einschließlich aller Regionsfehler, und Sie können Dienststatuswarnungen einrichten, um Sie über Probleme zu informieren.
Aktive Anforderungen: Alle aktiven Anforderungen an den fehlerhaften primären Bereich können fehlschlagen. Nach Abschluss des Failovers sollten Anwendungen erneut eine Verbindung herstellen und es mit dem heraufgestuften Cluster versuchen.
Erwarteter Datenverlust: Failovervorgänge bei Ausfällen einer Region erfolgen ungeplant, sodass nicht replizierte Schreibvorgänge verloren gehen können, da die Replikation asynchron erfolgt.
Erwartete Ausfallzeiten: Die gesamten Ausfallzeiten sind abhängig von Erkennungszeit, Failovermodus und Verhalten für die erneute Verbindung des Clients.
Für vom Kunden initiierte erzwungene Werbeaktionen umfasst die gesamte Ausfallzeit die Zeit, die es benötigt, um den Ausfall zu erkennen und Ihre Antwortprozesse zu initiieren, sowie die Zeit, um die Aktion abzuschließen.
Sobald eine Werbeaktion gestartet wurde, ist sie in der Regel innerhalb weniger Minuten abgeschlossen.
Umleitung: Die globale Lese-/Schreib-Verbindungszeichenfolge verweist nach der Heraufstufung automatisch auf den heraufgestuften Cluster. Anwendungen, die clusterspezifische Verbindungszeichenfolgen verwenden, erfordern möglicherweise Konfigurationsupdates, sodass sie den Datenverkehr an den fehlerfreien Cluster weiterleiten.
Regionswiederherstellung
Azure DocumentDB wechselt nicht automatisch zurück zur ursprünglichen Region, nachdem diese wieder verfügbar ist. Um Schreibvorgänge in den ursprünglichen Bereich zurückzugeben, führen Sie eine weitere Heraufstufung aus, nachdem Sie Ihre bevorzugte Topologie neu aufgebaut haben. Verwenden Sie eine kontrollierte Hochstufung, um Datenverlust beim Failback zu vermeiden. Eine geordnete Hochstufung erfordert eine kurze Ausfallzeit, und Sie können sie zu einem Zeitpunkt Ihrer Wahl durchführen, z. B. während eines Wartungsfensters. Weitere Informationen finden Sie unter Eine kontrollierte Höherstufung auslösen.
Test auf Regionsfehler
Testen Sie Ihren Notfallwiederherstellungsprozess regelmäßig, indem Sie den Replikatcluster in einer kontrollierten Umgebung bewerben.
Verwenden Sie die erzwungene Heraufstufung, um das Ausfallverhalten zu simulieren. Dieser Test kann zu Datenverlust führen. Erwägen Sie daher, diesen Test in einer Nichtproduktionsumgebung auszuführen. Weitere Informationen finden Sie unter Eine erzwungene Hochstufung auslösen.
Verwenden Sie eine ordnungsgemäße Heraufstufung für geplante Switchover-Übungen, wenn Sie Datenverluste vermeiden möchten. Weitere Informationen finden Sie unter Eine kontrollierte Höherstufung auslösen.
Sichern und Wiederherstellen
Replikation und Unterstützung für Verfügbarkeitszonen helfen, einen Cluster während Infrastrukturfehlern verfügbar zu halten. Azure DocumentDB übernimmt automatisch fortlaufende Sicherungen, die ein anderes Risiko darstellen, indem die Point-in-Time Recovery (PITR) aktiviert wird, nachdem Sie Daten versehentlich gelöscht oder geändert haben. Azure DocumentDB übernimmt Sicherungen, ohne dass sich dies auf die Leistung oder Verfügbarkeit von Datenbankvorgängen auswirkt. Weitere Informationen dazu, wie Replikation und Sicherung unterschiedliche Risiken behandeln, finden Sie unter Redundanz, Replikation und Sicherung.
Azure DocumentDB speichert Sicherungen separat von den Quelldaten. In Regionen, die Verfügbarkeitszonen unterstützen, speichert der Dienst Sicherungsmomentaufnahmen in drei Verfügbarkeitszonen. Azure DocumentDB verwaltet diese Sicherungen, und Sie können sie nicht exportieren. Der Dienst behält Sicherungen für 35 Tage für aktive Cluster, 7 Tage für aktive Burstable-Tier -Cluster (M10, M20, M25) und 7 Tage für gelöschte Cluster.
Sie können eine Sicherung in einem neuen Cluster wiederherstellen. Danach müssen Sie eine Reihe von Aufgaben nach der Wiederherstellung ausführen.
Weitere Informationen finden Sie unter Wiederherstellen eines Clusters in Azure DocumentDB.
Resilienz gegenüber Wartungsarbeiten an Diensten
Microsoft wendet regelmäßig Dienstupdates an und führt andere Wartungen durch. Die Azure Plattform übernimmt diese Aktivitäten automatisch, um sicherzustellen, dass die Wartung nahtlos und transparent für Sie ist. Bei Wartungsereignissen wird keine Ausfallzeit erwartet, es sei denn, Sie wurden über die geplante Wartung in Azure Service Health informiert.
Geplante Wartungsereignisse können weiterhin kurze vorübergehende Fehler für Clientvorgänge verursachen. Ihre Anwendung sollte diese Ereignisse mithilfe der Wiederholungsanleitungen in der Resilienz für vorübergehende Fehler behandeln.
Service-Level-Vereinbarung
Der Service level agreement (SLA) für Azure-Dienste beschreibt die erwartete Verfügbarkeit jedes Diensts und die Bedingungen, die Ihre Lösung erfüllen muss, um diese Verfügbarkeitserwartungen zu erreichen. Weitere Informationen finden Sie unter Dienstleistungsvereinbarungen für Onlinedienste.
Für Azure DocumentDB gelten Verfügbarkeits-SLAs nur, wenn ihr Cluster hohe Verfügbarkeit (HA) aktiviert hat. Für die folgenden Konfigurationen gelten unterschiedliche Verfügbarkeits-SLAs:
HA-fähige Cluster, die mehrere Azure Regionen umfassen, indem sie die regionsübergreifende Replikation verwenden.
HA-fähige Cluster in einer einzelnen Region.