Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Die Prompt-API ist eine experimentelle Web-API, mit der Sie ein in Microsoft Edge integriertes kleines Sprachmodell (SLM) aus dem JavaScript-Code Ihrer Website oder Browsererweiterung abrufen können. Verwenden Sie die Prompt-API, um Text zu generieren und zu analysieren, oder erstellen Sie Anwendungslogik basierend auf Benutzereingaben, und entdecken Sie innovative Möglichkeiten, Prompt-Engineering-Funktionen in Ihre Webanwendung zu integrieren.
Detaillierter Inhalt:
- Verfügbarkeit der Prompt-API
- Alternativen und Vorteile der Eingabeaufforderungs-API
- In Microsoft Edge integrierte kleine Sprachmodelle
- Das Modell Phi-4-mini
- Das Modell "Aion-1.0-Instruct"
- Aktivieren Sie die Prompt-API
- Sehen Sie sich ein funktionierendes Beispiel an
- Verwenden Sie die Prompt-API
- Senden von Feedback
- Siehe auch
Verfügbarkeit der Prompt-API
Die Prompt-API ist ab Version 138.0.3309.2 als Entwicklervorschau in den Kanälen Microsoft Edge Canary und Edge Dev verfügbar.
Die Prompt-API soll dabei helfen, Anwendungsfälle zu entdecken und Herausforderungen für integrierte SLMs zu verstehen. Es wird erwartet, dass diese API von anderen experimentellen APIs für spezifische KI-gestützte Aufgaben wie Schreibunterstützung und Textübersetzung abgelöst wird. Weitere Informationen zu diesen anderen APIs finden Sie unter:
- Zusammenfassen, Schreiben und Umschreiben von Text mit den Schreibhilfe-APIs
- Übersetzen von Text mit der Übersetzer-API
- Erkennen von Sprachen mit der Spracherkennungs-API
Alternativen und Vorteile der Eingabeaufforderungs-API
Um KI-Funktionen in Websites und Browsererweiterungen zu nutzen, können Sie auch die folgenden Methoden verwenden:
Senden Sie Netzwerkanforderungen an cloudbasierte KI-Dienste, z. B. Azure KI-Lösungen.
Führen Sie lokale KI-Modelle mithilfe der Web Neural Network (WebNN)-API oder der ONNX Runtime für das Web aus.
Die Prompt-API verwendet ein SLM, das auf demselben Gerät ausgeführt wird, auf dem die Ein- und Ausgaben des Modells verwendet werden (d. h. lokal). Dies hat im Vergleich zu cloudbasierten Lösungen folgende Vorteile:
Reduzierte Kosten: Mit der Nutzung eines Cloud-KI-Dienstes sind keine Kosten verbunden.
Netzwerkunabhängigkeit: Über den anfänglichen Modelldownload hinaus gibt es keine Netzwerklatenz beim Auffordern des Modells, und kann auch verwendet werden, wenn das Gerät offline ist.
Verbesserter Datenschutz: Die für das Modell eingegebenen Daten verlassen nie das Gerät und werden nicht zum Trainieren von KI-Modellen erfasst.
Die Prompt-API verwendet ein von Microsoft Edge bereitgestelltes und in den Browser integriertes Modell, das gegenüber benutzerdefinierten lokalen Lösungen wie solchen, die auf WebGPU, WebNN oder WebAssembly basieren, zusätzliche Vorteile bietet:
Gemeinsame einmalige Kosten: Das vom Browser bereitgestellte Modell wird beim ersten Aufruf der API heruntergeladen und für alle Websites freigegeben, die im Browser ausgeführt werden, wodurch die Netzwerkkosten für Benutzer und Entwickler reduziert werden.
Vereinfachte Nutzung für Webentwickler: Das integrierte Modell kann mithilfe einfacher Web-APIs ausgeführt werden und erfordert keine KI/ML-Kenntnisse oder die Verwendung von Frameworks von Drittanbietern.
In Microsoft Edge integrierte kleine Sprachmodelle
In den Microsoft Edge Canary- und Dev-Kanälen verwendet die Prompt-API ab Version 138.0.3309.2 das in Microsoft Edge integrierte Phi-4-mini-Modell.
Ab Version 150.0.4070 kann die Prompt-API auch mit der Vorabversion des Modells Aion-1.0-Instruct verwendet werden, das ebenfalls in Microsoft Edge integriert ist. Aion-1.0-Instruct ist ein kleineres, schnelleres und effizienteres Modell als Phi-4-mini und wird auf Geräten mit weniger leistungsfähigen GPUs oder ohne GPU über CPU-Inferenz unterstützt. Wenn die Leistungsklasse Ihres Geräts nicht hoch genug ist, um Phi-4-mini zu unterstützen, können Sie die Vorabversion des Aion-1.0-Instruct-Modells testen.
Weitere Informationen zu beiden Modellen und zum Aktivieren von Aion-1.0-Instruct finden Sie in den folgenden Abschnitten.
Das Modell Phi-4-mini
Mit der Prompt-API können Sie Phi-4-mini anfordern, das in Microsoft Edge integriert ist. Phi-4-mini ist ein leistungsfähiges kleines Sprachmodell, das sich durch textbasierte Aufgaben auszeichnet. Weitere Informationen zu Phi-4-mini und seinen Funktionen finden Sie auf der Modell-Karte unter microsoft/Phi-4-mini-instruct.
Haftungsausschluss
Wie andere Sprachmodelle kann sich auch die Phi-Modellfamilie potenziell unfair, unzuverlässig oder anstößig verhalten. Weitere Informationen zu den KI-Überlegungen des Modells finden Sie unter Überlegungen zu verantwortungsvoller KI.
Hardwareanforderungen
Die Entwicklervorschau für die Prompt-API ist für Geräte mit Hardwarefunktionen vorgesehen, die SLM-Ausgaben mit vorhersagbarer Qualität und Latenz erzeugen. Die Prompt-API ist derzeit auf Folgendes beschränkt:
Betriebssystem: Windows 10 oder 11 und macOS 13.3 oder höher
Lagerung: Mindestens 20 GB sind auf dem Volume verfügbar, das Ihr Edge-Profil enthält. Wenn die Größe des verfügbaren Speichers unter 10 GB fällt, wird das Modell gelöscht, um sicherzustellen, dass andere Browserfeatures über genügend Speicherplatz verfügen.
GPU: 5,5 GB VRAM oder mehr.
Netzwerk: Unbegrenzter Datentarif oder ungetaktete Verbindung. Das Modell wird nicht heruntergeladen, wenn eine getaktete Verbindung verwendet wird.
Um zu überprüfen, ob Ihr Gerät die Prompt-API-Entwicklervorschau unterstützt, lesen Sie unten den Abschnitt Aktivieren der Prompt-API und überprüfen Sie die Leistungsklasse Ihres Geräts.
Aufgrund des experimentellen Charakters der Prompt-API können Probleme bei bestimmten Hardwarekonfigurationen auftreten. Wenn Sie Probleme mit bestimmten Hardwarekonfigurationen sehen, geben Sie bitte Feedback, indem Sie eine neue Ausgabe im MSEdgeExplainers-Repository öffnen.
Verfügbarkeit des Modells Phi-4-mini
Ein erster Download des Phi-4-mini-Modells ist erforderlich, wenn eine Website zum ersten Mal eine API aufruft, die ein Modell auf dem Gerät erfordert. Sie können das Herunterladen des Phi-4-mini-Modells überwachen, indem Sie die Option "monitor" verwenden, wenn Sie eine neue Prompt-API-Sitzung erstellen. Weitere Informationen finden Sie unten unter Überwachen des Fortschritts des Modelldownloads.
Das Modell "Aion-1.0-Instruct"
In Microsoft Edge Canary oder Edge Dev ab Version 150.0.4070 kann die Prompt-API auch mit der Vorabversion des Modells Aion-1.0-Instruct verwendet werden, das in Microsoft Edge integriert ist.
Dieses Aion-1.0-Instruct-Modell ist deutlich kleiner, schneller und effizienter als Phi-4-mini und wird auf Geräten mit weniger leistungsfähigen GPUs oder ohne GPU über CPU-Inferenz unterstützt.
Aion-1.0-Instruct wird voraussichtlich im Juli 2026 als Open Source-Modell zur Verfügung gestellt.
Aktivieren Sie aion-1.0-instruct für die Eingabeaufforderungs-API
Standardmäßig verwendet die Prompt-API das Modell Phi-4-mini. Um Aion-1.0-Instruct in Microsoft Edge Canary oder Edge Dev zu verwenden, aktivieren Sie das Flag Vorabversion des Sprachmodells auf dem Gerät aktivieren, wie in den folgenden Schritten beschrieben. Wenn dieses Flag aktiviert ist, überschreibt Aion-1.0-Instruct Phi-4-mini als Standardmodell für die Prompt-API.
Stellen Sie sicher, dass Sie die neueste Version von Edge Canary oder Edge Dev (Version 150.0.4070 oder höher) verwenden. Weitere Informationen finden Sie unter Microsoft Edge-Insider werden.
Öffnen Sie in Edge Canary oder Edge Dev eine neue Registerkarte oder ein neues Fenster, und wechseln Sie zu
edge://flags.Geben Sie im Suchfeld oben auf der Seite Vorabversion des Sprachmodells auf dem Gerät aktivieren ein.
Wählen Sie in der Dropdownliste Vorabversion des Sprachmodells auf dem Gerät aktivieren die Option Aktiviert aus, und klicken Sie dann auf die Schaltfläche Neustart :
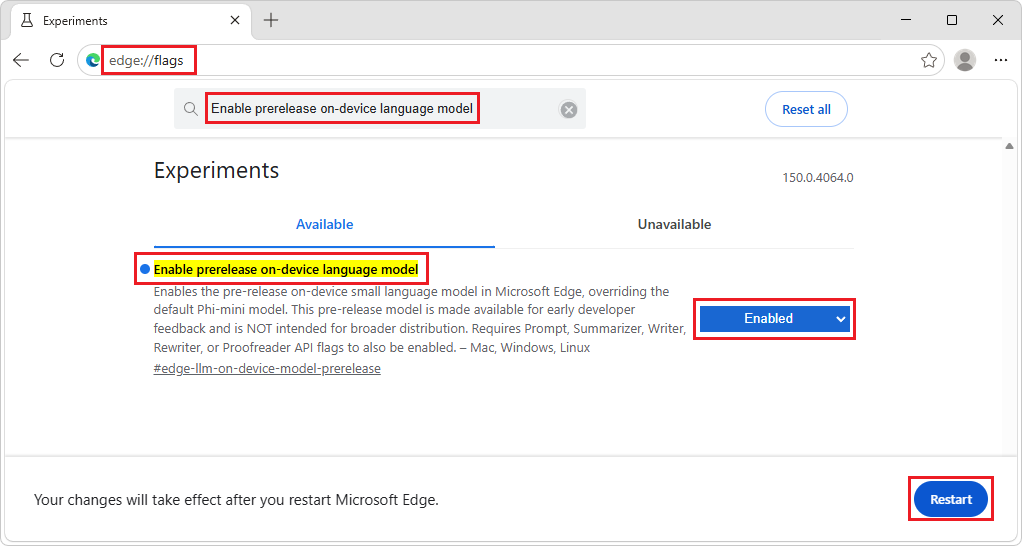
Um zu überprüfen, ob Aion-1.0-Instruct als Sprachmodell auf dem Gerät verwendet wird, wechseln Sie zu
edge://on-device-internals, klicken Sie auf Modellstatus, und überprüfen Sie, ob der Modellname auf Aion-1.0-Instruct festgelegt ist.
Haftungsausschluss
Das Modell Aion-1.0-Instruct steht in Microsoft Edge für frühzeitige Tests und Feedback für Entwickler zur Verfügung. Beachten Sie zusätzlich zu den oben aufgeführten Überlegungen zur verantwortungsvollen KI, dass sich das Verhalten und die Fähigkeiten des Modells aufgrund des Vorabversionsstatus ändern können.
Verfügbarkeit des Aion-1.0-Instruct-Modells
Ein erster Download des Aion-1.0-Instruct-Modells ist erforderlich, wenn eine Website zum ersten Mal eine API aufruft, die ein Modell auf dem Gerät erfordert. Sie können das Herunterladen des Modells "Aion-1.0-Instruct" mithilfe der Option "monitor" überwachen, wenn Sie eine neue Prompt-API-Sitzung erstellen. Weitere Informationen finden Sie unten unter Überwachen des Fortschritts des Modelldownloads.
Aktivieren Sie die Prompt-API
So verwenden Sie die Prompt-API in Microsoft Edge:
Stellen Sie sicher, dass Sie die neueste Version von Microsoft Edge Canary oder Edge Dev (Version 138.0.3309.2 oder höher) verwenden. Weitere Informationen finden Sie unter Microsoft Edge-Insider werden.
Öffnen Sie in Edge Canary oder Edge Dev eine neue Registerkarte oder ein neues Fenster, und wechseln Sie zu
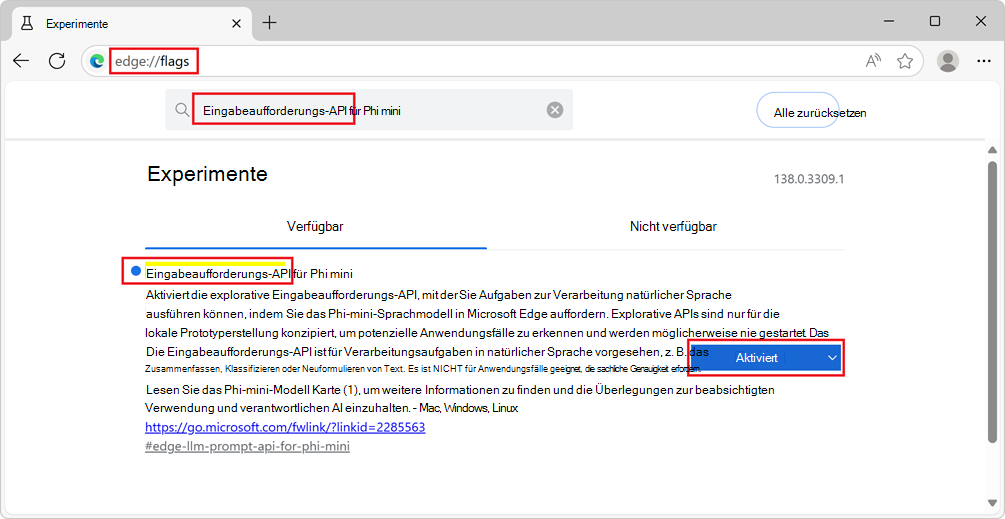
edge://flags/.Geben Sie im Suchfeld oben auf der Seite Prompt-API für das Sprachmodell auf dem Gerät ein.
Die Seite wird so gefiltert, dass die entsprechende Kennzeichnung angezeigt wird.
Wählen Sie unter Prompt-API für Sprachmodell auf dem Gerätdie Option Aktiviert aus:
Aktivieren Sie optional auch das Flag "Debugprotokolle des KI-Modells auf dem Gerät aktivieren", um Informationen, die für Debuggingprobleme nützlich sein können, lokal zu protokollieren.
Starten Sie Edge Canary oder Edge Dev neu.
Um zu überprüfen, ob Ihr Gerät die Hardwareanforderungen für die Entwicklervorschau der Prompt-API erfüllt, öffnen Sie eine neue Registerkarte, wechseln Sie zu
edge://on-device-internalsund überprüfen Sie den Wert der Geräteleistungsklasse .Wenn Ihre Geräteleistungsklasse Hoch oder höher ist, sollte die Prompt-API auf Ihrem Gerät unterstützt werden.
Wenn Ihre Geräteleistungsklasse "Mittel" oder "Niedrig" lautet, wird die Prompt-API nur über die Vorabversion des Modells "Aion-1.0-Instruct" unterstützt, die ab Edge-Version 150.0.4070 verfügbar ist. Informationen zum Testen des Aion-1.0-Instruct-Modells finden Sie oben unter Aktivieren von Aion-1.0-Instruct für die Eingabeaufforderungs-API.
Wenn Sie Probleme mit diesen Modellen feststellen, erstellen Sie bitte eine neue Ausgabe im MSEdgeExplainers-Repository.
Sehen Sie sich ein funktionierendes Beispiel an
Um die Prompt-API in Aktion zu sehen und vorhandenen Code zu überprüfen, der die API verwendet:
Aktivieren Sie die Prompt-API, wie oben beschrieben.
Öffnen Sie in Edge Canary oder Edge Dev eine Registerkarte oder ein Fenster, und wechseln Sie zum Prompt-API-Playground.
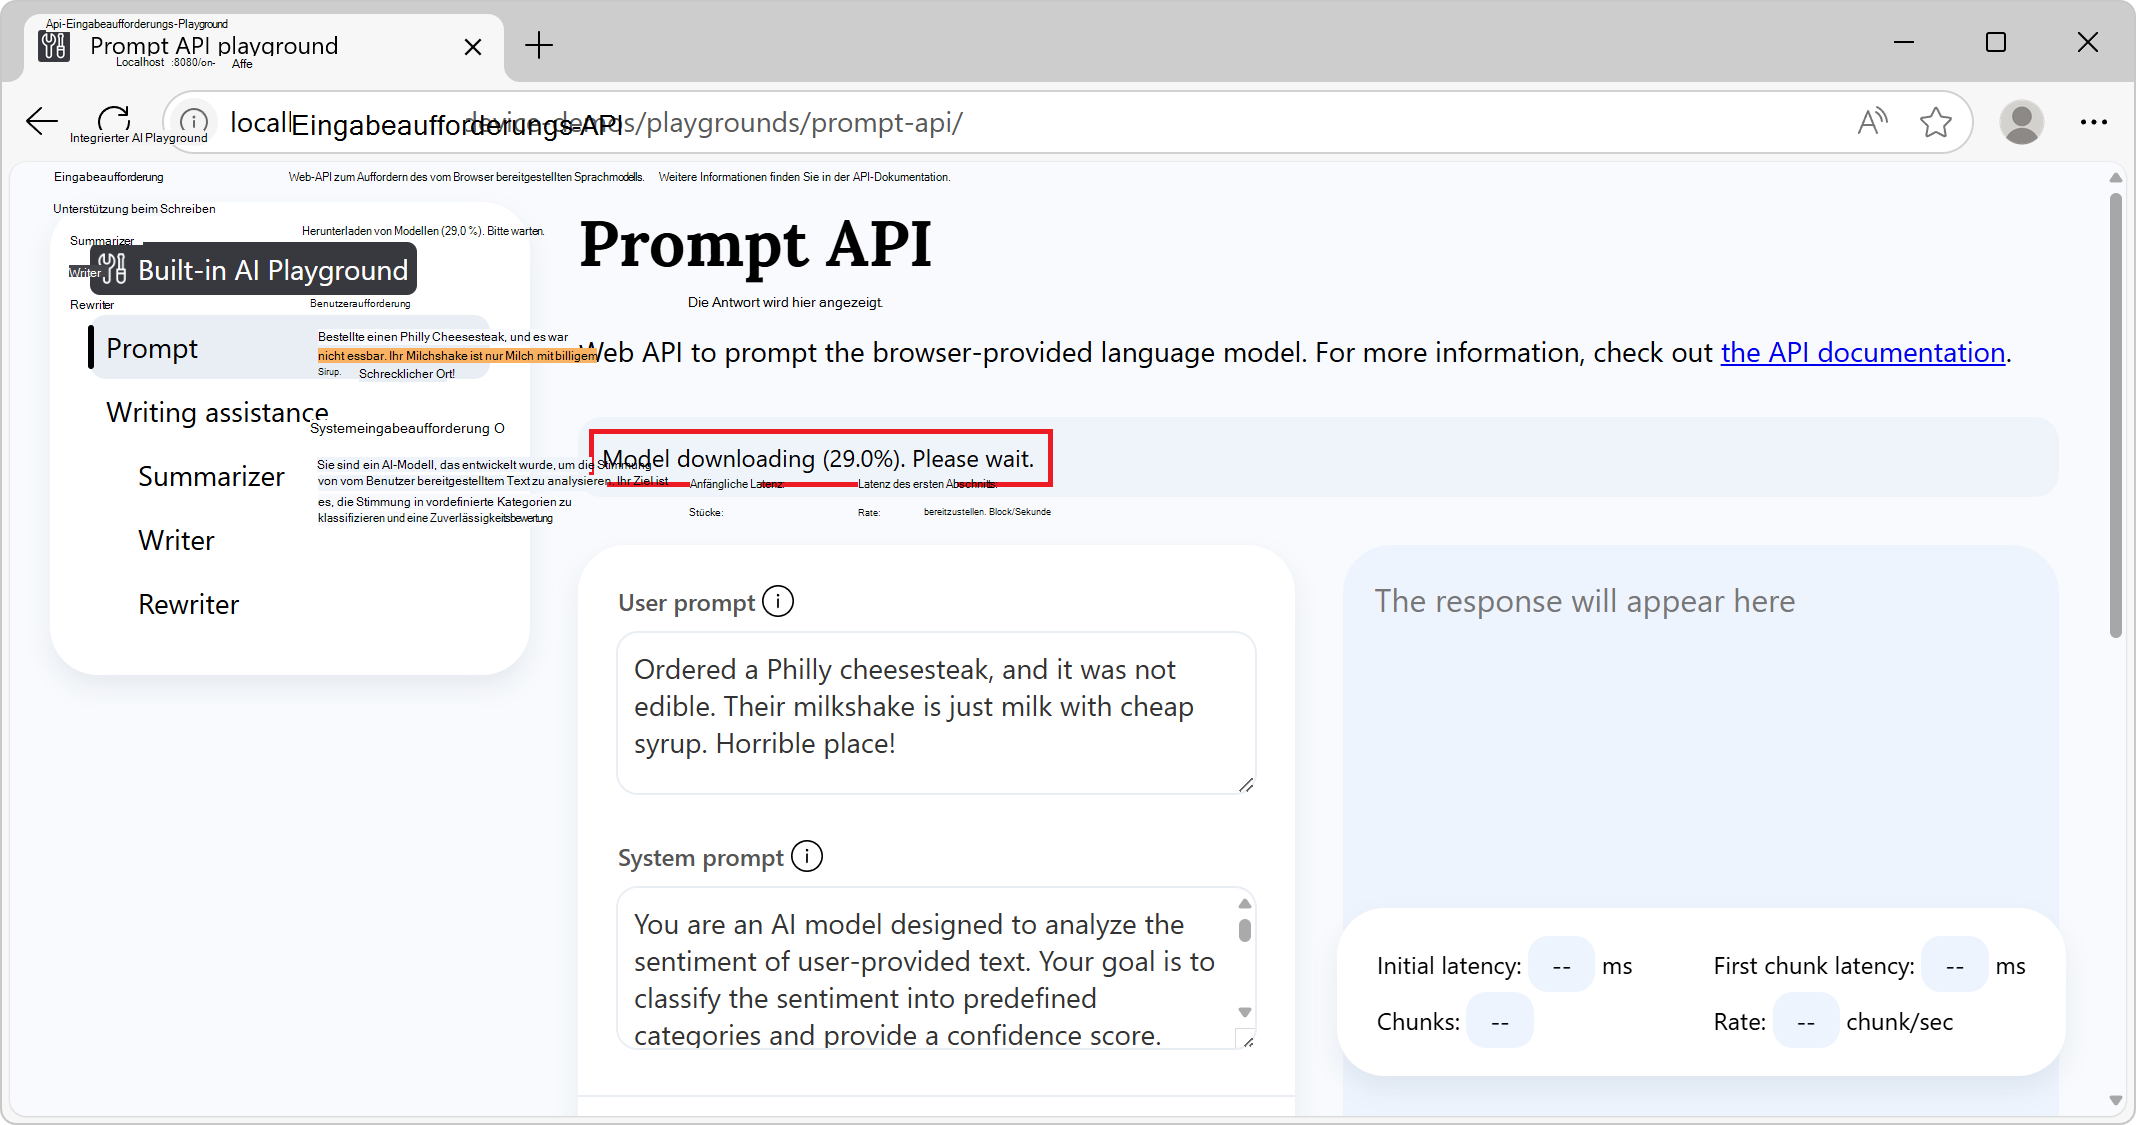
In der integrierten KI-Playgrounds-Navigation auf der linken Seite ist "Eingabeaufforderung " ausgewählt.
Überprüfen Sie im Informationsbanner oben den Status: Es lautet zunächst Modell herunterladen, bitte warten:
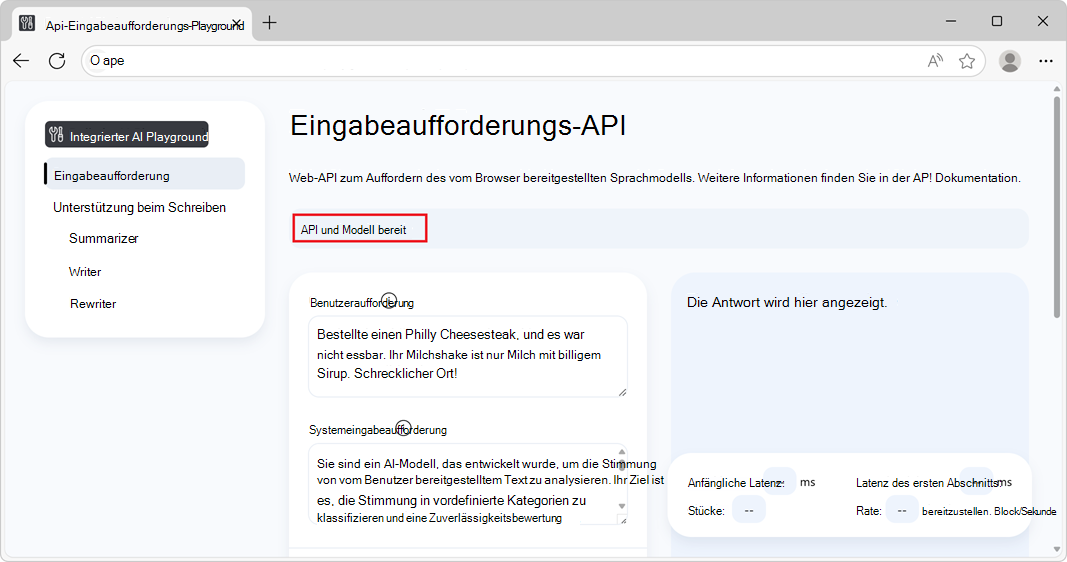
Nachdem das Modell heruntergeladen wurde, lautet das Informationsbanner "API" und "Modell bereit", was darauf hinweist, dass die API und das Modell verwendet werden können:
Wenn der Modelldownload nicht startet, starten Sie Microsoft Edge neu und versuchen Sie es noch mal.
Die Prompt-API wird nur auf Geräten unterstützt, die bestimmte Hardwareanforderungen erfüllen. Weitere Informationen finden Sie unter Hardwareanforderungen weiter oben.
Ändern Sie optional die Werte der Eingabeaufforderungseinstellungen, z. B.:
- Benutzeraufforderung
- System-Eingabeaufforderung
- Schema der Antworteinschränkung
- Weitere Einstellungen>Anweisungen zur N-Shot-Eingabeaufforderung
Klicken Sie unten auf der Seite auf die Schaltfläche "Eingabeaufforderung ".
Die Antwort wird im Antwortabschnitt der Seite generiert:
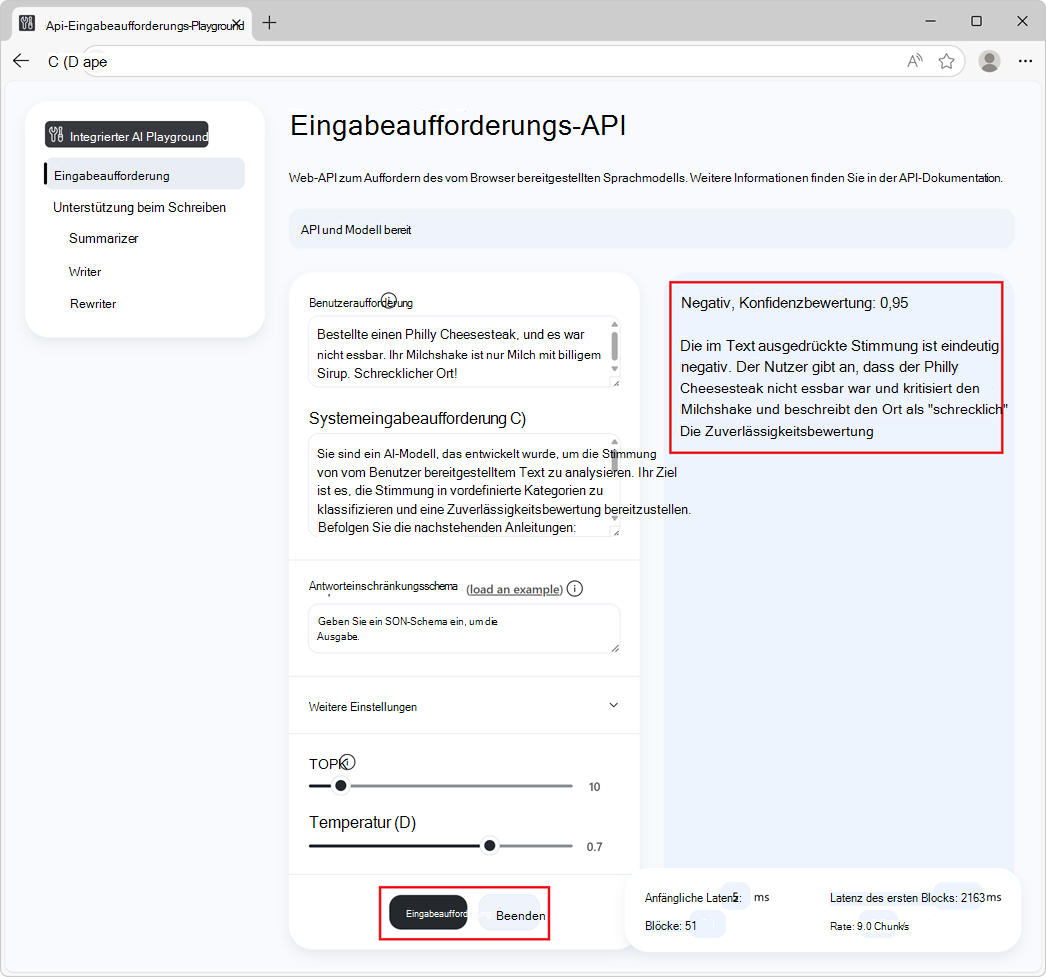
Klicken Sie jederzeit auf die Schaltfläche Beenden , um die Generierung der Antwort zu beenden.
Siehe auch:
- /built-in-ai/ – Quellcode und Infodatei für integrierte KI-Playgrounds, einschließlich des Prompt-API-Playgrounds.
Verwenden Sie die Prompt-API
Überprüfen, ob die API aktiviert ist
Bevor Sie die API im Code Ihrer Website oder Erweiterung verwenden, überprüfen Sie, ob die API aktiviert ist, indem Sie das Vorhandensein des LanguageModel Objekts testen:
if (!LanguageModel) {
  // The Prompt API is not available.
} else {
  // The Prompt API is available.
}
Prüfen, ob das Modell verwendet werden kann
Die Prompt-API kann nur verwendet werden, wenn das Gerät die Ausführung des Modells unterstützt und nachdem das Sprachmodell und die Modelllaufzeit von Microsoft Edge heruntergeladen wurden.
Um zu überprüfen, ob die API verwendet werden kann, verwenden Sie die LanguageModel.availability() folgende Methode:
const availability = await LanguageModel.availability();

if (availability == "unavailable") {
  // The model is not available.
}

if (availability == "downloadable" || availability == "downloading") {
  // The model can be used, but it needs to be downloaded first.
}

if (availability == "available") {
  // The model is available and can be used.
}
Erstellen einer neuen Sitzung
Beim Erstellen einer Sitzung wird der Browser angewiesen, das Sprachmodell in den Speicher zu laden, damit es verwendet werden kann. Bevor Sie das Sprachmodell auffordern können, erstellen Sie eine neue Sitzung mithilfe der create() folgenden Methode:
// Create a LanguageModel session.
const session = await LanguageModel.create();
Um die Modellsitzung anzupassen, können Sie Optionen an die create() Methode übergeben:
// Create a LanguageModel session with options.
const session = await LanguageModel.create(options);
Folgende Optionen sind verfügbar:
monitor, um den Fortschritt des Modelldownloads zu verfolgen.initialPrompts, um dem Modell Kontext zu den Eingabeaufforderungen zu geben, die an das Modell gesendet werden, und um ein Muster von Benutzer-/Assistenten-Interaktionen festzulegen, dem das Modell bei zukünftigen Eingabeaufforderungen folgen sollte.
Diese Optionen sind unten dokumentiert.
Überwachen des Fortschritts des Modelldownloads
Du kannst den Fortschritt des Modelldownloads verfolgen, indem du die monitor Option verwendest. Dies ist nützlich, wenn das Modell noch nicht vollständig auf das Gerät heruntergeladen wurde, auf dem es verwendet wird, um die Benutzer Ihrer Website darüber zu informieren, dass sie warten sollen.
// Create a LanguageModel session with the monitor option to monitor the model
// download.
const session = await LanguageModel.create({
  monitor: m => {
    // Use the monitor object argument to add an listener for the
    // downloadprogress event.
    m.addEventListener("downloadprogress", event => {
      // The event is an object with the loaded and total properties.
      if (event.loaded == event.total) {
        // The model is fully downloaded.
      } else {
        // The model is still downloading.
        const percentageComplete = (event.loaded / event.total) * 100;
      }
    });
  }
});
Bereitstellen einer Systemeingabeaufforderung für das Modell
Verwenden Sie die initialPrompts Option, um eine Systemeingabeaufforderung zu definieren, mit der dem Modell Anweisungen gegeben werden können, die beim Generieren von Text als Reaktion auf eine Eingabeaufforderung verwendet werden sollen.
Die Systemeingabeaufforderung, die Sie beim Erstellen einer neuen Sitzung angeben, wird während der gesamten Sitzung beibehalten, auch wenn das Kontextfenster aufgrund zu vieler Eingabeaufforderungen überläuft.
// Create a LanguageModel session with a system prompt.
const session = await LanguageModel.create({
  initialPrompts: [{
    role: "system",
    content: "You are a helpful assistant."
  }]
});
Wenn Sie die Eingabeaufforderung an einer anderen Stelle als an der 0. Position in initialPrompts platzieren, wird dies { role: "system", content: "You are a helpful assistant." } mit einem TypeError.
N-Shot-Eingabeaufforderung mit initialPrompts
Mit dieser initialPrompts Option können Sie auch Beispiele für Benutzer-/Assistenten-Interaktionen bereitstellen, die das Modell weiterhin verwenden soll, wenn Sie dazu aufgefordert werden.
Diese Technik wird auch als N-Shot-Prompting bezeichnet und ist nützlich, um die vom Modell generierten Antworten deterministischer zu gestalten.
// Create a LanguageModel session with multiple initial prompts, for N-shot
// prompting.
const session = await LanguageModel.create({
  initialPrompts: [
    { role: "system", content: "Classify the following product reviews as either OK or Not OK." },
    { role: "user", content: "Great shoes! I was surprised at how comfortable these boots are for the price. They fit well and are very lightweight." },
    { role: "assistant", content: "OK" },
    { role: "user", content: "Terrible product. The manufacturer must be completely incompetent." },
    { role: "assistant", content: "Not OK" },
    { role: "user", content: "Could be better. Nice quality overall, but for the price I was expecting something more waterproof" },
    { role: "assistant", content: "OK" }
  ]
});
Klonen Sie eine Sitzung, um die Unterhaltung mit denselben Optionen erneut zu starten
Klonen Sie eine vorhandene Sitzung, um das Modell ohne das Wissen aus den vorherigen Interaktionen, aber mit den gleichen Sitzungsoptionen aufzufordern.
Das Klonen einer Sitzung ist nützlich, wenn Sie die Optionen aus einer früheren Sitzung verwenden möchten, ohne das Modell jedoch mit früheren Antworten zu beeinflussen.
// Create a first LanguageModel session.
const firstSession = await LanguageModel.create({
  initialPrompts: [
    role: "system",
    content: "You are a helpful assistant."
  ]
});

// Later, create a new session by cloning the first session to start a new
// conversation with the model, but preserve the first session's settings.
const secondSession = await firstSession.clone();
Auffordern des Modells
Um das Modell aufzufordern, nachdem Sie eine Modellsitzung erstellt haben, verwenden Sie die session.prompt() oder-Methode session.promptStreaming() .
Warten Sie auf die endgültige Antwort
Die prompt Methode gibt eine Zusage zurück, die aufgelöst wird, sobald das Modell die Textgenerierung als Antwort auf Ihre Eingabeaufforderung abgeschlossen hat:
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Prompt the model and wait for the response to be generated.
const result = await session.prompt(promptString);

// Use the generated text.
console.log(result);
Token anzeigen, während sie generiert werden
Die promptStreaming Methode gibt sofort ein Stream-Objekt zurück. Verwenden Sie den Stream, um die Antworttoken anzuzeigen, während sie generiert werden:
// Create a LanguageModel session.
 const session = await LanguageModel.create();

// Prompt the model.
 const stream = session.promptStreaming(myPromptString);

// Use the stream object to display tokens that are generated by the model, as
// they are being generated.
for await (const chunk of stream) {
  console.log(chunk);
}
Sie können die prompt und-Methoden promptStreaming mehrmals innerhalb desselben Sitzungsobjekts aufrufen, um weiterhin Text zu generieren, der auf vorherigen Interaktionen mit dem Modell innerhalb dieser Sitzung basiert.
Einschränken der Modellausgabe mithilfe eines JSON-Schemas oder regulären Ausdrucks
Um das Format der Modellantworten deterministischer zu gestalten und die programmgesteuerte Verwendung zu vereinfachen, verwenden Sie die responseConstraint Option, wenn Sie das Modell dazu auffordern.
Die responseConstraint Option akzeptiert ein JSON-Schema oder einen regulären Ausdruck:
Damit das Modell mit einem in Zeichenfolgen konvertierten JSON-Objekt antwortet, das einem bestimmten Schema folgt, legen
responseConstraintSie es auf das JSON-Schema fest, das Sie verwenden möchten.Damit das Modell mit einer Zeichenfolge antwortet, die einem regulären Ausdruck entspricht, legen Sie ihn auf diesen regulären Ausdruck fest
responseConstraint.
Das folgende Beispiel zeigt, wie das Modell auf eine Eingabeaufforderung mit einem JSON-Objekt reagiert, das einem bestimmten Schema folgt:
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Define a JSON schema for the Prompt API to constrain the generated response.
const schema = {
  "type": "object",
  "required": ["sentiment", "confidence"],
  "additionalProperties": false,
  "properties": {
    "sentiment": {
      "type": "string",
      "enum": ["positive", "negative", "neutral"],
      "description": "The sentiment classification of the input text."
    },
    "confidence": {
      "type": "number",
      "minimum": 0,
      "maximum": 1,
      "description": "A confidence score indicating certainty of the sentiment classification."
    }
  }
}
;

// Prompt the model, by providing a system prompt and the JSON schema in the
// responseConstraints option.
const response = await session.prompt(
  "Ordered a Philly cheesesteak, and it was not edible. Their milkshake is just milk with cheap syrup. Horrible place!",
  {
    initialPrompts: [
      {
        role: "system",
        content: "You are an AI model designed to analyze the sentiment of user-provided text. Your goal is to classify the sentiment into predefined categories and provide a confidence score. Follow these guidelines:\n\n- Identify whether the sentiment is positive, negative, or neutral.\n- Provide a confidence score (0-1) reflecting the certainty of the classification.\n- Ensure the sentiment classification is contextually accurate.\n- If the sentiment is unclear or highly ambiguous, default to neutral.\n\nYour responses should be structured and concise, adhering to the defined output schema."
      },
    ],
    responseConstraint: schema
  }
);
Die Ausführung des obigen Codes gibt eine Antwort zurück, die ein in Zeichenfolgen konvertiertes JSON-Objekt enthält, z. B.:
{"sentiment": "negative", "confidence": 0.95}
Sie können die Antwort dann in Ihrer Codelogik verwenden, indem Sie sie mithilfe der JSON.parse() folgenden Funktion analysieren:
// Parse the JSON string generated by the model and extract the sentiment and
// confidence values.
const { sentiment, confidence } = JSON.parse(response);

// Use the values.
console.log(`Sentiment: ${sentiment}`);
console.log(`Confidence: ${confidence}`);
Senden mehrerer Nachrichten pro Prompt
Zusätzlich zu Zeichenfolgen akzeptieren die promptpromptStreaming und-Methoden auch ein Array von Objekten, die zum Senden mehrerer Nachrichten mit benutzerdefinierten Rollen verwendet werden. Die Objekte, die Sie senden, sollten im Format { role, content }, wobei entweder role oder assistantist user und content die Nachricht ist.
Gehen Sie beispielsweise folgendermaßen vor, um mehrere Benutzernachrichten und eine Assistent-Nachricht in derselben Eingabeaufforderung bereitzustellen:
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Prompt the model by sending multiple messages at once.
const result = await session.prompt([
  { role: "user", content: "First user message" },
  { role: "user", content: "Second user message" },
  { role: "assistant", content: "The assistant message" }
]);
Beenden der Textgenerierung
Um einen Prompt abzubrechen, bevor die von zurückgegebene session.prompt() Zusage aufgelöst wurde oder bevor der zurückgegebene Stream beendet session.promptStreaming() wurde, verwenden Sie ein AbortController Signal:
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Create an AbortController object.
const abortController = new AbortController();

// Prompt the model by passing the AbortController object by using the signal
// option.
const stream = session.promptStreaming(myPromptString , {
  signal: abortController.signal
});

// Later, perhaps when the user presses a "Stop" button, call the abort()
// method on the AbortController object to stop generating text.
abortController.abort();
Löschen einer Sitzung
Zerstören Sie die Sitzung, um dem Browser mitzuteilen, dass Sie das Sprachmodell nicht mehr benötigen, damit das Modell aus dem Speicher entladen werden kann.
Sie können eine Sitzung auf zwei verschiedene Arten zerstören:
- Mithilfe der
destroy()Methode. - Durch die Verwendung einer
AbortController.
Zerstörung einer Sitzung mit der destroy()-Methode
// Create a LanguageModel session.
const session = await LanguageModel.create();

// Later, destroy the session by using the destroy method.
session.destroy();
Zerstörung einer Sitzung mithilfe eines AbortControllers
// Create an AbortController object.
const controller = new AbortController();

// Create a LanguageModel session and pass the AbortController object by using
// the signal option.
const session = await LanguageModel.create({ signal: controller.signal });

// Later, perhaps when the user interacts with the UI, destroy the session by
// calling the abort() function of the AbortController object.
controller.abort();
Feedback senden
Die Entwicklervorschau für die Prompt-API soll dazu beitragen, Anwendungsfälle für vom Browser bereitgestellte Sprachmodelle zu entdecken.
Wir interessieren uns für folgende Themen:
- Der Bereich der Szenarien, für die Sie die Prompt-API verwenden möchten.
- Probleme mit der Prompt-API.
- Probleme mit den Sprachmodellen.
- Ob neue aufgabenspezifische APIs nützlich wären.
Um Feedback zu Ihren Szenarien und den Aufgaben zu senden, die Sie ausführen möchten, fügen Sie bitte einen Kommentar zum Problem mit Feedback zur Prompt-API hinzu.
Wenn Sie bei der Verwendung der API Probleme bemerken, melden Sie diese im Repository.
Sie können auch zur Diskussion über den Entwurf der Prompt-API im Repository der W3C Web Machine Learning Working Group beitragen.
Siehe auch
- Prompt-API-Spezifikationsentwurf
- webmachinelearning/prompt-api GitHub-Repository
- Schreiben, Umschreiben und Zusammenfassen von Text mit den Schreibhilfe-APIs
- Korrigieren von Grammatik-, Rechtschreib- und Interpunktionsfehlern in Texten mit der Korrekturlese-API
- Übersetzen von Text mit der Übersetzer-API
- /built-in-ai/ – Quellcode und Infodatei für integrierte KI-Playgrounds, einschließlich des Prompt-API-Playgrounds.