Profilerstellungsdaten
Bevor Sie Daten bereinigen oder transformieren, müssen Sie verstehen, was sich in Ihren Tabellen befindet. Profildaten bezieht sich auf die Untersuchung Ihrer Datensätze, um Zusammenfassungsstatistiken zu generieren – Häufigkeiten, Mittelwerte, Wertverteilungen und Nullwertprozentsätze – die Qualität und Struktur Ihrer Daten aufzeigen. Diese Foundation hilft Ihnen, Probleme wie fehlende Werte, Ausreißer und unerwartete Muster zu identifizieren, bevor sie Probleme nach unten verursachen.
In dieser Lektion erfahren Sie, wie Sie zusammenfassende Statistiken mithilfe von SQL-Befehlen und dem Datenprofilfeature in Azure Databricks generieren.
Generieren von Zusammenfassungsstatistiken mit SQL
Azure Databricks stellt SQL-Befehle bereit, die Statistiken zu Ihren Tabellen sammeln und anzeigen. Diese Statistiken helfen dem Abfrageoptimierer bei der Auswahl effizienter Ausführungspläne und geben Ihnen Einblicke in die Merkmale Ihrer Daten.
Sammeln von Statistiken mit ANALYZE TABLE
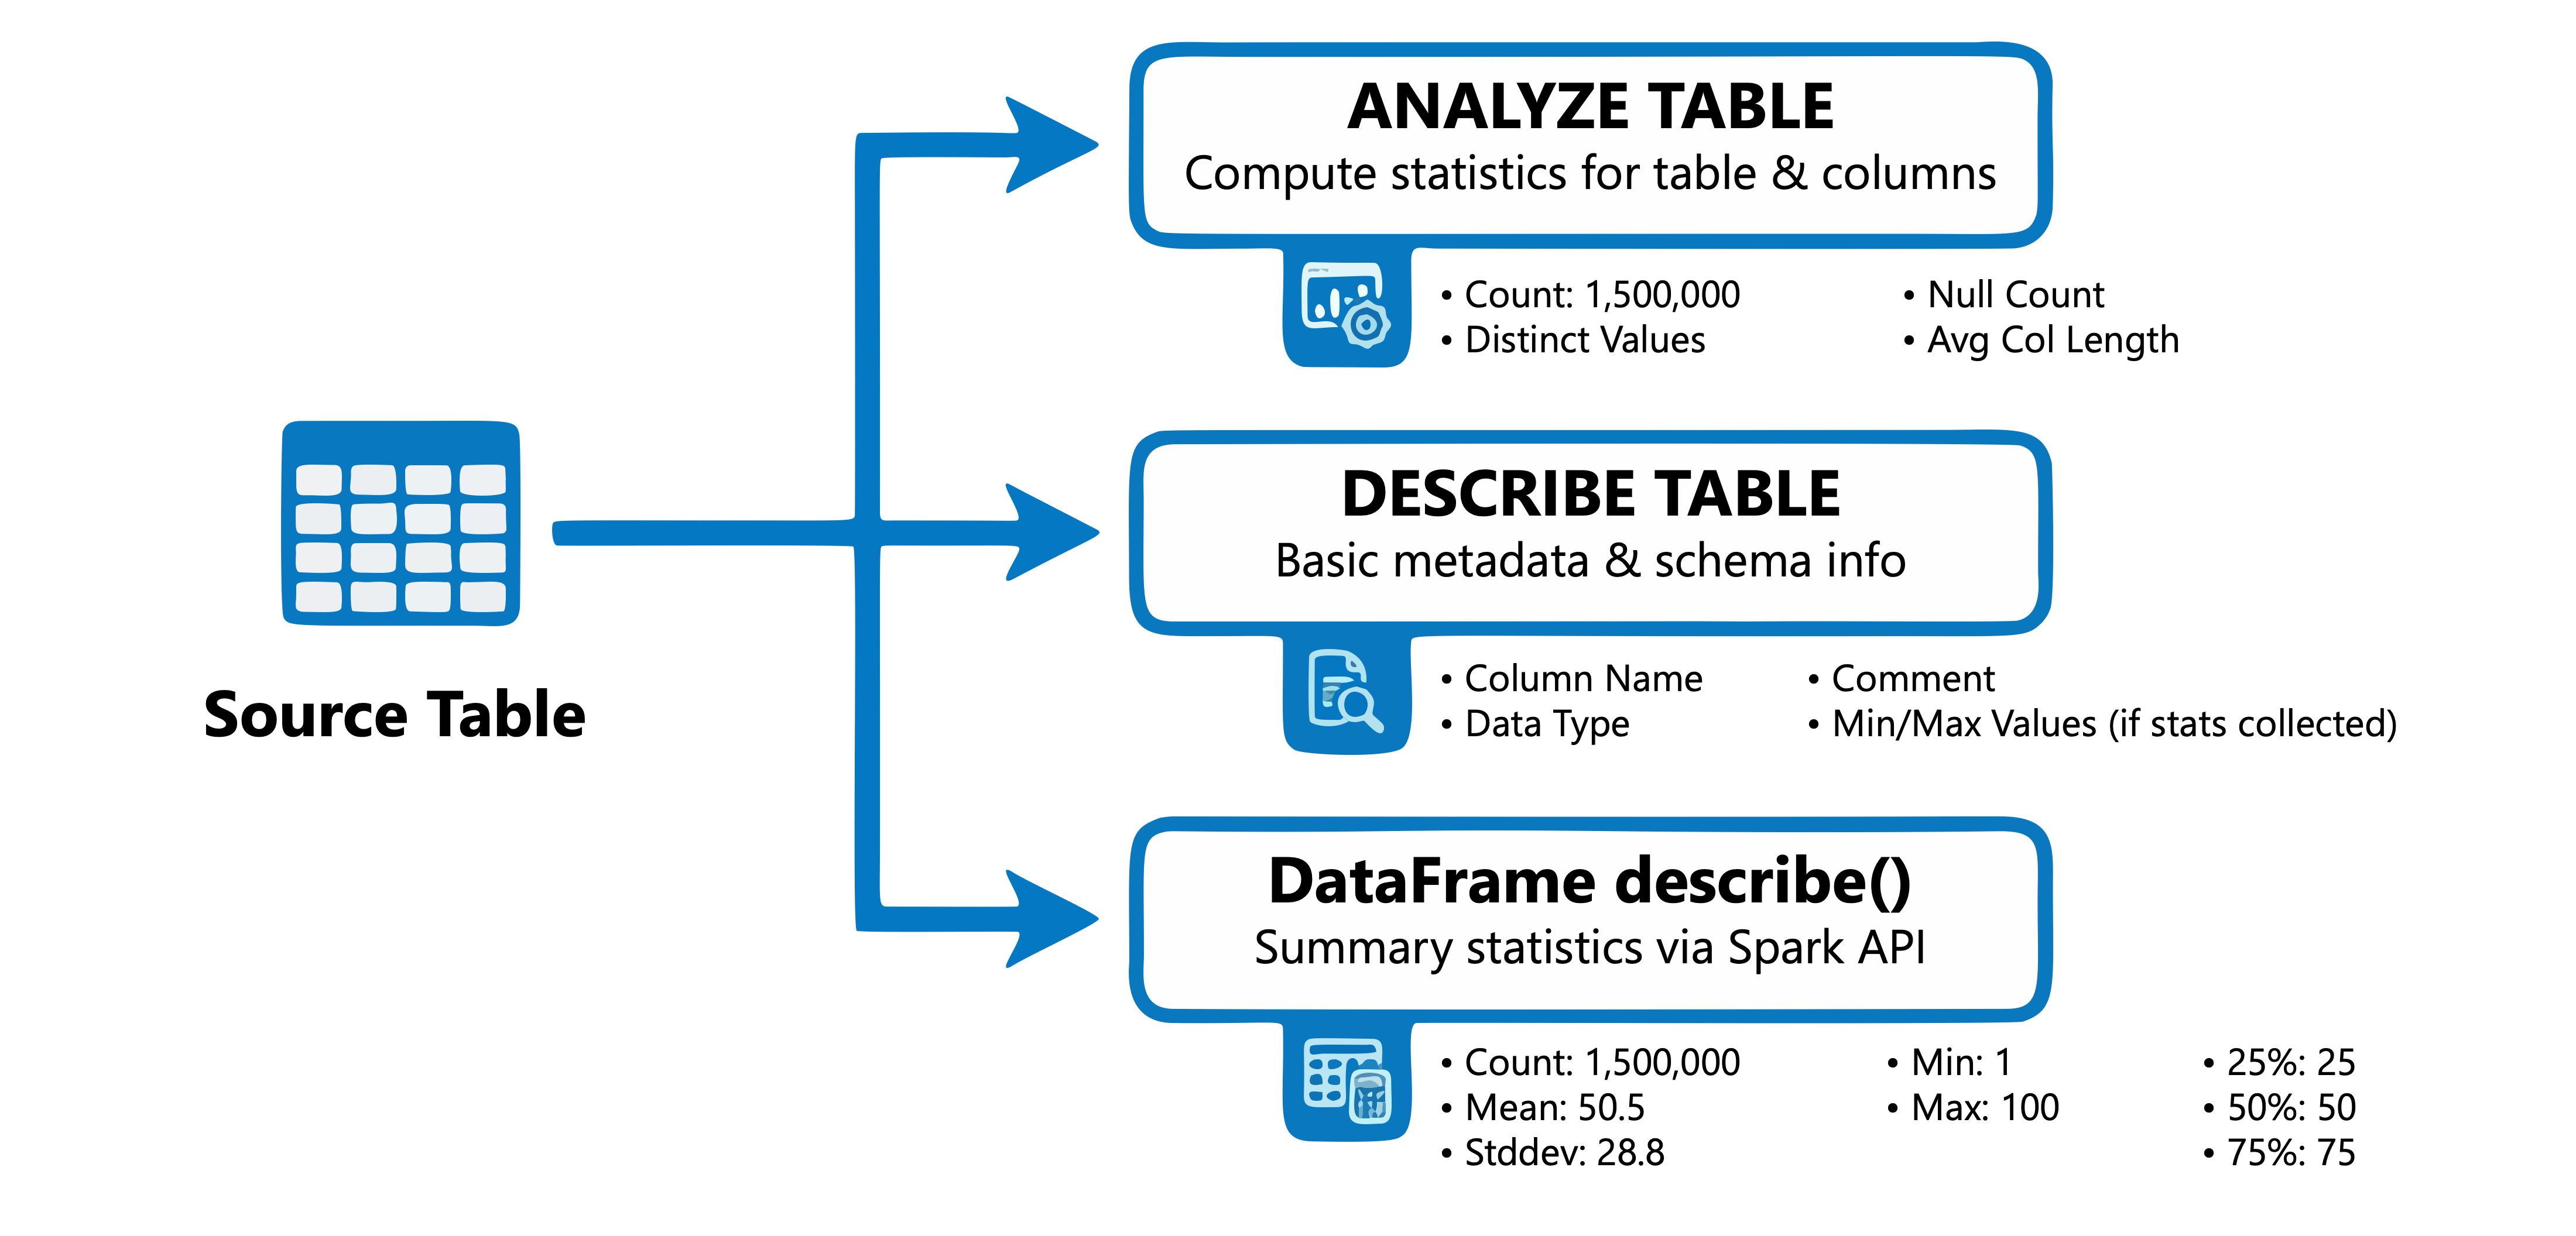
Der ANALYZE TABLE Befehl berechnet Statistiken für eine Tabelle oder bestimmte Spalten. Zu diesen Statistiken gehören Zeilenanzahlen, Metriken auf Spaltenebene wie Mindest- und Höchstwerte, NULL-Zählungen und unterschiedliche Wertanzahlen.
-- Collect basic table statistics (row count and size)
ANALYZE TABLE sales.transactions COMPUTE STATISTICS;

-- Collect statistics for specific columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR COLUMNS
    transaction_id, amount, customer_id;

-- Collect statistics for all columns
ANALYZE TABLE sales.transactions COMPUTE STATISTICS FOR ALL COLUMNS;
Wenn Sie eine bestimmte Spalte analysieren, erhalten Sie detaillierte Metriken:
-- View column-level statistics
DESC EXTENDED sales.transactions amount;
Dadurch werden Metriken zurückgegeben, einschließlich Minimalwert, Maximalwert, Anzahl null, unterschiedliche Anzahl, durchschnittliche Spaltenlänge und maximale Spaltenlänge.
Abrufen von Statistiken mit DESCRIBE TABLE
Der DESCRIBE TABLE EXTENDED Befehl zeigt gesammelte Statistiken zusammen mit Tabellenmetadaten an:
DESCRIBE TABLE EXTENDED sales.transactions;
Sie können pySpark auch verwenden, um Tabellenmetadaten abzurufen und Zusammenfassungsstatistiken zu generieren:
# Generate summary statistics for numeric columns using the DataFrame API
df = spark.table("sales.transactions")
df.describe().show()
Die describe() Methode gibt Anzahl, Mittelwert, Standardabweichung, Min und Max für numerische und Zeichenfolgenspalten zurück.
Die DESCRIBE TABLE EXTENDED Ausgabe enthält eine Statistics Zeile, in der die Größe der Tabelle in Byte und, nach dem Ausführen von ANALYZE TABLE ... COMPUTE STATISTICS, die Zeilenanzahl angezeigt werden. Für verwaltete Tabellen im Unity-Katalog wird die predictive Optimierung automatisch ausgeführt ANALYZE , um Statistiken auf dem aktuellen Stand zu halten.
Tipp
Führen Sie die Ausführung ANALYZE TABLE nach dem Laden von Massendaten oder signifikanten Änderungen aus, um sicherzustellen, dass der Abfrageoptimierer genaue Statistiken für die Planung effizienter Abfragen hat.
Datenprofiling im Unity-Katalog verwenden
Über SQL-Befehle hinaus bietet Azure Databricks die Datenqualitätsüberwachung im Unity-Katalog – ein Dach, der zwei unterschiedliche Funktionen abdeckt:
- Anomalieerkennung (Public Preview) überwacht alle Tabellen in einem Schema automatisch. Es analysiert historische Muster, um die Aktualität der einzelnen Tabellen (wie kürzlich sie aktualisiert wurden) und die Vollständigkeit (ob die erwartete Anzahl von Zeilen eingetroffen ist) auszuwerten. Sie aktivieren es einmal auf der Schemaebene im Katalog-Explorer, und Azure Databricks bestimmt, wie oft jede Tabelle überprüft werden soll. Verwenden Sie die Anomalieerkennung für eine automatisierte und umfassende Abdeckung Ihrer Tabellen, ohne eine Konfiguration für einzelne Tabellen erforderlich zu machen.
- Die Datenprofilerstellung stellt eine umfassende statistische Analyse pro Tabelle bereit– Nachverfolgung von Verteilungen, Nullprozentsätzen, Driftmetriken und Modellleistung im Laufe der Zeit. Sie konfigurieren sie einzeln für jede Tabelle. Verwenden Sie die Datenprofilerstellung für Ihre wichtigsten Tabellen, in denen Sie detaillierte historische Trends benötigen.
Für datentechnische Arbeiten, die sich auf die Reinigung und Qualität konzentrieren, verwenden Sie beide: Anomalieerkennung als Frühwarnsystem in allen Tabellen und Datenprofilierung für eine eingehende Überwachung von Schlüsseltabellen.
Grundlegendes zu Profiltypen
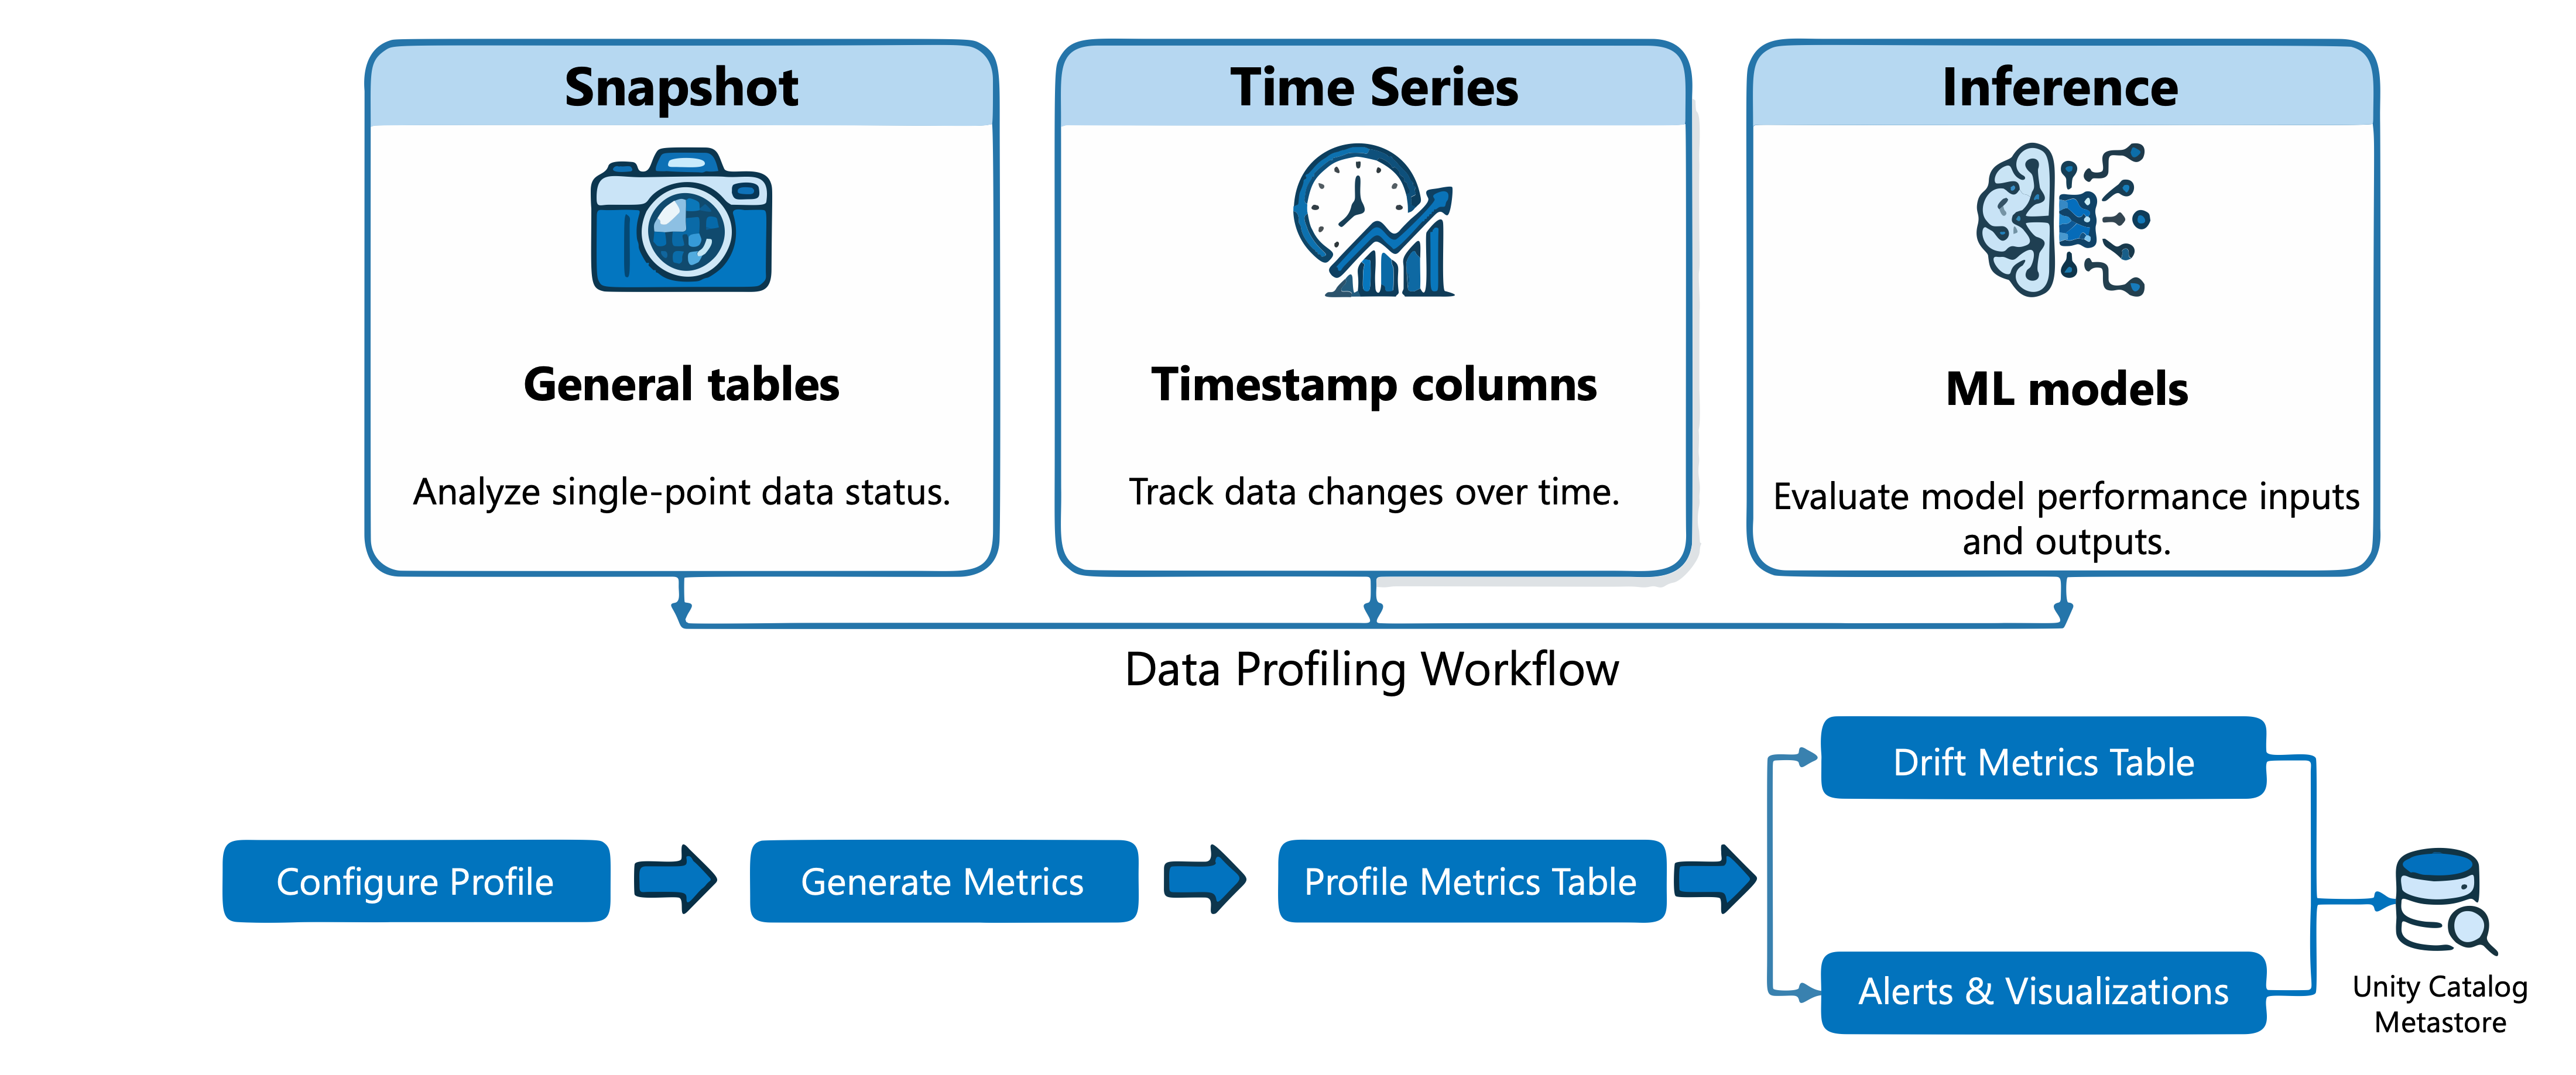
Die Datenprofilerstellung unterstützt drei Analysetypen, die jeweils für unterschiedliche Szenarien geeignet sind:
| Profiltyp | Anwendungsfall | Hauptmerkmale |
|---|---|---|
| Momentaufnahme | Allgemeine Tabellen | Berechnet Metriken über die gesamte Tabelle mit jeder Aktualisierung |
| Zeitreihe | Tabellen mit Zeitstempelspalten | Erfasst Metriken über Zeitfenster hinweg, um Trends zu erkennen |
| Schlussfolgerung | ML-Modell-Ableitungstabellen | Überwacht Modelleingaben, Vorhersagen und Genauigkeit im Laufe der Zeit |
Bei Datentechnikaufgaben, die sich auf die Datenqualität konzentrieren, sind die Snapshot- und Zeitreihenprofile am relevantesten.
Erstellen eines Profils mithilfe der Benutzeroberfläche
So erstellen Sie ein Profil im Katalog-Explorer:
- Navigieren Sie im Katalog-Explorer zu Ihrer Tabelle.
- Wählen Sie die Registerkarte "Qualität " aus.
- Wenn die Anomalieerkennung für das Schema nicht aktiviert ist, wählen Sie "Aktivieren" aus. Wenn die Anomalieerkennung bereits aktiviert ist, wählen Sie "Konfigurieren" aus.
- Wählen Sie im Dialogfeld "Datenqualitätsüberwachung " im Feld "Datenprofilerstellung " die Option "Konfigurieren" aus.
- Wählen Sie Ihren Profiltyp aus, und konfigurieren Sie Optionen wie Granularität und Planung.
Das Profil generiert eine Profilmetrikentabelle mit Zusammenfassungsstatistiken und einer Driftmetrikentabelle, die Verteilungsänderungen im Laufe der Zeit nachverfolgt. Azure Databricks füllt die Driftmetrikentabelle auf, wenn eine Baseline-Tabelle oder ein aufeinander folgendes Zeitfenster verfügbar ist.
Erstellen eines Profils mithilfe der API
Verwenden Sie für den programmgesteuerten Zugriff das Databricks SDK. Installieren oder aktualisieren Sie das SDK, um die aktuelle API abzurufen:
%pip install "databricks-sdk>=0.68.0"
Erstellen Sie dann ein Momentaufnahmeprofil für eine Tabelle:
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.dataquality import Monitor, DataProfilingConfig, SnapshotConfig

w = WorkspaceClient()

# Retrieve the table ID and schema ID required by the API
table = w.tables.get(full_name="main.sales.transactions")
schema = w.schemas.get(full_name="main.sales")

w.data_quality.create_monitor(
    monitor=Monitor(
        object_type="table",
        object_id=table.table_id,
        data_profiling_config=DataProfilingConfig(
            output_schema_id=schema.schema_id,
            assets_dir="/Workspace/Users/user@example.com/monitoring",
            snapshot=SnapshotConfig()
        )
    )
)
Um das Profil zu aktualisieren und Metriken zu aktualisieren:
from databricks.sdk.service.dataquality import Refresh

w.data_quality.create_refresh(
    object_type="table",
    object_id=table.table_id,
    refresh=Refresh(object_type="table", object_id=table.table_id)
)
Interpretieren von Profilerstellungsergebnissen
Profilerstellung generiert Metriken, die Ihnen helfen, die Datenqualität zu bewerten und Probleme zu identifizieren, die Aufmerksamkeit erfordern.
Wichtige Metriken, die untersucht werden sollen
Die Profilmetrikentabelle enthält Statistiken für jede Spalte:
| Metric | Was es zeigt |
|---|---|
count und num_nulls |
Vollständigkeit der Daten – hohe Null-Prozentwerte können auf Aufnahmeprobleme hinweisen. |
distinct_count |
Kardinalität – unerwartete Werte können Probleme mit der Datenqualität vorschlagen |
min
max
avg
stddev
|
Verteilungsmerkmale – Ausreißer oder schiefe Verteilungen |
frequent_items |
Die häufigsten Werte – hilft bei der Identifizierung dominanter Kategorien oder Duplikate |
quantiles |
Wertverteilung – nützlich zum Erkennen des Schiefegrads |
Erkennen von Problemen mit der Datenqualität
Wenn Sie Profilerstellungsergebnisse untersuchen, suchen Sie nach den folgenden allgemeinen Indikatoren:
- Hohe NULL-Prozentsätze in Spalten, die Werte enthalten sollen
- Unerwartete unterschiedliche Zählwerte, wie z. B. einzigartige Kennungen, die nicht einzigartig sind
- Wertbereiche außerhalb erwarteter Grenzen, z. B. negative Beträge, bei denen nur positive Werte gültig sind
- Verteilungsänderungen im Laufe der Zeit, die auf Datenabweichung hinweisen können
Die Driftmetrikentabelle berechnet statistische Tests wie den Kolmogorov-Smirnov (KS)-Test für numerische Spalten und chi-quadratischen Test für kategorisierte Spalten. Diese Tests quantifizieren, wie viele Verteilungen sich geändert haben.
Wenn Sie diese Muster verstehen, können Sie geeignete Bereinigungs- und Validierungsregeln für Ihre Datenpipelinen entwerfen.