Duplikate und Nullwerte auflösen
Probleme mit der Datenqualität wie doppelte Datensätze und NULL-Werte können Ihre Analyse- und Downstreamprozesse gefährden. Ob Duplikate durch gleichzeitige Datenladevorgänge entstehen oder Nullwerte aufgrund unvollständiger Quelldaten auftreten, ist es eine wesentliche Verantwortung von Dateningenieuren, die in Azure Databricks arbeiten, sich mit diesen Problemen auseinanderzusetzen.
In dieser Lektion erfahren Sie, wie Sie doppelte, fehlende und NULL-Werte mithilfe von SQL- und PySpark-Ansätzen identifizieren und auflösen.
Identifizieren doppelter Datensätze
Bevor Sie Duplikate entfernen können, müssen Sie sie finden. Duplikate treten in der Regel auf, wenn derselbe Datensatz mehrmals in einer Tabelle angezeigt wird, häufig aufgrund von Datenintegrationsproblemen, wiederholten Aufnahmevorgängen oder gleichzeitigen Schreibvorgängen.
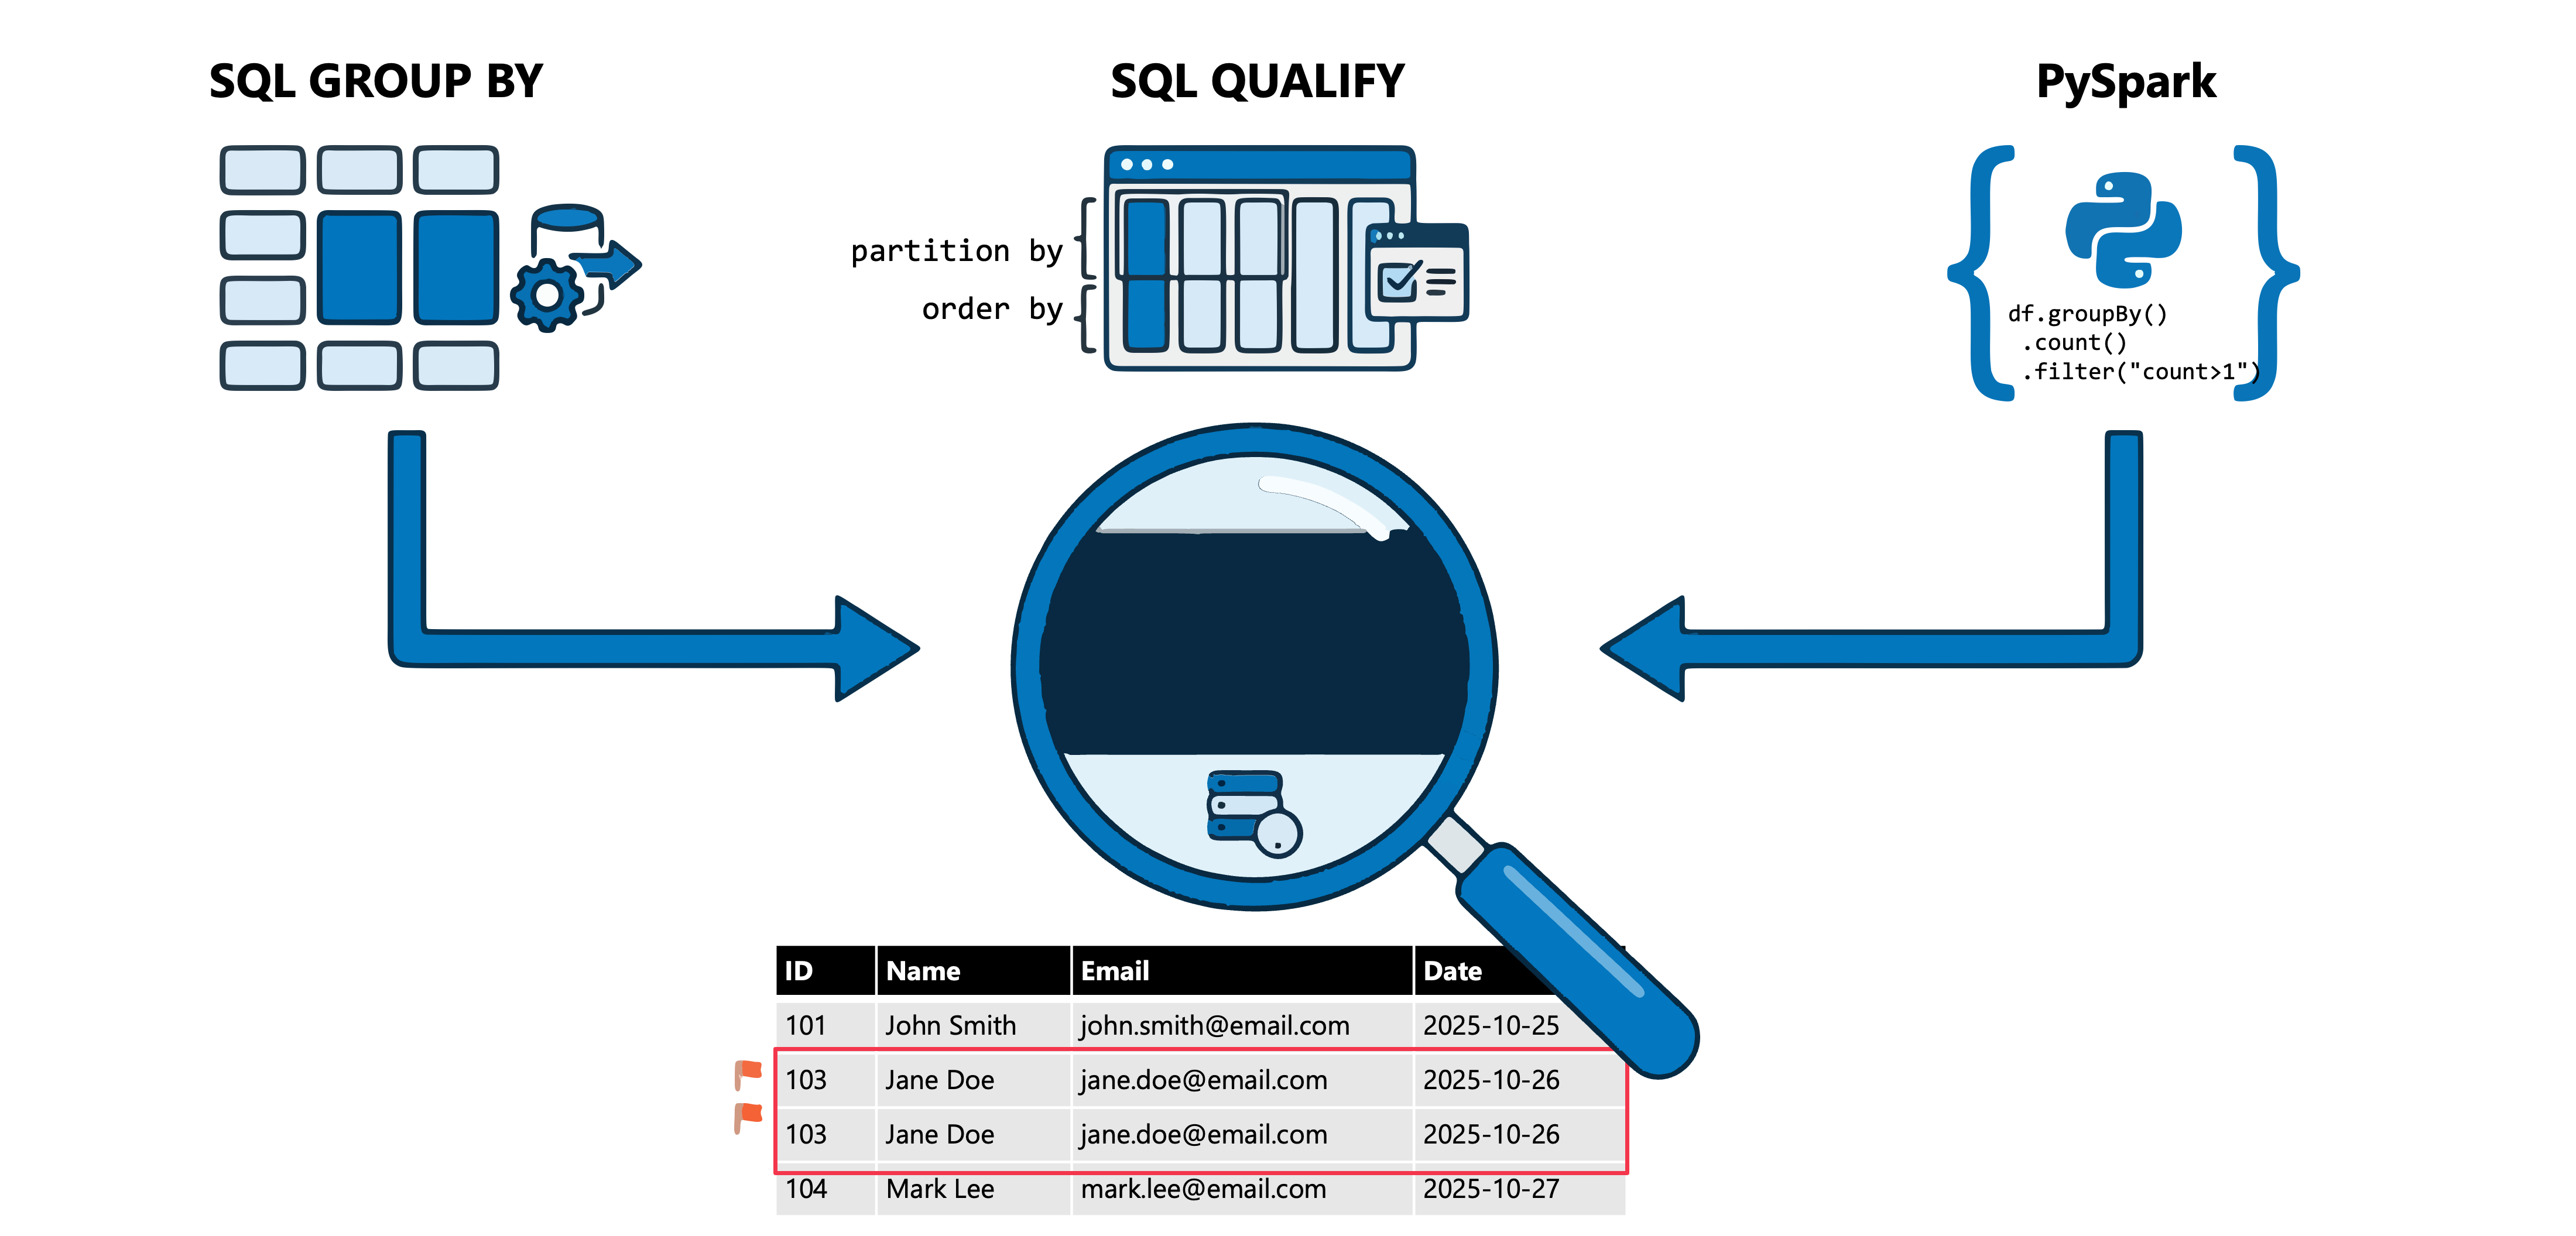
Verwenden von GROUP BY und HAVING zum Auffinden von Duplikaten
Die einfachste Möglichkeit zum Identifizieren von Duplikaten besteht darin, Datensätze zu gruppieren und Vorkommen zu zählen. Die HAVING Klausel filtert die gruppierten Ergebnisse so, dass nur Werte angezeigt werden, die mehrmals angezeigt werden.
SELECT
    customer_id,
    email,
    COUNT(*) AS occurrence_count
FROM sales.customers
GROUP BY customer_id, email
HAVING COUNT(*) > 1
ORDER BY occurrence_count DESC;
Diese Abfrage gibt alle Kombinationen von customer_id und email zurück, die mehrmals in der Tabelle erscheinen, um Ihnen einen Überblick über das Ausmaß der Duplizierung zu verschaffen.
Verwenden von QUALIFY mit Fensterfunktionen
Die QUALIFY Klausel bietet einen einfacheren Ansatz, indem die Ergebnisse von Fensterfunktionen direkt gefiltert werden, ohne dass Unterabfragen erforderlich sind. Dieser Ansatz ist besonders nützlich, wenn Sie nicht nur die Anzahl der doppelten Zeilen, sondern auch die tatsächlichen Duplikate sehen möchten.
SELECT *
FROM sales.customers
QUALIFY COUNT(*) OVER (PARTITION BY customer_id, email) > 1;
Diese Abfrage gibt möglicherweise Ergebnisse wie folgt zurück:
| Kunden_ID | name | erstellt_am | status | |
|---|---|---|---|---|
| 1001 | jane@contoso.com | Jane Doe | 2024-01-15 | Active |
| 1001 | jane@contoso.com | Jane D. | 2024-03-20 | Active |
| 1002 | bob@fabrikam.com | Bob Smith | 2024-02-10 | Ausstehend |
| 1002 | bob@fabrikam.com | Robert Smith | 11.02.2024 | Active |
Mit diesem Muster erhalten Sie alle Spalten aus den doppelten Zeilen, wodurch die Untersuchung der Quelle der Duplizierung erleichtert wird.
Suchen von Duplikaten mithilfe von PySpark
In PySpark können Sie Fensterfunktionen in Kombination mit Filtern verwenden, um doppelte Datensätze zu identifizieren:
from pyspark.sql.functions import count
from pyspark.sql.window import Window

window_spec = Window.partitionBy("customer_id", "email")

duplicates_df = (
    df.withColumn("row_count", count("*").over(window_spec))
    .filter("row_count > 1")
    .drop("row_count")
)

display(duplicates_df)
Verwenden Sie alternativ die exceptAll() Methode, um den ursprünglichen DataFrame mit einer deduplizierten Version zu vergleichen:
df_duplicates = df.exceptAll(df.dropDuplicates(["customer_id", "email"]))
display(df_duplicates)
Bei der Methode exceptAll() wird eine Set-Differenz durchgeführt, bei der Duplikate erhalten bleiben. Es gibt alle Zeilen aus dem ersten DataFrame zurück, die nicht im zweiten DataFrame enthalten sind, wobei doppelte Vorkommen erhalten bleiben. So funktioniert es:
-
df.dropDuplicates(["customer_id", "email"])erstellt einen DataFrame mit einer Zeile pro eindeutiger Kombination -
exceptAll()Vergleicht den ursprünglichen DataFrame mit dieser deduplizierten Version. - Für jede eindeutige Kombination wird ein Vorkommen "abgeglichen" und entfernt, wobei nur die zusätzlichen Duplikate verbleiben.
Wenn der Kunde 1001 beispielsweise dreimal im ursprünglichen DataFrame und einmal in der deduplizierten Version angezeigt wird, werden zwei Zeilen (die zusätzlichen Vorkommen) von exceptAll() zurückgegeben.
Hinweis
Im Gegensatz dazu except(), durch das alle übereinstimmenden Zeilen entfernt und unterschiedliche Ergebnisse zurückgegeben werden, exceptAll() bleibt die doppelte Struktur erhalten. Wenn Sie drei identische Zeilen im Original und eine im deduplizierten Satz haben, exceptAll() werden genau zwei Zeilen zurückgegeben.
Entfernen doppelter Datensätze
Nachdem Sie Duplikate identifiziert haben, können Sie eine Lösungsstrategie basierend auf Ihren Datenanforderungen auswählen.
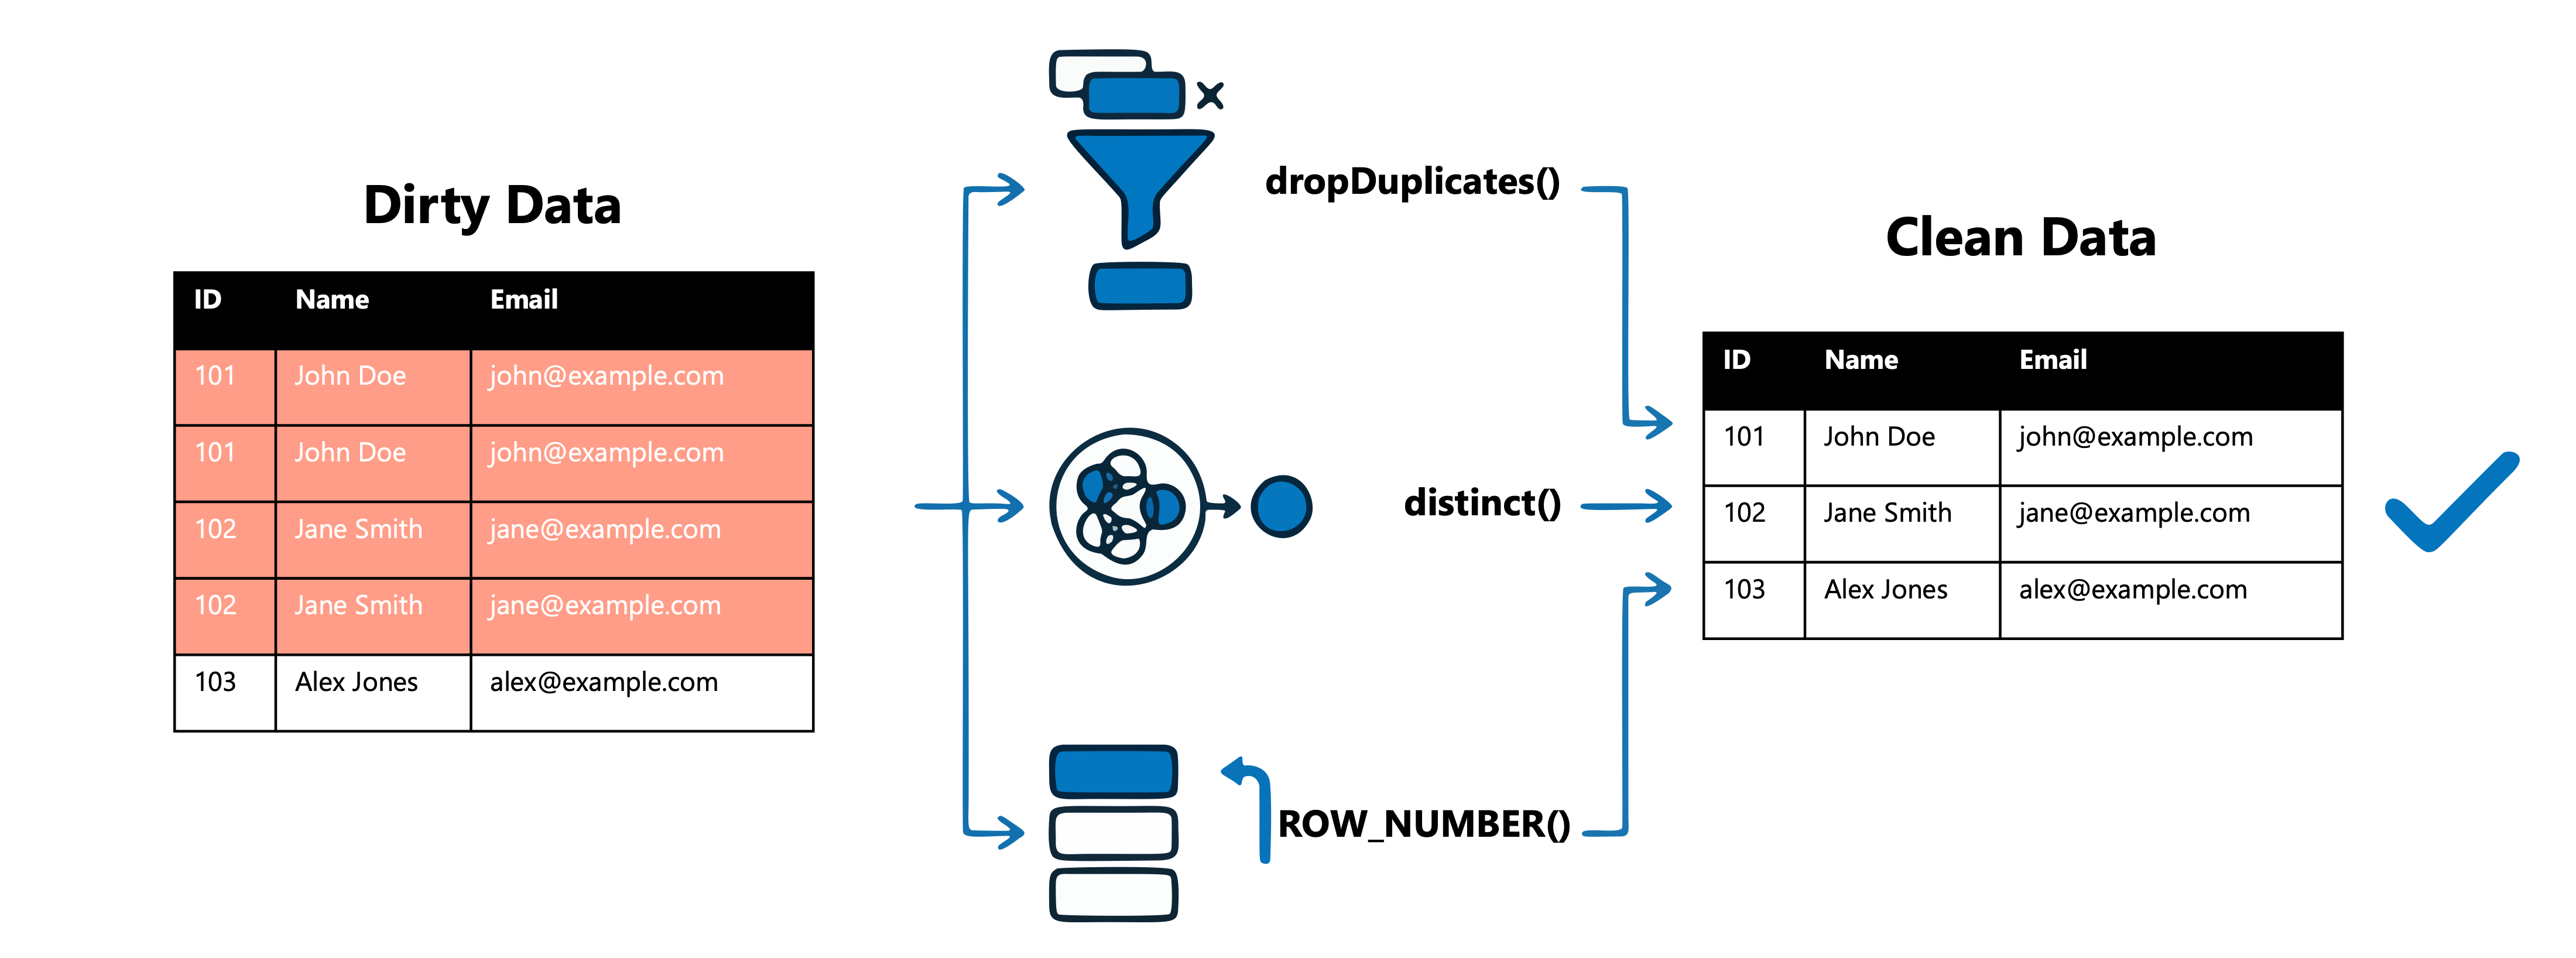
Duplikate in PySpark entfernen
Die dropDuplicates() Methode entfernt doppelte Zeilen basierend auf angegebenen Spalten und behält für jede Kombination eine Zeile bei. Wenn sich Zeilen in anderen Spalten unterscheiden, ist nicht garantiert, welche Zeile erhalten bleibt:
df_clean = df.dropDuplicates(["customer_id", "email"])
Verwenden Sie distinct() für die vollständige Zeilendeduplizierung über alle Spalten hinweg.
df_unique = df.distinct()
Beibehalten bestimmter Zeilen mithilfe von ROW_NUMBER
Wenn Sie steuern müssen, welches Duplikat beibehalten werden soll, verwenden Sie diese Option ROW_NUMBER()QUALIFY , um Datensätze basierend auf Kriterien wie dem neuesten Update auszuwählen:
SELECT *
FROM sales.customers
QUALIFY ROW_NUMBER() OVER (
    PARTITION BY customer_id
    ORDER BY updated_at DESC
) = 1;
Diese Abfrage partitioniert Datensätze nach customer_id, sortiert sie nach updated_at absteigender Reihenfolge und behält nur den zuletzt aktualisierten Datensatz für jeden Kunden.
Behandeln von Null- und fehlenden Werten
Nullwerte stellen fehlende oder unbekannte Daten dar. Je nach Ihren Analyseanforderungen müssen Sie möglicherweise Zeilen mit Nullen entfernen, durch Standardwerte ersetzen oder statistische Berechnungen verwenden.
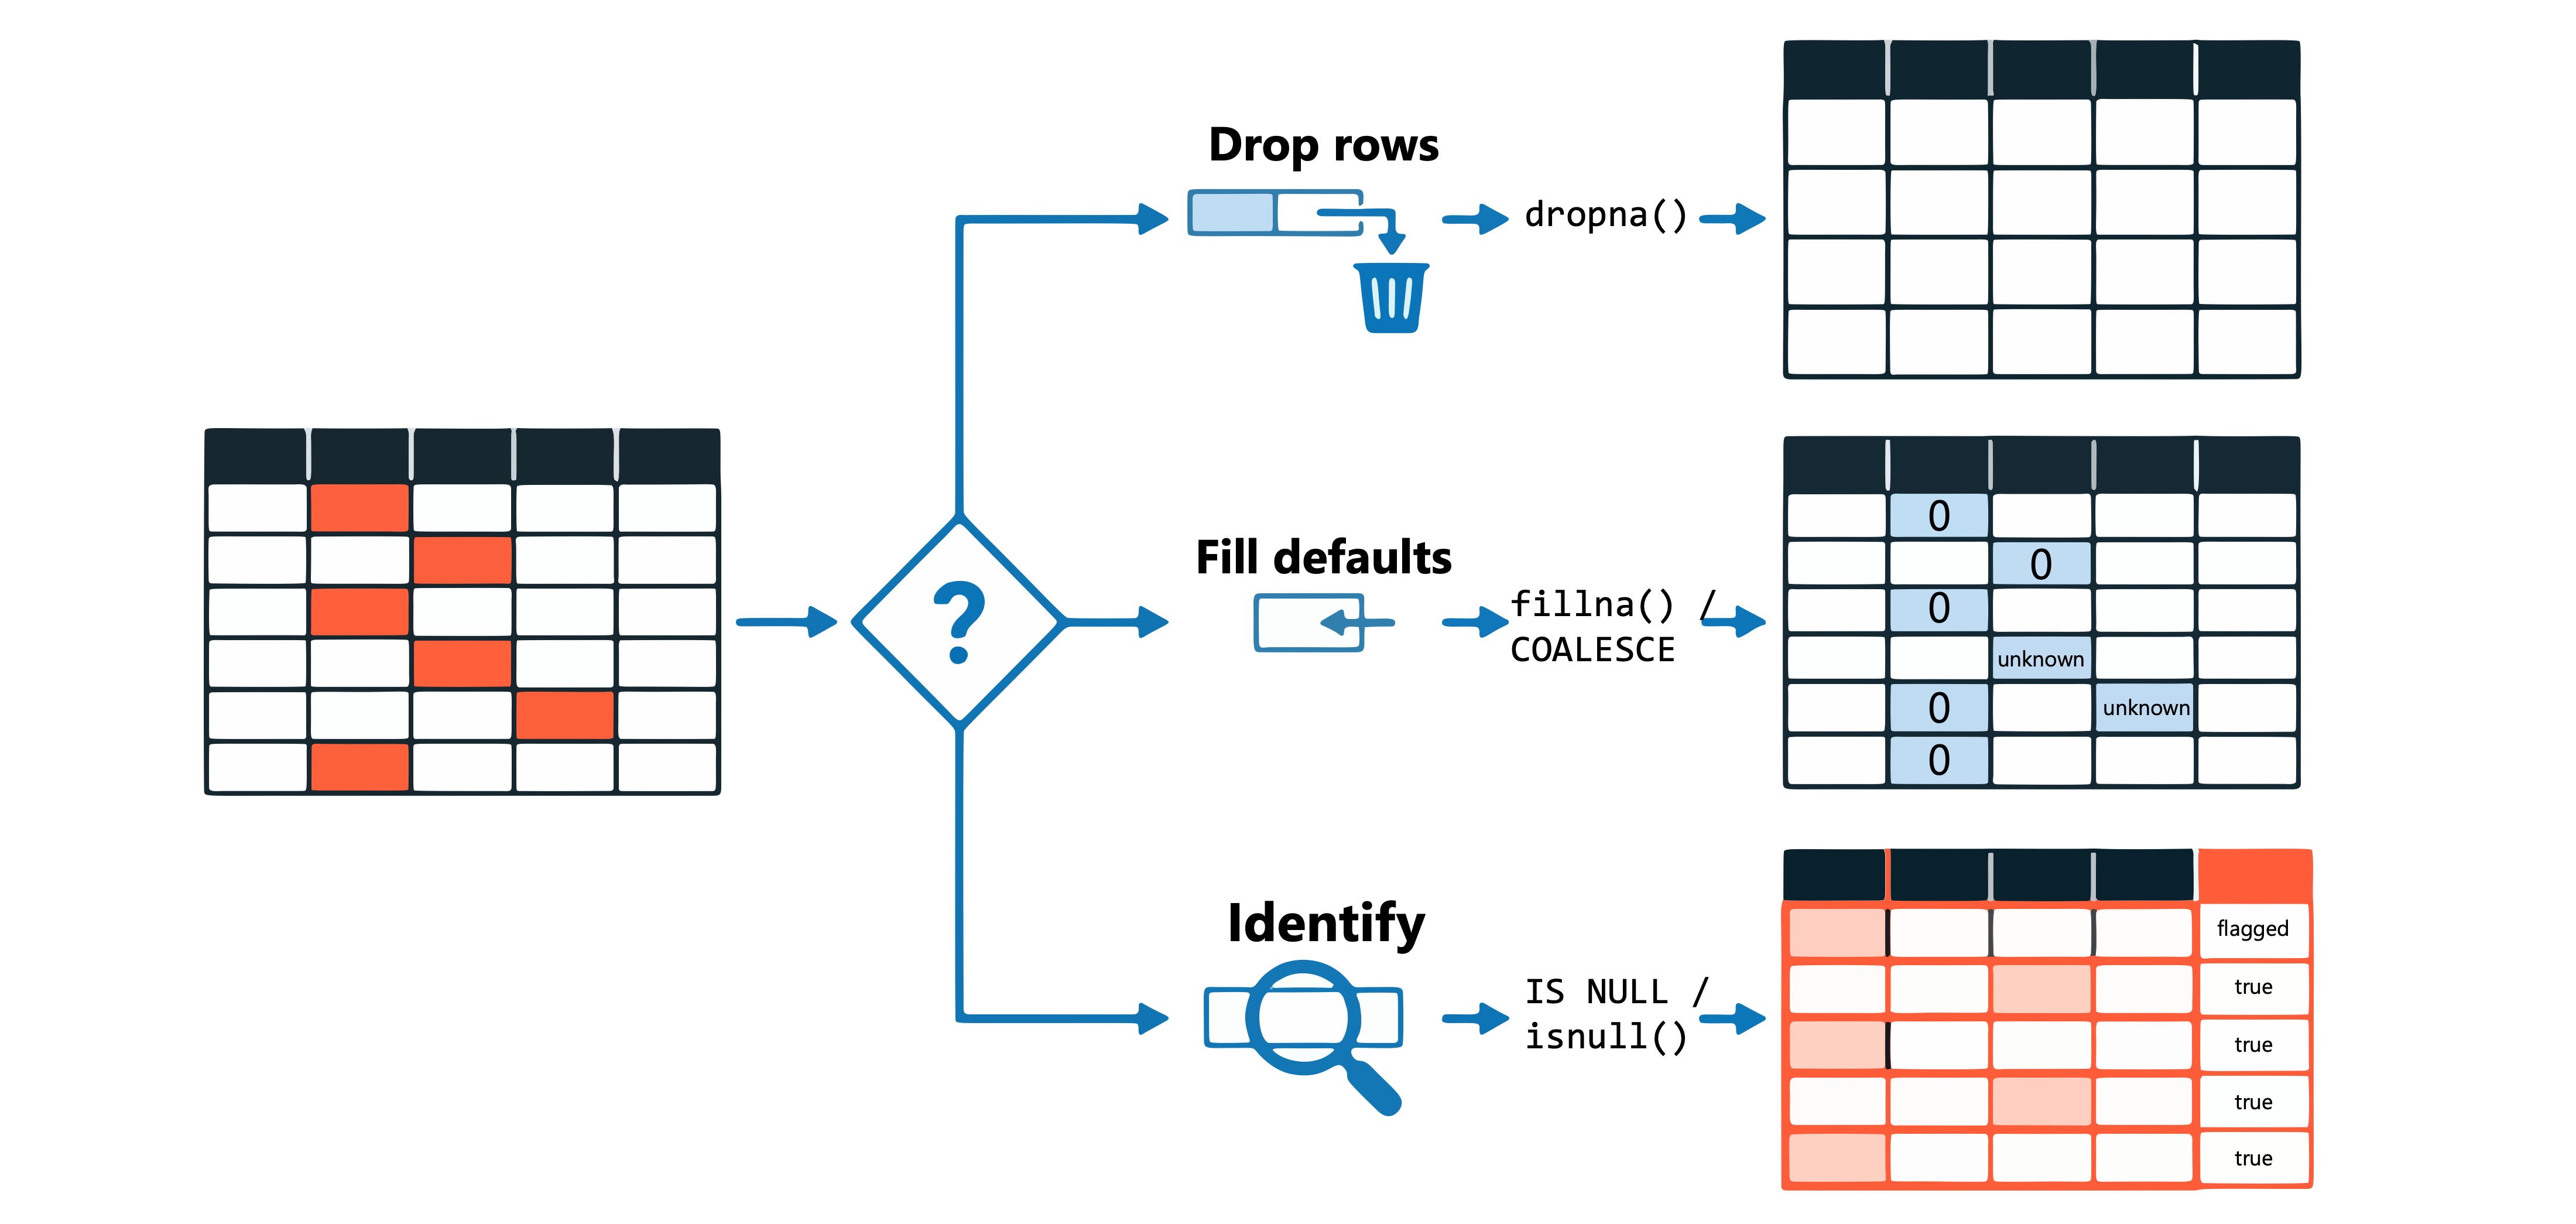
Identifizieren von Nullwerten
Verwenden Sie die isnull() Funktion oder den IS NULL Operator, um Datensätze mit fehlenden Werten zu finden:
SELECT *
FROM sales.transactions
WHERE amount IS NULL
   OR customer_id IS NULL;
So zählen Sie Null-Vorkommen pro Spalte:
SELECT
    COUNT(*) AS total_rows,
    COUNT(*) - COUNT(amount) AS null_amount_count,
    COUNT(*) - COUNT(customer_id) AS null_customer_count
FROM sales.transactions;
Zeilen mit Nullwerten ablegen
In PySpark entfernt die dropna() Methode Zeilen mit NULL-Werten:
# Drop rows where any column is null
df_clean = df.dropna()

# Drop rows where all columns are null
df_clean = df.dropna(how="all")

# Drop rows where specific columns are null
df_clean = df.dropna(subset=["customer_id", "amount"])
Der how Parameter steuert das Verhalten: "any" Legt Zeilen mit mindestens einer Null (Standardeinstellung) ab, während "all" Zeilen nur dann abgelegt werden, wenn alle angegebenen Spalten null sind.
Füllen Sie Nullwerte mit Standardwerten auf
Die fillna() Methode ersetzt NULL-Werte durch die angegebenen Standardwerte:
# Fill null values with a single value (applies only to columns whose data type matches)
df_filled = df.fillna(0)

# Fill specific columns with different values
df_filled = df.fillna({
    "amount": 0,
    "status": "Unknown",
    "quantity": 1
})
Verwenden Sie in SQL die COALESCE Funktion, um Standardwerte bereitzustellen:
SELECT
    customer_id,
    COALESCE(amount, 0) AS amount,
    COALESCE(status, 'Unknown') AS status
FROM sales.transactions;
Auswählen der richtigen Strategie
Die entsprechende Nullbehandlungsstrategie hängt vom Datenkontext ab:
| Scenario | Empfohlene Vorgehensweise |
|---|---|
| Nullwerte in erforderlichen Feldern wie Identifikatoren | Zeilen entfernen |
| Nullen in numerischen Feldern für die Aggregation | Auffüllen mit Null oder Durchschnitt |
| Nullen in optionalen kategorisierten Feldern | Ausfüllen mit Platzhaltern wie "Unbekannt" |
| Nullwerte, die die Analyse verzerren könnten | Überspringen oder Ausfüllen basierend auf Fachwissen |
Tipp
Dokumentieren Sie Ihre Nullbehandlungsentscheidungen. Zukünftige Analysten müssen verstehen, warum bestimmte Werte ersetzt oder entfernt wurden, um Abfrageergebnisse korrekt zu interpretieren.
Wenn Sie wissen, wie Sie diese Probleme mit der Datenqualität identifizieren und beheben können, bereiten Sie darauf vor, zuverlässigere Datenpipelines zu erstellen. Mit sauberen Daten erzeugen Ihre nachgelagerten Transformationen und Analysen vertrauenswürdige Ergebnisse.