Transformieren von Daten mit Verknüpfungen und Festlegen von Operatoren
Datenerstellungsworkflows erfordern häufig das Kombinieren von Informationen aus mehreren Datasets. Verknüpfungen kombinieren Tabellen horizontal, indem Zeilen in verknüpften Spalten übereinstimmen, während festgelegte Operatoren Tabellen vertikal kombinieren, indem Zeilen angefügt, überschneiden oder ausschließen. Wenn Sie wissen, wann sie jeden Ansatz verwenden, können Sie effiziente Transformationspipelines erstellen.
In dieser Lektion erfahren Sie, wie Sie Tabellen basierend auf Beziehungen verknüpfen und Satzoperatoren anwenden, um Datasets mit übereinstimmenden Schemas zu kombinieren.
Kombinieren von Tabellen mit Verknüpfungen
Verknüpft Zeilen aus zwei Tabellen basierend auf einer bezogenen Spalte. Der Verknüpfungstyp bestimmt, welche Zeilen im Ergebnis angezeigt werden und wie nicht übereinstimmende Zeilen behandelt werden.
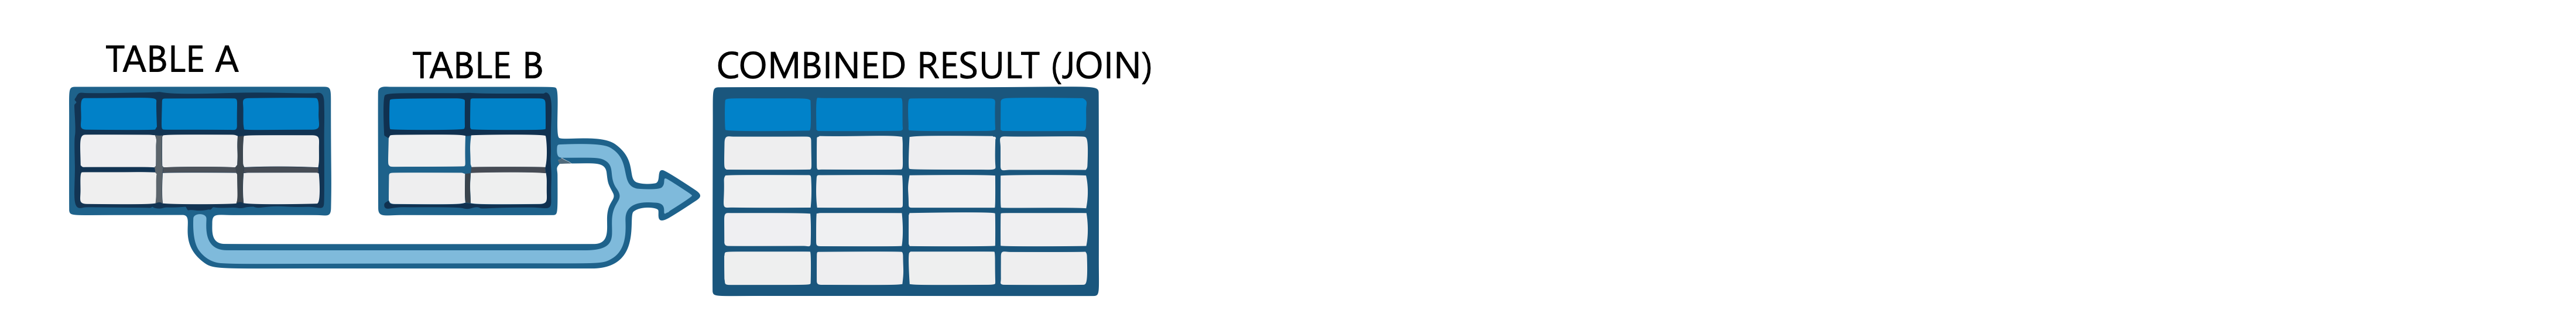
Verstehen von Verknüpfungstypen
Jeder Verknüpfungstyp dient einem bestimmten Zweck bei der Datentransformation:
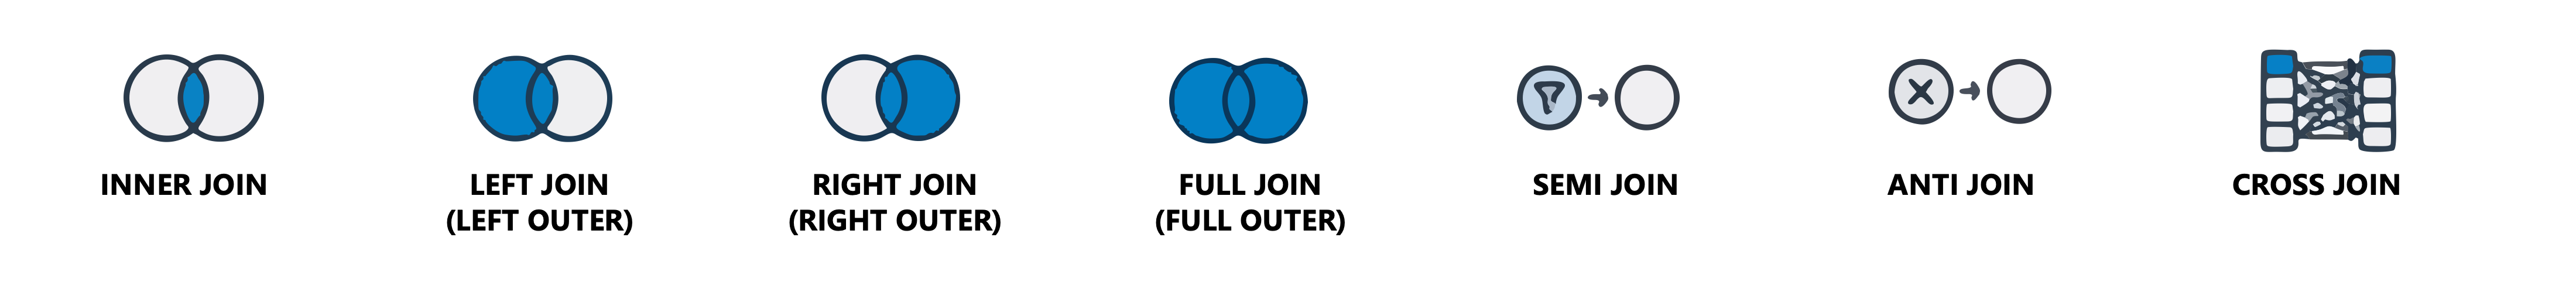
| Join-Typ | Description | Anwendungsfall |
|---|---|---|
INNER |
Gibt nur übereinstimmende Zeilen aus beiden Tabellen zurück. | Verknüpfen von Bestellungen mit gültigen Kunden |
LEFT |
Gibt alle linken Tabellenzeilen zurück; fügt NULLs für die rechte Tabelle hinzu, wenn keine Übereinstimmung vorliegt | Alle Kunden einschließen, auch ohne Bestellungen |
RIGHT |
Gibt alle rechten Tabellenzeilen zurück; fügt NULLs für die linke Tabelle hinzu, wenn keine Übereinstimmung vorliegt. | Einschließen aller Abteilungen, auch ohne Mitarbeiter |
FULL |
Gibt alle Zeilen aus beiden Tabellen zurück; fügt NULLs für Nicht-Übereinstimmungen hinzu | Kombinieren von Datasets zum Auffinden von Lücken auf beiden Seiten |
SEMI |
Gibt linke Tabellenzeilen zurück, die Übereinstimmungen in der rechten Tabelle aufweisen | Filtern von Kunden, die Bestellungen getätigt haben |
ANTI |
Gibt linke Tabellenzeilen zurück, die in der rechten Tabelle keine Übereinstimmung aufweisen | Suchen von Kunden, die nie Bestellungen getätigt haben |
CROSS |
Gibt das kartesische Produkt aller Zeilen zurück. | Generieren aller möglichen Kombinationen |
Verknüpfen von Tabellen mit SQL
Die JOIN-Klausel kombiniert Tabellen basierend auf einer Bedingung, die mit ON oder USING. In den folgenden Beispielen werden Mitarbeiter- und Abteilungstabellen verwendet:
CREATE TEMP VIEW employee(id, name, deptno) AS
    VALUES (105, 'Chloe', 5),
           (103, 'Paul',  3),
           (101, 'John',  1),
           (102, 'Lisa',  2),
           (104, 'Evan',  4),
           (106, 'Amy',   6);

CREATE TEMP VIEW department(deptno, deptname) AS
    VALUES (3, 'Engineering'),
           (2, 'Sales'),
           (1, 'Marketing');
Um Mitarbeiter an ihre Abteilungen abzugleichen, verwenden Sie eine innere Verknüpfung:
-- Inner join: only employees with matching departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
INNER JOIN department d ON e.deptno = d.deptno;
Eine innere Verknüpfung gibt nur drei Zeilen zurück– Mitarbeiter, deren Abteilungsnummern in der Abteilungstabelle vorhanden sind. Mitarbeiter in Abteilungen 4, 5 und 6 werden nicht angezeigt, da diese Abteilungen nicht in der Abteilungstabelle enthalten sind.
Wenn Sie alle Mitarbeiter unabhängig von Abteilungszuordnungen einschließen müssen, verwenden Sie eine Left Join:
-- Left join: all employees, NULL for missing departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
LEFT JOIN department d ON e.deptno = d.deptno;
Dies gibt alle sechs Mitarbeiter zurück. Diejenigen ohne übereinstimmende Abteilungen zeigen NULL in der deptname Spalte an.
Verknüpfen von DataFrames mit PySpark
Die PySpark-Methode join() bietet die gleiche Funktionalität. Der how Parameter gibt den Verknüpfungstyp an:
df_employee = spark.table("employee")
df_department = spark.table("department")

# Inner join
df_inner = df_employee.join(
    df_department,
    on=df_employee.deptno == df_department.deptno,
    how="inner"
)
display(df_inner)
Ändern Sie für linke, rechte oder vollständige äußere Verknüpfungen den how-Parameter:
# Left join: keep all employees
df_left = df_employee.join(
    df_department,
    on="deptno",
    how="left"
)

# Full outer join: keep all rows from both tables
df_full = df_employee.join(
    df_department,
    on="deptno",
    how="full"
)
Wenn die Verknüpfungsspalte in beiden DataFrames denselben Namen hat, übergeben Sie den Spaltennamen als Zeichenfolge. Bei diesem Ansatz werden doppelte Spalten im Ergebnis vermieden.
Daten mit Semi- und Anti-Joins filtern
Semi- und Anti-Joins filtern Daten basierend auf dem Vorhandensein in einer anderen Tabelle. Eine Semi-Verknüpfung gibt Zeilen aus der linken Tabelle zurück, die Übereinstimmungen aufweisen, ohne Spalten aus der rechten Tabelle einzuschließen:
-- Find employees who belong to listed departments
SELECT *
FROM employee
LEFT SEMI JOIN department ON employee.deptno = department.deptno;
Eine Anti-Verknüpfung gibt das Gegenteil zurück – Zeilen ohne Übereinstimmungen:
-- Find employees in departments not listed
SELECT *
FROM employee
LEFT ANTI JOIN department ON employee.deptno = department.deptno;
Verwenden Sie how="semi" im PySpark oder how="anti":
# Employees with matching departments
df_semi = df_employee.join(df_department, on="deptno", how="semi")

# Employees without matching departments
df_anti = df_employee.join(df_department, on="deptno", how="anti")
Kombinieren von Zeilen mit Setoperatoren
Mengenoperatoren arbeiten vertikal, indem sie Zeilen aus Abfragen mit derselben Spaltenstruktur kombinieren. Im Gegensatz zu Verknüpfungen basieren Set-Operatoren nicht auf Bedingungen – sie stapeln oder vergleichen ganze Ergebnismengen.
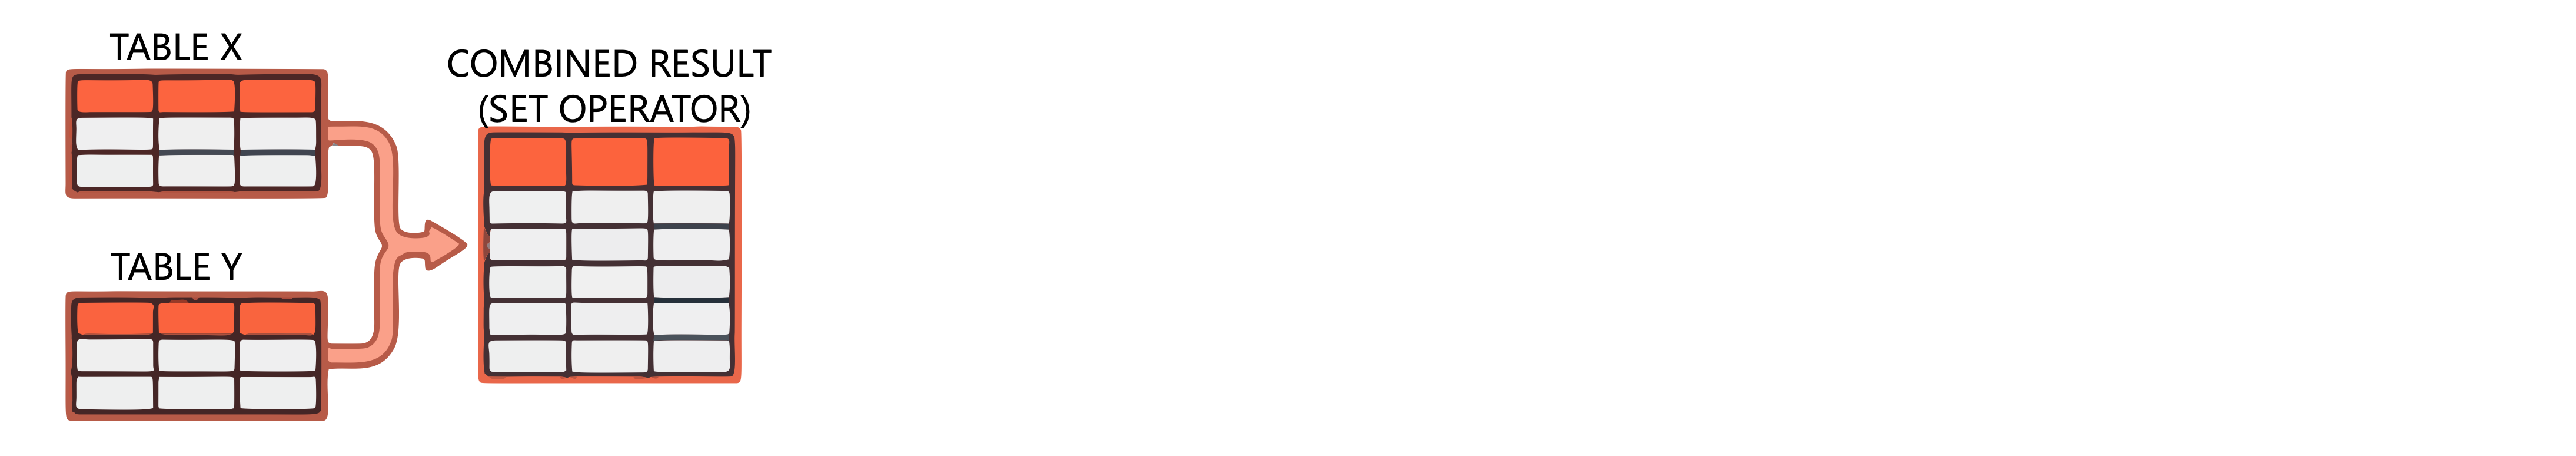
Grundlegendes zu Satzoperatoren
Azure Databricks unterstützt drei Satzoperatoren:
| Bediener | Description | Verhalten |
|---|---|---|
UNION |
Kombiniert Zeilen aus beiden Abfragen | Entfernt Duplikate standardmäßig; verwenden ALL , um sie beizubehalten |
INTERSECT |
Gibt Zeilen zurück, die in beiden Abfragen vorhanden sind. | Es werden nur übereinstimmende Zeilen angezeigt. |
EXCEPT |
Gibt Zeilen aus der ersten Abfrage zurück, die nicht in der zweiten Abfrage enthalten sind. | Entfernt Standardmäßig Duplikate. |
Beide Abfragen müssen dieselbe Anzahl von Spalten mit kompatiblen Datentypen aufweisen.
Zusammenführen von Datasets mit UNION
UNION fügt Zeilen von einer Abfrage an eine andere an. Standardmäßig werden Duplikate entfernt:
-- Combine active and archived customers (no duplicates)
SELECT customer_id, name, email FROM active_customers
UNION
SELECT customer_id, name, email FROM archived_customers;
Verwenden Sie Folgendes UNION ALL, um alle Zeilen einschließlich Duplikaten beizubehalten:
-- Combine all rows, keeping duplicates
SELECT customer_id, name, email FROM active_customers
UNION ALL
SELECT customer_id, name, email FROM archived_customers;
Verwenden Sie diese Funktion UNION ALL , wenn Sie wissen, dass es keine Duplikate gibt oder wenn Duplikate sinnvoll sind. Es funktioniert besser, da der Deduplizierungsschritt übersprungen wird.
Verwenden Sie union() in PySpark zum Kombinieren von DataFrames. Beachten Sie, dass sich das Verhalten von PySpark union() wie UNION ALL verhält—es behält Duplikate bei.
df_active = spark.table("active_customers")
df_archived = spark.table("archived_customers")

# Combine both tables (keeps duplicates)
df_combined = df_active.union(df_archived)

# Remove duplicates if needed
df_distinct = df_active.union(df_archived).distinct()
Finden Sie gemeinsame Zeilen mit INTERSECT
INTERSECT gibt nur Zeilen zurück, die in beiden Abfragen angezeigt werden. Dadurch können überlappende Daten identifiziert werden:
-- Find customers in both active and archived tables
SELECT customer_id FROM active_customers
INTERSECT
SELECT customer_id FROM archived_customers;
Diese Abfrage identifiziert Kunden, die irgendwie in beiden Tabellen angezeigt werden – nützlich für Datenqualitätsprüfungen oder die Identifizierung von Datensätzen, die eine Abstimmung benötigen.
Zeilen mit AUSNAHME ausschließen
EXCEPT gibt Zeilen aus der ersten Abfrage zurück, die in der zweiten nicht vorhanden sind. Dadurch können Lücken oder eindeutige Datensätze identifiziert werden:
-- Find active customers not in the archived table
SELECT customer_id FROM active_customers
EXCEPT
SELECT customer_id FROM archived_customers;
Sie können auch MINUS als Synonym für EXCEPT:
-- Same result using MINUS syntax
SELECT customer_id FROM active_customers
MINUS
SELECT customer_id FROM archived_customers;
Wie UNION entfernen sowohl INTERSECT als auch EXCEPT standardmäßig Duplikate. Fügen Sie ALL hinzu, um Duplikate bei Bedarf beizubehalten.
Tipp
Denken Sie beim Verketten von Satzvorgängen daran, dass INTERSECT eine höhere Priorität hat als UNION und EXCEPT. Verwenden Sie Klammern, um die Auswertungsreihenfolge zu steuern.
Auswählen zwischen Verknüpfungen und Festlegen von Operatoren
Die Wahl zwischen Verknüpfungen und Festlegen von Operatoren hängt von Ihrem Transformationsziel ab. Verknüpfungen kombinieren Spalten aus verknüpften Tabellen horizontal, während festgelegte Operatoren Zeilen vertikal kombinieren.
Verwenden Sie Verknüpfungen , wenn Sie Folgendes benötigen:
- Anreichern von Datensätzen durch Hinzufügen von Spalten aus verknüpften Tabellen
- Abgleichen von Datensätzen basierend auf Schlüsselbeziehungen
- Filtern von Daten basierend auf dem Vorhandensein in einer anderen Tabelle (Semi-/Anti-Verknüpfungen)
Verwenden Sie festgelegte Operatoren , wenn Sie Folgendes benötigen:
- Anfügen von Datensätzen aus mehreren Quellen mit identischen Schemas
- Suchen allgemeiner Datensätze über Datasets hinweg
- Identifizieren von Datensätzen, die für ein Dataset eindeutig sind
Beide Ansätze bilden die Grundlage effektiver Datentransformationspipelines. In der nächsten Einheit erfahren Sie, wie Sie transformierte Daten in Zieltabellen im Unity-Katalog laden.