Laden von Daten mit Zusammenführung, Einfügen und Hinzufügen
Nachdem Sie Daten transformiert und bereinigt haben, besteht der letzte Schritt in Ihrer Pipeline darin, die Daten in Zieltabellen zu laden. Azure Databricks bietet drei Kernladestrategien: Anfügen, Überschreiben und Zusammenführen. Jede Strategie dient verschiedenen Anwendungsfällen und die Auswahl des richtigen, hängt davon ab, wie sich Ihre Quelldaten auf vorhandene Datensätze beziehen.
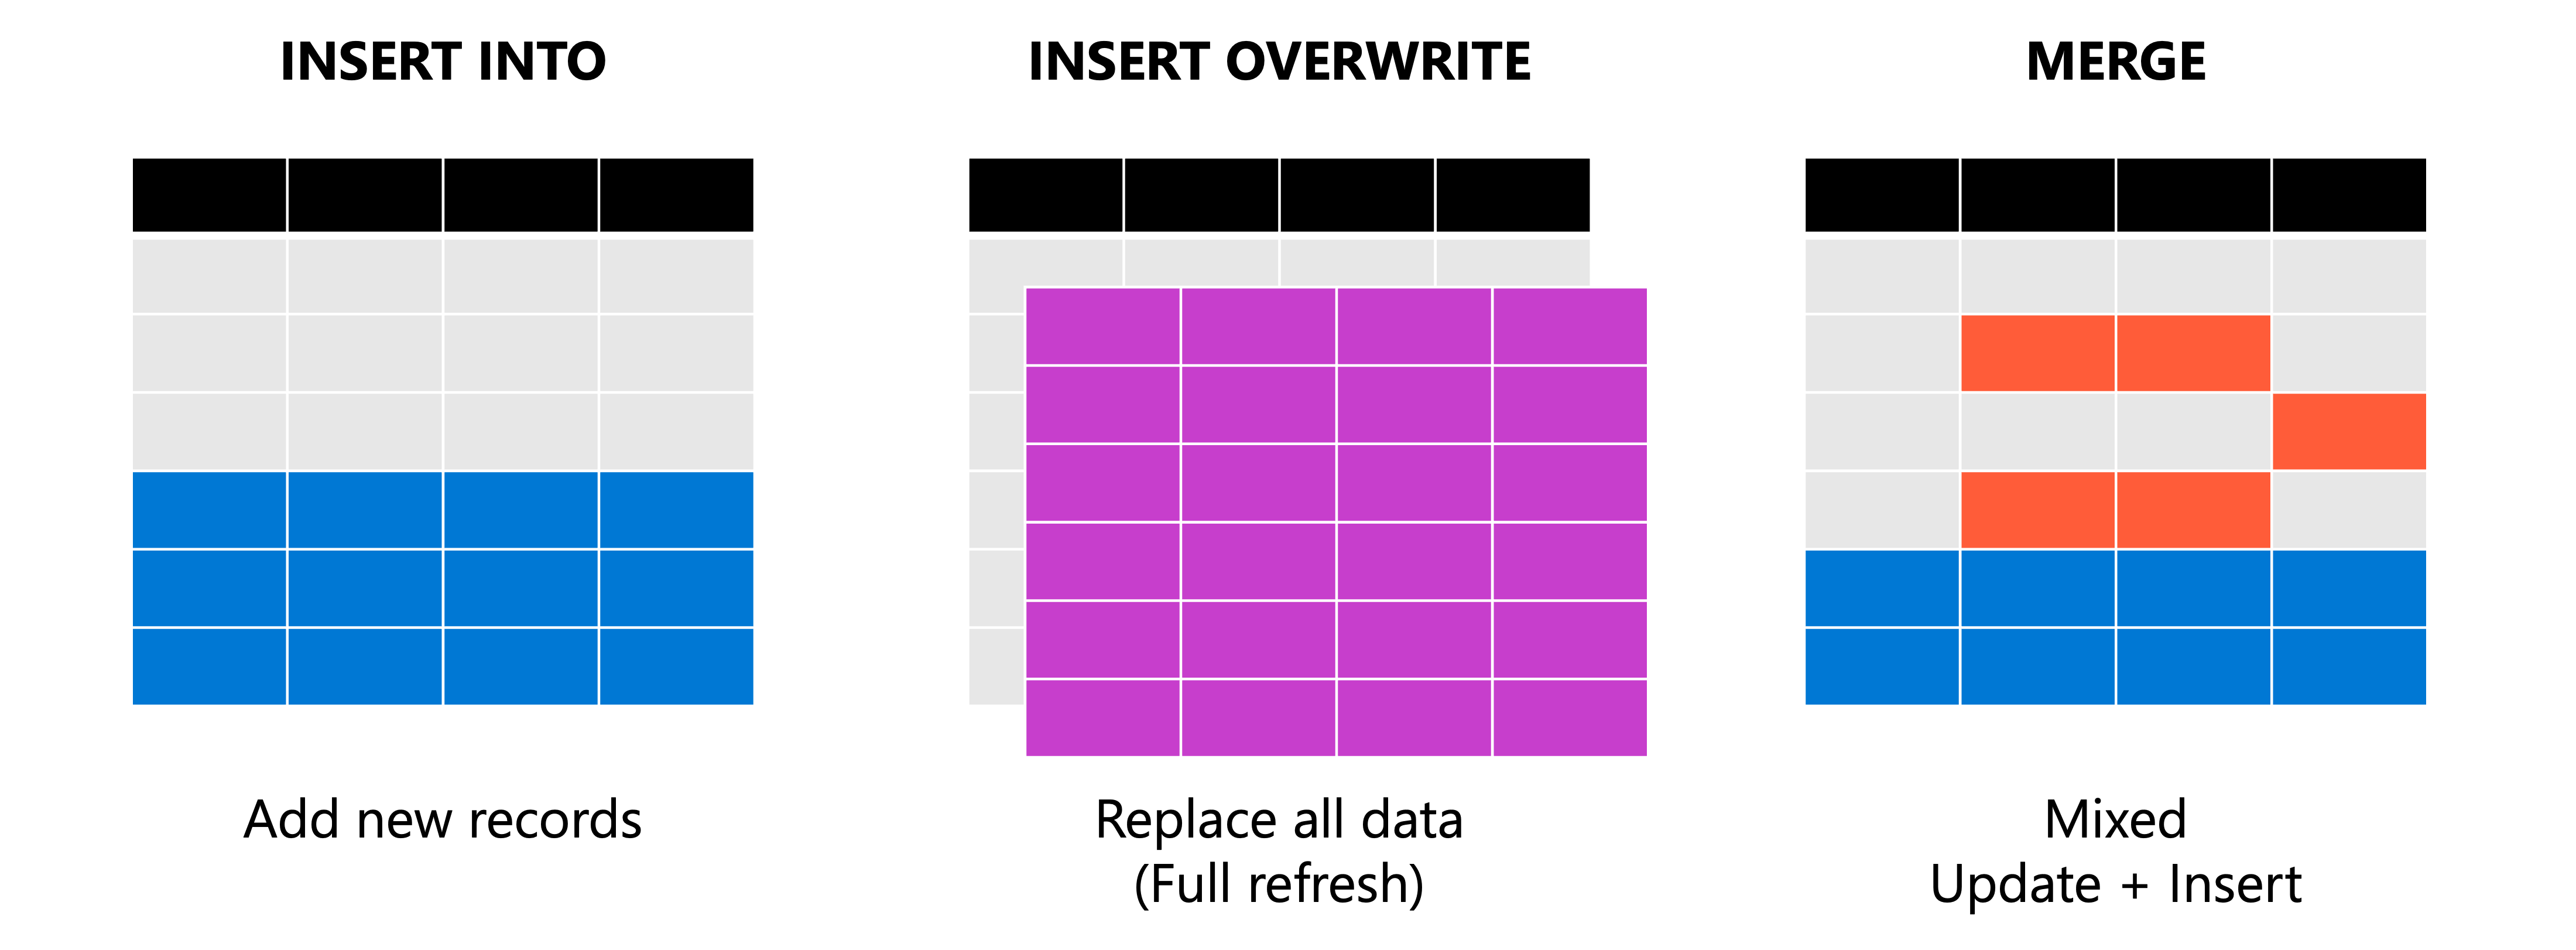
In dieser Lektion erfahren Sie, wie Sie neue Zeilen mit INSERT anfügen, Daten durch Überschreibvorgänge ersetzen und Änderungen mithilfe von MERGE für Upsert-Szenarien synchronisieren.
Anfügen von Daten mit INSERT INTO
Der einfachste Ladevorgang fügt einer vorhandenen Tabelle neue Zeilen hinzu, ohne die aktuellen Daten zu ändern. Verwenden Sie INSERT INTO, wenn Sie neue Datenbatches laden, die sich nicht mit vorhandenen Datensätzen überlappen , z. B. tägliche Transaktionsprotokolle, neue Ereignisdatenströme oder inkrementelle Datenextrakte.
INSERT INTO funktioniert sowohl mit SQL als auch mit PySpark. Die folgenden Beispiele zeigen, wie Zeilen zu einer Verkaufstabelle hinzugefügt werden.
-- Append new records using VALUES
INSERT INTO sales.transactions (transaction_id, amount, transaction_date)
VALUES
    ('TXN001', 150.00, '2026-01-15'),
    ('TXN002', 275.50, '2026-01-15');

-- Append from a staging table or query
INSERT INTO sales.transactions
SELECT * FROM staging.daily_transactions
WHERE transaction_date = current_date();
In PySpark fügen Sie Daten an, indem Sie einen DataFrame mit append Modus schreiben:
# Append DataFrame to existing table
df_new_transactions.write.mode("append").saveAsTable("sales.transactions")

# Or use insertInto for existing tables
df_new_transactions.write.insertInto("sales.transactions")
Tipp
Stellen Sie beim Anfügen von Daten sicher, dass die Quelldaten vor dem Laden dedupliziert werden. INSERT INTO sucht nicht nach Duplikaten. Wenn Sie denselben Batch zweimal laden, erhalten Sie doppelte Zeilen.
Daten durch INSERT OVERWRITE ersetzen
Manchmal müssen Sie vorhandene Daten ersetzen, anstatt sie hinzuzufügen. INSERT OVERWRITE schneidet die Zieltabelle oder Partition ab, bevor neue Zeilen eingefügt werden. Dieser Ansatz eignet sich gut für die Erneute Verarbeitung fehlgeschlagener Batches, das Aktualisieren von Nachschlagetabellen oder das Neuerstellen von Aggregationen.
-- Replace entire table contents
INSERT OVERWRITE sales.daily_summary
SELECT
    region,
    SUM(amount) as total_sales,
    COUNT(*) as transaction_count
FROM sales.transactions
WHERE transaction_date = current_date()
GROUP BY region;
Bei partitionierten Tabellen können Sie bestimmte Partitionen überschreiben, während andere intakt bleiben:
-- Replace only January 2026 partition
INSERT OVERWRITE sales.monthly_report
PARTITION (report_month = '2026-01')
SELECT region, product_category, SUM(amount) as revenue
FROM sales.transactions
WHERE transaction_date BETWEEN '2026-01-01' AND '2026-01-31'
GROUP BY region, product_category;
Delta Lake unterstützt auch selektive Überschreibungen mit der REPLACE WHERE Klausel, die Zeilen, die einer Bedingung entsprechen, vor dem Einfügen löscht:
-- Replace transactions for a specific date range
INSERT INTO sales.transactions
REPLACE WHERE transaction_date >= '2026-01-01' AND transaction_date <= '2026-01-07'
SELECT * FROM staging.corrected_transactions;
Standardmäßig muss jede von der Abfrage zurückgegebene Zeile mit dem REPLACE WHERE Prädikat übereinstimmen. Wenn eine Zeile außerhalb des Prädikats liegt, schlägt die Anweisung fehl und schreibt nichts.
Verwenden Sie in PySpark den Modus overwrite für den vollständigen Ersatz der Tabelle, und fügen Sie die Option replaceWhere hinzu, um nur die Zeilen zu ersetzen, die einer Bedingung entsprechen:
# Overwrite entire table
df_refreshed.write.mode("overwrite").saveAsTable("sales.daily_summary")

# Replace only the January 2026 rows
(df_january.write
    .mode("overwrite")
    .option("replaceWhere", "report_month = '2026-01'")
    .saveAsTable("sales.monthly_report"))
Von Bedeutung
Die kombinierte INSERT OVERWRITE PARTITION SQL-Syntax partitionOverwriteMode=dynamic ist nur auf klassisches Compute beschränkt – sie funktioniert nicht auf Databricks SQL Warehouses oder serverlosen Compute. Python- und Scala DataFrame-Schreibvorgänge mit partitionOverwriteMode=dynamic arbeiten an allen Computetypen. Bei neuen Pipelines empfiehlt Databricks REPLACE USING anstelle des Überschreibens von Partitionen, da das Überschreiben von Partitionen veraltete Daten verwenden kann, wenn die Partitionierung sich ändert.
Dynamisches Ersetzen von Daten mit REPLACE USING
REPLACE USING ist der empfohlene Ansatz für dynamische Datenüberschreibungen. Es funktioniert für alle Computetypen – einschließlich Databricks SQL Warehouses und serverloser Compute – und erfordert keine Spark-Sitzungskonfiguration. Im Gegensatz dazu partitionOverwriteModeREPLACE USING werden partitionierte Tabellen, nicht partitionierte Tabellen und Tabellen mit flüssigem Clustering unterstützt.
-- Replace only the partitions touched by the incoming data
INSERT INTO sales.monthly_report
  REPLACE USING (report_month)
  SELECT region, product_category, SUM(amount) AS revenue, report_month
  FROM staging.corrected_transactions
  GROUP BY region, product_category, report_month;
Die REPLACE USING-Klausel löscht atomar die Zeilen in sales.monthly_report, die mit den eingehenden Zeilen in report_month übereinstimmen, und fügt dann die neuen Zeilen ein. Zeilen, die nicht den angegebenen Spalten entsprechen, bleiben unverändert. In Databricks Runtime 16.3–17.1 müssen die Spalten USING der vollständige Satz von Partitionsspalten (Legacyverhalten) der Tabelle sein. In Databricks Runtime 17.2 und höher werden alle Spalten eines beliebigen Tabellentyps unterstützt, einschließlich nicht partitionierten Tabellen und Tabellen mit flüssigem Clustering. Die SQL-Klausel REPLACE USING erfordert Databricks Runtime 16.3 oder höher, und die Python- und Scala-Option replaceUsing erfordert Databricks Runtime 18.2 oder höher. Da REPLACE USING normale Gleichheit verwendet wird, stimmen Zeilen mit NULL Werten in den USING Spalten nicht überein und werden nicht aus der Zieltabelle entfernt.
Wenn Sie flexiblere Übereinstimmungen benötigen, z. B. das Ersetzen von Zeilen basierend auf einer benutzerdefinierten Bedingung oder das Behandeln von NULL-Werten als gleich, verwenden Sie REPLACE ON stattdessen Folgendes:
-- Replace rows matching a user-defined condition across source and target
INSERT INTO sales.transactions AS target
  REPLACE ON (target.transaction_id = source.transaction_id)
  (SELECT * FROM staging.corrected_transactions) AS source;
REPLACE ONerfordert Databricks Runtime 17.1 und höher für SQL und Databricks Runtime 18.2 und höher für die Python- und Scala-Option replaceOn. Verwenden Sie REPLACE WHERE (weiter oben behandelt), wenn Sie bedingungsbasierten Ersatz ohne Quelltabellenverweis benötigen.
Zusammenführen von Daten für Upsert-Vorgänge
Echtwelt-Datenpipelines müssen vorhandene Datensätze häufig aktualisieren, während sie gleichzeitig neue einfügen. Die MERGE-Anweisung behandelt dieses Muster, das häufig als "upsert" bezeichnet wird, indem Quellzeilen Zielzeilen zugeordnet und verschiedene Aktionen angewendet werden, je nachdem, ob es eine Übereinstimmung gibt.
MERGE ist für langsam ändernde Dimensionen, die Synchronisierung von Daten aus Quellsystemen und die Verarbeitung von CDC (Change Data Capture)-Feeds unerlässlich.
MERGE INTO customers AS target
USING customer_updates AS source
ON target.customer_id = source.customer_id
WHEN MATCHED THEN
    UPDATE SET
        target.email = source.email,
        target.phone = source.phone,
        target.last_updated = current_timestamp()
WHEN NOT MATCHED THEN
    INSERT (customer_id, name, email, phone, created_date, last_updated)
    VALUES (source.customer_id, source.name, source.email, source.phone,
            current_timestamp(), current_timestamp());
Diese Abfrage aktualisiert die E-Mail-Adressen und Telefonnummern vorhandener Kunden und fügt gleichzeitig völlig neue Kunden hinzu. Die ON-Klausel definiert den übereinstimmenden Schlüssel – in der Regel einen Primärschlüssel oder einen Geschäftsbezeichner.
Zusammenführen mit bedingter Logik
Fügen Sie BEDINGUNGEN zu WHEN-Klauseln hinzu, um komplexere Szenarien zu behandeln. Sie können beispielsweise nur Datensätze aktualisieren, die tatsächlich geändert wurden:
MERGE INTO products AS target
USING product_feed AS source
ON target.sku = source.sku
WHEN MATCHED AND source.price <> target.price THEN
    UPDATE SET target.price = source.price, target.updated_at = current_timestamp()
WHEN MATCHED AND source.discontinued = true THEN
    DELETE
WHEN NOT MATCHED THEN
    INSERT *;
Die INSERT * Syntax fügt alle Spalten aus der Quelle ein, wenn sie mit dem Zielschema übereinstimmen.
Mit PySpark zusammenführen
Verwenden Sie für die programmgesteuerte Steuerung die Delta Lake Python-API:
from delta.tables import DeltaTable

target_table = DeltaTable.forName(spark, "customers")

target_table.alias("target").merge(
    source_df.alias("source"),
    "target.customer_id = source.customer_id"
).whenMatchedUpdate(set={
    "email": "source.email",
    "phone": "source.phone",
    "last_updated": "current_timestamp()"
}).whenNotMatchedInsert(values={
    "customer_id": "source.customer_id",
    "name": "source.name",
    "email": "source.email",
    "phone": "source.phone",
    "created_date": "current_timestamp()",
    "last_updated": "current_timestamp()"
}).execute()
Verwenden Sie für einfachere Fälle, in denen Quell- und Zielschemas übereinstimmen, die Komfortmethoden:
target_table.alias("target").merge(
    source_df.alias("source"),
    "target.customer_id = source.customer_id"
).whenMatchedUpdateAll(
).whenNotMatchedInsertAll(
).execute()
Auswählen der richtigen Ladestrategie
Die Auswahl des Ladevorgangs hängt von der Beziehung zwischen Quell- und Zieldaten ab:
| Scenario | Operation | Wann verwenden |
|---|---|---|
| Nur neue Datensätze | INSERT INTO / anhängen | Tägliche Protokolle, Ereignisdatenströme, inkrementelle Extrakte |
| Vollständige Aktualisierung | EINFÜGEN ÜBERSCHREIBEN | Nachschlagetabellen, Aggregationen, fehlerhafte Batchverarbeitung |
| Gemischte Aktualisierungen und Einfügungen | MERGE | CDC-Feeds, Dimensionstabellen, Datensynchronisierung |
| Selektive Ersetzung durch Prädikat | WHERE ERSETZEN | Korrigieren bestimmter Datumsbereiche oder logischer Bedingungen |
| Dynamische Datenüberschreibung (alle Computetypen) | ERSETZEN DURCH | Empfohlen für Überschreibungen auf Zeilenebene für jeden Tabellentyp (partitioniert, nicht partitioniert, flüssiges Clustering) |
| Ersetzen benutzerdefinierter Bedingungszeilen | ERSETZEN NACH | Überschreibungen auf Zeilenebene mit NULL-sicheren oder komplexen Abgleichsbedingungen |
Von Bedeutung
MERGE-Vorgänge schlagen fehl, wenn mehrere Quellzeilen mit derselben Zielzeile übereinstimmen, da unklar ist, welche Quellzeile auf die Zielzeile anzuwenden ist. Aktionen ohne Bedingung DELETE sind die Ausnahme. Deduplizieren Sie die Quelldaten vor dem Zusammenführen.
Das Verständnis dieser Lademuster bereitet Sie darauf vor, zuverlässige Datenpipelines zu erstellen, die die Datenintegrität beibehalten und gleichzeitig neue und geänderte Datensätze effizient verarbeiten.