Vor der Cloud
- 17 Minuten
Nachdem wir jetzt das Cloud Computing definiert haben, betrachten wir einige Beispiele, wie das Computing in verschiedenen Bereichen wie Business Computing, Scientific Computing und Personal Computing vor dem Aufkommen von Cloud Computing eingesetzt wurde.
Business Computing: Das Business Computing umfasst häufig den Einsatz von Managementinformationssystemen, die die Logistik und den Betrieb, Enterprise Resource Planning (ERP), Customer Relationship Management (CRM), Produktivität im Büro und Business Intelligence (BI) steuern. Diese Tools ermöglichten optimierte Prozesse, die zu einer gesteigerten Produktivität und Kostensenkung in einer Vielzahl von Unternehmen führten.
So ermöglicht die CRM-Software z. B. Unternehmen das Erfassen, Speichern, Verwalten und Interpretieren einer Vielzahl von Daten über ehemalige, aktuelle und potenzielle zukünftige Kunden. Die CRM-Software bietet eine integrierte Ansicht (in Echtzeit oder nahezu in Echtzeit) aller organisatorischen Interaktionen mit Kunden. Für ein produzierendes Unternehmen könnte die CRM-Software von einem Vertriebsteam verwendet werden, um Meetings, Aufgaben und Nachverfolgungen mit Kunden zu planen. Ein Marketingteam könnte Kunden gezielt mit Kampagnen ansprechen, die auf bestimmten Mustern basieren. Abrechnungsteams können Angebote und Rechnungen nachverfolgen. Als solches handelt es sich um ein zentrales Repository zur Speicherung dieser Informationen. Um diese Funktionalität zu ermöglichen, werden von den Unternehmen und Vertriebsteams eine Vielzahl von Hard- und Softwaretechnologien eingesetzt, um die Daten zu erfassen, die mit verschiedenen Datenbank- und Analysesystemen gespeichert und analysiert werden müssen.
Scientific Computing: Scientific Computing verwendet mathematische Modelle und Analyseverfahren, die auf Computern implementiert werden, um wissenschaftliche Probleme zu lösen. Ein beliebtes Beispiel ist die Computersimulation physikalischer Phänomene – z. B. mithilfe von Klimamodellen zur Wettervorhersage. Dieser Bereich hat die traditionellen theoretischen und Laborversuchsmethoden gespalten, indem er es Wissenschaftlern und Ingenieuren ermöglicht hat, bekannte Ereignisse zu rekonstruieren oder zukünftige Situationen vorherzusagen, indem Programme zur Simulation und Untersuchung verschiedener Systeme unter verschiedenen Umständen entwickelt wurden. Derartige Simulationen erfordern in der Regel eine sehr große Anzahl von Berechnungen, die oft auf teuren Supercomputern oder verteilten Computingplattformen ausgeführt werden.
Personal Computing: Beim Personal Computing führt ein Benutzer verschiedene Anwendungen auf einem universellen Personalcomputer (PC) aus. Beispiele für solche Anwendungen sind Textverarbeitungssysteme und andere Software für die Produktivität im Büro, Kommunikationsanwendungen wie E-Mail-Clients und Unterhaltungssoftware wie Videospiele und Media Player. Ein PC-Benutzer besitzt, installiert und wartet in der Regel die Soft- und Hardware, die zur Durchführung solcher Aufgaben verwendet wird.
Behandlung der Skalierung
Eine der langjährigen Herausforderungen in der IT ist die bedarfsgerechte Skalierung von Computeressourcen, um z. B. die Kapazität einer Website zu erhöhen, damit den Anforderungen eines wachsenden Kundenstamms Rechnung getragen wird, oder um die „stoßweise“ auftretende Auslastung während der Hauptgeschäftszeiten oder bei besonderen Veranstaltungen zu bewältigen, die ein großes Publikum ansprechen.
Der zunehmende Umfang beim Computing ist ein kontinuierlicher Prozess, sei es bei der Erhöhung der Anzahl der Kunden und Ereignisse, die in CRM erfasst, überwacht und analysiert werden müssen, sei es bei der Erhöhung der Präzision numerischer Simulationen in der wissenschaftlichen Datenverarbeitung oder des Realismus in Videospielanwendungen. Darüber hinaus wurde die Nachfrage nach einem größeren Umfang durch die zunehmende Einführung von Technologien in verschiedenen Bereichen oder die Expansion von Unternehmen und Märkten sowie durch die kontinuierliche Zunahme der Zahl der Benutzer und ihrer Anforderungen verursacht. Unternehmen müssen die zunehmende Größe berücksichtigen, wenn sie die Bereitstellung ihrer Lösungen planen und budgetieren.
Unternehmen planen ihre IT-Infrastruktur typischerweise in einem Prozess namens Kapazitätsplanung. Im Rahmen der Kapazitätsplanung wird die Zunahme bei der Nutzung verschiedener IT-Dienste gemessen und als Maßstab für die zukünftige Expansion herangezogen. Unternehmen müssen im Voraus planen, um neuere und bessere Server, Speichergeräte und Netzwerkgeräte zu beschaffen, einzurichten und zu warten. Manchmal sind Unternehmen durch Software eingeschränkt, da sie möglicherweise eine begrenzte Anzahl von Lizenzen erworben haben und weitere benötigen, um die Infrastruktur für eine größere Anzahl von Benutzern zu erweitern.
Die grundlegendste Form der Skalierung ist die sogenannte vertikale Skalierung, bei der alte Systeme durch neuere, leistungsfähigere Systeme mit schnelleren CPUs sowie mehr Arbeitsspeicher und Speicherplatz ersetzt werden. In vielen Fällen besteht die vertikale Skalierung aus der Aktualisierung oder dem Austausch von Servern und der Erhöhung der Kapazität von Speicherarrays. Dieser Prozess kann Monate in Anspruch nehmen, um geplant und ausgeführt zu werden, und erfordert häufig kurze Ausfallzeiten, wenn Upgrades eingeführt werden.
Die Skalierung kann auch horizontal erfolgen, indem die Anzahl der dem System zugewiesenen Ressourcen erhöht oder verringert wird. Ein Beispiel dafür ist das High Performance Computing, bei dem zusätzliche Server und Speicherkapazitäten zu bestehenden Clustern hinzugefügt werden können, wodurch die Anzahl der Berechnungen erhöht wird, die pro Sekunde durchgeführt werden können. Ein weiteres Beispiel sind Webfarmen (Servergruppen, die Websites und Webanwendungen hosten), in denen zusätzliche Server online gestellt werden können, um den erhöhten Datenverkehr zu bewältigen. Wie die vertikale Skalierung kann auch dieser Prozess Monate für die Planung und Ausführung in Anspruch nehmen, wobei auch Ausfallzeiten möglich sind.
Da Unternehmen ihre IT-Ausrüstung besaßen und instand hielten, während die Kosten für die Adressierung der Skalierung weiter stiegen, ermittelten die Unternehmen andere Methoden zur Kostensenkung. Große Unternehmen haben die Computinganforderungen verschiedener Abteilungen in einem einzelnen großen Rechenzentrum zusammengefasst, wodurch sie Immobilien, Stromversorgung, Kühlung und Netzwerke konsolidierten, um Kosten zu senken. Auf der anderen Seite könnten kleine und mittlere Unternehmen Immobilien, Netzwerk, Stromversorgung, Kühlung und physische Sicherheit mieten, indem sie ihre IT-Ausrüstung in einem gemeinsam genutzten Rechenzentrum platzieren. Dies wird typischerweise als Zusammenlegungsdienst bezeichnet, der von kleinen bis mittleren Unternehmen übernommen wurde, die intern keine eigenen Rechenzentren errichten wollten. Zusammenlegungsdienste werden weiterhin in verschiedenen Bereichen als kosteneffizienter Ansatz zur Senkung der Betriebskosten eingesetzt.
Das Business Computing hat sich mit der vertikalen und horizontalen Skalierung sowie der Konsolidierung von IT-Ressourcen in Rechenzentren und Zusammenlegungen befasst. Beim Scientific Computing wurden parallele und verteilte Systeme eingesetzt, um die Größe der Probleme und die Genauigkeit ihrer numerischen Simulationen zentral hochzuskalieren. Eine Definition von Parallelverarbeitung ist die Verwendung mehrerer homogener Computer, die den Status teilen und als einzelner großer Computer fungieren, um umfangreiche oder äußerst präzise Berechnungen durchzuführen. Verteiltes Computing ist die Verwendung mehrerer autonomer Computersysteme, die über ein Netzwerk verbunden sind, um ein großes Problem in Teilaufgaben zu unterteilen, die gleichzeitig ausgeführt werden und über Nachrichten im Netzwerk kommunizieren. Die wissenschaftliche Gemeinschaft hat in diesen Bereichen weiterhin Innovationen vorangetrieben, die sich mit der Skalierung befassen. Beim Personal Computing hat sich die Skalierbarkeit durch die gestiegenen Anforderungen von umfangreicheren Inhalten und speicherintensiven Anwendungen ausgewirkt. Benutzer ersetzen ihre PCs durch neuere, schnellere Modelle oder führen ein Upgrade für existierende Modelle durch, um diesen Anforderungen gerecht zu werden.
Zunahme der Internetdienste
In den späten 90er Jahren nahm die Akzeptanz dieser Computeranwendungen und -plattformen in allen Bereichen stetig zu. Bald sollte die Software nicht nur funktional, sondern auch in der Lage sein, einen Wert und Erkenntnisse für geschäftliche und private Anforderungen zu schaffen. Diese Anwendungen wurden für die Zusammenarbeit verwendet. Sie wurden kombiniert und aufeinander abgestimmt, um untereinander Informationen zu übertragen. Die IT war nicht mehr nur eine Kostenstelle für ein Unternehmen, sondern eine Quelle für Innovation und Effizienz.
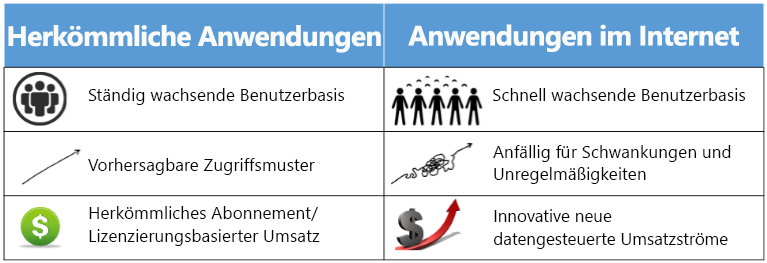
Abbildung 1.2: Vergleich von herkömmlichem und Internet Computing
Das 21. Jahrhundert war geprägt von einer explosionsartigen Zunahme des Volumens und der Kapazität der drahtlosen Kommunikation, des World Wide Web und des Internets. Diese Veränderungen haben zu einer netzwerk- und datengesteuerten Gesellschaft geführt, in der die Produktion, Verbreitung und der Zugriff auf digitalisierte Informationen vereinfacht wird. Das Internet hat einen globalen Marktplatz für mehr als 4 Milliarden Benutzer geschaffen. Dieser Anstieg der Daten und Verbindungen ist für Unternehmen von großem Wert. Daten schaffen auf unterschiedliche Weise einen Wert, unter anderem durch Experimentieren, Segmentieren von Populationen und Unterstützen der Entscheidungsfindung durch Automatisierung1. Durch die Nutzung digitaler Technologien sollten die zehn führenden Volkswirtschaften der Welt ihre Produktion zwischen 2015 und 2020 um mehr als eine Billion US-Dollar steigern.
Die steigende Anzahl von Verbindungen, die über das Internet ermöglicht werden, hat auch seinen Wert gesteigert. Forscher haben Hypothesen aufgestellt, dass der Wert eines Netzwerks superlinear in Abhängigkeit von der Anzahl der Benutzer variiert. Daher hat die Gewinnung und Bindung von Kunden im Internet eine Priorität, und dies erfolgt durch die Erstellung zuverlässiger und reaktionsschneller Dienste und die Durchführung von Änderungen auf der Grundlage beobachteter Datenmuster.
Einige Beispiele für Systeme im Internetbereich sind:
- Suchmaschinen, die große Datasets (bis zu Petabyte) durchforsten, speichern, indizieren und suchen. Google startete z. B. als riesiger Webindex, der alle paar Tage den Webdatenverkehr durchsuchte und analysierte und diese Indizes mit Schlüsselwörtern abglich. Heute werden die Indizes nahezu in Echtzeit aktualisiert und es ist eine der beliebtesten Möglichkeiten, auf Informationen im Internet zuzugreifen. Ihr Index umfasst Billionen von Seiten mit einer Größe von Tausenden Terabyte3.
- Soziale Netzwerke wie Facebook und LinkedIn, die es den Benutzern ermöglichen, persönliche und berufliche Beziehungen aufzubauen und Gemeinschaften auf der Grundlage ähnlicher Interessen zu bilden. Facebook hat z. B. inzwischen mehr als 2 Milliarden aktive Benutzer pro Monat.
- Onlineeinzelhändler wie Amazon führen einen Bestand von Millionen von Produkten und bedienen eine globale Benutzerbasis. Im Jahr 2017 erzielte der Onlineeinzelhandel von Amazon einen Nettoumsatz von 178 Milliarden Euro – 31 % mehr als im Vorjahr.
- Streaming-Multimediaanwendungen ermöglichen es Benutzern, Videos und andere Formen von komplexen Inhalten anzusehen und zu teilen. Ein solches Beispiel ist YouTube, das täglich bis zu 5 Milliarden Videos bereitstellt und jede Sekunde 300 Minuten an Videos hochlädt.
- Echtzeit-Kommunikationssysteme für Audio-, Video- und Textchats wie Skype, die mehr als 50 Milliarden Minuten an Anrufen pro Monat verzeichnen.
- Suiten für Produktivität und Zusammenarbeit, die Millionen von Dokumenten für viele gleichzeitige Benutzer bereitstellen und so beständige Updates in Echtzeit ermöglichen. Microsoft 365 bedient z. B. monatlich etwa 60 Millionen aktive Benutzer.
- CRM-Anwendungen von Anbietern wie SalesForce werden in über hunderttausend Organisationen eingesetzt. Große CRMs bieten jetzt intuitive Dashboards zur Statusverfolgung, Analysen zur Ermittlung der Kunden, die die höchsten Geschäfts- und Umsatzprognosen generieren, um das zukünftige Wachstum vorherzusagen.
- Data Mining- und Business Intelligence-Anwendungen, die die Nutzung anderer Dienste (wie die oben genannten) analysieren, um Ineffizienzen und Möglichkeiten der Monetarisierung zu finden.
Von diesen Systemen wird offensichtlich erwartet, dass sie mit einer hohen Anzahl von gleichzeitigen Benutzern zurechtkommen. Dies erfordert eine Infrastruktur, die in der Lage ist, große Mengen an Netzwerkdatenverkehr zu bewältigen, Daten zu generieren und sicher zu speichern, und das ohne nennenswerte Verzögerungen. Diese Dienste erzielen ihren Wert, indem sie einen konstanten und zuverlässigen Qualitätsstandard bieten. Sie bieten auch umfangreiche Benutzeroberflächen für mobile Geräte und Webbrowser, die eine einfache Bedienung ermöglichen, aber schwieriger zu erstellen und zu warten sind.
Wir fassen hier einige der Anforderungen an internetfähige Systeme zusammen:
- Allgegenwärtigkeit: Jederzeit von überall aus auf einer Vielzahl von Geräten verfügbar sein. Ein Verkäufer erwartet z. B., dass sein CRM-Dienst zeitnahe Updates auf einem mobilen Gerät bereitstellt, um Kundenbesuche kürzer, schneller und effektiver zu gestalten. Der Dienst sollte unter einer Vielzahl von Netzwerkverbindungen reibungslos funktionieren.
- Hochverfügbarkeit – Der Dienst muss „immer verfügbar“ sein. Betriebszeiten werden durch die Anzahl der Neunen angegeben. Drei Neunen oder 99,9 % bedeuten, dass ein Dienst neun Stunden im Jahr nicht verfügbar sein wird. Fünf Neunen (ca. 6 Minuten pro Jahr) sind ein typischer Schwellenwert für einen Hochverfügbarkeitsdienst. Schon eine Ausfallzeit von wenigen Minuten in Anwendungen für den Onlineeinzelhandel kann sich auf einen Umsatz von Millionen von US-Dollar auswirken.
- Geringe Wartezeit: Schnelle und zuverlässige Zugriffszeiten. Selbst geringfügig langsamere Ladezeiten haben gezeigt, dass sie die Nutzung der betroffenen Webseite deutlich verringern. Wenn z. B. die Latenzzeit für die Suche von 100 Millisekunden auf 400 Millisekunden erhöht wird, sinkt die Anzahl der Suchvorgänge pro Benutzer von 0,8 % auf 0,6 %, und die Änderung bleibt auch nach Wiederherstellung der Latenz auf das ursprüngliche Niveau erhalten.
- Skalierbarkeit: Die Fähigkeit, mit variablen Auslastungen aufgrund von Saisonalität und Dynamik umzugehen, die über lange und kurze Zeiträume starke Schwankungen beim Datenverkehr verursachen. An Tagen wie dem „Black Friday“ und „Cyber Monday“ erhalten Händler wie Amazon und Walmart ein Mehrfaches des Netzwerkdatenverkehrs als im Durchschnitt.
- Kosteneffizienz: Ein Dienst im Internet erfordert deutlich mehr Infrastruktur als eine herkömmliche Anwendung sowie eine bessere Verwaltung[4]. Eine Möglichkeit zur Kostenreduzierung besteht darin, die Verwaltung von Diensten zu vereinfachen und die Anzahl der Administratoren zu verringern, die einen Dienst verwalten. Kleinere Dienste können es sich leisten, ein niedriges Verhältnis von Dienst zu Administrator aufzuweisen (z. B. 2:1, wobei ein einzelner Administrator zwei Dienste verwalten muss). Um die Rentabilität zu erhalten, müssen Dienste wie Microsoft Bing jedoch ein hohes Verhältnis von Dienst zu Administrator aufweisen (z. B. 2500:1, wobei ein einzelner Administrator 2500 Dienste verwalten muss).
- Interoperabilität: Viele dieser Dienste werden oft zusammen verwendet und müssen daher eine einfache Benutzeroberfläche für die Wiederverwendung bieten und standardisierte Mechanismen für den Import und Export von Daten unterstützen. So können z. B. Dienste wie Uber Google Maps in ihre Produkte integrieren, um den Benutzern vereinfachte Standort- und Navigationsinformationen zur Verfügung zu stellen.
Wir werden jetzt einige der frühen Lösungen für die verschiedenen oben genannten Probleme untersuchen. Die erste zu bewältigende Herausforderung war die große Roundtripzeit für frühe Webdienste, die sich überwiegend in Nordamerika befanden. Die ersten Mechanismen zur Bewältigung der Probleme der geringen Latenzzeit (aufgrund von weit entfernten Servern) und des Serverausfalls basierten einfach auf Redundanz. Ein Verfahren dazu war die „Spiegelung“ von Inhalten, bei der Kopien beliebter Webseiten an verschiedenen Orten auf der Welt gespeichert wurden. Dadurch wurde die Belastung des zentralen Servers minimiert, die Latenzzeit der Endbenutzer reduziert und der Datenverkehr im Fehlerfall zu einem anderen Server umgeleitet. Der Nachteil war eine erhöhte Komplexität im Umgang mit Inkonsistenzen, wenn auch nur eine Kopie der Daten geändert werden sollte. Daher ist dieses Verfahren eher für statische Workloads mit umfangreichen Lesevorgängen wie die Bereitstellung von Bildern, Videos oder Musik geeignet. Aufgrund der Effektivität dieses Verfahrens verwenden die meisten internetbasierten Dienste Content Delivery Networks (CDNs), um verteilte globale Caches von beliebten Inhalten zu speichern. So verwaltet z. B. Cable News Network (CNN) jetzt Replikate ihrer Videos auf mehreren „Edge“-Servern an verschiedenen Standorten weltweit, die jeweils eine personalisierte Werbung pro Standort aufweisen.
Natürlich war es nicht immer sinnvoll, dass einzelne Unternehmen Dutzende von Servern auf der ganzen Welt kaufen. Kosteneffizienzen wurden oft durch die Nutzung von gemeinsam genutzten Hostingdiensten erzielt. Hier würden Freigaben eines einzelnen Webservers an mehrere Mandanten vermietet, wodurch sich die Kosten für die Serverwartung amortisieren. Gemeinsam genutzte Hostingdienste könnten sehr ressourceneffizient sein, da die Ressourcen unter der Annahme, dass nicht alle Dienste gleichzeitig mit Spitzenlast betrieben würden, überdimensioniert werden könnten. (Bei einem überdimensionierten physischen Server ist die Gesamtkapazität aller Mandanten größer als die tatsächliche Kapazität des Servers.) Der Nachteil bestand darin, dass es fast unmöglich war, die Dienste der Mandanten von denen ihrer Nachbarn zu isolieren. So könnte ein einzelner überlasteter oder fehleranfälliger Dienst alle seine Nachbarn negativ beeinflussen. Ein weiteres Problem ergab sich, da die Mandanten oft böswillig seien und versuchen könnten, ihren Vorteil der Zusammenlegung zu nutzen, um Daten zu stehlen oder anderen Benutzern den Dienst zu verweigern.
virtuelle private Server wurden als Varianten des gemeinsam genutzten Hostingmodells entwickelt, um dem entgegenzuwirken. Einem Mandanten würde ein virtueller Computer (VM) auf einem freigegebenen Server zur Verfügung gestellt. Diese virtuellen Computer wurden oft statisch zugewiesen und mit einem einzelnen physischen Computer verknüpft, wodurch sie schwer skalierbar waren und oft eine manuelle Wiederherstellung nach Ausfällen erforderten. Obwohl sie nicht mehr überdimensioniert werden konnten, wiesen sie eine bessere Isolation der Leistung und Sicherheit zwischen den zusammengelegten Diensten als eine einfache Ressourcenfreigabe auf.
Ein weiteres Problem der gemeinsamen Nutzung öffentlicher Ressourcen war, dass die Speicherung privater Daten in der Infrastruktur von Drittanbietern erforderlich war. Einige der oben beschriebenen internetbezogenen Dienste konnten es sich nicht leisten, die Kontrolle über die Datenspeicherung zu verlieren, da jede Offenlegung privater Daten ihrer Kunden verheerende Folgen hätte. Daher mussten diese Unternehmen ihre eigene globale Infrastruktur einrichten. Vor dem Aufkommen der Public Cloud konnten solche Dienste nur von großen Unternehmen wie Google und Amazon bereitgestellt werden. Jedes dieser Unternehmen würde weltweit große, homogene Rechenzentren mit Standardkomponenten errichten, wobei ein Rechenzentrum als ein einzelner, massiver Computer von der Größe einer Lagerhalle (Warehouse-Scale Computer, WSC) betrachtet werden könnte. Eine WSC bot eine einfache Abstraktion, um Anwendungen und Daten global zu verteilen und gleichzeitig das Besitzrecht zu behalten.
Aufgrund der Skalierungseffekte konnte die Auslastung eines Rechenzentrums optimiert werden, um Kosten zu senken. Auch wenn dies immer noch nicht so effizient war wie die öffentliche gemeinsame Nutzung von Ressourcen (die Cloud), hatten diese Computer von der Größe einer Lagerhalle viele wünschenswerte Eigenschaften, die als Grundlage für den Aufbau von internetbasierten Diensten dienten. Die Skalierung der Computinganwendungen entwickelte sich von der Betreuung einer festen Benutzerbasis hin zu einer dynamischen globalen Population. Standardisierte WSCs ermöglichten es großen Unternehmen, derart große Zielgruppen zu versorgen. Eine ideale Infrastruktur würde die Leistung und Zuverlässigkeit eines WSC mit dem gemeinsam genutzten Hostingmodell kombinieren. Dies würde es auch einem kleinen Unternehmen ohne den hohen Aufwand für den Aufbau großer Rechenzentren ermöglichen, eine weltweit wettbewerbsfähige Anwendung zu entwickeln und zu starten.
Ein weiterer Ansatz zur gemeinsamen Nutzung von Ressourcen war das Grid Computing, das die gemeinsame Nutzung autonomer Computersysteme zwischen Institutionen und geografischen Standorten ermöglichte. Mehrere akademische und wissenschaftliche Einrichtungen würden zusammenarbeiten und ihre Ressourcen zusammenlegen, um ein gemeinsames Ziel zu verfolgen. Jede Institution würde dann einer „virtuellen Organisation“ beitreten, indem sie eine bestimmte Anzahl von Ressourcen über klar definierte Freigaberegeln bereitstellt. Ressourcen sind oft heterogen und lose gekoppelt, sodass komplexe Programmierkonstrukte zusammengefügt werden müssen. Die Raster waren auf die Unterstützung nicht kommerzieller Forschungs- und akademischer Projekte ausgerichtet und basierten auf bestehenden Open-Source-Technologien.
Die Cloud war ein logischer Nachfolger, der viele der Features der oben genannten Lösungen kombinierte. So können z. B. Universitäten über die Cloud die Computinginfrastruktur mieten, die zentral von einem Cloud-Dienstanbieter verwaltet wird, anstatt einen Ressourcenpool über ein Raster zu nutzen, um zum Pool beizutragen und auf ihn zuzugreifen. Da der zentrale Anbieter über einen großen Ressourcenpool verfügte, um alle Kunden zufrieden zu stellen, erleichterte die Cloud das dynamische zentrale Hoch- und Herunterskalieren der Nachfrage in kurzer Zeit. Anstelle von offenen Standards wie dem Raster setzt das Cloud Computing jedoch auf proprietäre Protokolle und verlangt vom Anwender ein gewisses Maß an Vertrauen in den Cloud-Dienstanbieter.
Literatur
- IBM (2017). Was sind Big Data?https://www.ibm.com/analytics/hadoop/big-data-analytics
- Google Inc. (2015). How Search Works https://www.google.com/insidesearch/howsearchworks/thestory/
- Hamilton, James R und andere (2007). Entwerfen und Bereitstellen von Internet-Scale-Diensten
Überprüfen Sie Ihr Wissen
Feedback
War diese Seite hilfreich?
No
Benötigen Sie Hilfe zu diesem Thema?
Möchten Sie versuchen, Ask Learn zu verwenden, um Sie durch dieses Thema zu klären oder zu leiten?