Infrastructure-as-Code
- 11 Minuten
Wenn ein Unternehmen vor dem Cloudzeitalter seine IT-Infrastruktur erweitern musste, stellte es neue physische Server bereit und fügte sie dem Netzwerk hinter einem Lastenausgleich und einer Firewall hinzu. Wenn ein Betriebsleiter die Investitionsausgaben für die Unterstützung zusätzlicher Kapazitäten schätzen musste, erfolgten diese Schätzungen in Bezug auf ganze Server. Ein Taschenrechner war für „Architektur“ zuständig. Einer der Tipps bei der damaligen Kapazitätsplanung lautete, ein „Polster“ oder eine Überdimensionierung von 20 % einzuplanen, falls die ursprünglichen Schätzungen zu niedrig waren.
Die Cloud hat all das geändert, indem IT-Infrastruktur als Dienst (IaaS) angeboten wird. Plötzlich wurde das Hinzufügen von Kapazität zu einer Frage des Klickens auf Schaltflächen in einem Portal, der Eingabe von Befehlen in eine Konsole oder der Ausführung von Skripts. Doch mit dieser Einfachheit ergaben sich neue Herausforderungen. Wenn eine ganze Lösung aus Dutzenden oder sogar Hunderten von Clouddiensten binnen Minuten von einer einzigen Person bereitgestellt werden kann, wie können Sie dann sicherstellen, dass Lösungen ordnungsgemäß bereitgestellt werden, die einzelnen Ressourcen richtig konfiguriert sind und der Benutzer keinen Fehler gemacht hat? Wie lässt sich eine Lösung nach der Bereitstellung zuverlässig modifizieren und gleichzeitig das Potenzial menschlicher Fehler minimieren? Das Schreiben von Skripts ist eine Lösung, aber wie wir in der vorigen Lektion gelernt haben, löst es bestimmte Probleme, während es andere aufwirft.
Der nächste Schritt auf dem Weg zur Automatisierung der Prozesse zur Verwaltung von Cloudinfrastruktur ist Infrastructure-as-Code, kurz IaC. Die Grundidee ist IaC, eine Lösung explizit zu definieren, die wie ein Programm auf dynamische Weise in der Cloud bereitgestellt wird. Wenn Sie das Programm ausführen, erstellen Sie eine Lösung. Wenn Sie das Programm ändern, ändern Sie die Lösung. IaC bietet einen Mechanismus zur Definition einer Lösung. Darin sind viele der Elemente eines Programms enthalten, ohne unbedingt auf eine Programmiersprache angewiesen zu sein: Deklaration von Objekten (Variablen), wiederverwendbare Funktionen und Prozeduren, Abfangen und Beheben von Fehlern und vor allem formelle Unterstützung für Tests und Debuggen (Abbildung 3).
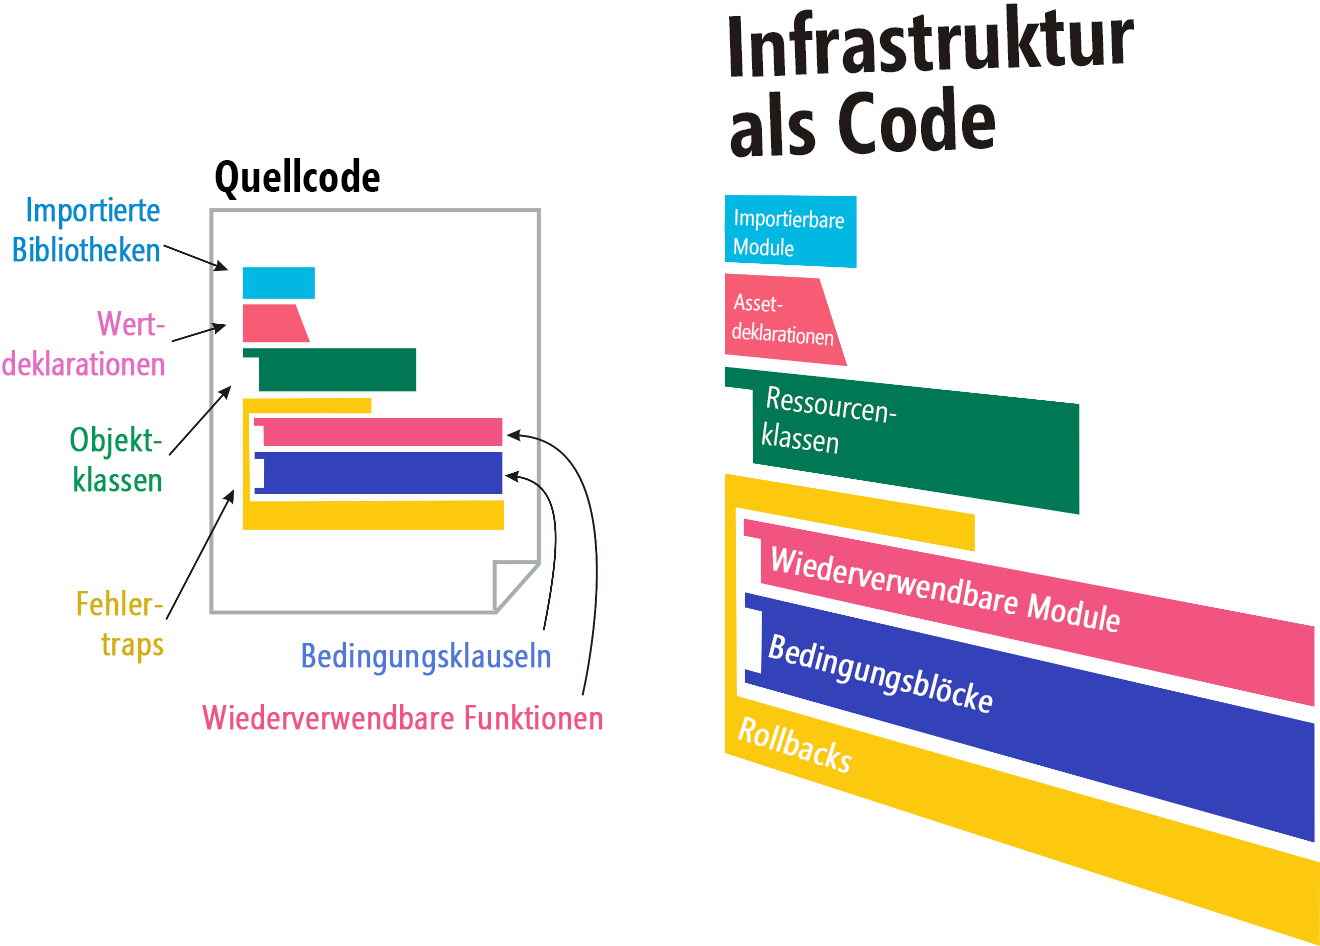
Abbildung 3: Parallelen zwischen Infrastructure-as-Code und Softwareprogrammen
IaC setzt auf Konfigurationsdateien, die dem Quellcode von Anwendungsprogrammen ähnlich sind. Eine IaC-Konfigurationsdatei sieht möglicherweise nicht wie Quellcode aus und ist wahrscheinlich nicht in Python oder einer anderen herkömmlichen Programmiersprache geschrieben. Dennoch sind alle wichtigen Komponenten, nach denen ein Softwareentwickler suchen würde, vorhanden, allerdings mit einer anderen Syntax. Einer Konfigurationsdatei können Befehle oder Schritt-für-Schritt-Prozeduren fehlen, die ein Python-Programm oder ein PowerShell-Skript aufweist. Aber sie definiert gleichermaßen sowohl ein Ergebnis als auch einen Prozess zum Erreichen dieses Ergebnisses.
Dies ist das Konzept von Infrastructure-as-Code. Die Dynamik der Cloud macht die Lösungsressourcen flexibel, ohne durch die Grenzen der Computer, die sie unterstützen, eingeschränkt zu sein. Ein System, das ihre Verwaltung überwacht, sollte auch nicht durch diese Grenzen eingeschränkt sein und das gesamte Rechenzentrum, sowohl lokal als auch dezentral, wie einen einzigen programmierbaren, zusammenstellbaren Computer behandeln.
Einführung in die Konfigurationsverwaltung
Neben der IT profitieren viele Branchen von der Konfigurationsverwaltung, insbesondere in der Fertigung und Produktion. Bei der Automobilproduktion bezieht sich Konfigurationsverwaltung auf die Methoden und Prozesse zur Herstellung eines Produkts, das bestimmte Normen oder Kundenanforderungen erfüllt. Im Industrieanlagenbau, der Teile für den Bau von Maschinen herstellt, gibt es Systeme für die Teilenummerierung, das Freigabemanagement, das Änderungsmanagement und die Statuserfassung, die alle koordiniert werden müssen, um ein wiederholbares Ergebnis zu erzielen.
Die Automatisierung der Konfigurationsverwaltung in der IT ist gar nicht so anders. Sie umfasst das Verwalten von Systemen in Übergangszuständen. Und sie umfasst die Koordination verschiedener Subsysteme für deren Zusammenspiel. Zurzeit beschäftigen sich IT-Administratoren mit philosophischen Fragen: Sollte das System die Prozesse, durch die eine cloudbasierte Infrastruktur bereitgestellt und aufgebaut wird, pflegen und erhalten? Oder sollte es stattdessen die Infrastrukturkomponenten definieren, die zur Erfüllung der Kunden- oder Benutzeranforderungen notwendig sind, und herausfinden, wie diese Anforderungen auf Grundlage des aktuellen Zustands der Infrastruktur erfüllt werden können? Heute sind Konfigurationsverwaltungssysteme im Einsatz, die entweder den einen oder den anderen Ansatz verfolgen.
1993, als Virtualisierung im Rechenzentrum noch in den Kinderschuhen steckte, produzierte ein Forscher für Quantenfeldtheorie an der Universität Oslo namens Mark Burgess in seiner Freizeit und zwischen staatlich finanzierten Projekten zur Wärmefeldtheorie1 das vermutlich erste moderne Tool zur Konfigurationsverwaltung. Es hieß CFEngine und begann als domänenspezifische Sprache, die auf Basis von Kriterien in der Konfiguration eines Computers bedingte Tests implementierte. Mit diesen Tests wurde ermittelt, welche Anweisungen ausgeführt werden müssen, um das System in einen gewünschten Konfigurationszustand zu versetzen.
Im Laufe ihrer Entwicklung wurden die Kriterien für diese bedingten Tests wie Deklarationen formuliert, d. h. Aussagen, die beschreiben, wie der gewünschte Zustand des Systems aussehen sollte. Bis dahin wurde eine Systemkonfiguration als Ausgangszustand eines Systems beschrieben, das eine Reihe von Transformationen durchläuft. Derselbe Ansatz kann gewählt werden, um ein typisches Verwaltungsskript zu charakterisieren: eine Liste mit allen Aufgaben eines CLI-Interpreters, um den Zustand eines bestehenden Systems zu ändern oder um etwas in einen Zustand zu bringen, der bei null beginnt.
Sieben Jahre später definierte Burgess für sein wichtiges Lehrbuch zur Netzwerk- und Systemverwaltung2 tatsächlich die Verwendung des Begriffs „Infrastruktur“, um die Ressourcen zu bezeichnen, die das Rechenzentrum kollektiv bilden und unterstützen. Darin stellte er auch seine fünf Anforderungen an eine als stabil geltende Infrastruktur eines Rechenzentrums dar: Skalierbarkeit, Zuverlässigkeit, Redundanz, Homogenität und Reproduzierbarkeit.
Burgess war der Ansicht, dass es möglich sei, diese Anforderungen durch ein Konfigurationsverwaltungssystem zu erfüllen, dessen Sprache den Entwickler mit dem gewünschten Endzustand beginnen und das System die Entwicklung rückwärts in Richtung des gegenwärtigen Zustands lenken lässt. In einem auf seiner persönlichen Website veröffentlichten Essay3 beschreibt Burgess die Richtung, in die konventionelle Skripterstellung tendiert, als Kongruenz, was er mit einem Rezept vergleicht, das jemanden durch die Schritte führt, wie etwas erstellt wird, ohne zu beschreiben, was dieses Etwas ist. Die Richtung, die er bevorzugt, heißt Konvergenz. Er vergleicht sie mit der Verwendung einer Karte, die das Ziel zeigt, und der Planung einer Route, die dorthin zurückführt, wo Sie gerade sind.
Konfigurationsverwaltung der nächsten Generation
2006 veröffentlichte der Open-Source-Softwareentwickler Luke Kanies unter General Public License (GPL) ein Tool, das er Puppet nannte. Er beschrieb es als „Konfigurationsverwaltung der nächsten Generation4“ und stellte es seinen IT-Fachkollegen als „Abstraktionsschicht des Betriebssystems“ vor. Dieser Begriff hat sich nicht durchgesetzt, wohl aber die Idee. Seine Prämisse war, dass die Sprache eines Konfigurationsverwaltungssystems die erforderlichen Komponenten eines Ressourcentyps wie virtuelle Computer deklarieren muss. Das System kann dann die Verantwortung für die Ausführung aller notwendigen Schritte übernehmen, um diese Anforderungen oder etwas Ähnliches zu erfüllen, auch wenn sich die Reihenfolge dieser Schritte wahrscheinlich ändern wird. Weitere Details zur Sprache Puppet und zur Funktionsweise des Systems werden in der nächsten Lektion vorgestellt.
Bei Puppet kann ein Bediener eine Klasse von Diensten angeben, die sich aus Anwendungspaketen und den anderen Ressourcen zusammensetzt, die benötigt werden, um Benutzern etwas bereitzustellen. Der Auftrag des Konfigurationsverwaltungssystems besteht darin, die richtigen Ressourcen bereitzustellen, die für die Bereitstellung dieses Diensts gemäß der Klassifizierung in Puppet benötigt werden. Dies kann die Bereitstellung virtueller Computer oder bei neueren Containersystemen die Instanziierung von Containern und der sie unterstützenden Ressourcen umfassen.
DevOps – Entwickler und Bediener
Praktisch in dem Moment, in dem ein Unternehmen beginnt, über den Einsatz von Infrastructure-as-Code nachzudenken, beginnt es zu diskutieren, ob zwei seit jeher getrennte Abteilungen – IT-Verwaltung und Softwareentwicklung – sich zusammenschließen sollten. Die DevOps-Bewegung entstand aus der Idee heraus, dass jeder Plan auf dieser geschäftlichen Ebene nicht von zwei organisatorisch getrennten Teams umgesetzt werden kann.
Der Begriff „DevOps“ wird auf eine Inspiration auf einer Konferenz der Computerbranche 2009 zurückgeführt. Zwei der Redner waren John Allspaw, damals Leiter des technischen Betriebs, und Paul Hammond, Leiter des Entwicklungsteams, beim Foto-Sharing-Dienst Flickr. In ihrer gemeinsamen Session stellten sie diese damals radikale Idee vor: Wenn die Infrastruktur von Rechenzentren anpassungsfähig gestaltet werden und auf die sich ändernden Anforderungen von Workloads reagieren könnte, dann könnte sie Anwendungen und Dienste mit viel kürzeren Freigabezyklen und wesentlich schnelleren Bereitstellungs- und kontinuierlichen Verbesserungszyklen unterstützen.
IaC, Continuous Integration und Continuous Deployment (CI/CD) sowie die Neuausrichtung der Teams auf Projekte und Ziele statt auf Vorgesetzte und Organigramme wurden im Rahmen desselben evolutionären Trends zusammengeführt. Dieser Trend führt zu organisatorischen Veränderungen in den Fachbereichen, die auch von Mitarbeitern außerhalb der IT-Abteilung erkannt und geschätzt werden können:
Auswirkungen von DevOps
- Software wird schneller entwickelt.
- Tests werden ernster und strenger behandelt.
- Tools für die Infrastrukturverwaltung werden mit Automatisierungsserver integriert.
- Verwaltungsmethoden für Softwareteams werden für IT-Teams genutzt.
Software wird schneller entwickelt.
Oder für jene Organisationen, die noch nie eigene Anwendungen oder Dienste entwickelt haben, wird Software dort entwickelt, wo sie vorher nicht entwickelt wurde. Früher wurden die Freigabezyklen für Software über Monate, sogar Jahre, bis zu einem festgelegten Bereitstellungszeitpunkt auf dem Ablaufplan verlängert, der für das gesamte Unternehmen passend war. Ein Grund für solche Verlängerungen war es, Möglichkeiten einzuräumen, Hardware zu modernisieren oder zu ersetzen oder ganz neue Rechenzentren zu errichten, und zwar kurz vor einer Softwarefreigabe, die ansonsten in der Mitte des Zyklus von einer Infrastrukturveränderung betroffen gewesen wäre. Dank Cloudplattformen können Unternehmen nun häufiger inkrementelle Änderungen an ihrer Infrastruktur vornehmen, sodass es keinen Grund mehr gibt, Softwarefreigabezyklen zu verzögern.
Tests werden ernster und strenger behandelt.
In einer Rechenzentrumsumgebung mit umgesetzten CI/CD-Ansatz wird Software in mindestens einer, womöglich zwei getrennten Phasen getestet, bevor sie in die Produktion überführt wird. Es mag nicht praktikabel sein, ähnliche Entwicklungs- und Stagingphasen für Cloudinfrastrukturen einzurichten. IaC-Tools ermöglichen jedoch eine Planung von Probeläufen, bei denen Administratoren die Auswirkungen von Änderungen an Cloudlösungen beobachten und vorhersagen können, bevor diese verbindlich umgesetzt werden.
Tools für die Infrastrukturverwaltung werden mit Automatisierungsserver integriert.
Automatisierungsserver wie Jenkins werden verwendet, um Infrastrukturänderungen zu liefern. Die Folge ist, dass derselbe Ablaufplan für die Planung der Freigabezyklen von Anwendungen und Diensten mit Infrastrukturplänen, Rezepten (Chef) oder Playbooks (Ansible) synchronisiert wird, sodass der Zustand der Infrastruktur immer auf die unterstützten Workloads abgestimmt ist.
Verwaltungsmethoden für Softwareteams werden für IT-Teams genutzt.
Agile Methoden werden auf Betriebsteams ausgeweitet. In einem Agile-Framework legt ein kleineres Team mit einem Projektleiter einfachere Ziele fest, die in kürzeren Abständen erreicht werden können, und steuert diese Ziele methodischer an. Mehrere Teams können sich koordinieren und folglich ihren Fortschritt genauer messen. Ein nach dem Agile-Prinzip arbeitendes Betriebsteam kann sich enger mit einem Softwareteam abstimmen, um sicherzustellen, dass Infrastrukturressourcen verlässlich verfügbar sind.
IaC ist lediglich ein abstraktes Konzept ohne Tools zur Umsetzung. In der nächsten Lektion werden einige der verbreitetsten Tools zur Konfigurationsverwaltung vorgestellt, die alle in unterschiedlichem Maß das Konzept Infrastructure-as-Code aufgreifen.
Literatur
Persönliche Webseite von Mark Burgess. http://markburgess.org/bio.html.
Wiley Publishing. Prinzipien der Netzwerk- und Systemverwaltung. https://www.wiley.com/Principles+of+Network+and+System+Administration%2C+2nd+Edition-p-9780470868072.
Blog von Mark Burgess. http://markburgess.org/blog_cd.html.
usenix. Puppet: Konfigurationsverwaltung der nächsten Generation. https://www.usenix.org/publications/login/february-2006-volume-31-number-1/puppet-next-generation-configuration-management.
Überprüfen Sie Ihr Wissen
Feedback
War diese Seite hilfreich?
No
Benötigen Sie Hilfe zu diesem Thema?
Möchten Sie versuchen, Ask Learn zu verwenden, um Sie durch dieses Thema zu klären oder zu leiten?