Debuggen des Zuordnungsdatenflusses
Tipp
Weitere Details finden Sie auf der Registerkarte "Text und Bilder ".
Während des Erstellens von Zuordnungsdatenflüssen können Sie interaktiv beobachten, wie die Datentransformationen ausgeführt werden, sodass Sie sie debuggen können. Um diese Funktionalität zu verwenden, müssen Sie zuerst das Feature "Datenfluss Debuggen" aktivieren.
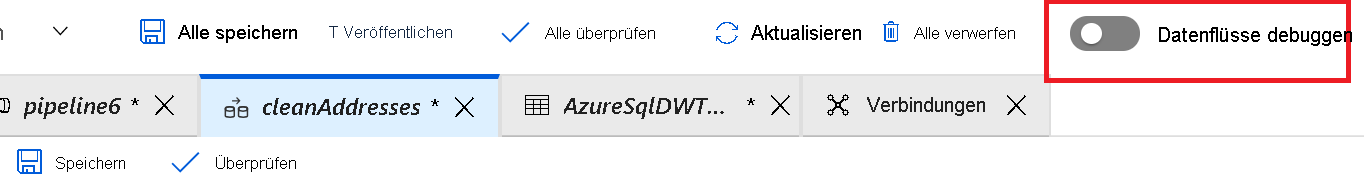
Durch Auswählen von Debug werden die Spark-Cluster bereitgestellt, die für die Interaktion mit den Transformationen von Zuordnungsdatenflüssen erforderlich sind. Beim Aktivieren des Debugvorgangs werden Sie aufgefordert, die Integration Runtime auszuwählen, die Sie in der Umgebung verwenden müssen. Wenn Sie AutoResolveIntegrationRuntime auswählen, wird ein Cluster mit acht Kernen und einer Standard-„Time to Live“ (TTL) von 60 Minuten gestartet. Sie können eine höhere TTL auswählen, wenn Sie mehr Leerlaufzeit vor dem Timeout der Sitzung zulassen möchten.
Hinweis
Es dauert normalerweise 5–7 Minuten, bis der Cluster hochgefahren ist. Wenn dieser Modus aktiviert ist und die Spark-Cluster ausgeführt werden, können Sie Ihren Datenfluss Schritt für Schritt aufbauen und die Daten einsehen, während sie jede Transformationsphase durchlaufen.
Eine Registerkarte "Datenvorschau" ist im Debugmodus verfügbar, mit der Sie die Daten in jeder Phase der Pipeline anzeigen können. Sie können die Daten nach jeder Transformation anzeigen. Die Datenvorschau bietet auch die Möglichkeit, Aktionen für die Daten auszuführen, z. B. das Anzeigen beschreibender Statistiken, das Ändern des Datentyps einer Spalte oder das Entfernen einer Spalte.
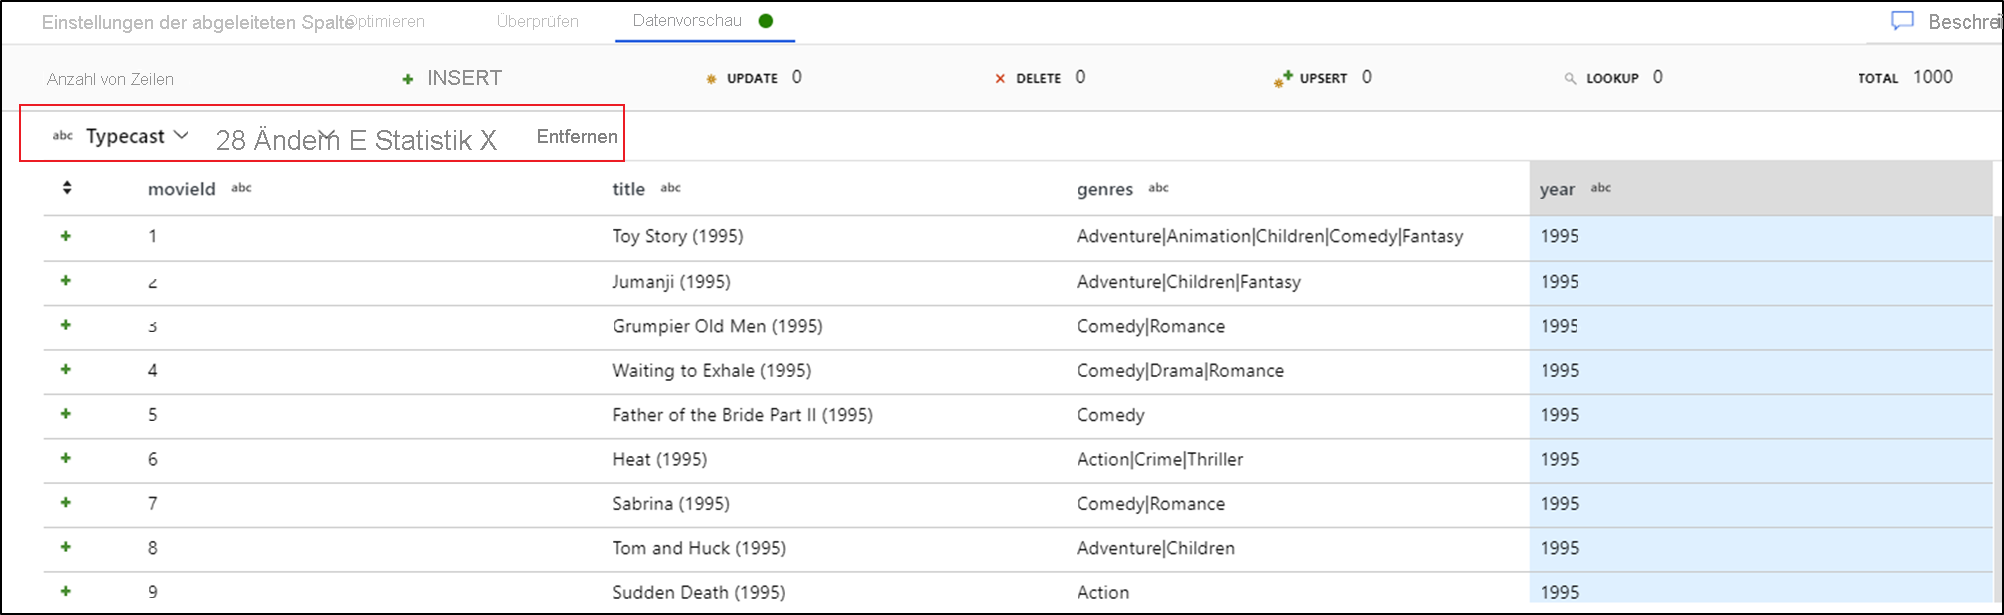
Schließlich können Sie die Debugeinstellungen verwenden, um die Anzahl der Zeilen zu kontrollieren, die innerhalb der Datenvorschau zurückgegeben werden.
Hinweis
Es wird empfohlen, die Anzahl der Zeilen auf so viele wie nötig zu beschränken, um zu bestätigen, dass die Daten korrekt sind. Je größer das Dataset ist, desto länger dauert es, bis die Ergebnisse zurückgegeben werden. Sie können in den Debugeinstellungen auch alle Parameterwerte angeben, die während der Ausführung der Pipeline verwendet werden sollen.
Sie werden pro Stunde abgerechnet, während eine Debugsitzung ausgeführt wird, einschließlich der TTL-Zeit. Deaktivieren Sie den Debugschalter, wenn Sie das Debuggen abgeschlossen haben, damit der Spark-Cluster beendet werden kann.