Implementierung von Validierungsprüfungen
Bei Datenpipelinen treten häufig Datensätze mit fehlenden Werten, doppelten Bezeichnern oder Werten auf, die außerhalb zulässiger Bereiche liegen. Ohne Überprüfungsprüfungen verteilen sich diese Datenqualitätsprobleme nachgelagert, verursachen falsche Analysen, fehlgeschlagene Berichte und unzuverlässige Geschäftsentscheidungen. Validierungsprüfungen erfassen diese Probleme am Zeitpunkt der Datenaufnahme und stellen sicher, dass nur Qualitätsdaten über Ihre Pipeline fließen.
In dieser Lektion erfahren Sie, wie Sie Validierungsprüfungen für Nullbarkeit, Datenkardinalität und Bereichsprüfung mithilfe von Erwartungen für Lakeflow-Pipelines und Delta Lake-Tabellen-Constraints implementieren.
Grundlegendes zu Validierungsansätzen in Azure Databricks
Azure Databricks bietet zwei primäre Mechanismen für die Implementierung von Überprüfungen: Pipelineerwartungen und Tabelleneinschränkungen. Jeder Ansatz dient verschiedenen Szenarien und bietet unterschiedliche Funktionen.
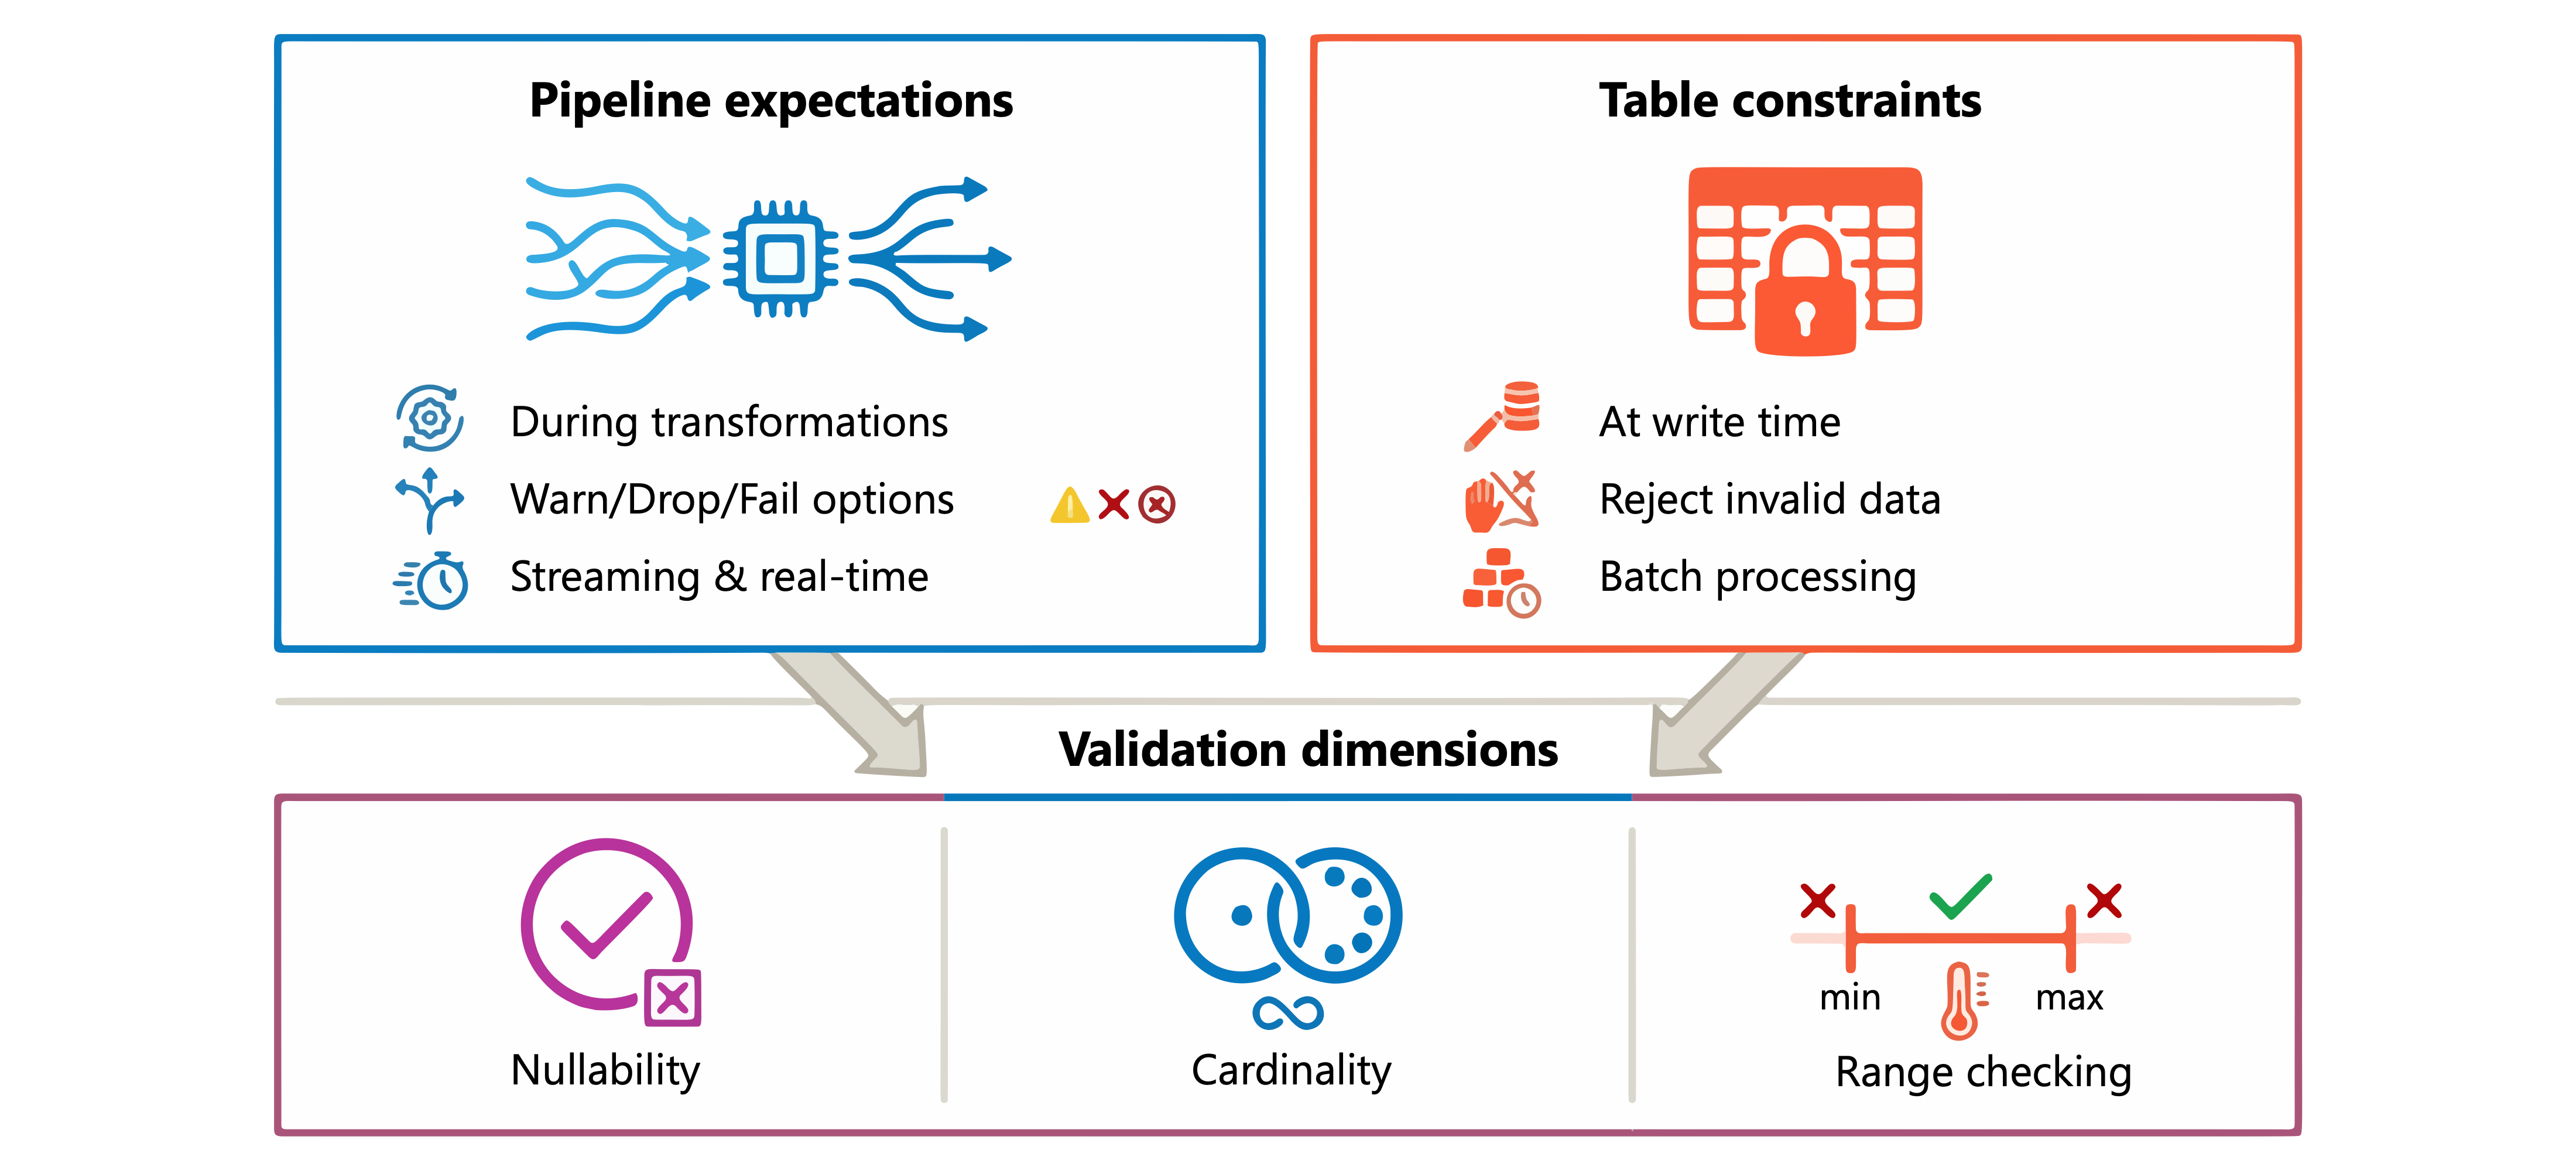
Pipelineerwartungen wenden die Validierung während Datentransformationen in Lakeflow-Pipelines an. Erwartungen ermöglichen es Ihnen, vor ungültigen Datensätzen zu warnen, sie zu löschen oder die Pipeline zu stoppen, wenn Daten gegen Ihre Regeln verstoßen. Dieser Ansatz eignet sich gut für Streamingtabellen und materialisierte Ansichten, bei denen Sie die Qualitätskontrolle in Echtzeit benötigen.
Tabelleneinschränkungen setzen Regeln direkt auf Delta Lake-Tabellen durch. Einschränkungen weisen ungültige Daten zum Zeitpunkt des Schreibens ab und verhindern, dass schlechte Datensätze in Ihre Tabellen gelangen. Dieser Ansatz eignet sich für die Batchverarbeitung und Szenarien, die strenge Datenintegritätsgarantien erfordern.
Mit diesen Ansätzen können Sie drei wichtige Dimensionen der Datenqualität überprüfen: Nullbarkeit (sicherstellen, dass erforderliche Werte vorhanden sind), Datenkardinalität (Überprüfen der Eindeutigkeit, wo erwartet) und Bereichsüberprüfung (bestätigen, dass Werte in akzeptable Grenzen fallen).
Implementieren von Nullbarkeitsprüfungen
Die Nullierbarkeitsüberprüfung stellt sicher, dass erforderliche Spalten Werte enthalten. Betrachten Sie eine Kundentabelle, in der sowohl email als auch customer_id immer Werte haben müssen. Sie können diese Prüfungen mithilfe der Erwartungen in Ihrer Pipeline implementieren.
Fügen Sie mithilfe von Python Ihrer Definition der Streamingtabelle Erwartungsdekoratoren hinzu.
from pyspark import pipelines as dp

@dp.table
@dp.expect_or_drop("valid_email", "email IS NOT NULL")
@dp.expect_or_drop("valid_customer_id", "customer_id IS NOT NULL")
def customers():
    return spark.readStream.table("raw.customers")
Dieselbe Überprüfung in SQL verwendet die CONSTRAINT Klausel:
CREATE OR REFRESH STREAMING TABLE customers(
    CONSTRAINT valid_email EXPECT (email IS NOT NULL) ON VIOLATION DROP ROW,
    CONSTRAINT valid_customer_id EXPECT (customer_id IS NOT NULL) ON VIOLATION DROP ROW
) AS SELECT * FROM STREAM(raw.customers);
Verwenden Sie Einschränkungen NOT NULL in der Tabellendefinition für Delta Lake-Tabellen außerhalb von Pipelines.
CREATE TABLE customers (
    customer_id INT NOT NULL,
    email STRING NOT NULL,
    first_name STRING,
    last_name STRING
);
Sie können vorhandenen Tabellen auch Nullbarkeitseinschränkungen hinzufügen:
ALTER TABLE customers ALTER COLUMN email SET NOT NULL;
Hinweis
Bevor Sie einer vorhandenen Tabelle eine NOT NULL Einschränkung hinzufügen, überprüft Azure Databricks, ob alle vorhandenen Zeilen die Einschränkung erfüllen. Der Vorgang schlägt fehl, wenn in der Spalte Nullwerte vorhanden sind.
Validieren der Datenkardinalität
Die Kardinalitätsüberprüfung stellt sicher, dass Spalten tatsächlich eindeutige Werte enthalten sollen. Diese Überprüfung ist für Primärschlüssel, Transaktions-IDs und andere Felder unerlässlich, in denen Duplikate Probleme mit der Datenqualität angeben.
Pipelineerwartungen können die Kardinalität validieren, indem Bedingungen geprüft werden, die auf Eindeutigkeitsprobleme hinweisen. So können Sie beispielsweise sicherstellen, dass pro Person nur einmal eine Sozialversicherungsnummer angezeigt wird:
from pyspark.sql.window import Window
from pyspark.sql.functions import count

@dp.table
@dp.expect("unique_ssn_per_person", "ssn_count = 1")
def employees():
    df = spark.table("raw.employees")
    w = Window.partitionBy("ssn")
    return df.withColumn("ssn_count", count("*").over(w))
Für umfassendere Kardinalitätsprüfungen kombinieren Sie Erwartungen mit Aggregationslogik in Ihrer Transformation:
CREATE OR REFRESH MATERIALIZED VIEW order_validation AS
SELECT
    order_id,
    COUNT(*) as occurrence_count
FROM orders
GROUP BY order_id
HAVING COUNT(*) > 1;
Diese materialisierte Ansicht identifiziert alle duplizierten Auftrags-IDs, sodass Sie Kardinalitätsprobleme untersuchen und beheben können.
Delta Lake unterstützt Primärschlüsseleinschränkungen, die die erwartete Eindeutigkeit dokumentieren, obwohl diese Einschränkungen informativ sind und nicht erzwungen werden.
CREATE TABLE orders (
    order_id INT NOT NULL,
    customer_id INT,
    order_date DATE,
    CONSTRAINT orders_pk PRIMARY KEY (order_id)
);
Tipp
Während Primärschlüsseleinschränkungen nicht erzwungen werden, helfen sie bei der Abfrageoptimierung und beim Dokumentieren der beabsichtigten Struktur Ihres Datenmodells. Verwenden Sie Pipeline-Erwartungen, um die Einzigartigkeit aktiv durchzusetzen.
Bereichsprüfung anwenden
Die Bereichsüberprüfung bestätigt, dass numerische, Datums- und andere Werte in akzeptable Grenzen fallen. Bei dieser Überprüfung werden Dateneingabefehler, Systemstörungen und Integrationsprobleme erfasst, die außerhalb des zulässigen Bereichs liegende Werte erzeugen.
Definieren Von Bereichserwartungen mithilfe von Vergleichsoperatoren oder der BETWEEN Klausel:
@dp.table
@dp.expect_or_fail("valid_age", "age BETWEEN 0 AND 150")
@dp.expect_or_fail("valid_salary", "salary >= 0")
@dp.expect_or_fail("valid_hire_date", "hire_date <= current_date()")
def employees():
    return spark.readStream.table("raw.employees")
Wenden Sie in SQL die gleichen Bereichsüberprüfungen an:
CREATE OR REFRESH STREAMING TABLE transactions(
    CONSTRAINT valid_amount EXPECT (amount > 0) ON VIOLATION DROP ROW,
    CONSTRAINT valid_date EXPECT (transaction_date <= current_date()) ON VIOLATION DROP ROW,
    CONSTRAINT valid_quantity EXPECT (quantity BETWEEN 1 AND 10000) ON VIOLATION DROP ROW
) AS SELECT * FROM STREAM(raw.transactions);
Verwenden Sie CHECK-Einschränkungen für Delta Lake-Tabellen, um Bereiche zum Zeitpunkt des Schreibens zu erzwingen.
ALTER TABLE employees ADD CONSTRAINT valid_age CHECK (age >= 18 AND age <= 120);
ALTER TABLE transactions ADD CONSTRAINT positive_amount CHECK (amount > 0);
Bereichsprüfungen können auch Geschäftsregeln überprüfen, die mehrere Bedingungen kombinieren:
@dp.expect("valid_discount", """
    discount_percent >= 0
    AND discount_percent <= 100
    AND (discount_percent <= 50 OR customer_tier = 'PREMIUM')
""")
Diese Erwartung stellt sicher, dass Rabatte innerhalb der Grenzen bleiben und erzwingt, dass nur Premiumkunden Rabatte über 50%erhalten.
Auswählen von Aktionen für Überprüfungsfehler
Wenn die Überprüfung fehlschlägt, wählen Sie aus, wie Ihre Pipeline reagiert. Jede Aktion passt zu unterschiedlichen Geschäftlichen Anforderungen und Datenkritischen Ebenen.
| Maßnahme | Anwendungsfall | Verhalten |
|---|---|---|
| Warnen (Standard) | Überwachung und Analyse | Ungültige Datensätze, die in das Ziel geschrieben werden; protokollierte Metriken |
| Verwerfen | Datenbereinigung | Ungültige Datensätze wurden vor dem Schreiben entfernt |
| Fehler | Kritische Datenintegrität | Pipeline stoppt; Transaktion wird zurückgesetzt |
Verwenden Sie die Warnaktion , wenn Sie Einblicke in Probleme mit der Datenqualität benötigen, ohne den Datenfluss zu blockieren:
@dp.expect("has_phone", "phone_number IS NOT NULL")
Verwenden Sie drop, wenn ungültige Datensätze stillschweigend herausgefiltert werden sollen.
@dp.expect_or_drop("complete_address", "street IS NOT NULL AND city IS NOT NULL")
Die Verwendung schlägt fehl , wenn die Datenintegrität kritisch ist und ungültige Datensätze inakzeptabel sind:
@dp.expect_or_fail("valid_account_balance", "balance >= 0")
Sie können Erwartungsmetriken in der Pipeline-Benutzeroberfläche anzeigen, indem Sie ein Dataset mit Erwartungen auswählen und die Registerkarte " Datenqualität " öffnen. Diese Metriken helfen Ihnen bei der Überwachung der Überprüfungsdurchlaufraten und beim Identifizieren systematischer Probleme mit der Datenqualität.
Nachdem Sie nun wissen, wie Validierungsprüfungen implementiert werden, können Sie sicherstellen, dass Ihre Datenpipeline Qualitätsstandards für Nullbarkeit, Kardinalität und Wertbereiche beibehalten.