Vorbereiten von Daten für den Abruf
Tip
Weitere Details finden Sie auf der Registerkarte "Text und Bilder ".
Der Abruf kann nur Informationen finden, die durchsuchbar gemacht wurden. Bevor eine RAG-Anwendung Fragen beantworten kann, benötigt sie eine Indizierungspipeline , die Quelldaten vorbereitet.
Die Indizierungspipeline führt in der Regel die folgenden Aufgaben aus:
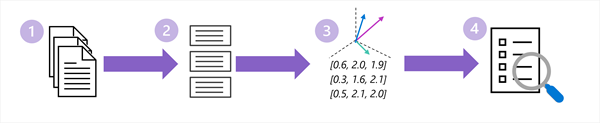
- Extrahiert den Quelltext.
- Unterteilt den Text in klar abgegrenzte Abschnitte.
- Codiert die Texttoken als Einbettungsvektoren, die semantische Attribute kapseln.
- Erstellt einen Index, der zum Durchsuchen der Einbettungen verwendet werden kann.
Lassen Sie uns jede dieser Aufgaben ausführlicher untersuchen.
Auswählen und Verarbeiten von Quelldaten
Eine RAG-Wissensquelle kann Produkthandbücher, Richtlinien, Webseiten, Datenbankdatensätze, Supporttickets oder andere genehmigte Inhalte umfassen. Der Vorbereitungsprozess umfasst häufig die folgenden Schritte:
- Lade Inhalt aus jeder Quelle.
- Extrahieren Sie nützlichen Text und die Struktur aus Formaten wie PDF-Dateien, Präsentationen, Webseiten oder Tabellen.
- Bereinigen Sie Inhalte, indem Sie wiederholte Kopfzeilen, Navigationstext oder andere Elemente entfernen, die für die Beantwortung von Fragen nicht hilfreich sind.
- Fügen Sie Metadaten wie Titel, Quell-URL, Kategorie, Zugriffsberechtigungen und datum der letzten Aktualisierung hinzu.
Die Quellqualität ist wichtig. Doppelte, veraltete oder widersprüchliche Dokumente können zu schlechten Abruf- und unzuverlässigen Antworten führen. Zugriffskontrollen sind ebenfalls unerlässlich: Benutzer sollten nur Inhalte abrufen, zu deren Anzeige sie berechtigt sind.
Aufteilen von Inhalten in Blöcke
Dokumente sind häufig zu groß, um an ein Modell vollständig zu senden. Sie sind in kleinere Abschnitte unterteilt, die als Chunks bezeichnet werden. Jeder Block sollte genügend Kontext enthalten, um sinnvoll zu sein, während er sich auf ein bestimmtes Thema konzentriert.
Beispielsweise könnte eine Reiserichtlinie nach Abschnitt in separate Blöcke für Flüge, Hotels, Mahlzeiten und Bodentransport aufgeteilt werden. Eine Frage zu Beschränkungen für Hotels kann dann den Abschnitt zu Hotels abrufen, ohne die gesamte Richtlinie dem Prompt hinzuzufügen.
Chunking beinhaltet einen Kompromiss:
- Zu große Textabschnitte können irrelevante Informationen enthalten und einen größeren Teil des Kontextfensters des Modells beanspruchen.
- Blöcke, die zu klein sind, können eine Anweisung von Überschriften, Definitionen oder anderen Informationen trennen, die zum Verständnis erforderlich sind.
Blöcke überschneiden sich häufig leicht, sodass ein wichtiger Kontext an einer Grenze nicht verloren geht.
Erstellen von Einbettungen
RAG-Lösungen verwenden häufig ein Einbettungsmodell , um jeden Block in eine Einbettung zu konvertieren: ein numerischer Vektor, der semantische Merkmale des Inhalts darstellt. Blöcke mit ähnlichen Bedeutungen weisen Einbettungen auf, die sich im Vektorraum nahe beieinander befinden, auch wenn sie unterschiedliche Wörter verwenden.
Indizierung der Daten
Die Lösung speichert die Blöcke, deren Einbettungen und nützliche Metadaten in einem Suchindex oder vektorfähigen Datenspeicher. Der Index kann Folgendes unterstützen:
- Schlüsselwortsuche, die effektiv ist, wenn genaue Wörter, Bezeichner oder Produktcodes wichtig sind.
- Vektorsuche, die semantisch ähnliche Inhalte findet.
- Hybridsuche, die Schlüsselwort- und Vektorsuche kombiniert.
Das Vorbereiten von Daten ist keine einmalige Aufgabe. Die Indizierungspipeline sollte neue Inhalte hinzufügen, geänderte Inhalte aktualisieren und inhalte entfernen, die nicht mehr gültig sind, sodass der Abruf die aktuelle Quelle der Wahrheit widerspiegelt.