Σημείωμα
Η πρόσβαση σε αυτήν τη σελίδα απαιτεί εξουσιοδότηση. Μπορείτε να δοκιμάσετε να εισέλθετε ή να αλλάξετε καταλόγους.
Η πρόσβαση σε αυτήν τη σελίδα απαιτεί εξουσιοδότηση. Μπορείτε να δοκιμάσετε να αλλάξετε καταλόγους.
Παραδείγματα ερωτημάτων (ονομάζονται επίσης "παραδείγματα λίγων λήψεων") δίνουν στον πράκτορα δεδομένων συγκεκριμένα μοτίβα από τα οποία μπορεί να μάθει. Είναι δείγματα ερωτήσεων και η αντίστοιχη λογική ερωτημάτων που παρέχουν οι δημιουργοί για να καθοδηγήσουν τον τρόπο με τον οποίο πρέπει να απαντήσει ο πράκτορας. Όταν ένας χρήστης κάνει μια ερώτηση σε μια προέλευση δεδομένων, ο παράγοντας δεδομένων ανακτά αυτόματα τα πιο σχετικά παραδείγματα—συνήθως τα τέσσερα πρώτα—και τα τροφοδοτεί στη διαδικασία δημιουργίας του. Με την αναφορά σε αυτά τα παραδείγματα, ο εκπρόσωπος μπορεί να κατανοήσει καλύτερα την αναμενόμενη δομή, τα φίλτρα και τους συνδέσμους, γεγονός που τον βοηθά να παράγει πιο ακριβή, συνεπή και με επίγνωση του περιβάλλοντος αποτελέσματα ερωτημάτων.
Παροχή παραδειγμάτων ερωτημάτων
Όταν παρέχετε παραδείγματα ερωτημάτων, πρέπει να συμπεριλάβετε τόσο μια ερώτηση φυσικής γλώσσας όσο και την αντίστοιχη απάντηση ερωτήματος. Κάθε ερώτηση πρέπει να είναι μοναδική για να δώσει στον Data Agent ένα ποικίλο σύνολο σημείων αναφοράς. Κάθε παράδειγμα ερωτήματος επικυρώνεται σε σχέση με το σχήμα της επιλεγμένης προέλευσης δεδομένων—τα ερωτήματα που δεν περνούν την επικύρωση δεν αποστέλλονται στον εκπρόσωπο. Για να διασφαλίσετε ότι χρησιμοποιούνται τα παραδείγματά σας, είναι σημαντικό να επιβεβαιώσετε ότι περνούν αυτό το βήμα επικύρωσης.
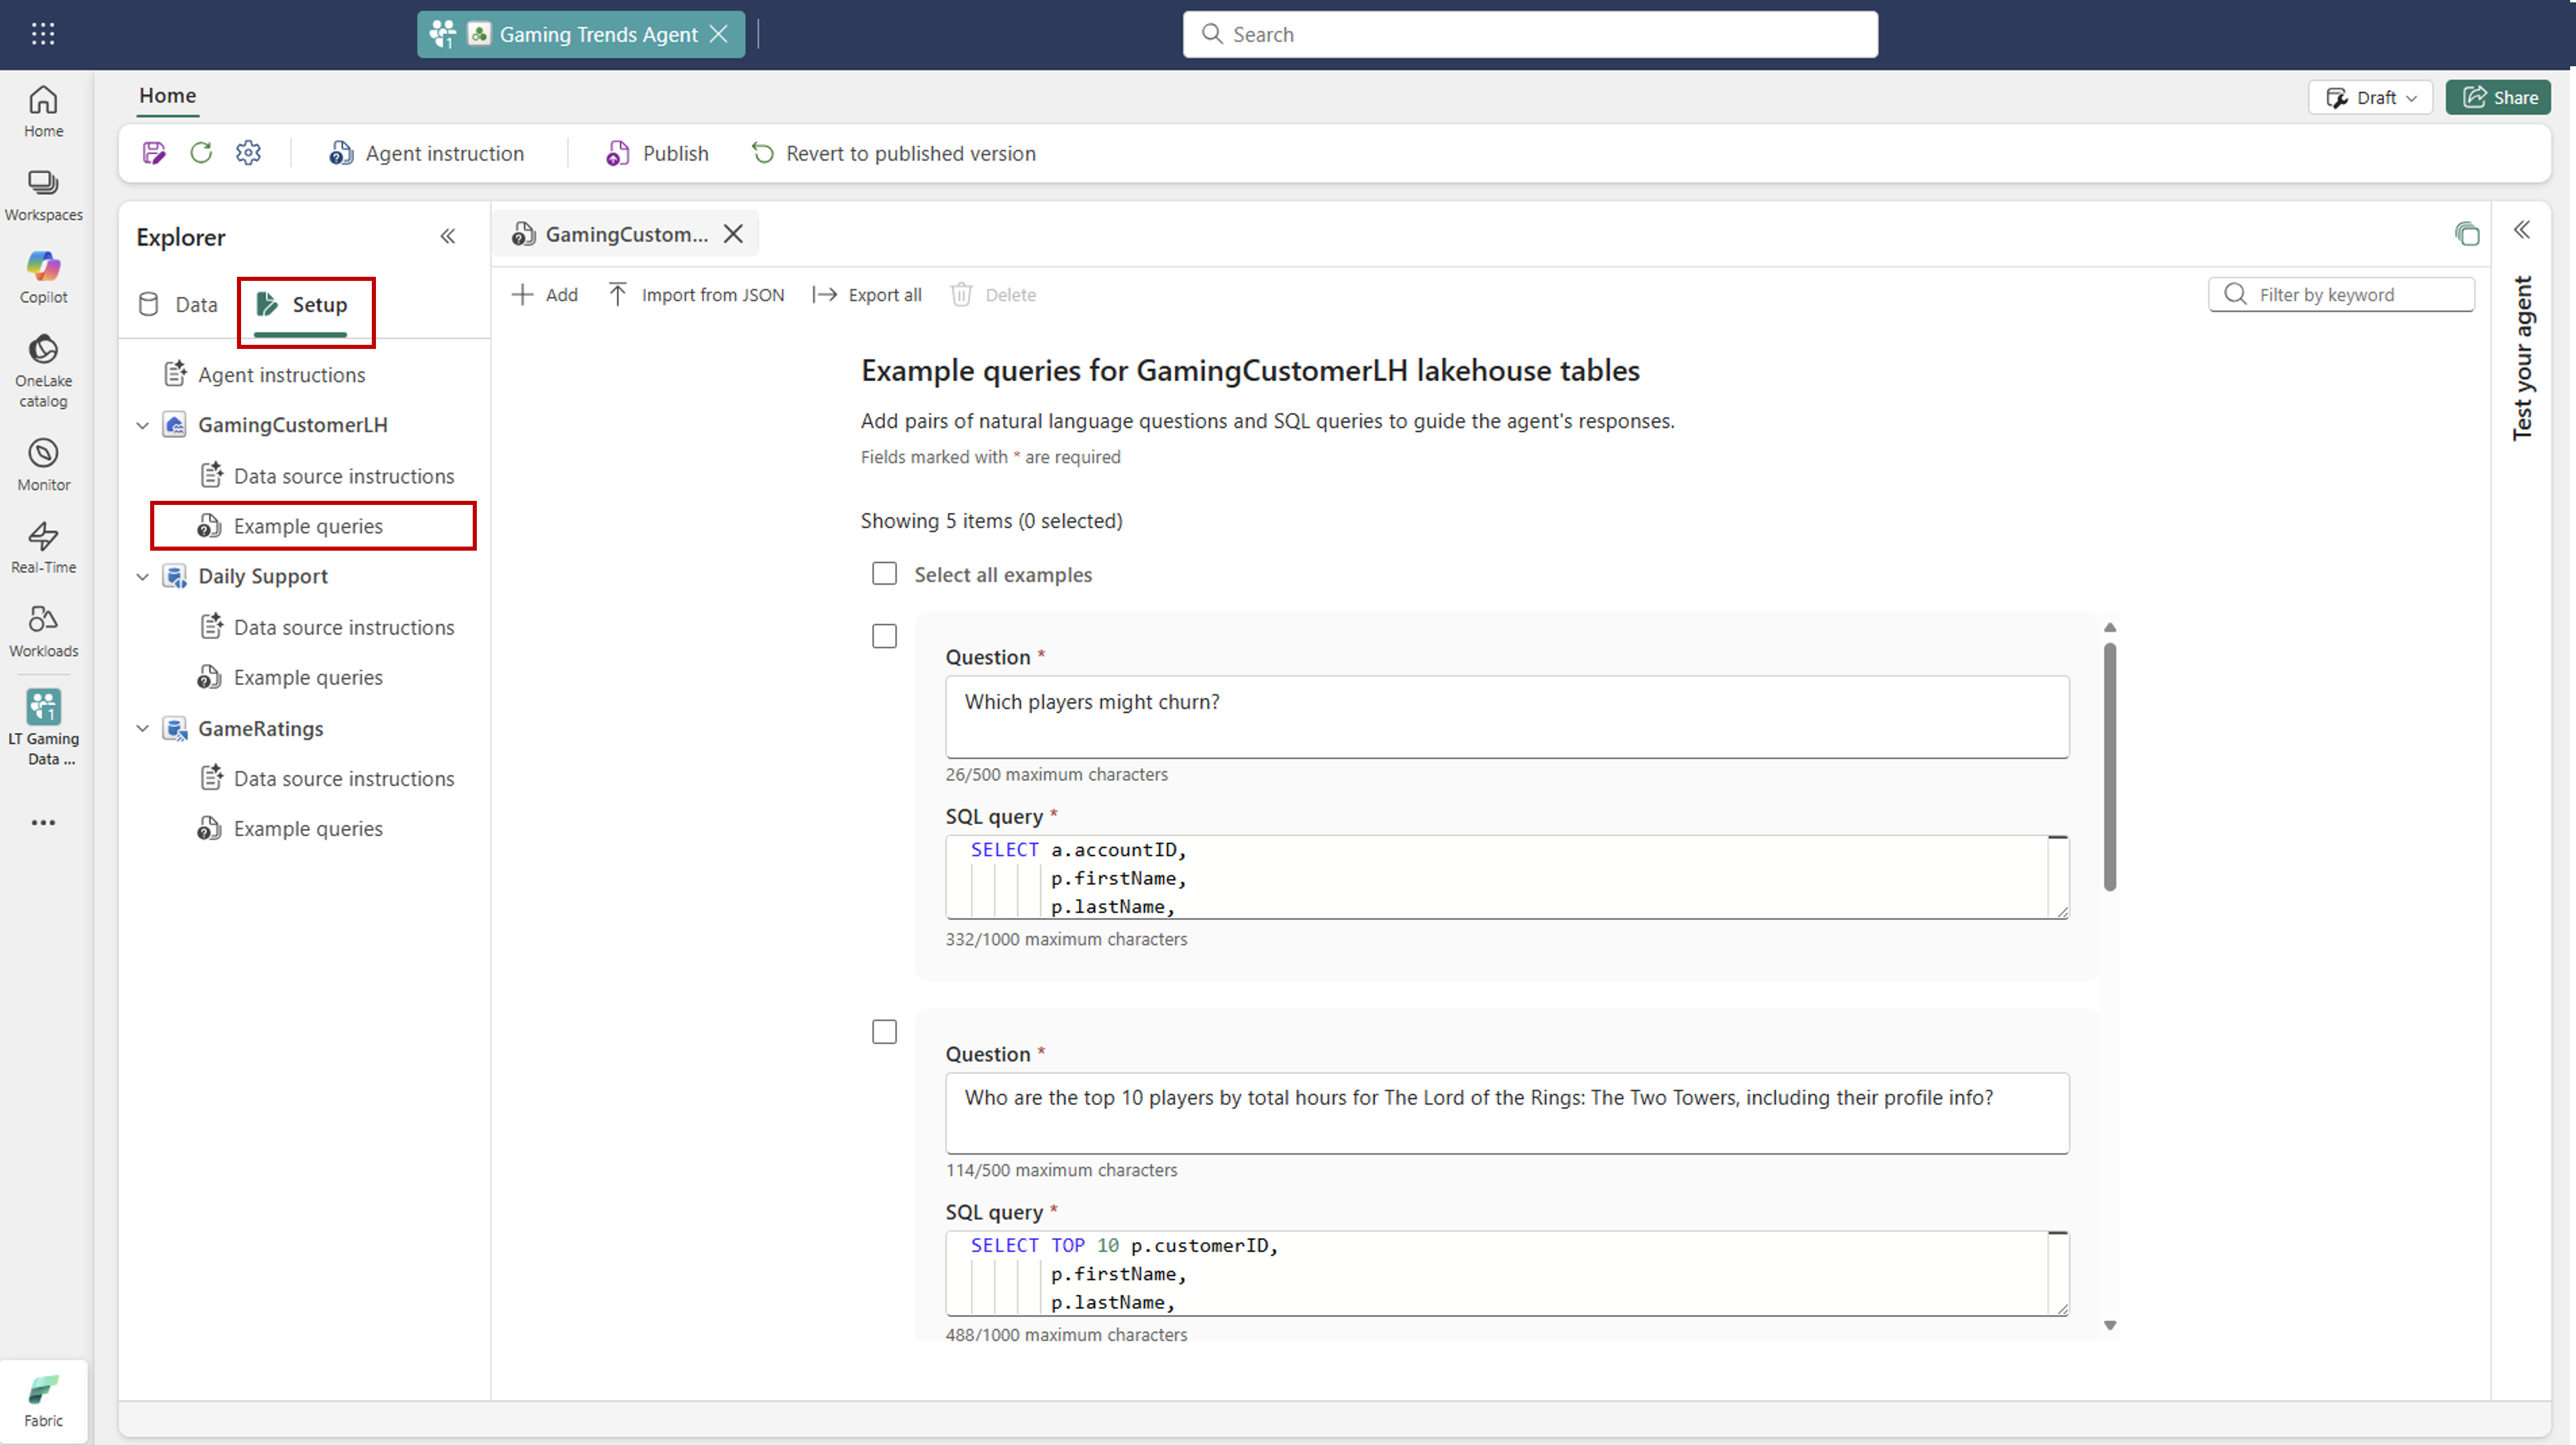
Ο πίνακας δείχνει ποιες προελεύσεις δεδομένων υποστηρίζουν αυτήν τη στιγμή παραδείγματα ερωτημάτων στο Data Agent. Αυτά τα παραδείγματα βοηθούν στην καθοδήγηση της διαδικασίας δημιουργίας ερωτημάτων του εκπροσώπου παρέχοντας μοτίβα και περιβάλλον.
| Τύπος προέλευσης δεδομένων | Υποστηρίζει παραδείγματα ερωτημάτων; |
|---|---|
| Lakehouse | ✅ Ναι |
| Warehouse | ✅ Ναι |
| Βάσεις δεδομένων KQL Eventhouse | ✅ Ναι |
| Σημασιολογικά μοντέλα | ❌ Όχι |
| Οντολογία | ❌ Όχι |
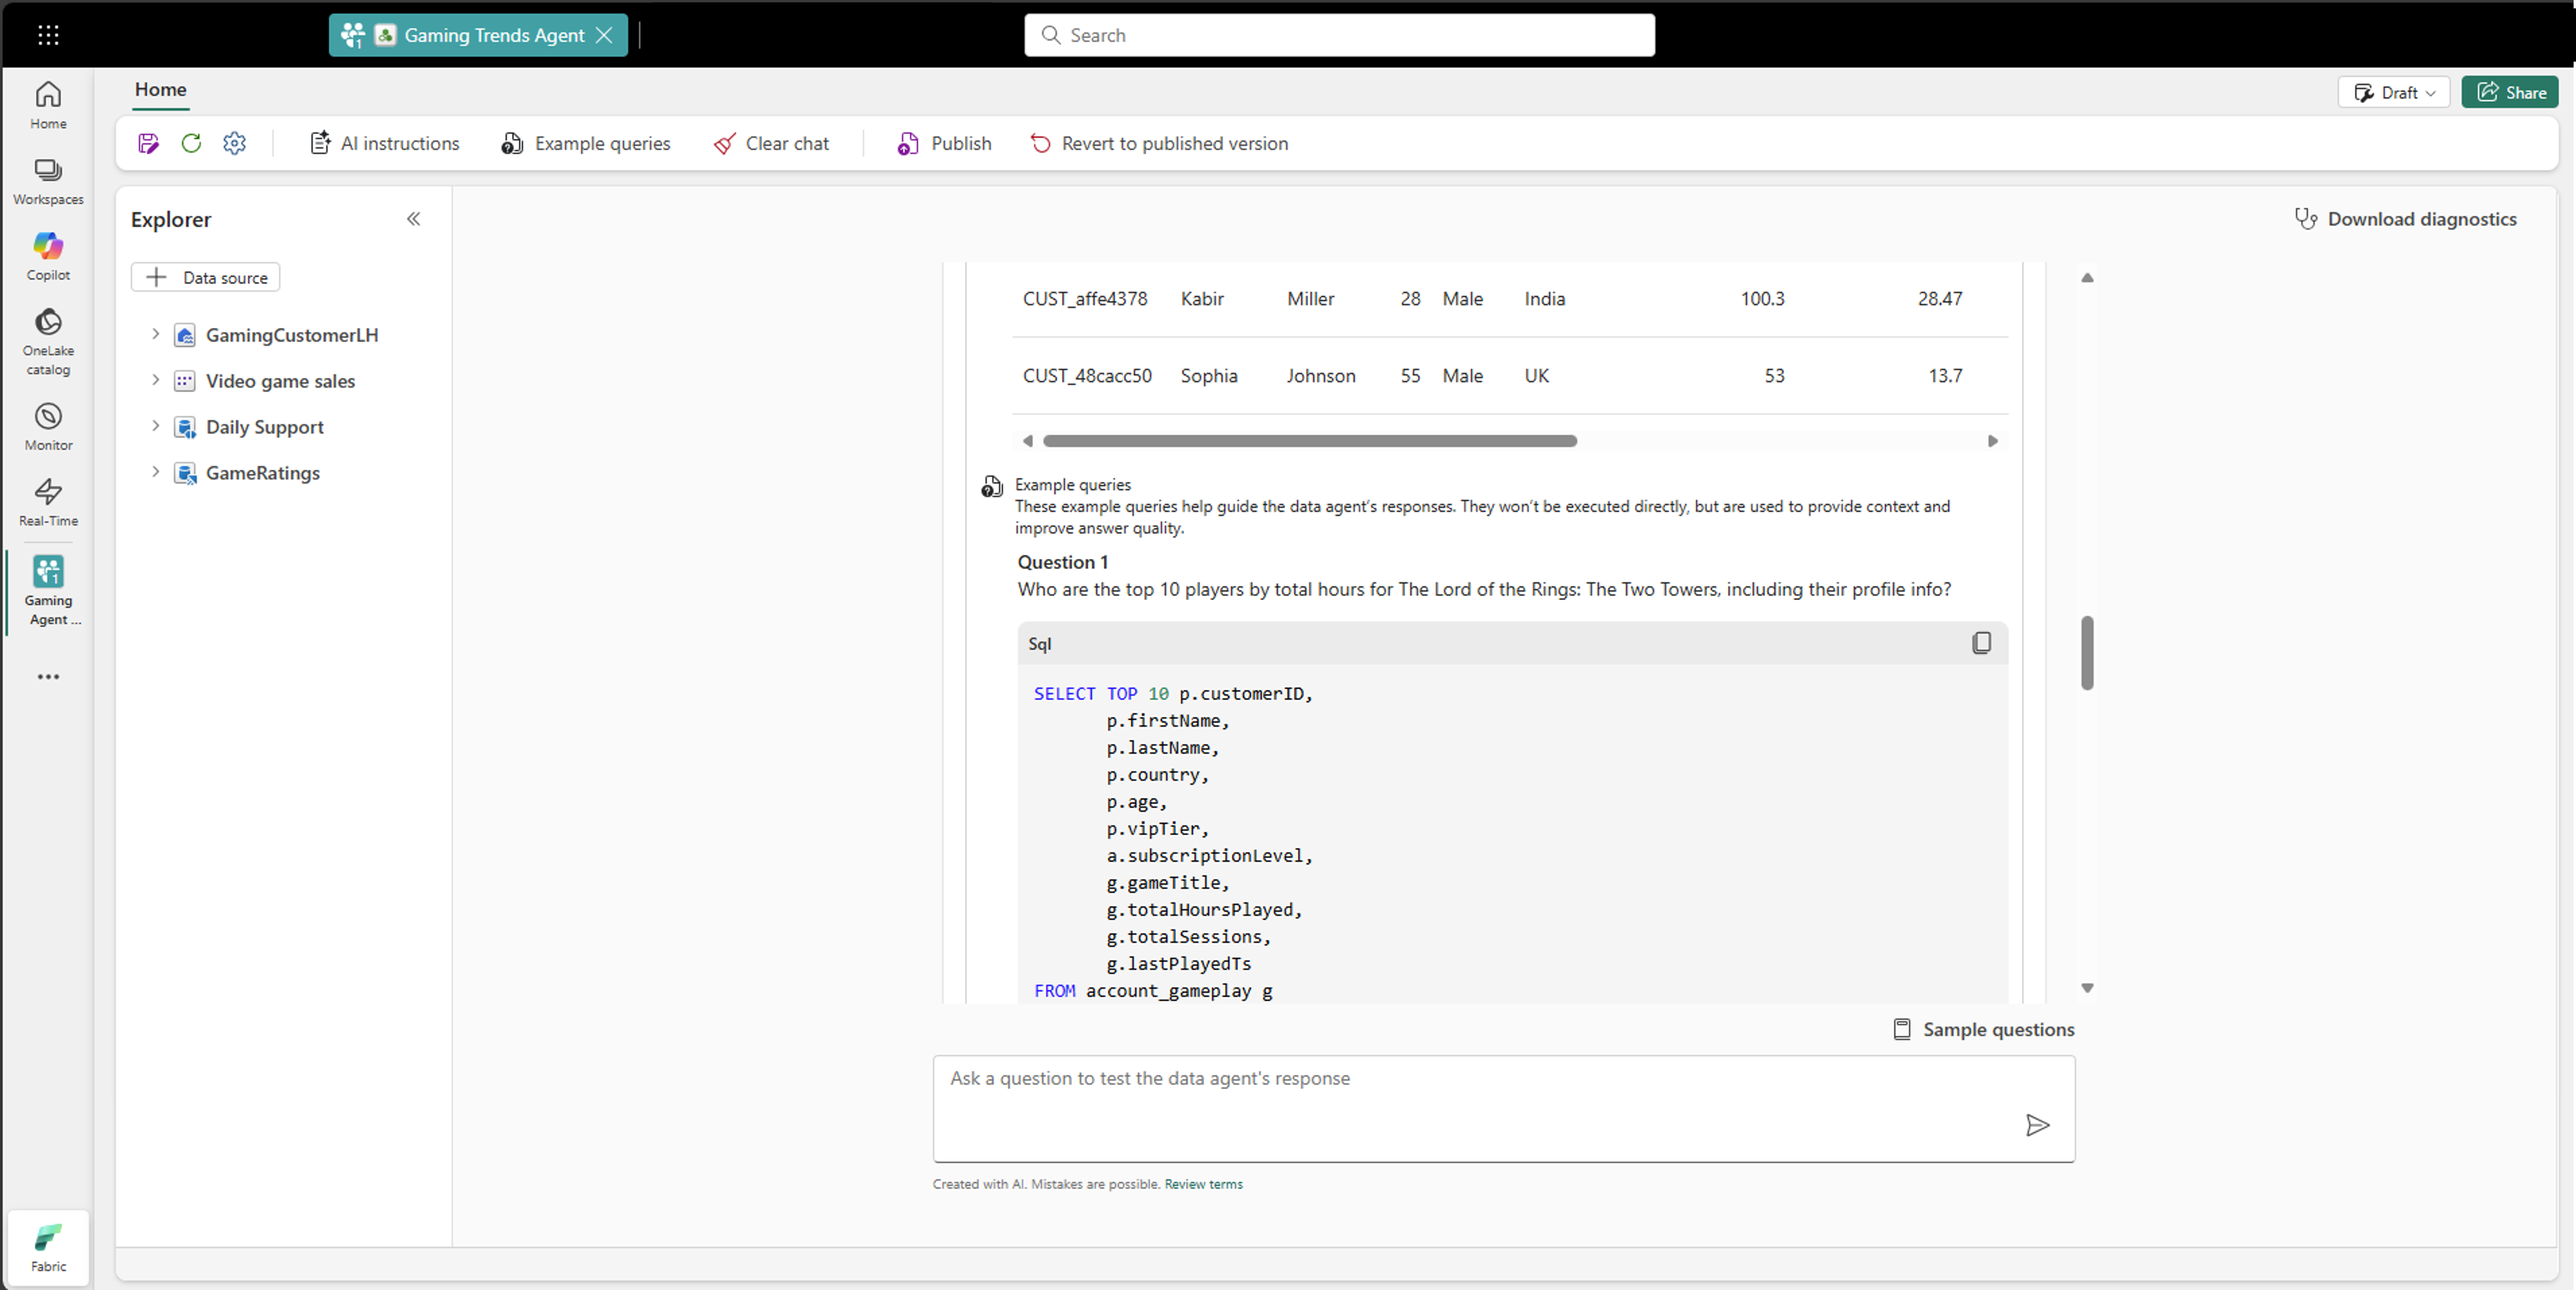
Μπορείτε επίσης να χρησιμοποιήσετε την προβολή βημάτων εκτέλεσης για να εντοπίσετε σφάλματα στα παραδείγματα ερωτημάτων που ανακτήθηκαν και εφαρμόστηκαν στην ερώτηση ενός χρήστη. Αυτή η προβολή είναι ιδιαίτερα χρήσιμη για την επιβεβαίωση ότι χρησιμοποιούνται τα σωστά παραδείγματα και για τη διάγνωση του λόγου για τον οποίο παράγονται ορισμένα αποτελέσματα. Εάν εμφανιστούν λάθος παραδείγματα, δοκιμάστε να βελτιώσετε τις ερωτήσεις σας ή να προσθέσετε σαφέστερα, πιο στοχευμένα παραδείγματα.
Βέλτιστες πρακτικές για τη σύνταξη παραδειγμάτων ερωτημάτων
Κατά τη δημιουργία παραδειγμάτων ερωτημάτων για τον παράγοντα δεδομένων, η τήρηση βέλτιστων πρακτικών διασφαλίζει ότι παρέχουν σαφή και αξιόπιστη καθοδήγηση κατά τη δημιουργία ερωτημάτων. Τα καλοφτιαγμένα παραδείγματα βοηθούν τον πράκτορα να κατανοήσει πώς οι ερωτήσεις φυσικής γλώσσας μεταφράζονται σε λογική SQL/KQL, να επισημάνει σύνθετες ενώσεις ή υπολογισμούς και να βελτιώσει την ακρίβεια των αποτελεσμάτων του. Χρησιμοποιήστε τις οδηγίες για να κάνετε τα παραδείγματά σας πιο αποτελεσματικά και αντιπροσωπευτικά πραγματικών σεναρίων χρηστών.
| # | Βέλτιστη πρακτική | Γιατί έχει σημασία |
|---|---|---|
| 1 | Βεβαιωθείτε ότι οι ερωτήσεις αντιστοιχίζονται με σαφήνεια στο ερώτημα | Ο πράκτορας δεδομένων χρησιμοποιεί αυτά τα παραδείγματα για να μάθει το μοτίβο μεταξύ της ερώτησης και της προκύπτουσας SQL/KQL. Η ασάφεια μειώνει την ακρίβεια. |
| 2 | Συμπεριλάβετε σχόλια στο ερώτημα για να καθοδηγήσετε τον εκπρόσωπο | Τα σχόλια ( -- substitute customer_id here) βοηθούν τον πράκτορα να καταλάβει πού να αντικαταστήσει τιμές ή να εφαρμόσει σημαντική λογική. |
| 3 | Επισημάνετε τη λογική σύνδεσης ή τα σύνθετα μοτίβα | Χρησιμοποιήστε παραδείγματα ερωτημάτων για να δείξετε πώς μπορείτε να χειριστείτε συνδέσμους πολλών πινάκων, συναθροίσεις ή άλλη προηγμένη λογική που είναι δύσκολο να περιγραφεί σε απλές οδηγίες. |
| 4 | Αποφύγετε τις επικαλύψεις ή τις αντιφάσεις | Κάθε παράδειγμα πρέπει να είναι διακριτό και μη αντικρουόμενο για να δίνει στον πράκτορα ένα καθαρό σήμα για το πώς να συμπεριφέρεται. |
| 5 | Χρησιμοποιήστε τα βήματα εκτέλεσης για να εντοπίσετε σφάλματα στα παραδείγματα που μεταβιβάζονται | Τα βήματα εκτέλεσης σάς επιτρέπουν να δείτε ποια παραδείγματα ανακτήθηκαν για μια δεδομένη ερώτηση χρήστη — εάν εμφανιστούν λάθος, προσαρμόστε τις ερωτήσεις σας ή προσθέστε πιο συγκεκριμένα παραδείγματα. |
| 6 | Αντικατοπτρίστε την πραγματική συμπεριφορά των χρηστών | Προσθέστε παραδείγματα ερωτημάτων που αντιπροσωπεύουν τα είδη των ερωτήσεων που κάνουν οι χρήστες σας για να μεγιστοποιήσετε τη συνάφεια και την ακρίβεια. |
Επικύρωση παραδειγμάτων ερωτημάτων
Το SDK Fabric Data Agent παρέχει ενσωματωμένα εργαλεία για την αξιολόγηση και τη βελτίωση της ποιότητας των παραδειγμάτων ερωτημάτων σας. Χρησιμοποιώντας τη evaluate_few_shots συνάρτηση, μπορείτε να επικυρώσετε κάθε ζεύγος φυσικής γλώσσας/SQL για να επιβεβαιώσετε ότι είναι σαφές, σωστό και ευθυγραμμισμένο με το σχήμα προέλευσης δεδομένων σας. Το SDK εκτελεί κάθε παράδειγμα μέσω της διαδικασίας αξιολόγησης του Data Agent, επιστρέφοντας μια λεπτομερή περίληψη των παραδειγμάτων που πέρασαν και ποια χρειάζονται βελτίωση.
Παροχή παραδειγμάτων ερωτημάτων
examples_to_add = {
    "What was total revenue for Product Alpha in Q1 2024?": "SELECT SUM(amount) AS revenue FROM sales WHERE product = 'Alpha' AND fiscal_quarter = '2024-Q1';",
    "Show me average deal size in the North region during 2023.": "SELECT AVG(amount) AS avg_deal FROM deals WHERE region = 'North' AND YEAR(closed_date) = 2023;",
    "How many support tickets were closed in January 2024?": "SELECT COUNT(*) AS tickets_closed FROM support_tickets WHERE status = 'Closed' AND DATE_TRUNC('month', closed_at) = '2024-01-01';",
    "What is the total revenue for Product Alpha in the first quarter of 2024?": "SELECT COUNT(DISTINCT order_id) AS revenue FROM order_facts WHERE product = 'Alpha' AND fiscal_quarter = '2024-Q1';",
    "How many new leads were generated from the website in February 2024?": "SELECT COUNT(*) AS web_leads FROM leads WHERE source = 'Web' AND DATE_TRUNC('month', created_at) = '2024-02-01';",
    "List total marketing touches for campaign Ignite in March 2024.": "SELECT SUM(touches) AS total_touches FROM campaign_metrics WHERE campaign_name = 'Ignite' AND DATE_TRUNC('month', activity_date) = '2024-03-01';",
    "What was the average deal amount in the North region during 2023?": "SELECT SUM(amount) / COUNT(*) AS avg_deal FROM deal_summary WHERE region = 'North' AND YEAR(closed_date) = 2023;",
    "Which products exceeded 1M revenue in 2023?": "SELECT product FROM sales WHERE YEAR(order_date) = 2023 GROUP BY product HAVING SUM(amount) > 1000000;",
    "Show me how many support tickets were closed during January 2024.": "SELECT COUNT(ticket_id) AS tickets_closed FROM ticket_events WHERE event_type = 'Closed' AND MONTH(event_time) = 1 AND YEAR(event_time) = 2024;",
    "What is the churn rate for subscription tier Gold in 2024 so far?": "SELECT SUM(churned_accounts)::float / NULLIF(SUM(active_accounts), 0) AS churn_rate FROM subscription_health WHERE tier = 'Gold' AND YEAR(snapshot_date) = 2024;",
}

# Add the examples to the datasource
try:
    datasource.add_fewshots(examples_to_add)
    print(f"Added {len(examples_to_add)} few-shot examples to the datasource")
except Exception as e:
    print(f"Note: {e}")
    print("Few-shots may already exist in the datasource")
Αξιολόγηση μέσω SDK
Εξετάζοντας το ποσοστό επιτυχίας και τα σχόλια, μπορείτε να προσαρμόσετε επαναληπτικά τα παραδείγματά σας—διευκρίνιση ερωτήσεων, βελτίωση της λογικής SQL ή προσθήκη σχολίων—ώστε ο παράγοντας δεδομένων να μαθαίνει από μοτίβα υψηλότερης ποιότητας και να παράγει πιο ακριβή αποτελέσματα για νέες ερωτήσεις.
# Evaluate few-shot examples using the Data Agent SDK.
# This runs validation on your natural-language/SQL pairs and returns a summary of results.
result = datasource.evaluate_few_shots(batch_size=20)


# Print out the overall success rate of your examples.
# This shows how many examples passed validation vs. the total tested.
print(f"Success rate: {result.success_rate:.2f}% ({result.success_count}/{result.total_examples})")
Παρακολούθηση σχολίων
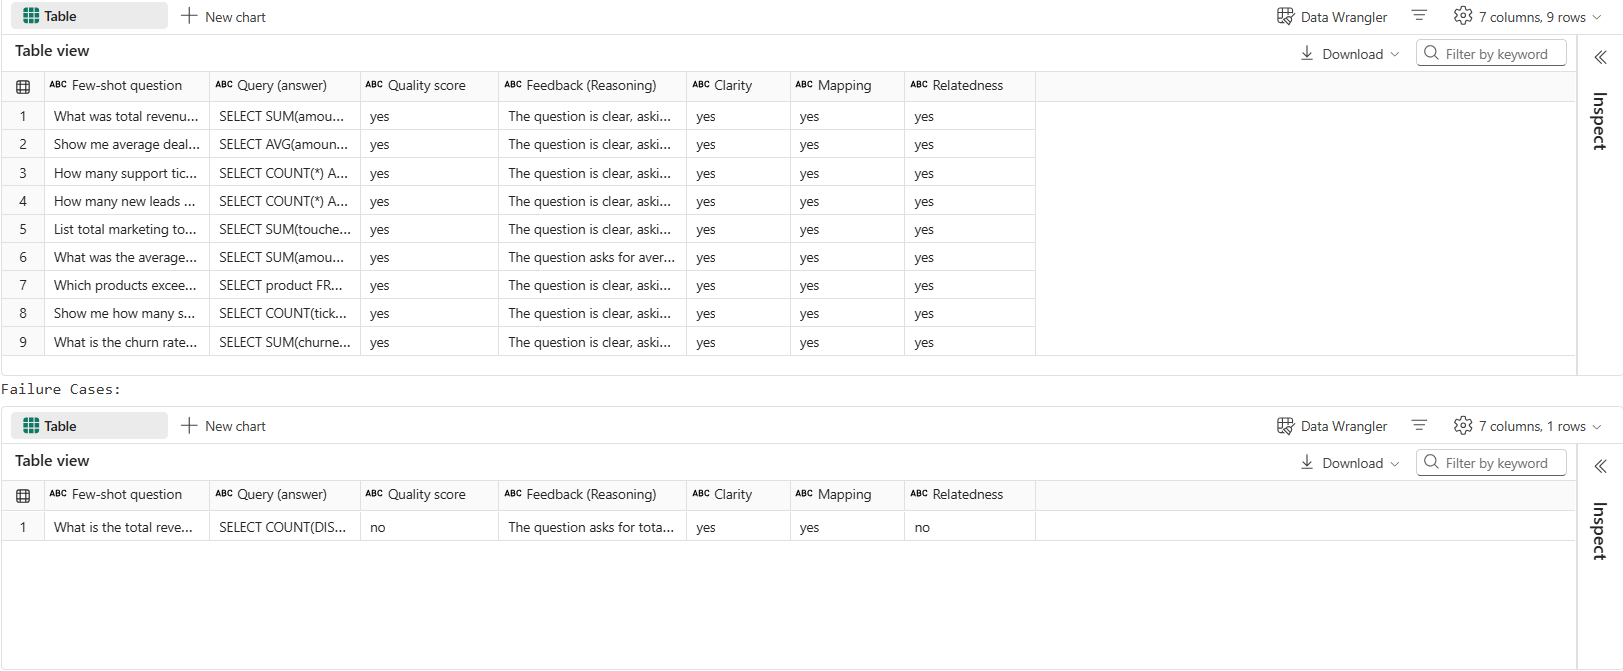
Μετά την εκτέλεση του εργαλείου επικύρωσης, θα λάβετε μια σαφή ανάλυση για το ποια παραδείγματα πέρασαν και ποια απέτυχαν. Αυτή η ανατροφοδότηση διευκολύνει τον εντοπισμό δυνατών και αδυναμιών στα λίγα παραδείγματά σας.
- Περιπτώσεις επιτυχίας: Παραδείγματα όπου η SQL ταίριαξε με τις αναμενόμενες απαντήσεις. Αυτά τα παραδείγματα είναι ισχυρές αναφορές μετά τις οποίες μπορείτε να μοντελοποιήσετε μελλοντικά παραδείγματα.
- Περιπτώσεις αποτυχίας: Παραδείγματα όπου η SQL δεν ταιριάζει με την αναμενόμενη απάντηση ή όπου το ζεύγος ερώτησης/ερωτήματος μπορεί να είναι ασαφές ή μη έγκυρο. Οι περιπτώσεις αυτές θα πρέπει να επανεξεταστούν και να βελτιωθούν.
# Access success and failure cases as pre-computed Pandas DataFrames
success_df = result.success_cases
failure_df = result.failure_cases

print("Success Cases:")
display(success_df)  # Shows examples where the SQL matched the user question

print("Failure Cases:")
display(failure_df)  # Shows examples that need review or improvement
Χρησιμοποιήστε αυτά τα σχόλια για να επαναλάβετε και να βελτιώσετε τα παραδείγματα ερωτημάτων σας. Η τακτική ενίσχυση των ασθενέστερων παραδειγμάτων θα βοηθήσει τον Data Agent να παράγει πιο ακριβή SQL και απαντήσεις με την πάροδο του χρόνου.
Για να εξερευνήσετε ένα πλήρες παράδειγμα εργασίας, μπορείτε να δείτε το δείγμα σημειωματαρίου στο αποθετήριο δεδομένων GitHub του Fabric Data Agent SDK:
Σημείωμα
Αυτό το βοηθητικό πρόγραμμα αξιολόγησης είναι προς το παρόν διαθέσιμο μόνο για παραδείγματα ερωτημάτων που βασίζονται σε SQL. Το KQL ή άλλοι τύποι ερωτημάτων δεν υποστηρίζονται ακόμα.
Εντοπισμός διενέξεων μεταξύ παραδειγμάτων ερωτημάτων
Μετά την ολοκλήρωση της επικύρωσης ποιότητας, το SDK αξιολόγησης εκτελεί αυτόματα εντοπισμό διενέξεων στα εγκεκριμένα παραδείγματα ερωτημάτων ή σε παραδείγματα λίγων λήψεων. Ο εντοπισμός διενέξεων εντοπίζει ασυνέπειες που μπορεί να προκαλέσουν την παραγωγή απρόβλεπτων ή εσφαλμένων αποτελεσμάτων από τον παράγοντα δεδομένων.
Μια διένεξη εντοπίζεται όταν δύο ή περισσότερα παραδείγματα:
- Αντιπροσωπεύουν την ίδια πρόθεση (με βάση μια κανονικοποιημένη έκδοση της ερώτησης φυσικής γλώσσας), αλλά αναφέρονται σε διαφορετικούς πίνακες ή προβολές
- Υπολογίστε την ίδια μέτρηση χρησιμοποιώντας διαφορετική λογική συνάθροισης ή διαφορετικά επίπεδα υποδιαίρεσης
- Δημιουργία ερωτημάτων SQL που θα επέστρεφαν ουσιωδώς διαφορετικά αποτελέσματα για την ίδια επιχειρηματική ερώτηση
Αυτές οι συγκρούσεις υποδηλώνουν ασάφεια ή ασυνέπεια μέσα σε λίγα παραδείγματα πλάνων. Η επίλυσή τους βοηθά στη βελτίωση του ντετερμινισμού των ερωτημάτων, της ακρίβειας και της συνολικής συμπεριφοράς των πρακτόρων.
Ελέγξτε τις λεπτομέρειες της διένεξης
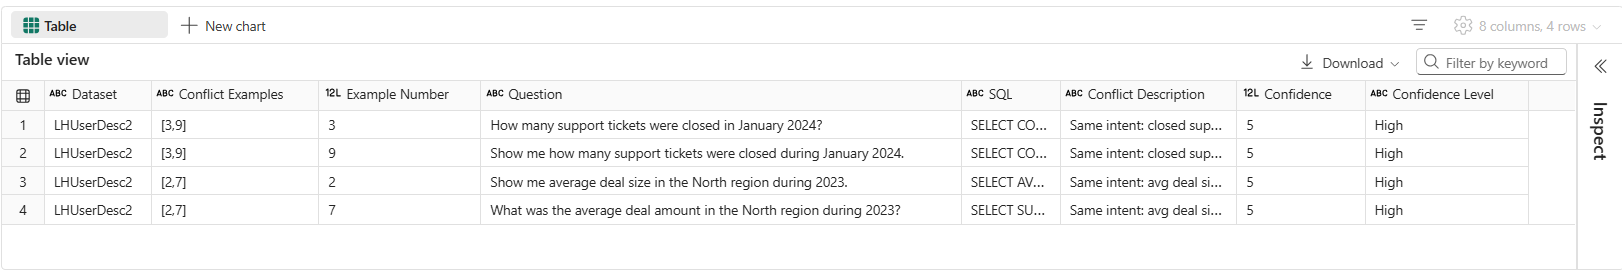
Όταν εντοπίζονται διενέξεις, το SDK επεκτείνει κάθε διένεξη σε σειρές ανά παράδειγμα, παρέχοντας λεπτομερή διαγνωστικά στοιχεία, όπως:
- Τα παραδείγματα που εμπλέκονται στη σύγκρουση
- Η ερώτηση φυσικής γλώσσας και η αντίστοιχη SQL για κάθε παράδειγμα
- Περιγραφή της σύγκρουσης που εξηγεί πώς αποκλίνουν τα παραδείγματα
- Βαθμολογία εμπιστοσύνης που υποδεικνύει την αξιοπιστία του εντοπισμού διενέξεων
Χρησιμοποιήστε αυτήν τη λεπτομερή προβολή για να κατανοήσετε ποια παραδείγματα βρίσκονται σε διένεξη και γιατί, καθώς και για να προσδιορίσετε ποια παραδείγματα πρέπει να ενημερωθούν ή να καταργηθούν.
# Display conflict summary
print(f"\nConflicts Detected: {result.conflict_count}")
print("Confidence Ratings: 5=High, 4=Medium, 3=Low, 2=Very Low, 1=Speculative\n")

# Access detailed conflict information as a pre-computed DataFrame
if result.conflict_count > 0:
    conflict_details_df = result.conflict_details
    display(conflict_details_df)
else:
    print("No conflict details to display.")
Το παρακάτω παράδειγμα δείχνει την έξοδο εντοπισμού διενέξεων, τις συσχετισμένες ερωτήσεις και την SQL, καθώς και το επίπεδο αξιοπιστίας κάθε διένεξης που εντοπίστηκε.
Κατανόηση των βαθμολογιών του επικυρωτή
Όταν εκτελείτε το εργαλείο επικύρωσης στα παραδείγματα ερωτημάτων σας, δημιουργεί τρεις βασικές βαθμολογίες για κάθε παράδειγμα: Σαφήνεια, Συνάφεια και Αντιστοίχιση. Αυτές οι βαθμολογίες προέρχονται από το πόσο καλά ευθυγραμμίζονται οι ερωτήσεις φυσικής γλώσσας και τα ερωτήματα SQL με τις βέλτιστες πρακτικές.
Διαύγεια
Μετρά εάν η ερώτηση φυσικής γλώσσας είναι σαφής και ξεκάθαρη. Οι ερωτήσεις πρέπει να είναι συγκεκριμένες, να περιλαμβάνουν τις απαραίτητες μετρήσεις, χρονοδιαγράμματα και φίλτρα και να αποφεύγουν ασαφείς ή πολλαπλές προθέσεις.Παράδειγμα – Καλό: «Συνολικά έσοδα ανά περιοχή για το 2024».
Παράδειγμα – Χρειάζεται βελτίωση: «Εμφάνιση απόδοσης».Συγγένειας
Αξιολογεί πόσο πολύ το ερώτημα SQL ταιριάζει με την πρόθεση της ερώτησης φυσικής γλώσσας. Η SQL θα πρέπει να επιστρέψει τη σωστή μέτρηση, να εφαρμόσει τα κατάλληλα φίλτρα και να ταιριάζει με την απαιτούμενη ευαισθησία.Παράδειγμα – Καλό: Μια ερώτηση ζητά τον αριθμό των πελατών τον Μάρτιο του 2025 → η SQL μετράει τους πελάτες με
WHERE month='2025-03'.
Παράδειγμα – Χρειάζεται βελτίωση: Μια ερώτηση ζητά μέτρηση, αλλά η SQL επιστρέφει SUM(έσοδα) ή φιλτράρει μια διαφορετική περίοδο.Χαρτογράφηση
Ελέγχει εάν όλες οι λεκτικές σταθερές στην ερώτηση φυσικής γλώσσας εμφανίζονται στο ερώτημα SQL. Κάθε αριθμός, ημερομηνία ή κατηγορία που αναφέρεται στην ερώτηση θα πρέπει να αντιπροσωπεύεται ρητά στην SQL.Παράδειγμα – Καλό: "Παραγγελίες άνω των 100 τον Μάρτιο του 2025 για το 'West'" → SQL περιλαμβάνει
> 100,2025-03και'West'.
Παράδειγμα – Χρειάζεται βελτίωση: Από την SQL λείπει μία από αυτές τις σταθερές (για παράδειγμα, δεν υπάρχει φίλτρο μήνα).
Ένα παράδειγμα θεωρείται υψηλής ποιότητας μόνο εάν και οι τρεις βαθμολογίες—Σαφήνεια, Συνάφεια και Χαρτογράφηση—είναι θετικές. Χρησιμοποιήστε αυτές τις βαθμολογίες για να περιορίσετε τα παραδείγματα ερωτημάτων σας: ξαναγράψτε ασαφείς ερωτήσεις, ευθυγραμμίστε την SQL πιο στενά με την πρόθεση της ερώτησης και βεβαιωθείτε ότι κάθε λεκτική σταθερά στην ερώτηση εμφανίζεται στο ερώτημα SQL. Αυτή η επαναληπτική διαδικασία βοηθά τον Data Agent να μάθει από καλύτερα μοτίβα και να παράγει πιο ακριβή αποτελέσματα.