Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Azure NetApp Files
Microsoft Fabric
Búsqueda de Azure AI
Microsoft Foundry
Azure Machine Learning
Ideas de soluciones
En este artículo se describe una idea de solución. Su arquitecto de la nube puede usar esta guía para ayudar a visualizar los componentes principales de una implementación típica de esta arquitectura. Utilice este artículo como punto de partida para diseñar una solución bien arquitectada que se alinee con los requisitos específicos de su carga de trabajo.
Esta idea de solución describe cómo la API REST de objetos de Azure NetApp Files ayuda a las organizaciones a usar datos de archivos empresariales existentes para análisis e inteligencia artificial sin copiarlos primero en un almacén de objetos independiente. Las aplicaciones compatibles con S3 de Amazon pueden permitir la búsqueda de documentos y el análisis asistido por IA, mientras que los flujos de trabajo NFS y SMB existentes siguen accediendo a esos datos. Evitar una copia independiente de los datos de origen puede reducir el tiempo necesario para poner en marcha cargas de trabajo analíticas, reducir los costes de almacenamiento duplicado y eliminar las canalizaciones de sincronización que, de otro modo, los equipos tendrían que crear, supervisar y mantener. Menos repositorios de datos de origen también significan menos copias para controlar y proteger. Este enfoque admite la modernización incremental sin necesidad de que las organizaciones reemplacen sus aplicaciones basadas en archivos existentes.
Architecture
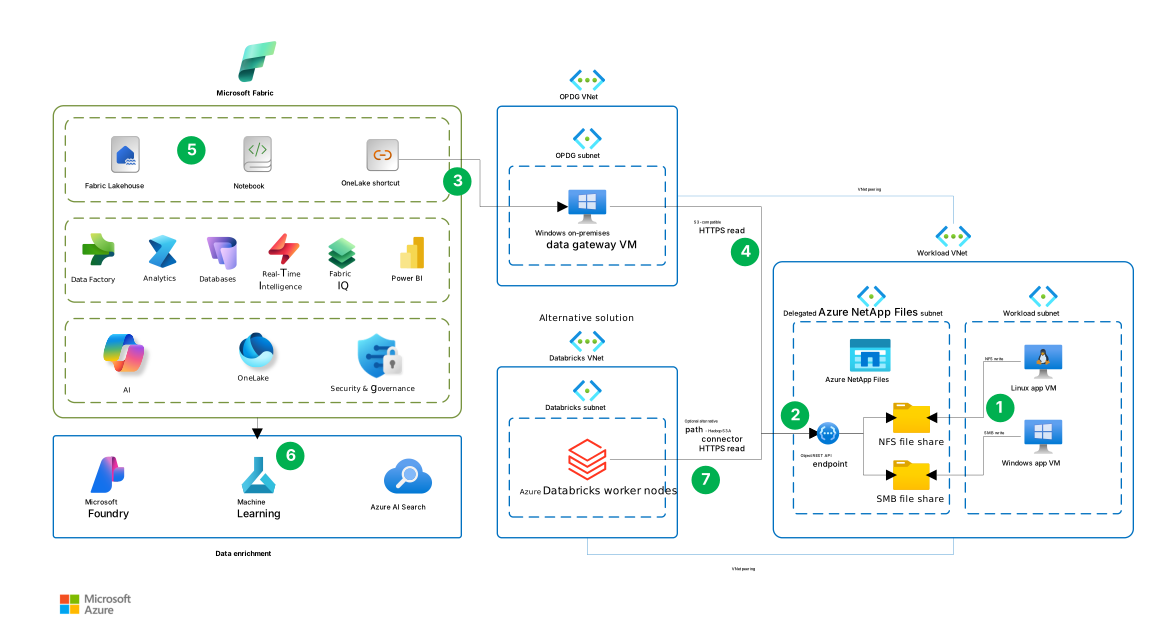
Esta arquitectura se centra en la integración de Microsoft Fabric con Azure NetApp Files a través de la API REST de objetos. El diagrama también muestra Azure Databricks como consumidor de análisis alternativo de los mismos datos de Azure NetApp Files. No es necesario implementar ambas plataformas. Las aplicaciones existentes siguen accediendo a los datos a través de NFS o SMB, en función de la configuración del volumen y los requisitos de cliente.
El proceso de cómputo de Azure Databricks accede al punto de conexión de la API REST de Azure NetApp Files Object a través de solicitudes compatibles con S3 mediante el conector S3A de Hadoop. Esta ruta alternativa de análisis no utiliza la puerta de enlace de datos local ni Microsoft OneLake.
Los servicios de IA posteriores que aparecen en el diagrama son meramente ilustrativos. No se muestra su integración de ingesta.
Descargue un archivo de Visio de esta arquitectura.
Flujo de datos
Las siguientes interacciones numeradas describen el diagrama de arquitectura. Los pasos del 1 al 5 describen la ruta de acceso de Microsoft Fabric principal. El paso 6 representa el enriquecimiento de datos posterior opcional. El paso 7 es una ruta de acceso de análisis alternativa, no una continuación del flujo de Fabric. Las flechas etiquetadas como Lectura HTTPS muestran las solicitudes dirigidas al punto de conexión de la API REST de objetos; los datos solicitados se devuelven al consumidor.
Las aplicaciones escriben datos de archivo. En la subred Carga de trabajo, la máquina virtual de la aplicación Linux escribe en el recurso compartido de archivos NFS y la máquina virtual de aplicación Windows escribe en el recurso compartido de archivos SMB. Azure NetApp Files hospeda ambos recursos compartidos en la subred delegada.
La API REST de Object expone los datos del archivo. El punto de conexión de la subred ANF delegada proporciona acceso compatible con S3 a directorios configurados en los volúmenes de Azure NetApp Files. Las conexiones del punto de conexión a los recursos compartidos NFS y SMB representan el acceso a los datos existentes, no una copia en un almacén de objetos independiente.
Fabric accede a los datos a través de un shortcut de OneLake. El acceso directo hace referencia a los datos de Azure NetApp Files a través de una conexión que utiliza la máquina virtual de la puerta de enlace de datos local de Windows en la subred OPDG (puerta de enlace de datos local). El acceso directo de OneLake está conectado a esta puerta de enlace.
La puerta de enlace lee desde la API REST de objetos. La puerta de enlace usa el emparejamiento entre la red virtual OPDG y la red virtual de carga de trabajo para llegar al punto de conexión. La ruta de acceso de lectura https compatible con S3 conecta la puerta de enlace al punto de conexión, que accede a los datos de archivo a los que se hace referencia para Fabric. Para conocer los requisitos de conexión, consulte Conectar OneLake a un volumen de Azure NetApp Files.
Fabric procesa y analiza los datos. Las cargas de trabajo de Fabric compatibles consumen los datos a través del acceso directo. Por ejemplo, los cuadernos leen los archivos a los que se hace referencia y escriben los resultados derivados en tablas lakehouse para el análisis y los informes de Power BI. En el cuadro Fabric del diagrama se muestran estas funcionalidades de procesamiento y análisis.
Los servicios posteriores opcionales enriquecen los datos. La flecha debajo de Fabric conduce al grupo de enriquecimiento de datos, que contiene Microsoft Foundry, Azure Machine Learning y Búsqueda de Azure AI. Este paso representa el procesamiento posterior opcional. El diagrama no muestra la ingesta o la orquestación necesarias para conectar estos servicios, y el shortcut de OneLake no establece esas integraciones.
Como alternativa, Azure Databricks lee directamente los datos del archivo. Los nodos de trabajo de la subred de Databricks usan el conector de Hadoop S3A para enviar solicitudes de lectura HTTPS al mismo punto de conexión de la API REST de objetos a través de las redes virtuales emparejadas. Esta ruta sustituye a la ruta de acceso y procesamiento de Fabric de los pasos 3 a 5. No pasa por la puerta de enlace de datos local ni por OneLake.
Elija la ubicación del acceso directo en función de cómo desea consumir los datos:
- Tablas Delta compatibles existentes. Cree un acceso directo de tabla en la sección Tablas de lakehouse, que tiene como destino la tabla Delta completa, incluido su registro de transacciones. Fabric reconoce el destino como una tabla que se puede consultar a través de Spark y el punto de conexión de análisis SQL, mientras que los datos de origen permanecen en Azure NetApp Files.
- Archivos para el acceso directo o el procesamiento. Cree accesos directos en la sección Archivos del lakehouse. Las cargas de trabajo compatibles pueden leer archivos Parquet, CSV y JSON independientes, además de documentos, sin copiar primero los archivos de origen a OneLake. Cuando los análisis posteriores requieren tablas de lakehouse, transforme o cargue los datos de origen en tablas delta derivadas en OneLake.
Los archivos Parquet independientes no se convierten automáticamente en tablas Delta. Un acceso directo en Archivos no registra automáticamente su destino como una tabla. Para obtener más información, consulte Dónde colocar accesos directos en una instancia de LakeHouse.
Components
Los siguientes componentes admiten la arquitectura centrada en Fabric y la alternativa opcional Azure Databricks.
Azure NetApp Files es un servicio de almacenamiento de archivos totalmente administrado basado en la tecnología NetApp. En esta arquitectura, almacena el conjunto de datos empresarial y proporciona acceso a objetos compatible con NFS, SMB y S3 a través de la API REST de objetos. También proporciona capacidades de instantáneas y replicación.
Azure NetApp Files API REST de objetos expone los datos de archivo existentes a través de una interfaz compatible con S3. En esta arquitectura, permite que las aplicaciones de análisis e inteligencia artificial compatibles accedan a los datos sin crear primero una copia independiente de almacenamiento de objetos. La interfaz admite un subconjunto de operaciones de Amazon S3. Confirme que las operaciones admitidas cumplen los requisitos de la aplicación antes de elegir esta integración.
Microsoft Fabric es una plataforma de análisis que unifica el movimiento de datos, el procesamiento de datos, la ingesta, la transformación, el procesamiento de flujos a través de Real-Time Intelligence y la creación de informes. En esta arquitectura, proporciona la plataforma de análisis para procesar y analizar datos de Azure NetApp Files a través de accesos directos de OneLake.
OneLake es el lago de datos lógico unificado para Fabric. En esta arquitectura, los accesos directos de OneLake ponen los datos referenciados de Azure NetApp Files a disposición de las cargas de trabajo de Fabric compatibles.
Azure Virtual Network proporciona conectividad privada entre los recursos de Azure en esta arquitectura. El emparejamiento de redes virtuales permite que la máquina virtual de la puerta de enlace y el recurso de proceso opcional de Azure Databricks accedan al punto de conexión de la API REST de objetos de Azure NetApp Files.
Una puerta de enlace de datos local conecta los accesos directos de OneLake al punto de conexión del depósito de Azure NetApp Files. A pesar de su nombre, en esta arquitectura, el gateway se ejecuta en modo estándar en una máquina virtual de Azure con un sistema operativo Windows compatible. Elija una imagen que cumpla los requisitos de instalación de la puerta de enlace. No se admiten las instalaciones de Server Core ni los contenedores de Windows. La puerta de enlace inicia conexiones salientes a través de Azure Relay para comunicarse con Fabric. No se requieren conexiones entrantes de Fabric. Configure el cortafuegos o el proxy para permitir los puntos de conexión salientes descritos en Ajustar la configuración de comunicación de la puerta de enlace de datos local.
Azure Databricks es una plataforma de análisis alternativa opcional para cargas de trabajo de ingeniería de datos y aprendizaje automático. Sus trabajos de Spark usan el conector Hadoop S3A configurado para el punto de conexión de la API REST de objetos para acceder al conjunto de datos de Azure NetApp Files en lugar de usar la ruta de integración de Fabric.
Alternatives
Esta arquitectura incluye varios componentes que puede sustituir por otros servicios o enfoques de Azure, en función de los requisitos funcionales y no funcionales de la carga de trabajo. Considere las siguientes alternativas y sus ventajas e inconvenientes.
Storage
Tenga en cuenta los requisitos de protocolo de las aplicaciones y el rendimiento medido al elegir entre Azure Blob Storage y Azure NetApp Files:
Elija Blob Storage cuando los clientes puedan usar la API REST de Blob Storage o NFS 3.0 y no requieran SMB ni NFS 4.1. Ambas interfaces pueden acceder a los mismos datos. La ruta de acceso de NFS 3.0 de Blob Storage está optimizada para cargas de trabajo secuenciales de alto rendimiento y con mucha lectura, donde el rendimiento es más importante que una latencia baja.
Elija Azure NetApp Files cuando las aplicaciones y las cargas de trabajo de análisis necesiten acceder a los mismos archivos a través de SMB o NFS 4.1 y la API REST de objetos compatibles con S3, o cuando las aplicaciones de archivos requieren E/S aleatorias de baja latencia. Para los datos que ya están en Azure NetApp Files, la API REST de objetos agrega acceso de análisis sin migrar aplicaciones o datos de origen.
Para cualquiera de las dos opciones, mida la latencia de un extremo a otro y el rendimiento bajo carga simultánea de la aplicación de origen y de analítica. El rendimiento de NFS o SMB no determina el rendimiento de la API REST de objetos ni el de Fabric, por lo que se debe comprobar la ruta de acceso prevista en función de los requisitos de la carga de trabajo. Compare los costos totales, incluidos los cambios de aplicación, la migración y cualquier duplicación y sincronización en curso. Para obtener una comparación de protocolos y cargas de trabajo, consulte Comparación de los servicios de almacenamiento de Azure.
Integration
Los trabajos de Azure Databricks pueden utilizar el conector Hadoop S3A para leer datos de Azure NetApp Files a través de la API REST de objetos, sin necesidad de OneLake ni de la puerta de enlace de datos local. Configure la confianza TLS y las credenciales almacenadas de forma segura, y valide las operaciones de escritura necesarias antes de recurrir a la escritura diferida. Si necesita scripts de inicialización, use scripts con ámbito de clúster almacenados en volúmenes de Unity Catalog en la computación compatible, siguiendo las instrucciones actuales de Azure Databricks para scripts de inicialización.
Detalles del escenario
Use este patrón cuando el mismo conjunto de datos debe atender aplicaciones que esperan un sistema de archivos montado y servicios de análisis o inteligencia artificial que esperan una interfaz de objeto compatible con S3.
Las aplicaciones que se ejecutan en máquinas virtuales o en contenedores pueden seguir usando Azure NetApp Files a través de NFS o SMB. Por ejemplo, pueden usar código de acceso a archivos existente, recursos compartidos montados y estructuras de directorio. La API REST de objetos de Azure NetApp Files asigna el directorio raíz de un volumen o un subdirectorio a un depósito compatible con S3, de modo que los clientes de objetos compatibles puedan acceder a los mismos archivos subyacentes.
Este enfoque es útil cuando desea agregar funcionalidades de análisis o inteligencia artificial a las cargas de trabajo basadas en archivos existentes sin cambiar las aplicaciones de origen para usar el almacenamiento de objetos. Los flujos de trabajo posteriores pueden seguir creando datos derivados, como conjuntos de datos transformados, índices, incrustaciones y cachés, según sea necesario.
Cuando los clientes de archivos y objetos acceden a los mismos datos, tenga en cuenta las diferencias en identidad, permisos, bloqueo y requisitos de coherencia de la aplicación. Defina cómo los productores indican que un archivo o un lote está completo antes de que los consumidores de objetos lo procesen. Los productores deben terminar de escribir y cerrar archivos antes de indicar que están listos y dejar esos archivos sin cambios mientras los consumidores los procesan. Pruebe este traspaso para detectar escrituras interrumpidas y reintentos de procesamiento.
Los modelos de identidad y autorización también difieren entre los métodos de acceso. Los permisos de archivo por usuario originales no se llevan automáticamente a Fabric. Configure los permisos de Fabric para los consumidores previstos y asegúrese de que la identidad usada por la API REST de objetos solo tiene acceso a los datos de origen necesarios. Para obtener más información, consulte Seguridad.
Asigne directorios a buckets independientes cuando los consumidores requieran diferentes niveles de acceso. La clasificación de datos, la retención, la autorización posterior y la gobernanza de los datos derivados siguen siendo responsabilidades de la carga de trabajo. Para obtener más información, consulte Crear un bucket.
Posibles casos de uso
Esta arquitectura puede admitir cargas de trabajo que necesitan analizar datos estructurados o no estructurados ya almacenados en Azure NetApp Files. En los ejemplos siguientes se muestran diferentes formas en que Fabric puede consumir esos datos.
Procesamiento de documentos
Las aplicaciones pueden guardar documentos, imágenes u otros archivos no estructurados en Azure NetApp Files mediante NFS o SMB. Un cuaderno de Fabric puede leer archivos completados mediante un acceso directo de OneLake y enviar su contenido a un servicio de procesamiento de documentos, como Azure Document Intelligence, para su extracción. Almacene los datos estructurados resultantes en tablas de lakehouse para la validación, el análisis y los informes.
Para obtener instrucciones de integración, consulte Integración de Document Intelligence a través de SynapseML.
Análisis de datos
Las aplicaciones pueden escribir datos estructurados, como archivos CSV o Parquet, en un recurso compartido de Azure NetApp Files. Los cuadernos de Fabric pueden leer archivos completados mediante el acceso directo de OneLake, combinarlos con otros datos del lakehouse y escribir los resultados derivados en tablas del lakehouse.
Este patrón puede admitir escenarios como ingeniería y análisis de calidad, análisis de datos de sensor y informes operativos sin necesidad de que las aplicaciones de origen cambien cómo almacenan sus archivos.
En el caso de los conjuntos de datos delta compatibles existentes, cree un acceso directo de OneLake en la sección Tablas de lakehouse que tenga como destino la tabla Delta completa, incluido su registro de transacciones. Fabric puede reconocer el destino como una tabla y los datos de origen pueden permanecer en Azure NetApp Files. Para obtener más información, consulte Dónde colocar accesos directos en una instancia de LakeHouse.
Búsqueda y recuperación con IA
Los documentos almacenados en Azure NetApp Files también pueden servir como contenido de origen para cargas de trabajo de IA. Por ejemplo, un flujo de trabajo de procesamiento puede leer documentos a través del acceso directo de OneLake y utilizarlos para crear un índice de Búsqueda de Azure AI destinado a la generación aumentada por recuperación (RAG).
El índice de búsqueda y las incrustaciones son datos derivados y se almacenan por separado de los archivos de origen. Diseñe el flujo de trabajo para mantener el contenido indexado sincronizado con las actualizaciones de origen, los cambios de nombre y las eliminaciones. Aplique también los controles de acceso adecuados al recuperar contenido indizado porque los permisos SMB y NFS originales no se convierten automáticamente en permisos de búsqueda por usuario.
Este mismo patrón puede ampliarse a otras cargas de trabajo de IA. Por ejemplo, los cuadernos de Fabric pueden preparar conjuntos de datos a partir de archivos de origen y almacenar los datos preparados en OneLake para su consumo por Azure Machine Learning. Para conocer las opciones y limitaciones de integración, consulte Integrar OneLake con Azure Machine Learning.
Considerations
Estas consideraciones implementan los pilares del Azure Well-Architected Framework, que es un conjunto de principios rectores que puede utilizar para mejorar la calidad de una carga de trabajo. Para obtener más información, consulte Well-Architected Framework. Para obtener más orientación, consulte las recomendaciones de Well-Architected Framework para Azure NetApp Files.
Reliability
La confiabilidad ayuda a garantizar que la aplicación pueda cumplir los compromisos que realice para sus clientes. Para obtener más información, vea Lista de verificación para la revisión del diseño en términos de confiabilidad.
Azure NetApp Files se ejecuta sobre una infraestructura bare metal tolerante a errores basada en ONTAP y proporciona un SLA de alta disponibilidad. Para una protección adicional frente a interrupciones regionales o de zona de disponibilidad, puede configurar opcionalmente la replicación entre zonas o entre regiones. Esta replicación es asincrónica y requiere que el cliente inicie la conmutación por error hacia el volumen de destino. Elija la opción de replicación y la programación según los objetivos de recuperación de la carga de trabajo. Para obtener más información, consulte fiabilidad de Azure NetApp Files.
El uso compartido de un conjunto de datos también hace que la disponibilidad del almacenamiento sea una dependencia común para las aplicaciones basadas en archivos y el análisis. Estas capacidades de almacenamiento no garantizan la disponibilidad de extremo a extremo para la puerta de enlace, la canalización de indexación ni las aplicaciones consumidoras. Alinee los objetivos de recuperación con la carga de trabajo completa, incluyendo la puerta de enlace, el procesamiento posterior y los datos derivados.
Una sola máquina virtual de puerta de enlace es un punto único de fallo para la ruta de acceso de integración de Fabric. Para cargas de trabajo críticas para el negocio, implemente al menos dos miembros de la puerta de enlace en máquinas virtuales independientes dentro de un clúster de puertas de enlace. Asegúrese de que todos los miembros puedan acceder al punto de conexión de la API REST Object y establezcan las conexiones salientes necesarias. Pruebe el comportamiento de la carga de trabajo cuando un miembro del gateway deja de estar disponible.
- La recuperación de archivos y volúmenes se admite a través de instantáneas puntuales con uso eficiente del espacio. Los equipos pueden restaurar un archivo individual, revertir un volumen completo o crear un nuevo volumen a partir de un punto de recuperación después de la eliminación accidental, la corrupción o un proceso de análisis con errores. Para ver las operaciones de recuperación disponibles, consulte protección de datos basada en instantáneas de Azure NetApp Files.
Seguridad
La seguridad proporciona garantías contra ataques deliberados y el uso indebido de sus valiosos datos y sistemas. Para obtener más información, consulte Lista de comprobación para la revisión del diseño de seguridad.
Mantener menos copias de datos de origen puede reducir el número de repositorios que se van a proteger. Azure NetApp Files cifra los datos en reposo y la API REST de objetos usa TLS para proteger los datos en tránsito. Los permisos de acceso a archivos dependen del protocolo:
Los clientes SMB y NFS siguen usando sus modelos de autenticación y autorización existentes. Las listas de control de acceso NTFS existentes (ACL), los permisos NFS y las reglas de asignación de identidades permanecen vigentes para esos clientes.
Los clientes de api REST de objetos se autentican mediante una clave de acceso S3. Los permisos del bucket definen si el cliente tiene acceso de solo lectura o de lectura y escritura en el directorio asignado. Las solicitudes de objetos no incluyen la identidad del usuario individual de SMB, NFS o del usuario posterior. Azure NetApp Files realiza todas las operaciones de objetos como la identidad del sistema de archivos suplantada y configurada del depósito. Los permisos de archivo y las ACL existentes solo se evalúan con respecto a esa identidad.
La identidad del sistema de archivos suplantada es un identificador de usuario (UID) y un identificador de grupo (GID) para volúmenes NFS o una cuenta de usuario para volúmenes SMB. Los volúmenes de doble protocolo usan el tipo de identidad que se corresponde con el estilo de seguridad configurado. Esta identidad determina los permisos de acceso a archivos. La clave de acceso S3 autentica al cliente de objeto. Para obtener más información, consulte Seguridad y permisos de la API REST de objetos.
Un acceso directo de OneLake compatible con S3 se autentica en el depósito mediante un ID de clave de acceso y una clave de acceso secreta. Las ACL de NTFS de origen, los permisos NFS y las identidades individuales de los propietarios de los archivos no se copian ni se asignan a OneLake. Los usuarios de Fabric están autorizados a través de los permisos de OneLake y Fabric. Solo pueden acceder al contenido expuesto al acceso directo a través del depósito y su identidad suplantada, pero OneLake no aplica los permisos de archivo originales por usuario. no se admiten OAuth, entidades de servicio ni RoleArn basadas en Microsoft Entra para este tipo de shortcut.
Por ejemplo, un usuario de Fabric podría leer un documento mediante el acceso directo incluso cuando su cuenta SMB personal no pueda leerlo directamente, siempre que los permisos de Fabric permitan el acceso y la identidad suplantada del depósito pueda leer el documento. Antes de poner un directorio a disposición, compruebe que el público objetivo de Fabric esté autorizado para acceder a su contenido.
Configure la identidad suplantada del bucket con únicamente los permisos de origen que requiera la carga de trabajo. Restringe el acceso al acceso directo y a Lakehouse. Use el flujo de trabajo de certificados basado en Azure Key Vault y el almacenamiento de credenciales para administrar certificados TLS y claves de acceso de S3. Defina y pruebe un procedimiento de rotación para coordinar los cambios de certificado y credenciales con actualizaciones de conexiones de Fabric y otros consumidores. La generación de nuevas credenciales del bucket invalida inmediatamente el par existente, así que prevea posibles interrupciones mientras actualiza los clientes y verifica el acceso después de la rotación.
Si usa un certificado TLS autofirmado, asegúrese de que cada host de puerta de enlace confía en él. Para más información, consulte Requisitos previos de la puerta de enlace de OneLake.
La seguridad y el cumplimiento normativo dependen de la configuración del almacenamiento, el acceso y los servicios posteriores. Incluya el procesamiento posterior y los datos derivados en el ámbito de gobernanza y cumplimiento. Requisitos como el RGPD y la HIPAA se aplican a toda la carga de trabajo, cuando corresponda. Para obtener más información, consulte Seguridad y permisos de la API REST de objetos y Creación de un acceso directo compatible con Amazon S3 en OneLake.
Optimización de costos
La optimización de costos se centra en formas de reducir los gastos innecesarios y mejorar las eficiencias operativas. Para obtener más información, consulte Lista de comprobación de revisión de diseño para la optimización de costes.
Evitar una copia de datos de origen independiente puede reducir los costos de sincronización y almacenamiento duplicados. Compare estos ahorros con los costes de capacidad y rendimiento de Azure NetApp Files, la proceso de la puerta de enlace, la capacidad de Fabric y el procesamiento y almacenamiento posteriores.
Esta estimación de precios de ejemplo incluye un grupo de capacidad estándar de 1 TiB Azure NetApp Files, una máquina virtual de Windows D8s_v5 para la puerta de enlace de datos local, dos discos administrados 128-GiB P10, una puerta de enlace NAT con una dirección IP pública y procesamiento de datos salientes, Fabric capacidad F2 y 100 GB de almacenamiento nativo de OneLake.
La configuración con una sola puerta de enlace no ofrece alta disponibilidad. Se excluyen los costes opcionales de AI Search, servicios de incrustación y Azure Databricks. Ajuste los recursos para los requisitos de capacidad, redes y disponibilidad de la carga de trabajo.
Acceso Cool: Clasifique los bloques de datos inactivos, incluidos los datos de instantáneas, en un almacenamiento de menor coste, al tiempo que se mantiene el acceso a archivos y objetos. Evalúe los cargos de recuperación, la latencia y los cambios de rendimiento específicos del nivel de servicio con respecto al patrón de acceso de la carga de trabajo.
Niveles de servicio y ajuste de tamaño correcto: Elija un nivel de servicio Azure NetApp Files que coincida con los requisitos de capacidad y rendimiento del conjunto de datos. El nivel de servicio flexible permite aprovisionar la capacidad del grupo y el rendimiento de forma independiente. Revise la capacidad y la capacidad de procesamiento del pool facturable a medida que cambie la demanda para evitar el sobreaprovisionamiento persistente.
Excelencia operativa
La excelencia operativa abarca los procesos de las operaciones que implementan una aplicación y la mantienen en ejecución en producción. Para obtener más información, consulte la Lista de comprobación de revisión de diseño para la excelencia operativa.
Los atajos de OneLake reducen la complejidad operativa al evitar un canal que mantenga una copia separada de los datos de origen para el análisis. Sin un flujo de copia independiente, los equipos no necesitan programar trabajos de copia, recuperarse de fallos de transferencia ni conciliar los datos de origen y los datos copiados como parte de las operaciones rutinarias.
Los equipos de la aplicación de origen y de análisis deben coordinar los cambios y la respuesta ante incidentes para el conjunto de datos compartido de Azure NetApp Files. Establezca la responsabilidad en materia de supervisión, fallos de procesamiento y administración de credenciales y certificados de la API REST de objetos.
Supervise el rendimiento de almacenamiento, gateway y Fabric para identificar restricciones y ajustar la capacidad o la tasa de transferencia:
Utilice Azure Monitor para realizar un seguimiento del rendimiento de lectura y escritura del volumen, las IOPS de lectura y escritura, otras IOPS, la latencia media de lectura y escritura, el consumo de capacidad y el indicador de límite de rendimiento alcanzado. Esté atento a los aumentos sostenidos de la latencia, a las limitaciones repetidas de la calidad de servicio (QoS) y a los umbrales de capacidad, en lugar de a picos aislados; las métricas de Azure NetApp Files se agregan por intervalos y la latencia del almacenamiento no incluye todos los componentes REST del lado del cliente.
Correlacionar las métricas de almacenamiento con mediciones del lado del cliente, como los percentiles de latencia de las solicitudes, el tamaño de los objetos, la concurrencia, los reintentos, los códigos de estado HTTP, la CPU, la memoria y el rendimiento de la red. De este modo, se distingue entre un límite de rendimiento del volumen y un cliente de proceso con recursos insuficientes, una configuración ineficiente del SDK, la sobrecarga de objetos pequeños o la distancia de red.
Supervise la CPU, la memoria, el espacio en disco disponible y el rendimiento de red de cada máquina virtual de puerta de enlace junto con los errores de puerta de enlace y los tiempos de finalización de la carga de trabajo. Configure alertas para una presión de recursos sostenida y poco espacio en disco, mediante umbrales establecidos durante las pruebas representativas de carga de trabajo. Utilice los registros de diagnóstico de la puerta de enlace al solucionar errores o accesos lentos. Supervise la máquina virtual y la red por separado porque los diagnósticos de gateway no proporcionan una cobertura completa de la infraestructura.
Supervise la utilización de la capacidad de Fabric y la limitación del ancho de banda con la aplicación Fabric Capacity Metrics. Configure las notificaciones de uso de capacidad para los administradores responsables. Correlacione el uso de la capacidad con las mediciones de la puerta de enlace y del almacenamiento para identificar si los retrasos se originan en el acceso al origen o en el procesamiento de Fabric antes de modificar la capacidad.
Eficiencia en el rendimiento
La eficiencia del rendimiento hace referencia a la capacidad de escalado de la carga de trabajo para satisfacer las demandas de los usuarios de forma eficaz. Para obtener más información, consulte Lista de comprobación de revisión de diseño para la eficiencia del rendimiento.
Azure NetApp Files puede admitir tanto aplicaciones NFS o SMB sensibles a la latencia como clientes de análisis o IA compatibles con S3 utilizando el mismo conjunto de datos. Mantener los datos de origen en un único volumen puede eliminar la etapa de copia que, de otro modo, retrasaría la indexación, el entrenamiento o el procesamiento por lotes y consumiría ancho de banda del cliente, de la red y del almacenamiento de destino.
La latencia de almacenamiento inferior al milisegundo en los niveles de servicio compatibles de Azure NetApp Files es especialmente relevante para las cargas de trabajo de NFS y SMB. No garantiza la latencia de extremo a extremo para las solicitudes a la API REST de objetos mediante HTTPS. Realice pruebas de rendimiento de la ruta de acceso compatible con S3 con objetos representativos y concurrencia antes de establecer un objetivo de latencia.
Dimensionamiento del almacenamiento: Determina el rendimiento en función de la demanda combinada de las aplicaciones de archivos y los consumidores de objetos. QoS automático vincula el rendimiento del volumen a la cuota de volumen. La QoS manual permite una asignación independiente dentro del presupuesto de rendimiento del grupo.. Realiza pruebas de rendimiento con cargas de trabajo representativas antes de ajustar el rendimiento.
Dimensionamiento de la puerta de enlace: Dimensione las máquinas virtuales de la puerta de enlace en función de la demanda combinada de las cargas de trabajo que acceden a Azure NetApp Files a través de accesos directos de OneLake. Utiliza las directrices de dimensionamiento y escalado de la pasarela como punto de partida. Valida el dimensionamiento con volúmenes de datos representativos y acceso simultáneo a través de los accesos directos. Mida la CPU, la memoria y el rendimiento de la red de la puerta de enlace, además de los tiempos de finalización de las cargas de trabajo, para determinar si se deben aumentar los recursos de la máquina virtual o añadir miembros a la puerta de enlace.
Dimensionamiento de la capacidad de Fabric: Dimensione la capacidad de Fabric para la carga de trabajo combinada de procesamiento e informes, incluida Power BI. Siga las instrucciones de la guía de planeamiento de capacidad de Fabric para calcular la capacidad inicial, probar con un piloto representativo y ajustar la capacidad en función del uso medido y la limitación de tasa.
Coloque los recursos de cómputo cerca del volumen, dimensione adecuadamente la red del cliente y pruebe con la carga de trabajo real. Aumente el paralelismo y use solicitudes suficientemente grandes para el análisis secuencial, pero limite la simultaneidad cuando aumente la latencia o los errores. Para NFS o SMB, valide la configuración de montaje, protocolo y aplicación. Para REST, compruebe la compatibilidad con las operaciones de API necesarias del cliente y pruebe la reutilización de la conexión, el comportamiento de carga, los reintentos y el listado de objetos.
Valida el rendimiento y la latencia de extremo a extremo bajo carga simultánea, y equilibra la demanda de análisis con los requisitos de rendimiento de la aplicación de origen.
Contributors
Microsoft mantiene este artículo. Los siguientes colaboradores escribieron este artículo.
Autores principales:
- Dan Jackson | Arquitecto de soluciones en la nube, NetApp
- Anthony Mashford | Arquitecto de soluciones en la nube, NetApp
- Daniel Söderholm | Ingeniero sénior de soluciones, Plataformas de nube y inteligencia artificial, Microsoft
Otros colaboradores:
- Heather Grandy | Ingeniera sénior de soluciones, plataformas de datos, Microsoft
Para ver los perfiles no públicos de LinkedIn, inicie sesión en LinkedIn.
Pasos siguientes
- Introducción a la API REST de objetos para Azure NetApp Files
- Conectar OneLake a un volumen de Azure NetApp Files
- Scripts de inicialización en Azure Databricks
- Integración de OneLake con Azure Machine Learning