Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Se aplica a: Azure SQL Database
Sin servidor es un nivel de procesamiento para bases de datos individuales en Azure SQL Database que ajusta automáticamente la computación según la demanda de carga de trabajo y cobra por la cantidad de computación usada por segundo. El nivel de proceso sin servidor también detiene automáticamente las bases de datos durante períodos inactivos cuando solo se factura el almacenamiento y reanuda automáticamente las bases de datos cuando finaliza la actividad. El nivel de proceso sin servidor está disponible en el nivel de servicio De uso general y en el nivel de servicio Hiperescala.
Información general
Un intervalo de escalado automático de proceso y un retraso de pausa automática son parámetros importantes para el nivel de proceso sin servidor. La configuración de estos parámetros da forma a la experiencia de rendimiento de la base de datos y el costo de proceso.
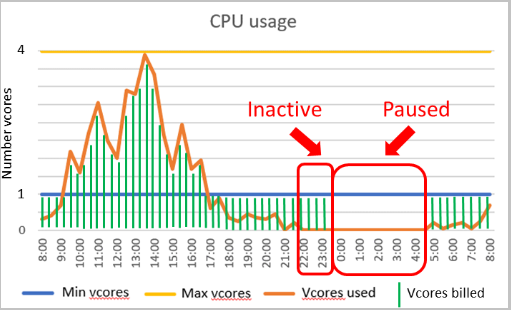 Diagrama que indica cuándo la facturación sin servidor dejará de incurrir en cargos por cálculo debido a la inactividad.
Configuración del rendimiento
- Los valores mínimos de núcleos virtuales y los valores máximos de núcleos virtuales son parámetros configurables que definen el intervalo de capacidad de proceso disponible para la base de datos. Los límites de memoria y E/S son proporcionales al intervalo de vCores especificado.
- El retardo de pausa automática es un parámetro configurable que define el periodo de tiempo que la base de datos debe estar inactiva antes de que se pause automáticamente. La base de datos se reanuda automáticamente cuando se produce el siguiente inicio de sesión u otra actividad. Alternativamente, puedes desactivar la pausa automática. Para más información, consulta Pausa automática y reanudación automática en la capa de computación sin servidor para Azure SQL Database.
Configuración predeterminada
En la siguiente tabla se muestran los valores disponibles para estos parámetros.
| Parámetro | Opciones de valores | Valor predeterminado |
|---|---|---|
| Mínimo de núcleos virtuales | Depende del número máximo de núcleos virtuales configurados, consulte los límites de recursos. | 0,5 núcleos virtuales |
| Retraso de pausa automática de uso general | Mínimo: 15 minutos Máximo: 10 080 minutos (siete días) Incrementos: 1 minuto Deshabilitar la pausa automática: -1 |
60 minutos |
| Tiempo de espera de la pausa automática para Hyperscale | Mínimo: 60 minutos Máximo: 10 080 minutos (siete días) Incrementos: 1 minuto Deshabilitar la pausa automática: -1 |
60 minutos |
Coste
El coste de una base de datos sin servidor es la suma del coste de cómputo y el coste de almacenamiento. El coste de almacenamiento se determina de la misma manera que el nivel de proceso aprovisionado.
- Cuando el uso de cómputo está entre los límites mínimo y máximo que configuras, el coste de cómputo se basa en vCore y memoria utilizada.
- Cuando el uso de cómputo está por debajo de los límites mínimos que configuras, el coste de cómputo se basa en los vCore y la memoria mínima configurados.
- Cuando se pausa la base de datos, el coste de proceso es cero y solo se incurre en costes de almacenamiento.
Para obtener más información sobre los costes, véase Facturación y escenarios de costes del nivel de proceso sin servidor.
Escenarios
Este nivel de proceso sin servidor ofrece una relación entre precio y rendimiento optimizada para bases de datos únicas con patrones de uso intermitentes e impredecibles, que pueden permitirse alguna demora en el calentamiento de los recursos de proceso después de períodos de inactividad. En cambio, el nivel de proceso aprovisionado está optimizado en términos de relación precio-rendimiento para bases de datos individuales o varias bases de datos en grupos elásticos con un uso medio más elevado y que no pueden permitirse ningún retraso en el arranque del proceso.
Escenarios adecuados para el proceso sin servidor
- Utiliza computación serverless para bases de datos individuales con patrones de uso intermitentes e impredecibles intercalados con periodos de inactividad y menor utilización media de cómputo a lo largo del tiempo.
- Utiliza computación sin servidor para bases de datos individuales en la capa de computación provisionada que se reescalan con frecuencia, o cuando prefieras delegar el reescalado de computación al servicio.
- Utiliza computación sin servidor para nuevas bases de datos individuales sin historial de uso cuando el tamaño del cálculo sea difícil o imposible de estimar antes de desplegar en Azure SQL Database.
Escenarios adecuados para el proceso aprovisionado
- Utiliza computación provisionada para bases de datos individuales con patrones de uso más regulares y predecibles y una mayor utilización media de cómputo a lo largo del tiempo.
- Utiliza capacidad de proceso aprovisionada para bases de datos que no pueden asumir concesiones de rendimiento debidas a reducciones de memoria más frecuentes o a retrasos al reanudarse desde un estado en pausa.
- Utiliza computación provisionada para múltiples bases de datos con patrones de uso intermitentes e impredecibles que pueden consolidarse en pools elásticos para una mejor optimización precio-rendimiento.
Comparación de los niveles de proceso
La tabla siguiente resume las diferencias entre el nivel de proceso sin servidor y el nivel de proceso aprovisionado:
| Proceso sin servidor | Computación provisionada | |
|---|---|---|
| Patrones de uso de bases de datos | Uso intermitente e impredecible con menor uso promedio de proceso a lo largo del tiempo. | Patrones de uso más regulares con mayor uso promedio de proceso a lo largo del tiempo, o varias bases de datos que usen grupos elásticos. |
| Trabajo de administración del rendimiento | Inferior | Superior |
| Escalado de proceso | Automático | Guía |
| Respuesta inicial al cómputo | Menor después de períodos de inactividad | Inmediata |
| Granularidad de facturación | Por segundo | Por hora |
- El mejor patrón de uso de bases de datos para computación serverless es intermitente e impredecible, con una menor utilización media de cómputo a lo largo del tiempo. El mejor patrón de uso para el cómputo provisionado es más regular, con una mayor utilización media de cómputo a lo largo del tiempo, o incluye múltiples bases de datos en pools elásticos.
- El cálculo sin servidor requiere menor esfuerzo de gestión del rendimiento. El cómputo provisionado requiere un mayor esfuerzo de gestión del rendimiento.
- El cómputo sin servidor escala automáticamente. La capacidad de cómputo aprovisionada se escala manualmente.
- El cómputo sin servidor tiene una respuesta inicial menor tras periodos inactivos. El cómputo provisionado responde inmediatamente.
- El computo sin servidor se factura por segundo. El cómputo provisionado se factura por hora.
Modelo de compra y nivel de servicio
En la tabla siguiente se describe la compatibilidad sin servidor en función del modelo de compra, los niveles de servicio y el hardware:
| Categoría | Soportado | No soportado |
|---|---|---|
| Modelo de compra | vCore | DTU |
| Nivel de servicio | Uso general Hiperescala |
Crítico para la empresa |
| Hardware | Serie estándar (Gen5) | El resto de hardware |
Bases de datos sin servidor con escalado automático
Para obtener más información sobre el escalado automático y la capacidad de respuesta del nivel de proceso sin servidor, consulta Escalado automático del nivel de proceso sin servidor para Azure SQL Database.
Pausa automática y reanudación automática
- La pausa automática y la reanudación automática sin servidor están disponibles en la categoría de servicio de propósito general.
- La pausa automática y la reanudación automática sin servidor son una función de vista previa de Azure SQL Database Hyperscale.
Para información detallada sobre el comportamiento de pausa automática y reanudación automática, disparadores, resolución de problemas y conectividad, consulte Pausa automática y reanudación automática en la capa de computación sin servidor.
Creación de una base de datos sin servidor nueva
Para instrucciones paso a paso sobre cómo crear, mover y configurar bases de datos serverless usando el portal de Azure, PowerShell, CLI de Azure y T-SQL, consulta Crear y configurar una base de datos serverless.
Mejores prácticas del nivel de proceso sin servidor
Considera las siguientes mejores prácticas al utilizar bases de datos serverless.
Implementar la lógica de reintentos de aplicación
Todas las aplicaciones conectadas a la nube deben usar recomendaciones de lógica de reintentos de conexión. Los errores de conectividad transitoria deben gestionarse con lógica de reintento en todas las aplicaciones en la nube. La lógica de reintento para bases de datos serverless es especialmente importante porque los errores temporales de conectividad debidos a la reanudación automática son predecibles.
Para más información, consulta Resolución de problemas de conectividad de reanudación automática.
Revisa la interoperabilidad que impida la pausa automática
Algunas funciones y configuraciones pueden impedir que una base de datos serverless se pause automáticamente. Puedes desactivar la pausa automática en la base de datos si estas funciones están en uso.
Para más información, véase Resolución de problemas de pausa automática.
Supervisar
Para más información sobre cómo monitorizar eventos de pausa y reanudación de tu base de datos serverless, consulta Monitorizar la capa de computación serverless para Azure SQL Database.
Límites de recursos
Para los límites de recursos, véase Computación sin servidor de propósito general y Computación sin servidor Hyperscale.
Facturación
Para información detallada de facturación, incluyendo cálculos de costes de cálculo, factura mínima de cálculo y ejemplos de escenarios tanto para niveles de Propósito General como Hyperscale, véase Facturación por niveles de computación sin servidor.
Regiones disponibles
Para obtener disponibilidad regional, consulte disponibilidad Serverless por región para Azure SQL Database.