Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Los administradores del área de trabajo y los usuarios con privilegios suficientes pueden configurar y administrar almacenes de SQL. En este artículo se describe cómo crear, editar y supervisar almacenes de SQL existentes.
También puede crear almacenes de SQL mediante la API de almacenes de SQL o Terraform.
Databricks recomienda usar almacenes de SQL sin servidor cuando estén disponibles.
Nota
La mayoría de los usuarios no pueden crear almacenes de SQL, pero pueden reiniciar cualquier almacenamiento de SQL al que puedan conectarse. Consulte Conectarse a un almacén SQL.
Requisitos
Los almacenes de SQL tienen los siguientes requisitos:
- Para crear un almacén de SQL, debe ser administrador del área de trabajo o un usuario con permisos de creación de clústeres sin restricciones.
- Antes de poder crear un almacén de SQL sin servidor en una región que admita la característica, es posible que se requieran algunos pasos. Consulte Configuración de almacenes sql sin servidor.
- En el caso de los almacenes de SQL clásicos o pro, la cuenta de Azure debe tener una cuota de vCPU adecuada. La cuota predeterminada de vCPU suele ser adecuada para crear un almacén de SQL sin servidor, pero es posible que no sea suficiente para escalar el almacén de SQL o para crear almacenes adicionales. Consulte Cuota de vCPU de Azure requerida para almacenes SQL clásicos y pro. Puede solicitar una cuota de vCPU adicional. Su cuenta de Azure puede tener limitaciones en la cantidad de cuota de vCPU que puede solicitar. Póngase en contacto con el equipo de la cuenta de Azure para obtener más información.
Crear un almacén SQL
Para crear un almacén de SQL mediante la interfaz de usuario web:
- Haga clic en Almacenes de SQL en la barra lateral.
- Haga clic en Crear almacenamiento de SQL.
- Escriba un nombre para el almacén.
- (Opcional) Configure las opciones de almacenamiento. Consulte Configuración de la configuración de un almacenamiento de SQL.
- (Opcional) Configure las opciones avanzadas. Consulte Opciones avanzadas.
- Haga clic en Crear.
- (Opcional) Configure el acceso a un almacenamiento de SQL. Consulte Administración de un almacenamiento de SQL.
El almacenamiento creado se inicia automáticamente.
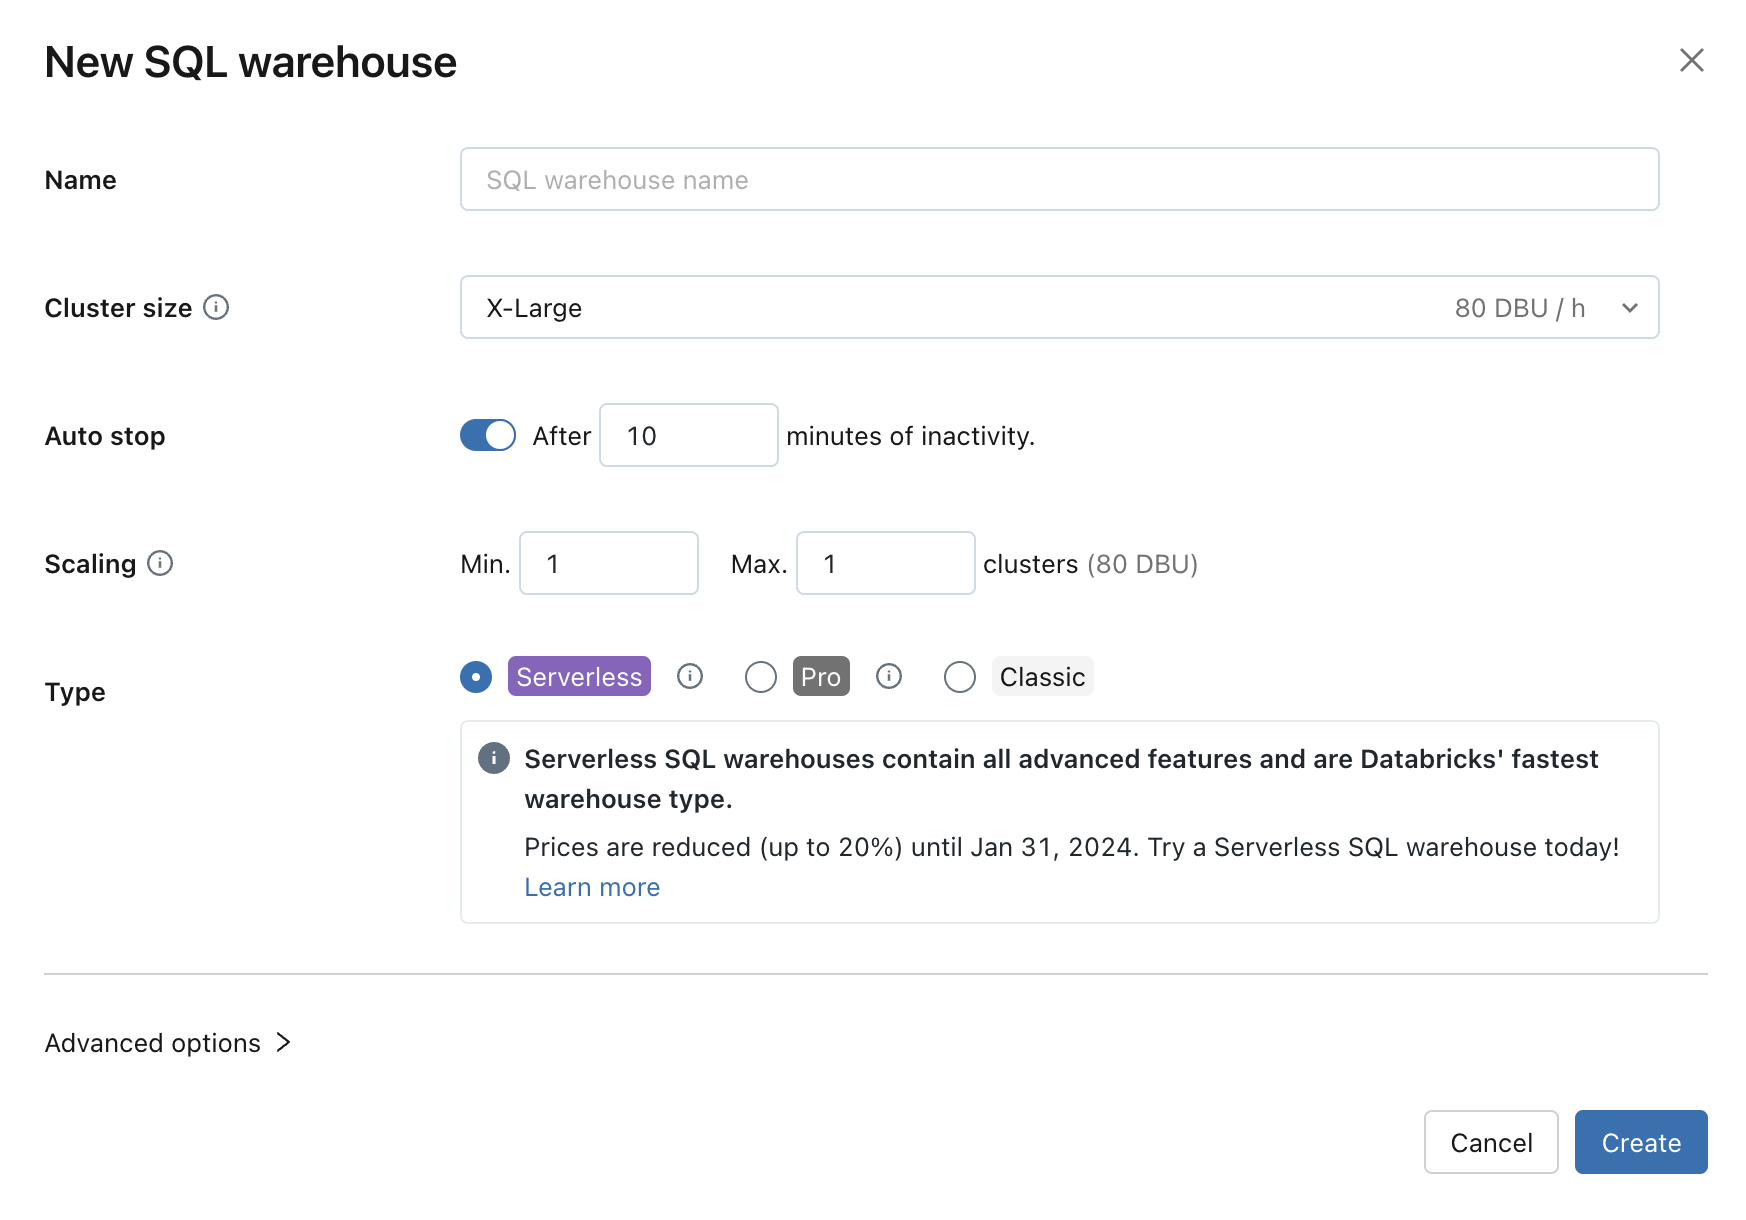
Configurar la configuración del almacén SQL
Puede modificar la siguiente configuración al crear o editar un almacén de SQL:
Tamaño del clúster representa el tamaño del nodo controlador y el número de nodos de trabajo asociados al clúster. El valor predeterminado es X-Large. Para reducir la latencia de las consultas, aumente el tamaño.
Auto Stop determina si el almacén se detiene si permanece inactivo durante el número de minutos especificado. Los almacenes de SQL inactivos siguen acumulando cargos de DBU y de instancia en la nube hasta que se detienen.
- Almacenes SQL Pro y clásicos: El valor predeterminado es 45 minutos, lo cual se recomienda para uso típico. El mínimo es de 10 minutos.
- Almacenes SQL sin servidor: El valor predeterminado es de 10 minutos, lo cual se recomienda para el uso típico. El mínimo es de 5 minutos cuando se usa la interfaz de usuario. Tenga en cuenta que puede crear un almacén de SQL sin servidor mediante la API de almacenes de SQL, en cuyo caso puede establecer el valor de detención automática en un mínimo de 1 minuto.
El escalado establece el número mínimo y máximo de clusters que se utilizarán para una consulta. El valor predeterminado tiene un mínimo y un máximo de un clúster. Puede aumentar el número máximo de clústeres si desea controlar más usuarios simultáneos para una consulta determinada. Azure Databricks recomienda un clúster para cada 10 consultas simultáneas.
Para mantener un rendimiento óptimo, Azure Databricks recicla clústeres que han estado funcionando durante más de 24 horas. Durante el reciclaje, Azure Databricks abre un nuevo clúster y comienza a realizar la transición de nuevas consultas a él al retirar el clúster anterior. Las consultas existentes continúan ejecutándose en el clúster antiguo hasta que terminan.
Durante este período de transición, puede ver temporalmente un recuento de clústeres que supere el máximo configurado. Por ejemplo, si el número máximo de clústeres está establecido en 1, es posible que vea 2 clústeres activos durante el reciclaje. Azure Databricks espera a que todas las consultas del clúster anterior finalicen antes de finalizarla.
Importante
Si las consultas existentes continúan ejecutándose en el clúster antiguo más allá de las 24 horas, Azure Databricks podría eventualmente terminar el clúster de forma forzosa para completar el proceso de reciclaje. Para reducir el riesgo de interrupciones, diseña cargas de trabajo de larga duración para que se completen en 24 horas, o divídelas en consultas más pequeñas.
El tipo determina el tipo de warehouse. Si está habilitado "sin servidor" en su cuenta, este será el valor predeterminado. Consulte tipos de almacenamiento de SQL para obtener la lista.
Opciones avanzadas
Configure las siguientes opciones avanzadas expandiendo el área Opciones avanzadas cuando cree un nuevo almacén de SQL o edite un almacén de SQL existente. También puede configurar estas opciones mediante el uso de la API del almacén de SQL.
Etiquetas: Las etiquetas te permiten monitorizar el coste de los recursos en la nube utilizados por usuarios y grupos de tu organización. Las etiquetas se especifican como pares clave-valor.
Unity Catalog: Si Unity Catalog está habilitado para el espacio de trabajo, es el valor predeterminado para todos los nuevos almacenes en el espacio de trabajo. Si el Unity Catalog no está habilitado en el área de trabajo, no verá esta opción. Consulte ¿Qué es Unity Catalog?.
Canal: Utilice el canal de Vista previa para probar nuevas funcionalidades, incluidas sus consultas y paneles, antes de que se convierta en el estándar SQL de Databricks.
Use las notas de la versión para obtener información sobre lo que se encuentra en la versión preliminar más reciente.
Importante
Databricks recomienda no usar una versión preliminar para cargas de trabajo de producción. Dado que solo los administradores del área de trabajo pueden ver las propiedades de un almacenamiento, incluido su canal, considere la posibilidad de indicar que un almacenamiento de SQL de Databricks usa una versión preliminar en el nombre de ese almacenamiento para evitar que los usuarios lo usen para cargas de trabajo de producción.
Azure Databricks también admite tiempos de espera de instrucciones por almacenamiento que puede establecer con la API de almacenamiento de SQL. Esta opción no está disponible en la interfaz de usuario. Para más detalles, consulte Statement timeout.
Establecer un warehouse predeterminado a nivel de usuario
Puede establecer una instancia predeterminada de SQL Warehouse para usarla automáticamente al ejecutar consultas. Esta configuración invalida el almacenamiento predeterminado de nivel de área de trabajo, si existe uno. Ver Establecer una instancia predeterminada de SQL Warehouse para el área de trabajo.
Use el menú desplegable para establecer un nuevo valor predeterminado desde cualquier superficie de creación de SQL de Databricks, incluido el editor de SQL, paneles de IA/BI, Genie, Alertas y el Explorador de catálogos.
Para establecer un almacenamiento predeterminado de nivel de usuario:
Haga clic en el menú desplegable para seleccionar el cómputo de almacén SQL.
Haga clic en Personalizar el almacén predeterminado.

Elija alguna de las acciones siguientes:
- Espacio de trabajo predeterminado: Mantén esta configuración para usar el almacén predeterminado establecido para el espacio de trabajo.
- Última selección: La selección predeterminada muestra el último almacén SQL que ha seleccionado para el cálculo.
- Predeterminado personalizado: Elige un nuevo almacén SQL como tu almacén predeterminado. Esto invalida una configuración predeterminada de nivel de área de trabajo. Después de configurarlo, el almacén seleccionado se designa automáticamente como cómputo. Para invalidar manualmente esta configuración, elija otro almacén de SQL en el menú desplegable.
Gestionar un almacén de datos SQL
Los administradores del área de trabajo y los usuarios con privilegios CAN MANAGE en un almacén SQL pueden completar las siguientes tareas en un almacén SQL existente:
Para detener un almacén en ejecución, haga clic en el icono de detención situado junto al almacén.
Para iniciar un almacén detenido, haga clic en el icono de inicio situado junto al almacén.
Para editar un almacén, haga clic en el icono de
 . A continuación, haga clic en Editar.
Para agregar y editar permisos, haga clic en el icono del
y luego en Permisos.- Asignar Puede ver para permitir a los usuarios ver los almacenes de SQL, incluidos el historial de consultas y los perfiles de consulta. Estos usuarios no pueden ejecutar consultas en el almacenamiento.
- Asigne Puede usar a los usuarios que necesitan ejecutar consultas en el almacenamiento.
- Asigne Puede supervisar a usuarios avanzados para solucionar problemas y optimizar el rendimiento de las consultas. El permiso Can monitor permite a los usuarios ejecutar consultas y supervisar almacenes SQL, incluyendo el historial de consultas y los perfiles de consulta.
- Asigne Puede administrar a los usuarios responsables del dimensionamiento y los límites de gasto de almacenamiento de SQL.
- Es propietario se aplica automáticamente al creador del almacén SQL.
Para obtener información sobre los niveles de los permisos, consulte ACL del almacén de SQL.
Para actualizar una instancia de un almacenamiento de SQL a sin servidor, haga clic en el menú kebab
y, a continuación, haga clic en Actualizar a sin servidor.Para eliminar un almacén, haga clic en el icono de
. A continuación, haga clic en Eliminar.
Nota
Póngase en contacto con su representante de Databricks para restaurar almacenes eliminados en un plazo de 14 días.