Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Importante
Esta característica se encuentra en su versión beta. Para usarlo, un administrador de espacio de trabajo debe activar la Materialización del Panel de IA/BI desde la página de Previsualizaciones . Consulte Administrar versiones preliminares de Azure Databricks.
Los paneles de IA/BI se basan en conjuntos de datos específicos del panel. Por defecto, cada conjunto de datos se evalúa en tiempo real, así que cada vez que carga un panel de control o un visor interactúa con él, las consultas, uniones y escaneos de código fuente subyacentes se ejecutan de nuevo en tu almacén SQL. Para paneles construidos sobre consultas de código fuente costosas o muchas uniones, volver a ejecutar esas consultas en cada interacción es lento y costoso.
La materialización de conjuntos de datos precalcula y almacena los resultados detrás de un conjunto de datos, por lo que el trabajo pesado ocurre una sola vez en un calendario en lugar de en cada carga o interacción del panel de control. Las interacciones se renderizan a partir de los resultados almacenados, lo que hace que los paneles publicados sean más rápidos.
Materialization utiliza la tecnología de materialización de vistas métricas del Catálogo Unity. Consulte Materialización para vistas de métricas.
Lo que se materializa
Materialization precalcula y almacena datos de conjuntos de datos. Lo que se almacena varía entre los dos tipos de conjuntos de datos:
- Para conjuntos de datos SQL, el resultado completo de la consulta se precalcula y almacena.
- Para las vistas de métricas locales, se almacena el modelo de datos a nivel de fila (datos fuente, uniones y campos de filtro), mientras que las medidas se siguen calculando en tiempo de consulta sobre la base precalculada.
Benefits
La materialización de conjuntos de datos ofrece los siguientes beneficios:
- Paneles de control más rápidos sin necesidad de remodelar. Las uniones costosas y los análisis de la fuente de datos se ejecutan una vez según una programación, en lugar de hacerlo con cada carga, lo que elimina la espera que experimentan los usuarios cuando un panel vuelve a consultar tablas grandes.
- Menor coste de almacenamiento en lectura. Precomputar el modelo base de datos evita repetir la misma consulta pesada para cada visor y cada carga de página, lo que reduce el uso redundante del almacén.
- No hay gastos operativos. Azure Databricks crea, almacena y actualiza los datos materializados para ti. No hay pipeline, esquema ni almacenamiento que gestionar.
Costs
La materialización de conjuntos de datos implica costes de almacenamiento y cálculo:
- Almacenamiento. Pagas por almacenar los datos materializados. Los cargos dependen del almacenamiento subyacente utilizado. Para una visión general del almacenamiento en el Catálogo Unity, consulte Conectar al almacenamiento de objetos en la nube usando el Catálogo Unity.
- Calcular. La creación inicial y las actualizaciones se ejecutan en pipelines serverless de Lakeflow y generan costes de cómputo. Consulta los precios de Lakeflow pipelines.
Compara estos costes frente al ahorro de evitar escaneos y uniones repetidas de fuente. Elige un calendario de actualización que equilibre la frescura de los datos con los costes de cálculo.
Cuándo utilizar la materialización
La materialización no siempre es la palanca adecuada para el rendimiento. El beneficio proviene de reemplazar la recomputación repetida y completa de un conjunto de datos (escaneo y unión) por lecturas sobre una tabla precomputada. Materializar un conjunto de datos cuando se apliquen uno o más de los siguientes aspectos:
- Paneles de control altamente interactivos. El panel tiene muchos filtros, filtrado cruzado o desgloses. Sin materialización, cada interacción vuelve a ejecutar la consulta de datos, por lo que precomputar esos conjuntos de datos da resultados repetidamente en una sesión.
- Conjuntos de datos caros. El conjunto de datos se basa en combinaciones de varias tablas, vistas complejas o expresiones de tabla comunes (CTE), funciones de ventana o uniones de muchas tablas.
- Filtros selectivos en tablas grandes. El conjunto de datos selecciona un pequeño subconjunto, como una región o los últimos 7 días de miles de millones de filas. La materialización almacena solo el pequeño subconjunto.
- Tolerancia para la actualidad programada. Los datos solo necesitan ser tan frescos como el calendario de actualizaciones del panel de control, como por horas o diarias, en lugar de en tiempo real.
Para conjuntos de datos pequeños o paneles que rara vez se cargan, la consulta en tiempo real suele ser lo suficientemente rápida y la materialización puede no merecer la pena el coste. Como la materialización se activa de forma opcional en cada publicación y en cada conjunto de datos, solo puedes aplicarla donde compensa.
Requisitos
- Acceso a un panel de INTELIGENCIA ARTIFICIAL/BI.
- El panel de control se publica con la opción de permisos para compartir datos. La materialización no es compatible con los paneles publicados con permisos de datos individuales. Consulte ¿Qué son los permisos de datos compartidos?.
- Computación sin servidor habilitada en el espacio de trabajo. La creación inicial y las actualizaciones se ejecutan mediante pipelines serverless de Lakeflow. Consulte Configuración de almacenes sql sin servidor.
- PUEDE USAR permisos en un almacén SQL que ejecute Databricks Runtime 17.3 y superior.
Habilitar la materialización de conjuntos de datos
Los conjuntos de datos se seleccionan por defecto para materialización, pero la materialización está desactivada en el panel hasta que activas la opción Materializar conjuntos de datos al publicar.
Elige qué conjuntos de datos quieres materializar
En la pestaña de Datos , haz clic en el icono de materialización junto a un conjunto de datos para incluirlo o excluirlo.
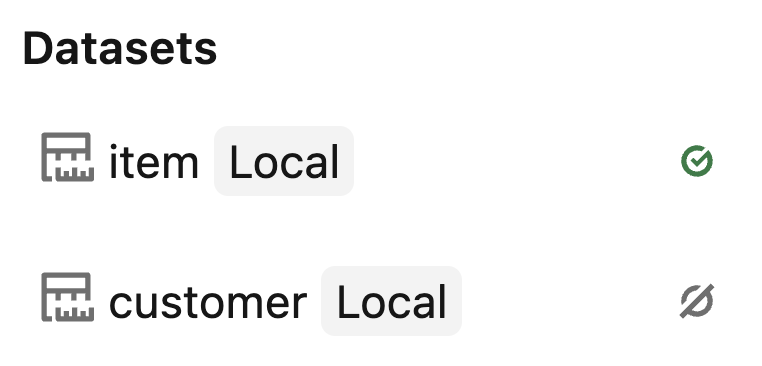
Cuando se excluye un conjunto de datos de la materialización, las consultas sobre ese conjunto de datos devuelven resultados en tiempo real, mientras que las consultas sobre conjuntos de datos materializados reflejan la ejecución de materialización más reciente. Cuando todos los conjuntos de datos utilizan el mismo calendario de materialización, los widgets mantienen una frescura consistente de los datos.
Publicar con materialización
- Haz clic en Publicar en el panel de borradores.
- Selecciona Permisos para compartir datos en el cuadro de diálogo de publicación.
- Activa la opción Materializar conjuntos de datos para materializar los conjuntos de datos seleccionados en la pestaña de Datos .
- Haga clic en Publicar.
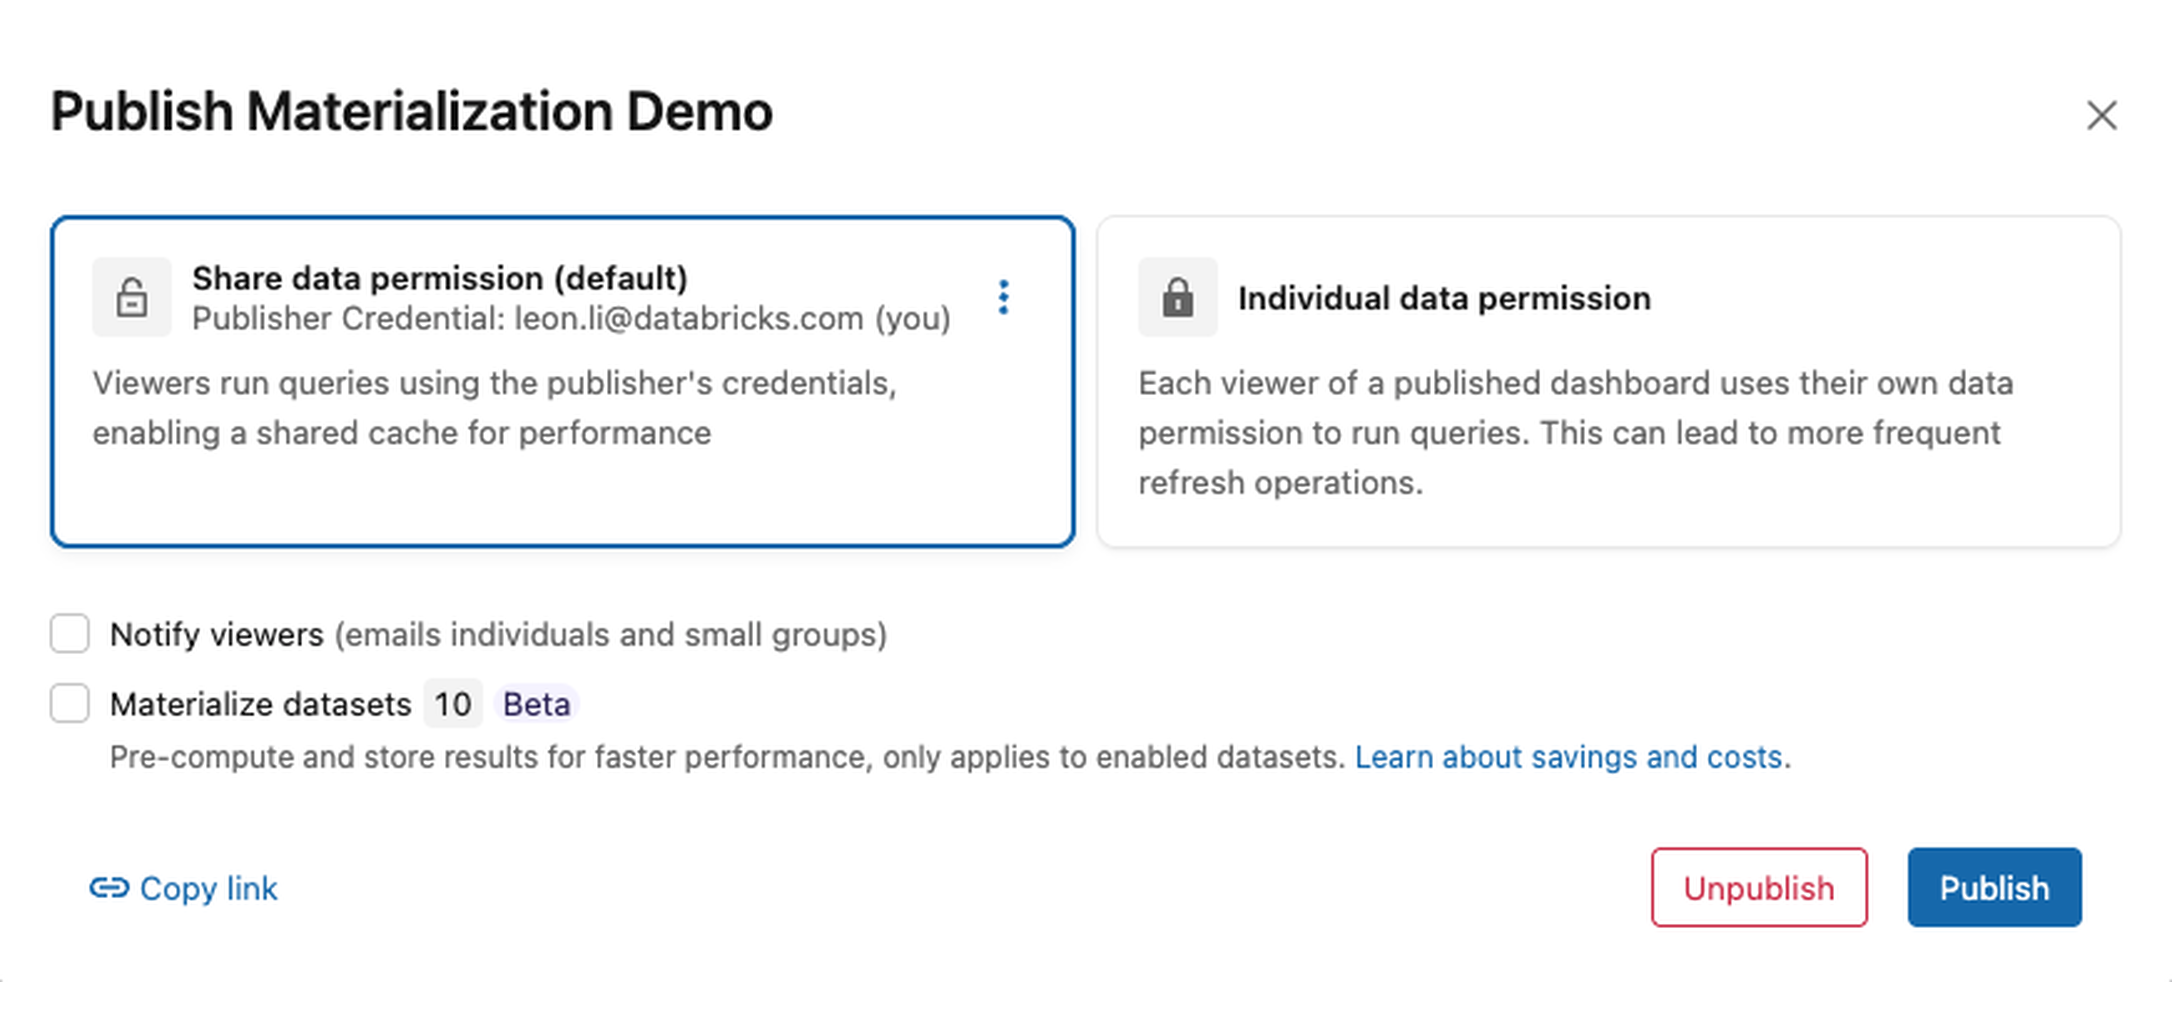
Activa la opción Materializar conjuntos de datos en cada publicación.
Establece un calendario de actualizaciones
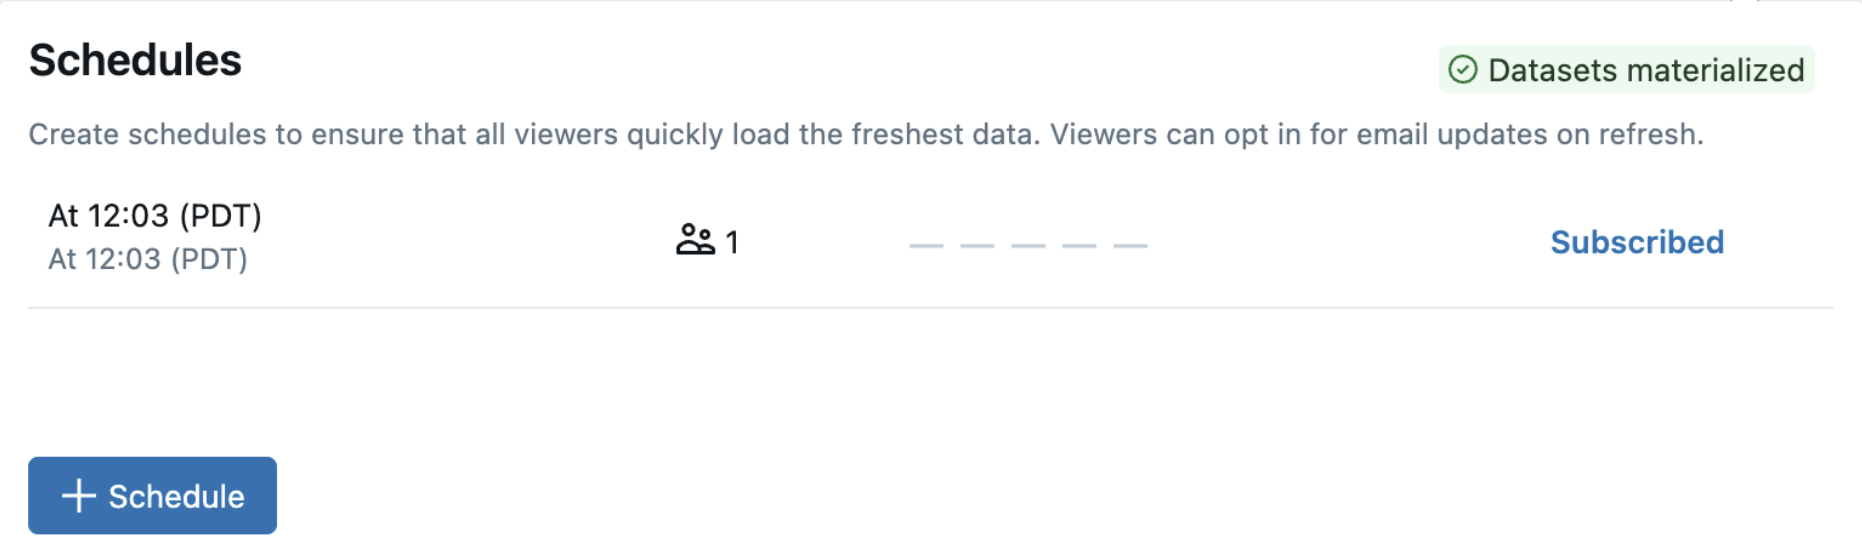
Los datos materializados se actualizan según la programación de actualización del panel. Usa el horario del panel para ajustar la frecuencia de refresco.
Si el panel no tiene un calendario, publicar con materialización activada añade un calendario diario de actualización. Se conservan los horarios existentes. Sin un horario activo, los datos materializados no se actualizan automáticamente tras la creación.
Ver estado de materialización
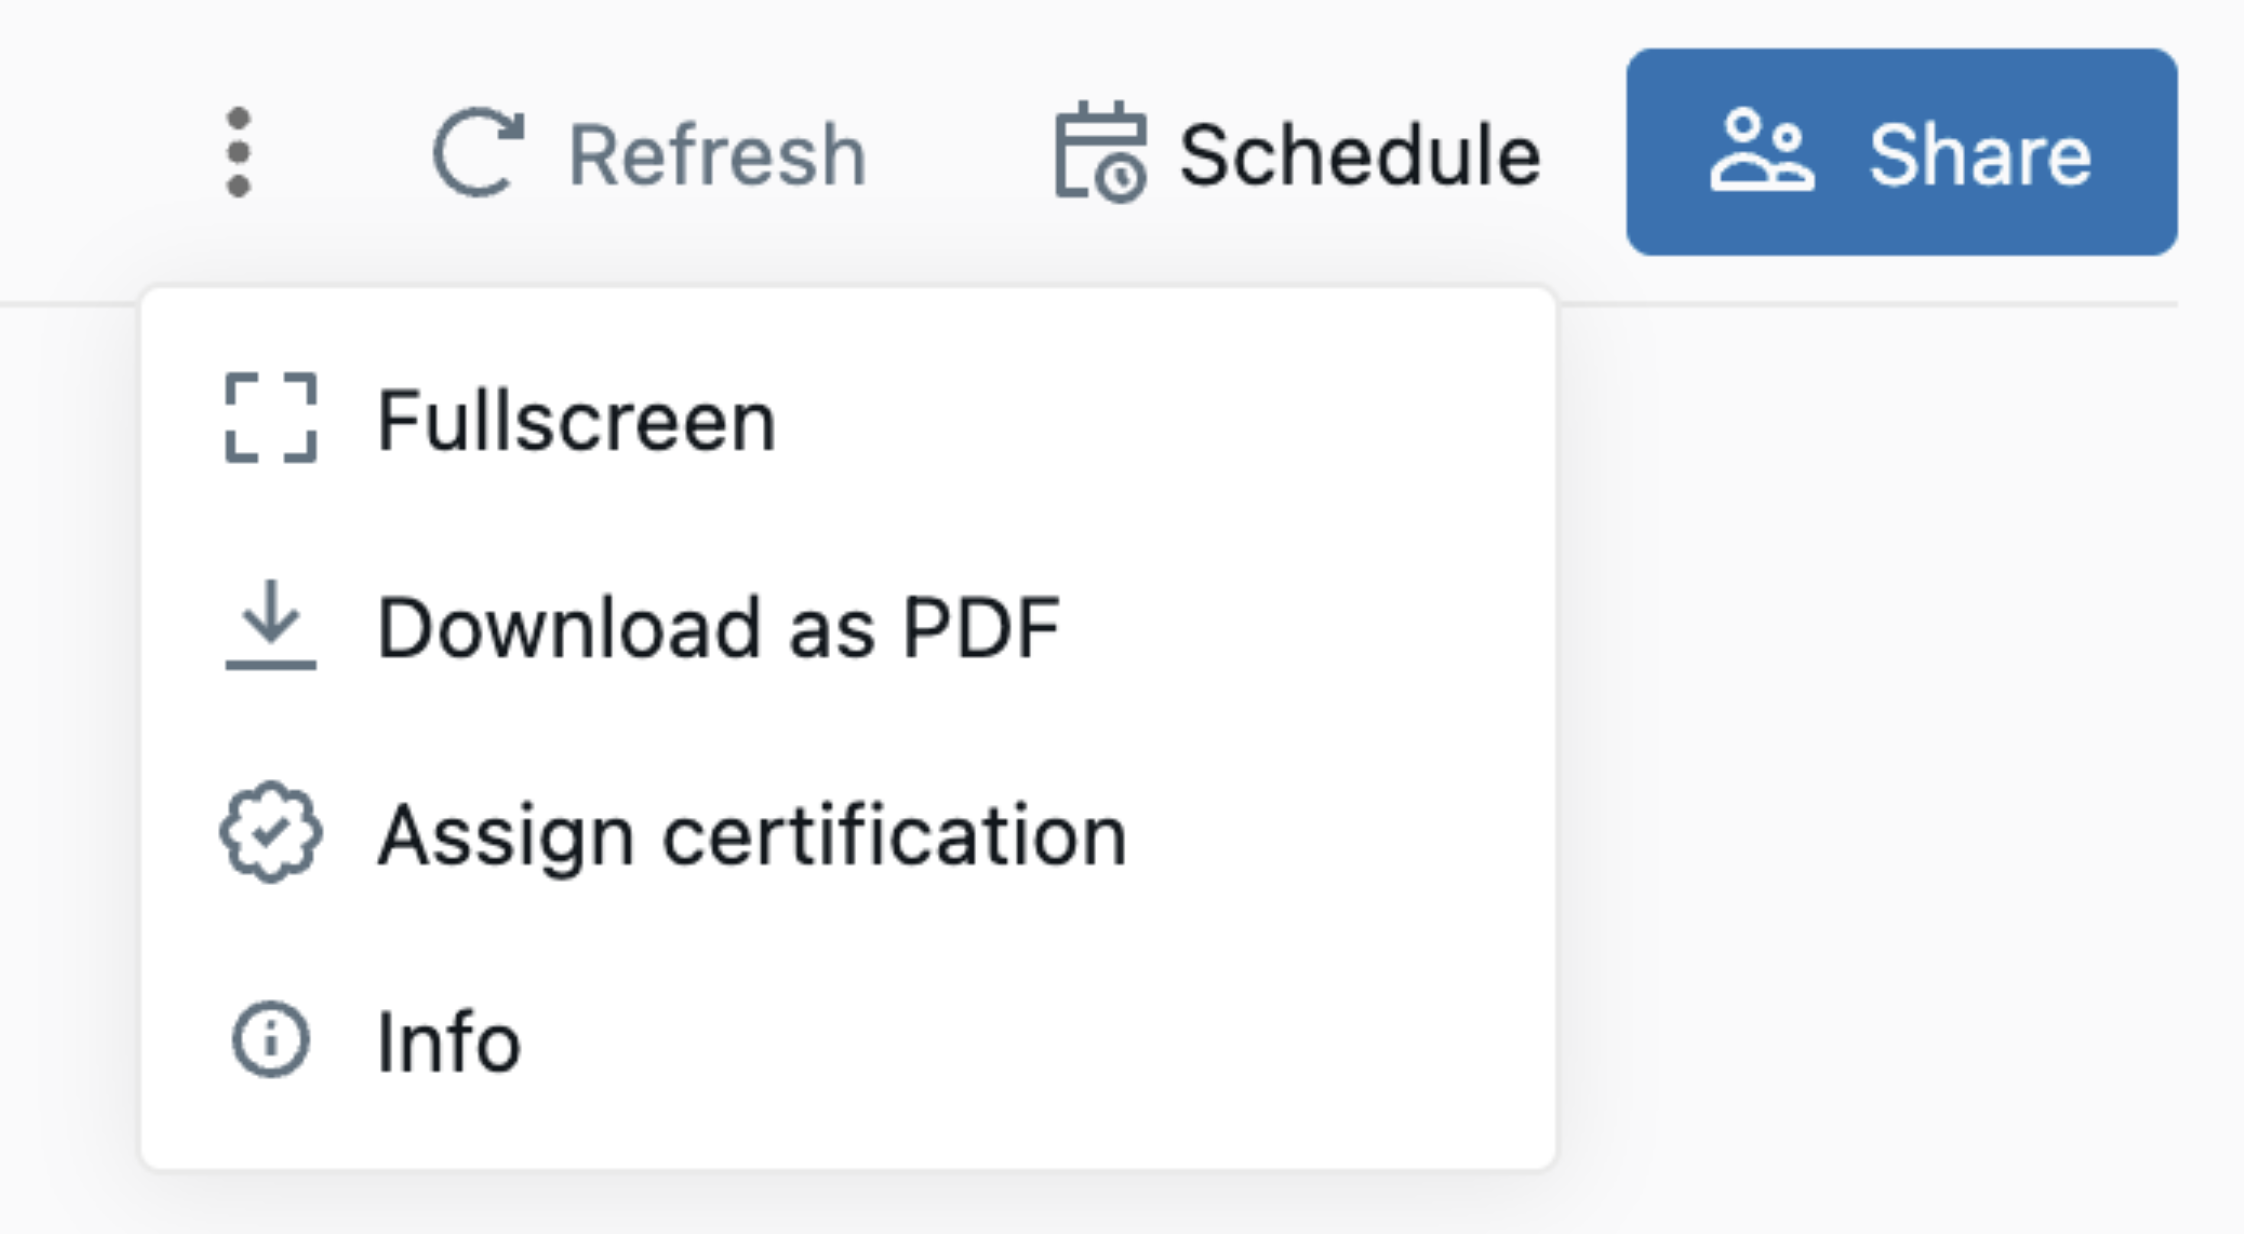
En el panel de control publicado, abre el  y selecciona Info. La barra lateral muestra el estado de cada conjunto de datos materializado y la información de actualización.
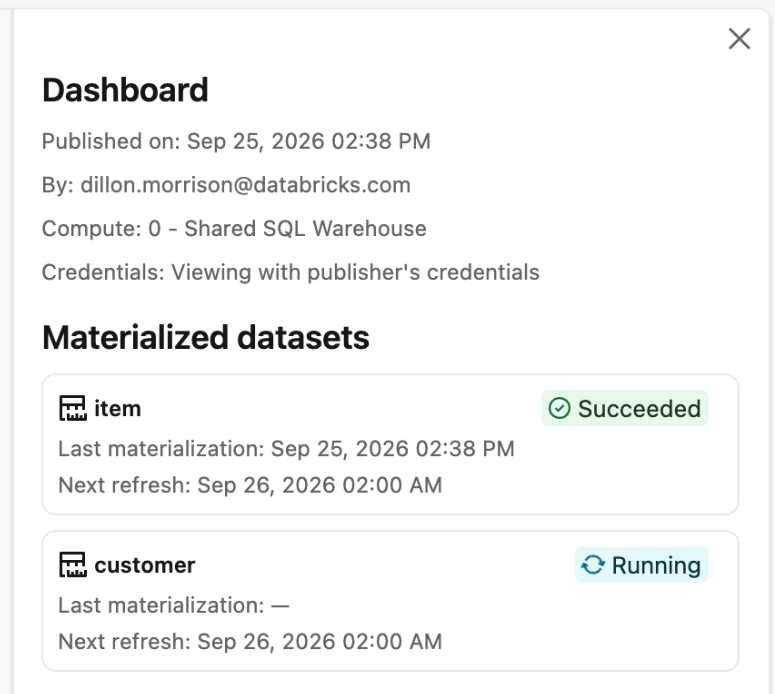
Reutilización y limpieza
Azure Databricks gestiona el ciclo de vida de tus datos materializados:
- Reutilización entre revisiones. Si un panel de control es republicado por el mismo usuario y un conjunto de datos no cambia, la materialización existente se reutilizará, evitando un desperdicio de cálculo.
- Limpieza automática. Azure Databricks elimina las materializaciones que un panel de control publicado ya no usa, por ejemplo, tras un cambio de definición o la retirada de su publicación.
La republicación no actualiza necesariamente los datos materializados.
Limitaciones
La materialización de conjuntos de datos tiene las siguientes limitaciones:
- Solo cuadros de mando publicados. La materialización se aplica a los paneles publicados. Los borradores continúan consultando datos en tiempo real.
- No hay conjuntos de datos parametrizados. No se pueden materializar conjuntos de datos que definen los parámetros. Si se opta por materializar un conjunto de datos parametrizado, Azure Databricks lo notifica como fallido en lugar de materializarlo.
- La actualización sigue solo el calendario del panel de control. No existe un calendario de actualización separado por conjunto de datos. La materialización se actualiza según la frecuencia de actualización programada de tu panel.
- Se requiere un entorno sin servidor. La creación inicial y las actualizaciones se ejecutan en canalizaciones serverless de Lakeflow, por lo que el espacio de trabajo debe tener habilitada la computación serverless.
- Los datos protegidos no se entregan a través de materializaciones. No se puede crear materialización para datos fuente protegidos por seguridad a nivel de fila, máscaras de columna o políticas de control de acceso basadas en atributos (ABAC). Si se añade seguridad a nivel de fila a una tabla fuente después de que se cree la materialización, las consultas posteriores a la vista de métricas omiten la materialización y se ejecutan sobre los datos fuente.
- Se requieren permisos para compartir datos. Solo puedes habilitar la materialización cuando publiques con permisos de datos compartidos. No puedes activarlo cuando publicas con permisos individuales de datos.
Preguntas más frecuentes
Las siguientes preguntas tratan sobre el comportamiento de materialización de conjuntos de datos, actualizaciones y permisos.
¿La materialización cambia mis métricas o resultados?
La materialización preserva la lógica de consulta del conjunto de datos, pero sus datos reflejan la última actualización exitosa. Para las vistas de métricas locales, las medidas se calculan en el momento de la consulta a partir de los datos materializados. Consulte qué se materializa.
¿Qué ocurre si una materialización no está lista o no está disponible?
Si una materialización no está lista o no está disponible en el momento de la consulta, la consulta devuelve un error en lugar de consultar datos en vivo. Espera a que termine la materialización y luego vuelve a ejecutar la consulta.
¿Dónde se almacenan los datos materializados?
Azure Databricks almacena los datos materializados en un almacenamiento interno administrado asociado a tu panel publicado. No hay nada que puedas publicar en el Catálogo de Unity, ni esquema ni almacenamiento que gestionar. El acceso sigue siguiendo tu panel de control y los permisos de datos subyacentes.
¿Con qué frecuencia se actualizan los datos materializados?
Los datos materializados se actualizan según la programación de actualización del panel. Consulta Establecer un calendario de actualizaciones.
¿Qué recursos de proceso utiliza la materialización?
La creación inicial y las actualizaciones se ejecutan en pipelines serverless de Lakeflow gestionados por Azure Databricks. Por eso debe estar habilitada la computación serverless en el espacio de trabajo.
¿La materialización afecta a los permisos?
N.º La materialización no otorga acceso adicional a los datos. Access sigue la configuración de compartición del panel de control y los permisos usados para publicarlo.
¿Qué pasa cuando vuelvo a publicar?
Las materializaciones existentes pueden reutilizarse cuando el mismo usuario vuelve a publicar un conjunto de datos sin cambios. Consulta Reutilizar y limpiar. Activa la opción Materializar conjuntos de datos en cada publicación.