Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
En este artículo se describe un proceso de seis fases para migrar una carga de trabajo impulsada por un LLM de un modelo base a otro: qué se debe tener en cuenta en cada fase, qué características de Microsoft Foundry se aplican y cómo cambia el trabajo para distintos tipos de equipos.
Qué significa la migración de modelos
Cada modelo que se ejecuta en producción tiene una fecha de retirada. Cuando se reemplaza un modelo en el que depende, o cuando un modelo más reciente serviría mejor la carga de trabajo, migra. El intercambio de un modelo no es un cambio de una línea: un modelo diferente puede desplazar silenciosamente el tono, el formato, la forma JSON, la latencia, el costo o el comportamiento de llamada a herramientas y interrumpir el código de bajada que depende del comportamiento anterior.
Una migración correcta conserva el comportamiento de la aplicación o la mejora de maneras medibles. El éxito requiere un proceso repetible para detectar el desfase, adaptarse de forma segura y demostrar la calidad antes del lanzamiento amplio.
Cuándo migrar
Normalmente, una migración se inicia por una de las cuatro razones:
- Un modelo se está retirando. En Foundry, cada modelo de disponibilidad general incluye una fecha de retirada, y las familias más antiguas se reemplazan con el tiempo. Para consultar la política y las fechas de retirada, consulte el ciclo de vida y la política de soporte de Foundry Models y el calendario de retirada de modelos.
- Hay disponible un mejor modelo. Un modelo más reciente ofrece una mayor calidad, un menor costo, una mejor latencia o una funcionalidad (como la salida estructurada o la llamada a herramientas mejorada) que necesita la carga de trabajo.
- Un problema de costo o latencia fuerza un cambio. La latencia o el costo unitario del modelo actual ya no satisfacen sus necesidades.
- Una brecha de funcionalidad bloquea el producto. El modelo actual no puede hacer algo que el producto ahora requiere.
¿Qué ocurre en la fecha de retirada?
Lo que Azure hace cuando se retira un modelo depende de cómo se compra la capacidad y Foundry usa terminología diferente para cada ruta de acceso:
- Las implementaciones estándar, estándar globales y estándar de zona de datos (pago por uso) se actualizan automáticamente según una programación gradual y regional. Puede controlar el momento estableciendo
versionUpgradeOptionen uno de estos valores:OnceNewDefaultVersionAvailable,OnceCurrentVersionExpiredoNoAutoUpgrade(lo que significa que la implementación deja de funcionar al retirarse del servicio). El procesamiento prioritario sigue el mismo recorrido. - Las implementaciones aprovisionadas (PTU)no se actualizan automáticamente. Puede migrarlos usted mismo, ya sea en el mismo lugar (el tráfico se redirige en un intervalo de entre 20 y 30 minutos, sin interrupción del servicio) o en paralelo (poner en marcha la nueva implementación, probarla, redirigir el tráfico y eliminar la anterior).
- Las implementaciones por lote siguen la ruta de acceso en paralelo: implemente el nuevo modelo, vuelva a enviar trabajos, retire la implementación anterior.
Independientemente de la ruta de acceso que se aplique, el desafío del desarrollador es el mismo: en una fecha establecida, el tráfico comienza a alcanzar un modelo diferente. Un punto de conexión que sigue respondiendo no significa que la aplicación se comporte correctamente, por lo que las cargas de trabajo actualizadas y migradas manualmente se benefician de la evaluación y validación que se describe en este artículo.
Migración antes de la fecha de retirada
La actualización automática es solo una red de seguridad para las implementaciones de pago por uso, no un plan de migración. Los despliegues con aprovisionamiento no tienen margen de seguridad. En cualquier caso, no es un sustituto de un plan de migración. Dos compromisos de directiva le ofrecen espacio para migrar según su propia programación en lugar de esperar a la fecha límite:
- El modelo de reemplazo estará disponible aproximadamente 90 días antes de la retirada en El estándar global y aproximadamente 30 días antes de la retirada en regiones aprovisionadas en las que el predecesor se retira. Use esta ventana para evaluar el nuevo modelo y migrar manualmente.
- Las fechas de retirada no son extensibles. No existe ningún proceso de excepción, por lo que una fecha que no había previsto sigue aplicándosele.
No necesitas un aviso de obsolescencia para empezar. Si un modelo más reciente es más barato, más rápido o tiene más capacidades, somételo al proceso ahora. La migración deliberadamente convierte la fecha de retirada en una formalidad. Dado que las migraciones se repiten, vale la pena hacer que el proceso se pueda repetir.
Quién debe usar el proceso de migración
El proceso de migración se ajusta mejor cuando el equipo crea una característica con tecnología LLM dentro de un producto o plataforma más grande, se migra aproximadamente trimestralmente y tiene un propietario claro (como un equipo de plataforma central o el equipo de la aplicación) que ejecuta cada migración deliberadamente.
Este proceso también se ajusta a los equipos nativos de IA, donde el modelo es el producto. Las fases son las mismas, pero se ejecutan más rápido y a menudo en paralelo en lugar de en una secuencia estricta.
El proceso asume que va a pasar de unos modelos base a otros; es decir, modelos que implementa tal como se publican en el catálogo de modelos, sin personalización en el nivel de pesos. Las cargas de trabajo ajustadas con precisión quedan fuera del alcance. No se pueden actualizar automáticamente, ya que tienen su propio calendario de fin de vida para el entrenamiento y el despliegue. Adaptar cargas de trabajo ajustadas implica la destilación o el reentrenamiento, en lugar de cambios en las solicitudes y en el esquema. Si utiliza implementaciones ajustadas, planifique volver a ajustarlas con el modelo base de reemplazo lo antes posible.
Fases de migración
Una migración pasa por seis fases. Cada fase genera una salida que usa la siguiente fase. Las fases de migración son:
Detectar → Evaluar → Adaptar → Validar → Implementar → Retirar
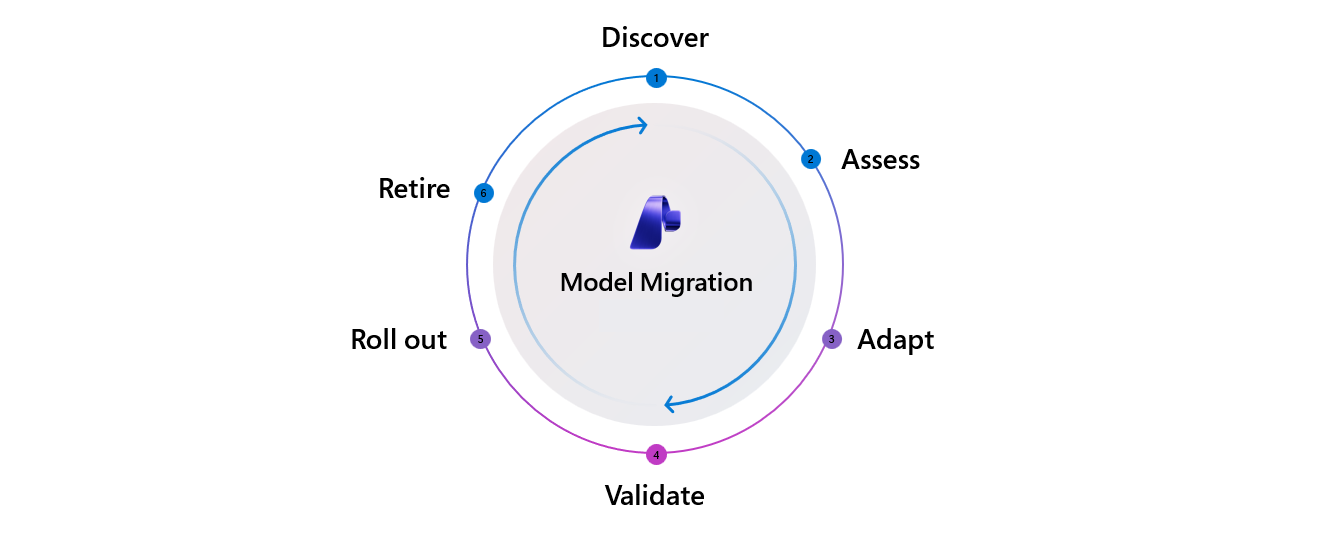
En la tabla siguiente se describen cada fase y las características y herramientas de Foundry que lo admiten. Las características están disponibles en Microsoft Foundry y Azure OpenAI a menos que se marque Foundry solo, lo que significa que Azure OpenAI no tiene equivalente.
Las secciones por fase que se muestran más adelante en este artículo explican por qué existe cada fase, qué aspecto tiene un resultado correcto, qué tener en cuenta, cuándo usar cada característica y dónde se interrumpe normalmente la fase.
| Phase | Description | Características y herramientas |
|---|---|---|
| Descubra | Obtenga información sobre que se está llegando o necesitando un cambio de modelo y decida si debe actuar. |
|
| Evaluar | Elija el modelo de destino y confirme que está disponible de forma operativa. |
|
| Adaptar | Reproduzca la carga de trabajo actual en el nuevo modelo, diagnostique los cambios de comportamiento y vuelva a diseñar mensajes, parámetros, definiciones de herramientas, esquemas de salida y el código de llamada alrededor de ellos. |
|
| Validación | Evalúe la carga de trabajo adaptada según una rúbrica de calidad para decidir si se puede lanzar con seguridad. |
|
| Implementación | Promover a producción mediante un despliegue gradual, supervisar el comportamiento en producción y confirmar o revertir. |
|
| Retire | Desmantelar el despliegue antiguo, liberar capacidad, archivar las evaluaciones y actualizar la documentación de procesos posteriores. |
|
Antes de migrar: Preparación de un conjunto de datos de prueba
Este paso de preparación ensambla un conjunto de entradas representativas, salidas esperadas y criterios de éxito acordados antes de que comience cualquier trabajo de migración. Este conjunto es una dependencia condicionante en la parte central del proceso: no se puede volver a ejecutar en la fase de Adaptación sin datos de entrada, y no se puede evaluar en la fase de Validación sin datos de referencia ni criterios.
Lo que debes tener en cuenta
- Compile el conjunto de datos antes de elegir un destino. El conjunto de datos describe la carga de trabajo, no el modelo candidato, por lo que puede ensamblarlo en paralelo con Discover.
- Recopile entradas de orígenes reales o sintéticos. Utilice tráfico de producción capturado o ejemplos de dominio seleccionados en formato CSV o JSONL. Cuando aún no se dispone de datos representativos, genere entradas sintéticas y adversarias con el Simulator.
- Capture la instrumentación antes de que la necesite. La captura de contenido en producción requiere activación explícita y nunca es retroactiva, por lo que no puedes evaluar el tráfico que no registraste. Empiece a registrar indicaciones, respuestas, latencia y recuentos de tokens ahora.
- Congelar el conjunto de datos. Mantenga las entradas, las verdades básicas y los criterios de éxito fijos para toda la migración. Si alguno de ellos cambia, ya no puede comparar los resultados de origen y destino.
También necesita disponer de un inventario de las implementaciones de modelos que utiliza su carga de trabajo, incluido el tipo de cada una (estándar, aprovisionada o por lotes). Para cada modelo de origen, anote su fecha de retirada y su reemplazo sugerido de la programación de retirada del modelo.
Fase 1: Detección
El propósito de la fase de descubrimiento es reconocer que se avecina un cambio de modelo o que merece la pena, y decidir si se debe actuar. El resultado es una decisión de seguir adelante o no, y seguir con el modelo actual es una opción válida. Un resultado correcto es una señal temprana y estructurada que proporciona la fecha de desuso, el modelo de reemplazo y la ventana de migración, o una decisión deliberada de permanecer en el modelo actual.
Lo que debes tener en cuenta
- ¿Cuál es la fecha de retirada y cuánta pista tiene realmente? Considere la fecha de retirada, menos el tiempo de validación y despliegue, como la fecha límite real.
- ¿Hay un reemplazo sugerido específico, o tienes que preseleccionar tú mismo a los candidatos?
- ¿El cambio implica restricciones normativas o regionales (para cargas de trabajo reguladas, la disponibilidad y la certificación suelen ser más importantes que la calidad)?
Dónde se interrumpe normalmente
Los equipos aprenden sobre las retiradas incoherentemente, a través de un correo electrónico, un banner del portal o un mensaje interno, y notan la señal tarde. Ese retraso acorta una ventana ya estrecha. Los desarrolladores en solitario y los equipos pequeños suelen descubrir una retirada a causa de un error en producción, en lugar de por un anuncio.
Lo que traes
El calendario de retirada y la API de modelos exponen los datos en un contrato estable. Las organizaciones maduras agregan una capa de notificación interna delgada en la parte superior para enrutarla a los propietarios adecuados.
Fase 2: Evaluación
El propósito de la fase de evaluación es elegir el modelo de destino candidato y confirmar que se puede ejecutar: en la región correcta, con el tipo de implementación adecuado, con cuota suficiente y que esté disponible junto con el modelo actual para que siga siendo posible revertir. Un resultado satisfactorio es una elección clara entre los modelos candidatos, con la región, el SKU, la cuota y el coste confirmados antes de iniciar el ajuste.
Lo que debes tener en cuenta
- Calidad y posicionamiento entre candidatos. Cuando varios modelos están en uso, decida cuál se adapta mejor a su carga de trabajo por su calidad, no solo cuál obtiene la puntuación más alta en una comparativa pública.
- Coste en tu propio tráfico. La estructura de precios cambia entre generaciones de modelos. Los tokens de razonamiento, las entradas almacenadas en caché y la sobrecarga de la salida estructurada pueden duplicar o incluso multiplicar por más de dos la economía unitaria, por lo que debes calcular el coste mensual del proyecto basándote en el tráfico histórico y no solo en el precio de catálogo.
- Disponibilidad operativa. Confirme la región, la SKU y la cuota, y que el destino se pueda ejecutar en paralelo con el origen para mantener una ruta de reversión.
- Control de cumplimiento En el caso de las cargas de trabajo reguladas, la certificación y la disponibilidad regional pueden filtrar la lista candidata antes de que la calidad entre en la conversación.
Dónde se interrumpe normalmente
La parálisis de elección se establece en cuando varios candidatos tienen un posicionamiento poco claro. Los equipos descubren solo a mitad de la planificación que el modelo elegido no está disponible en su región o para su SKU. O bien, una proyección de costos revela que el nuevo modelo es materialmente más caro en el tráfico real.
Lo que traes
Los benchmarks se calculan sobre conjuntos de datos públicos, así que considere la clasificación como un filtro en lugar de la meta y confirme la preselección con su propia carga de trabajo. La proyección de costes sigue la misma lógica: la vista mensual se obtiene de tus propios registros de tokens, lo cual es sencillo una vez que tienes los datos del tráfico.
Fase 3: Adaptación
El propósito de la fase de adaptación es hacer que la carga de trabajo funcione bien en el nuevo modelo. Vuelva a reproducir primero la carga de trabajo existente (para aislar los cambios de comportamiento controlados por modelos), diagnostique lo que ha cambiado y vuelva a diseñar de forma iterativa. Un resultado satisfactorio es una comparación lado a lado del comportamiento frente a tráfico real o representativo, con cada cambio registrado.
Adapt es más que la edición de solicitudes
Las instrucciones son la parte más visible, pero una migración suele afectar también a otros cuatro aspectos:
-
Parámetros.
temperature,top_p,max_tokens, y los controles de esfuerzo de razonamiento no se corresponden de forma exacta entre generaciones, y es posible que las familias de modelos más recientes no admitan algunos parámetros. - Definiciones de herramientas. Es posible que tenga que volver a escribir o ajustar los nombres de argumento, las descripciones y los campos obligatorios que guiaron el modelo anterior de forma confiable.
- Esquemas de salida. Los modelos difieren en cómo se adhieren a la salida estructurada. Es posible que necesite añadir restricciones explícitas a un esquema que el modelo anterior solo respetaba de forma laxa, o quizá por fin pueda imponer un esquema.
- Código de llamada Diferencias entre la superficie de la API y el SDK (Chat Completions frente a Responses, formato de streaming y campos de solicitud nuevos o renombrados). También es posible que tenga que actualizar el análisis posterior que daba por sentado el formato de respuesta anterior.
En las cargas de trabajo agénticas y de flujo de trabajo, el trabajo de esquemas y de invocación de herramientas suele superar al trabajo relacionado con las solicitudes.
Lo que debes tener en cuenta
- Reproduce de nuevo sin cambios antes de ajustar. Ejecute la configuración actual en el modelo de destino sin cambios. Este enfoque le ayuda a separar el comportamiento que ha cambiado el modelo de los cambios que introduce y proporciona una línea base.
- Mira lo que realmente cambia. El nivel de detalle, la profundidad del razonamiento, el cumplimiento del formato de salida estructurado, el formato de las llamadas a herramientas, el comportamiento de rechazo y la variabilidad de la latencia suelen cambiar.
- Reproducir trazas reales para detectar regresiones en las llamadas de herramientas. Los campos adicionales, los argumentos renombrados y los cambios en la secuenciación solo afloran en trazas reales, no en evaluaciones de un solo turno.
- Realice un seguimiento de los cambios. La nueva ingeniería rápida es fácil de hacer y fácil de perder. Mantenga el original y registre lo que cambió y por qué.
Características de fabricación
Tres características de Foundry respaldan esta fase:
- Prompt Optimizer es el botón Optimizar directamente debajo del campo de instrucciones del sistema en el área de juegos del agente. Reestructura las instrucciones mediante procedimientos recomendados de ingeniería de mensajes, muestra el razonamiento por párrafo para cada cambio y admite un bucle iterado: agregue una sugerencia como "mantener el esquema JSON exactamente" y vuelva a optimizar. Disponible solo en Foundry, no Azure OpenAI.
- La optimización del agente ajusta las instrucciones, las herramientas y la selección de modelos juntas para las cargas de trabajo del agente. Disponible solo en Foundry, no Azure OpenAI.
- El simulador genera entradas sintéticas y antagónicas cuando no tiene datos de producción para reproducirlos.
Dónde se interrumpe normalmente
En el caso de las cargas de trabajo insertadas y orientadas al producto, esta fase suele tardar más tiempo porque el bucle de diagnóstico es manual: los equipos vuelven a ejecutar mensajes, comparan las diferencias y rara vez registran lo que han cambiado o por qué.
Lo que traes
- Comience con los optimizadores y, a continuación, compruebe. Aplican procedimientos recomendados generales en un solo paso en lugar de adaptarse al conjunto de datos y optimizan el texto de instrucción en lugar de definiciones de herramientas o esquemas de salida. Considere la salida como un borrador sólido: copie primero su prompt original (no hay historial de versiones) y luego vuelva a evaluarlo con su conjunto de datos fijado antes de dar por bueno el cambio.
- Planifique más trabajo manual para los traslados entre familias. No hay ningún flujo de "optimización para el modelo de destino X", por lo que el traslado entre familias de modelos implica la traducción deliberada de mensajes y esquemas.
- Registre el tráfico antes de que lo necesite. La reproducción solo es tan buena como la captura y la captura de contenido es opcional y nunca retroactiva.
Fase 4: Verificar
El propósito de la fase de validación es decidir si la carga de trabajo adaptada es segura para enviarla puntándola con un índice de calidad en un conjunto de datos mantenido. La rúbrica puede basarse en reglas, en una referencia, en un LLM que actúa como juez, en una revisión humana o en un marco específico de un dominio. Un resultado satisfactorio es entregar una batería de evaluación fiable, ejecutada sobre un conjunto de datos congelado, en la que tanto el equipo de la aplicación como los revisores puedan confiar.
Validar es una fase, pero tiene dos puntos de contacto, así que no la trates como un único evento al final del proceso:
- Prepárese temprano. Fija el conjunto de datos y los criterios de éxito en Antes de migrar, antes de adaptar. El momento en que cambian, el origen y el destino dejan de ser comparables.
- Puerta tarde, en dos pases. En primer lugar, ejecute el modelo actual en el conjunto inmovilizado para establecer una línea base de origen, el número que tiene que superar. A continuación, evalúa el objetivo en el mismo conjunto y toma una decisión.
Lo que debes tener en cuenta
- Mantenga el conjunto de datos y los criterios sin cambios. Esta es la única materia más importante en el proceso para mantener los resultados comparables.
- Mida las tres dimensiones que se corresponden con la aprobación final: calidad (puntuaciones del evaluador o del revisor), latencia (tiempo hasta el primer token y rendimiento, aislados a la llamada que está migrando) y coste (coste de los tokens de entrada y salida por solicitud).
- Haga coincidir la rúbrica con la carga de trabajo. Una rúbrica de resumen clínico, una afirmación sobre la secuenciación de llamadas a herramientas para agentes, o señales preexistentes de retroalimentación de usuario podrían ser más significativas que una puntuación genérica.
- Trate la puerta como una señal para los equipos nativos de IA. En lugar de una evaluación puntual de aprobado/suspenso, la evaluación se ejecuta continuamente, con cada confirmación de cambios, y se integra con Roll out.
Características de fabricación
Dos funcionalidades de Foundry respaldan esta fase:
- SDK de evaluación de Azure AI incluye más de 30 evaluadores integrados, que abarcan el arraigo, la relevancia, la capacidad de recuperación, la coherencia, la fluidez, las métricas basadas en referencias (F1, BLEU y ROUGE), la seguridad y los evaluadores de agentes y de Azure OpenAI. También incluye un LLM personalizado que actúa como juez para rúbricas específicas de la tarea.
- La evaluación del portal ejecuta los mismos evaluadores sobre los destinos de modelo, agente, conjunto de datos y seguimiento.
Ejecute el mismo conjunto de evaluadores sobre la fuente y el destino en el conjunto de datos congelado para que las cifras sean comparables.
| Dimension | Qué medir | Where |
|---|---|---|
| Quality | Puntuaciones del evaluador en el texto fuente frente al texto de destino | SDK de evaluación de IA de Azure, evaluación del portal |
| Latencia | Tiempo a primer token y rendimiento | Tabla de clasificación comparativa, métricas operativas |
| Cost | Costo del token de entrada y salida por solicitud | Salidas de evaluación, precios del modelo |
Dónde se interrumpe normalmente
La mayoría de los equipos no tienen una suite de evaluación, y los que sí la tienen a menudo la han desarrollado ellos mismos. Para las cargas de trabajo reguladas, se añade por encima una revisión humana o de gestión de la calidad obligatoria y se convierte en el cuello de botella. Estas migraciones se quedan atascadas en Validate, no en Adapt.
Lo que traes
Los evaluadores están listos para ejecutarse, pero elaborar un conjunto de pruebas relevante para el dominio a partir de su propio tráfico de producción requiere trabajo manual en el caso de las cargas de trabajo de modelos (sin agentes). Esta necesidad es la razón por la que el paso de preparación paga por sí mismo.
Fase 5: Implementación
El propósito de esta fase es promover la configuración validada a la producción en fases: primero no producción, luego un porcentaje controlado o ponderado y, a continuación, una exposición más amplia. A lo largo de todo, vea la latencia en vivo, los errores y, idealmente, la calidad con respecto a la línea de base de migración previa. A continuación, confirme o revierte. Un resultado correcto es una exposición gradual a través del tráfico controlado, ponderado o sombreado, una señal de calidad activa más allá de la latencia y los errores, y una ruta de reversión conservada.
Lo que debes tener en cuenta
- Conozca el tipo de implementación. El tipo de implementación determina la mecánica: las implementaciones de la familia Estándar pueden actualizarse automáticamente según una programación que controle. Las implementaciones aprovisionadas, por lotes y optimizadas se migran manualmente. En la tabla siguiente se muestran los mecanismos por tipo.
- Conserva un corredor de reversión. Mantén accesible el despliegue antiguo hasta que estés seguro. Las decisiones de reversión forzadas por una fecha límite de desuso en lugar de por evidencia son un signo de advertencia que inició demasiado tarde.
- Cuando no se puede activar, use el modo de sombra o reflejo. Los flujos regulados (PHI, transacciones financieras) a menudo no pueden exponer un nuevo modelo al tráfico real de los clientes. El equivalente está ejecutando el nuevo modelo en entradas de producción sin conexión y comparando salidas con el modelo anterior sin afectar a los usuarios.
- Vigile las regresiones que la evaluación sin conexión no detectó. La latencia del usuario real y el comportamiento de los casos perimetrales solo pueden mostrarse bajo carga de producción.
Mecanismos de migración por tipo de implementación
| Tipo de implementación | Enfoque de migración | Quota |
|---|---|---|
| Estándar, Estándar global, Estándar de zona de datos | Actualización automática según una programación gradual. Control de tiempo con versionUpgradeOption (OnceNewDefaultVersionAvailable, OnceCurrentVersionExpiredo NoAutoUpgrade). El procesamiento prioritario sigue el mismo recorrido. |
Se conserva automáticamente |
| provisionado | Manual: local (el tráfico se redirige durante un intervalo de 20 a 30 minutos) o en paralelo (nuevo despliegue, redirigir el tráfico y eliminar el anterior). | Asegúrese primero de que dispone de la cuota del modelo de destino. |
| Batch | En paralelo: implemente el nuevo modelo, vuelva a enviar trabajos y, a continuación, retire la implementación anterior. | Garantizar la cuota del modelo de destino |
| Ajuste fino (fuera del ámbito de este artículo) | No se actualiza automáticamente; plazos de retirada independientes para el entrenamiento y el despliegue. Vuelva a ajustar o destilar en el modelo base de reemplazo. | Garantizar la cuota del modelo de destino |
Después de desviar el tráfico, configure la evaluación continua para evaluar un porcentaje muestreado del tráfico de producción en el panel de Foundry Observability, conectado a las trazas para el análisis de la causa raíz, además de alertas de Azure Monitor cuando la calidad disminuya.
Dónde se interrumpe normalmente
Las regresiones de calidad que la evaluación offline no detectó aparecen bajo carga en producción. Las decisiones de reversión suelen ser forzadas por una fecha límite de desuso en lugar de por evidencia, lo que es un signo de que la migración se inició demasiado tarde.
Lo que traes
El enrutamiento ponderado entre dos despliegues se implementa en tu propio gateway o en la capa de aplicación, y el periodo de reversión es una decisión deliberada para mantener activo el despliegue anterior durante un tiempo (los equipos de sistemas embebidos normalmente quieren unos 30 días). Ambos vale la pena diseñarlos una vez y reutilizarlos en cada migración.
Fase 6: Retirar
El propósito de la fase de retirada es desmantelar el despliegue anterior, liberar capacidad, archivar los artefactos de evaluación y comunicar el cambio a la documentación de cara al cliente, las páginas de marketing, los procedimientos operativos de soporte y los registros de auditoría cuando se exija su conservación. Al final, el despliegue anterior ya no existe, el número de despliegues tiende a disminuir y las lecciones aprendidas se trasladan al siguiente ciclo.
Lo que debes tener en cuenta
- Tratar el retiro como un proceso de gobernanza, no solo como una limpieza. En el caso de las cargas de trabajo reguladas, las obligaciones de retención pueden requerir mantener los artefactos durante años.
- Confirme que la fuente realmente ha desaparecido. Compruebe que se ha retirado la versión anterior y elimine la implementación para que deje de consumir capacidad.
- Aplica lo aprendido en adelante. Reincorpora las trazas de producción recientes a tu conjunto de datos de referencia para que la migración siguiente resulte más barata.
Dónde se interrumpe normalmente
Los equipos omiten la retirada, lo que conduce a una acumulación de implementaciones zombis. Los equipos que no se retiran activamente llevan mucho más implementaciones activas que sus compañeros, y la mayoría de ese recuento es residuos estructurales de migraciones anteriores. Un subproceso común que falta es la comunicación: la documentación de marketing y producto sigue haciendo referencia al modelo anterior después del intercambio.
Lo que traes
El panel de observabilidad muestra que el número de despliegues está disminuyendo, pero decidir cuáles de esos despliegues siguen soportando carga es una decisión que debe tomar vuestro equipo. Haga que la retirada sea una tarea de seguimiento explícita en lugar de una esperanza.
La migración rara vez es binaria
Las migraciones reales suelen ser de estado dividido: parte de la carga de trabajo se ejecuta en el nuevo modelo, mientras una vía sensible a la latencia o de mayor riesgo sigue en el modelo anterior, a veces durante semanas. Planee la implementación parcial y la reversión parcial en lugar de un solo cambio del modelo anterior al nuevo. La retirada suele ir por detrás del despliegue con semanas o meses de retraso, y esos despliegues antiguos que siguen activos son los que se manifiestan como proliferación.
Contenido relacionado
- Comprenda la desaprobación y los plazos de soporte en la política de soporte y ciclo de vida de Foundry Models
- Consulte las fechas de retirada y las sustituciones en el calendario de retirada del modelo
- Vea lo que ya se ha retirado en Modelos retirados de Microsoft Foundry.
- Comparación de modelos candidatos con pruebas comparativas de modelos y tablas de clasificación
- Adaptación de avisos a un nuevo modelo con optimización de mensajes con el optimizador de mensajes
- Validar la calidad antes de cambiar mediante la ejecución de evaluaciones desde el portal de Foundry
- Supervisa la carga de trabajo migrada con Observabilidad en IA generativa