La evaluación establece una línea base de calidad para el agente y le permite establecer umbrales de aceptación, como una tasa de superación de cumplimiento de tareas, antes de liberar los cambios en los usuarios.
Cada paso ofrece cinco rutas de acceso. Use lo que prefiera:
La evaluación se realiza sobre un agente invocable desplegado. Asegúrese de que el agente esté desplegado y disponible antes de configurar la evaluación.
En el azd directorio del proyecto, compruebe que el agente está implementado e invocable:
azd ai agent show
Enviar un prompt de prueba:
azd ai agent invoke "Write a haiku about deploying cloud applications."
Debería ver una respuesta en unos segundos.
- Abra el portal de Foundry y vaya al proyecto.
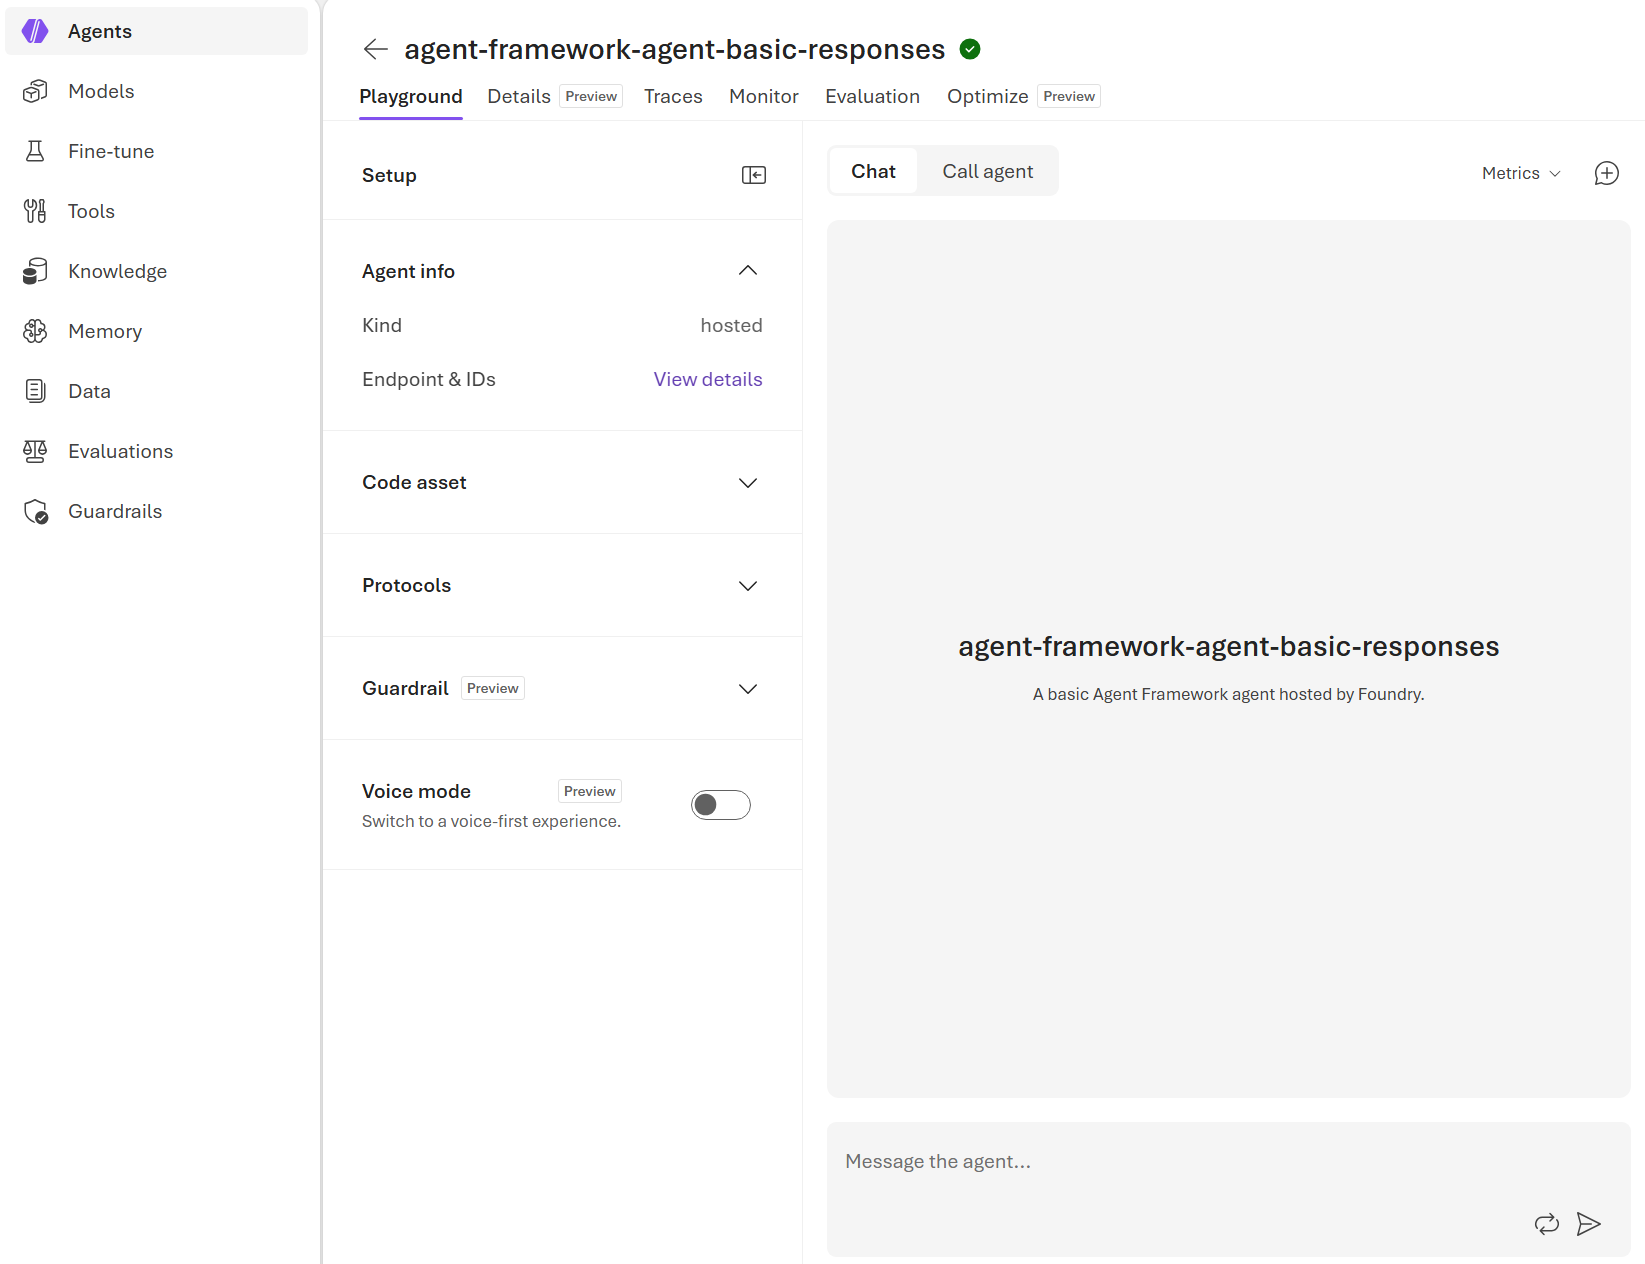
- Seleccione el agente y, a continuación, seleccione la pestaña Playground.
- Envío de un mensaje de prueba, como
Write a haiku about deploying cloud applications.
Debería ver una respuesta en unos segundos.
Instale el SDK de Foundry:
pip install "azure-ai-projects>=2.0.0" azure-identity
Establezca dos variables de entorno y, a continuación, cree el cliente del proyecto. Establezca FOUNDRY_PROJECT_ENDPOINT en el punto de conexión del proyecto y FOUNDRY_MODEL_NAME en una implementación de finalización de chat para usarla como modelo de evaluación. En los ejemplos de código siguientes se supone que los ejecuta en este contexto:
import os
from azure.identity import DefaultAzureCredential
from azure.ai.projects import AIProjectClient

endpoint = os.environ["FOUNDRY_PROJECT_ENDPOINT"]
model_deployment = os.environ["FOUNDRY_MODEL_NAME"]

credential = DefaultAzureCredential()
project_client = AIProjectClient(endpoint=endpoint, credential=credential)
client = project_client.get_openai_client()
Confirmar que el agente desplegado está registrado y disponible. Reemplace por <your-agent-name> el nombre del agente hospedado:
agent = project_client.agents.get("<your-agent-name>")
print(f"Found agent: {agent.name}")
La llamada devuelve el agente si existe o genera un error si el nombre es incorrecto o el agente no está desplegado.
Instale el SDK de Foundry y el cliente de evals de OpenAI:
dotnet add package Azure.AI.Projects --prerelease
dotnet add package OpenAI
dotnet add package Azure.Identity
Establezca dos variables de entorno y, a continuación, cree los clientes. Establezca FOUNDRY_PROJECT_ENDPOINT en el punto de conexión del proyecto y FOUNDRY_MODEL_NAME en una implementación de finalización de chat para usarla como modelo de evaluación. En los ejemplos de código siguientes se supone que los ejecuta en este contexto:
using System.ClientModel;
using System.Text.Json;
using Azure.AI.Projects;
using Azure.AI.Projects.Agents;
using Azure.Core;
using Azure.Identity;
using OpenAI;
using OpenAI.Evals;

#pragma warning disable AAIP001, OPENAI001

var endpoint = Environment.GetEnvironmentVariable("FOUNDRY_PROJECT_ENDPOINT")!;
var modelDeployment = Environment.GetEnvironmentVariable("FOUNDRY_MODEL_NAME")!;

var credential = new DefaultAzureCredential();
AIProjectClient projectClient = new(new Uri(endpoint), credential);

// OpenAI-compatible evals client bound to the Foundry project endpoint.
// A Microsoft Entra token works as the credential because both use "Authorization: Bearer".
var token = credential.GetToken(new TokenRequestContext(["https://ai.azure.com/.default"])).Token;
EvaluationClient evalClient = new(
    new ApiKeyCredential(token),
    new OpenAIClientOptions { Endpoint = new Uri($"{endpoint}/openai/v1") });
Confirmar que el agente desplegado está registrado y disponible. Reemplace por <your-agent-name> el nombre del agente hospedado:
ProjectsAgentRecord agent = projectClient.AgentAdministrationClient.GetAgent("<your-agent-name>");
Console.WriteLine($"Found agent: {agent.Name}");
La llamada devuelve el agente si existe o genera un error si el nombre es incorrecto o el agente no está desplegado.
Instale el SDK de Foundry:
npm install @azure/ai-projects @azure/identity dotenv
Establezca dos variables de entorno y, a continuación, cree el cliente del proyecto. Establezca FOUNDRY_PROJECT_ENDPOINT en el punto de conexión del proyecto y FOUNDRY_MODEL_NAME en una implementación de finalización de chat para usarla como modelo de evaluación. En los ejemplos de código siguientes se supone que los ejecuta en este contexto:
import { DefaultAzureCredential } from "@azure/identity";
import { AIProjectClient } from "@azure/ai-projects";
import "dotenv/config";

const endpoint = process.env["FOUNDRY_PROJECT_ENDPOINT"] || "";
const modelDeployment = process.env["FOUNDRY_MODEL_NAME"] || "";

const projectClient = new AIProjectClient(
  endpoint,
  new DefaultAzureCredential(),
);
const client = projectClient.getOpenAIClient();
Confirmar que el agente desplegado está registrado y disponible. Reemplace por <your-agent-name> el nombre del agente hospedado:
const agent = await projectClient.agents.get("<your-agent-name>");
console.log(`Found agent: ${agent.name}`);
La llamada devuelve el agente si existe o genera un error si el nombre es incorrecto o el agente no está desplegado.
Referencia: clase AIProjectClient
Empiece con evaluadores integrados para evaluar su agente con un conjunto de datos de prueba.
En primer lugar, cree un archivo JSONL de consultas de prueba para el agente. Cada línea es un objeto JSON con un query campo. Guárdelo dentro de la carpeta fuente del agente, con el nombre src/<your-agent-name>/tests/queries.jsonl:
{"query": "Write a haiku about deploying cloud applications."}
A continuación, cree un eval.yaml archivo en la misma carpeta de origen del agente, que src/<your-agent-name>/eval.yaml. Apunta al conjunto de datos y enumera los evaluadores integrados que se van a aplicar. La dataset.local_uri ruta es relativa a esta carpeta. Reemplace <your-agent-name> por el nombre de su agente alojado y <your-chat-completion-deployment> por la implementación del modelo de juez:
name: agent-eval
agent:
  name: <your-agent-name>
  kind: hosted
dataset:
  local_uri: tests/queries.jsonl
evaluators:
  - builtin.intent_resolution
  - builtin.task_adherence
options:
  eval_model: <your-chat-completion-deployment>
max_samples: 15
El valor de eval_model es el modelo evaluador que puntúa las respuestas; puede reutilizar el despliegue que ya usa su agente.
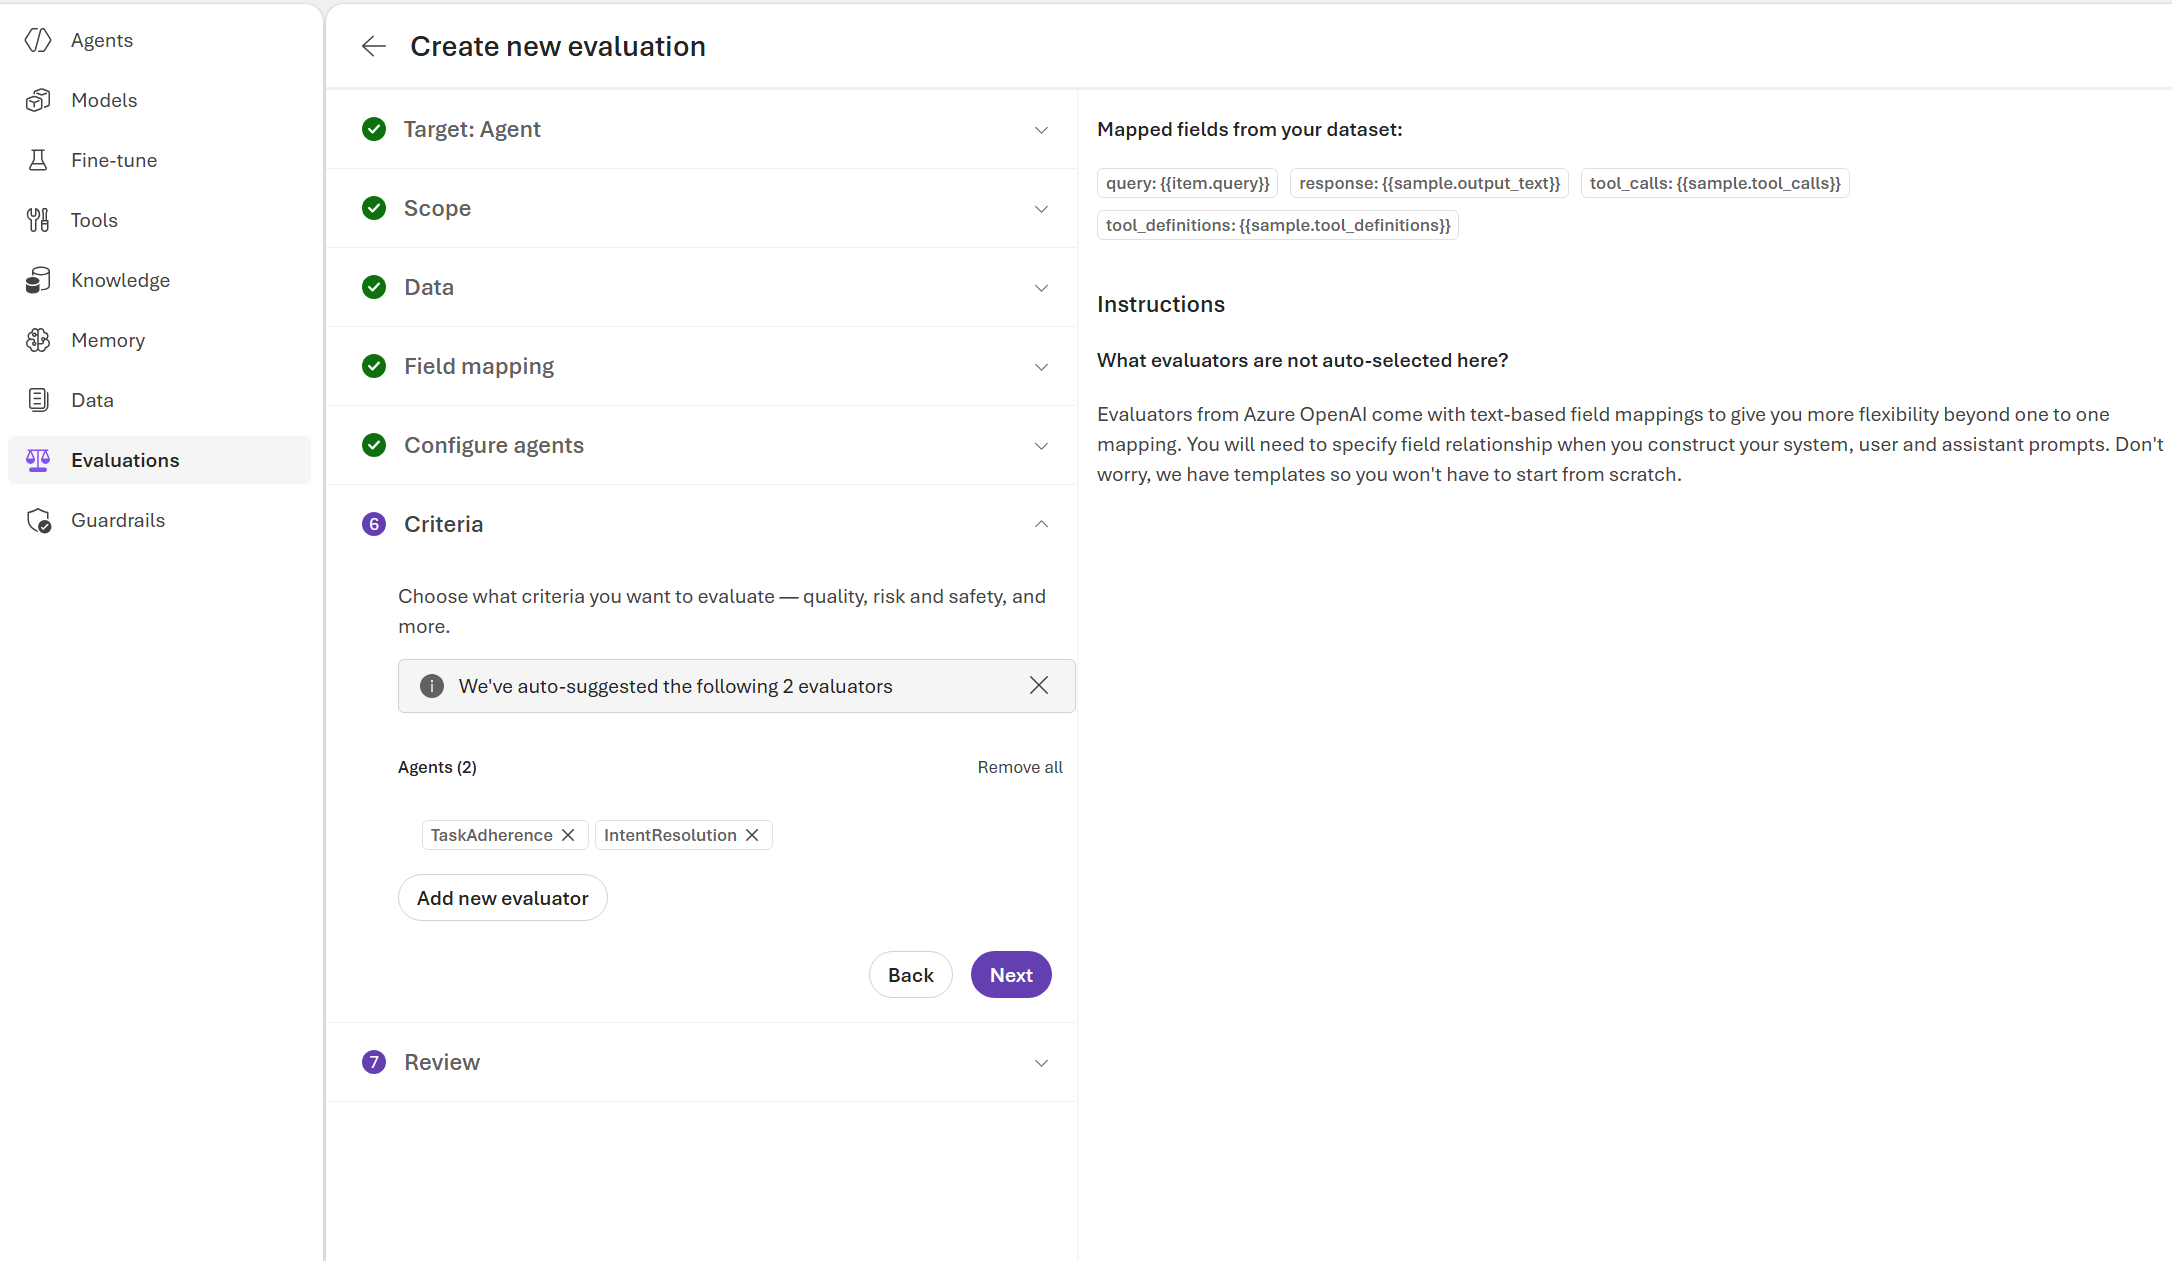
- En el portal de Foundry, abra el agente y seleccione la pestaña Evaluación y, a continuación, seleccione Crear.
- En Seleccionar destino de evaluación, seleccione Agente.
- En Seleccionar ámbito de evaluación, seleccione Turnos individuales.
- En Seleccionar origen de datos, seleccione Conjunto de datos existente y elija un archivo CSV o JSONL de consultas de prueba de los recursos de datos del proyecto.
- Si aparece el paso Configurar agentes , revise el agente y acepte el mensaje de usuario predeterminado,
{{item.query}}. Ajústelo solo si el agente espera un formato de entrada diferente.
- En Seleccionar criterios de prueba, seleccione uno o varios evaluadores de agentes, como Cumplimiento de tareas y Resolución de intenciones.
Mantenga abierto el asistente. La evaluación se envía en el siguiente paso.
En primer lugar, cree un archivo JSONL de consultas de prueba para el agente. Cada línea es un objeto JSON con un query campo. Guárdelo como queries.jsonl:
{"query": "Write a haiku about deploying cloud applications."}
Cargue el archivo como un conjunto de datos en el proyecto:
dataset = project_client.datasets.upload_file(
    name="agent-test-queries",
    version="1",
    file_path="./queries.jsonl",
)
A continuación, seleccione evaluadores integrados y asigne sus entradas. El data_mapping parámetro indica a cada evaluador dónde encontrar la consulta y la respuesta del agente. Los evaluadores asistidos por IA necesitan un modelo de evaluación en initialization_parameters; el valor debe ser una implementación de finalización de chat en el proyecto.
from azure.ai.projects.models import TestingCriterionAzureAIEvaluator

testing_criteria = [
    TestingCriterionAzureAIEvaluator(
        type="azure_ai_evaluator",
        name="Intent Resolution",
        evaluator_name="builtin.intent_resolution",
        initialization_parameters={"model": model_deployment},
        data_mapping={
            "query": "{{item.query}}",
            "response": "{{sample.output_items}}",
        },
    ),
    TestingCriterionAzureAIEvaluator(
        type="azure_ai_evaluator",
        name="Task Adherence",
        evaluator_name="builtin.task_adherence",
        initialization_parameters={"model": model_deployment},
        data_mapping={
            "query": "{{item.query}}",
            "response": "{{sample.output_items}}",
        },
    ),
]
Cree la evaluación. Define el esquema de datos de prueba y los criterios de prueba, y actúa como contenedor para una o varias ejecuciones:
from openai.types.eval_create_params import DataSourceConfigCustom

data_source_config = DataSourceConfigCustom(
    type="custom",
    item_schema={
        "type": "object",
        "properties": {"query": {"type": "string"}},
        "required": ["query"],
    },
    include_sample_schema=True,
)

evaluation = client.evals.create(
    name="Agent Quality Evaluation",
    data_source_config=data_source_config,
    testing_criteria=testing_criteria,
)
print(f"Evaluation created: {evaluation.id}")
En primer lugar, cree un archivo JSONL de consultas de prueba para el agente. Cada línea es un objeto JSON con un query campo. Guárdelo como queries.jsonl:
{"query": "Write a haiku about deploying cloud applications."}
Cargue el archivo como un conjunto de datos en el proyecto:
AIProjectDataset dataset = projectClient.Datasets.UploadFile(
    name: "agent-test-queries",
    version: "1",
    filePath: "./queries.jsonl");
A continuación, seleccione evaluadores integrados y asigne sus entradas. El data_mapping parámetro indica a cada evaluador dónde encontrar la consulta y la respuesta del agente. Los evaluadores asistidos por IA necesitan un modelo de evaluación en initialization_parameters; el valor debe ser una implementación de finalización de chat en el proyecto.
var testingCriteria = new object[]
{
    new
    {
        type = "azure_ai_evaluator",
        name = "Intent Resolution",
        evaluator_name = "builtin.intent_resolution",
        initialization_parameters = new { model = modelDeployment },
        data_mapping = new { query = "{{item.query}}", response = "{{sample.output_items}}" },
    },
    new
    {
        type = "azure_ai_evaluator",
        name = "Task Adherence",
        evaluator_name = "builtin.task_adherence",
        initialization_parameters = new { model = modelDeployment },
        data_mapping = new { query = "{{item.query}}", response = "{{sample.output_items}}" },
    },
};
Cree la evaluación. Define el esquema de datos de prueba y los criterios de prueba, y actúa como contenedor para una o varias ejecuciones:
var createEvaluation = new
{
    name = "Agent Quality Evaluation",
    data_source_config = new
    {
        type = "custom",
        item_schema = new
        {
            type = "object",
            properties = new { query = new { type = "string" } },
            required = new[] { "query" },
        },
        include_sample_schema = true,
    },
    testing_criteria = testingCriteria,
};

ClientResult evaluationResult = evalClient.CreateEvaluation(
    BinaryContent.Create(BinaryData.FromObjectAsJson(createEvaluation)));
string evaluationId = JsonDocument.Parse(evaluationResult.GetRawResponse().Content.ToString())
    .RootElement.GetProperty("id").GetString()!;
Console.WriteLine($"Evaluation created: {evaluationId}");
En primer lugar, cree un archivo JSONL de consultas de prueba para el agente. Cada línea es un objeto JSON con un query campo. Guárdelo como queries.jsonl:
{"query": "Write a haiku about deploying cloud applications."}
Cargue el archivo como un conjunto de datos en el proyecto:
const dataset = await projectClient.datasets.uploadFile(
  "agent-test-queries",
  "1",
  "./queries.jsonl",
);
A continuación, seleccione evaluadores integrados y asigne sus entradas. El data_mapping parámetro indica a cada evaluador dónde encontrar la consulta y la respuesta del agente. Los evaluadores asistidos por IA necesitan un modelo de evaluación en initialization_parameters; el valor debe ser una implementación de finalización de chat en el proyecto.
const testingCriteria = [
  {
    type: "azure_ai_evaluator",
    name: "Intent Resolution",
    evaluator_name: "builtin.intent_resolution",
    initialization_parameters: { model: modelDeployment },
    data_mapping: {
      query: "{{item.query}}",
      response: "{{sample.output_items}}",
    },
  },
  {
    type: "azure_ai_evaluator",
    name: "Task Adherence",
    evaluator_name: "builtin.task_adherence",
    initialization_parameters: { model: modelDeployment },
    data_mapping: {
      query: "{{item.query}}",
      response: "{{sample.output_items}}",
    },
  },
];
Cree la evaluación. Define el esquema de datos de prueba y los criterios de prueba, y actúa como contenedor para una o varias ejecuciones:
const dataSourceConfig = {
  type: "custom",
  item_schema: {
    type: "object",
    properties: { query: { type: "string" } },
    required: ["query"],
  },
  include_sample_schema: true,
};

const evaluation = await client.evals.create({
  name: "Agent Quality Evaluation",
  data_source_config: dataSourceConfig,
  testing_criteria: testingCriteria,
});
console.log(`Evaluation created: ${evaluation.id}`);
Ejecute la batería de pruebas con su agente implementado. El servicio envía cada consulta de prueba al agente, captura la respuesta y la puntúa con los evaluadores seleccionados.
Ejecute la evaluación desde la raíz del área de trabajo azd:
azd ai agent eval run --config eval.yaml
Note
azd ai agent eval run resuelve la ruta de acceso relativa a la --config carpeta de origen del agente en src/ (por ejemplo, src/<your-agent-name>/eval.yaml), no al directorio actual. Mantenga eval.yamly el conjunto de datos al que apunta local_uri , dentro de esa carpeta.
El comando lee eval.yaml, envía cada consulta al agente, puntúa las respuestas e imprime un resumen cuando finaliza:
Eval run started
   Eval: eval_b36748dede424e4ba3f8e6c99ca2cf27
   Run:  evalrun_5f72ef189ad24790a32128e6f230b131
   (✓) Done  Eval run

Results:    1 total, 1 passed, 0 failed, 0 errored

Per-criteria results:
  intent_resolution: 1 passed, 0 failed, 0 errored
  task_adherence: 1 passed, 0 failed, 0 errored
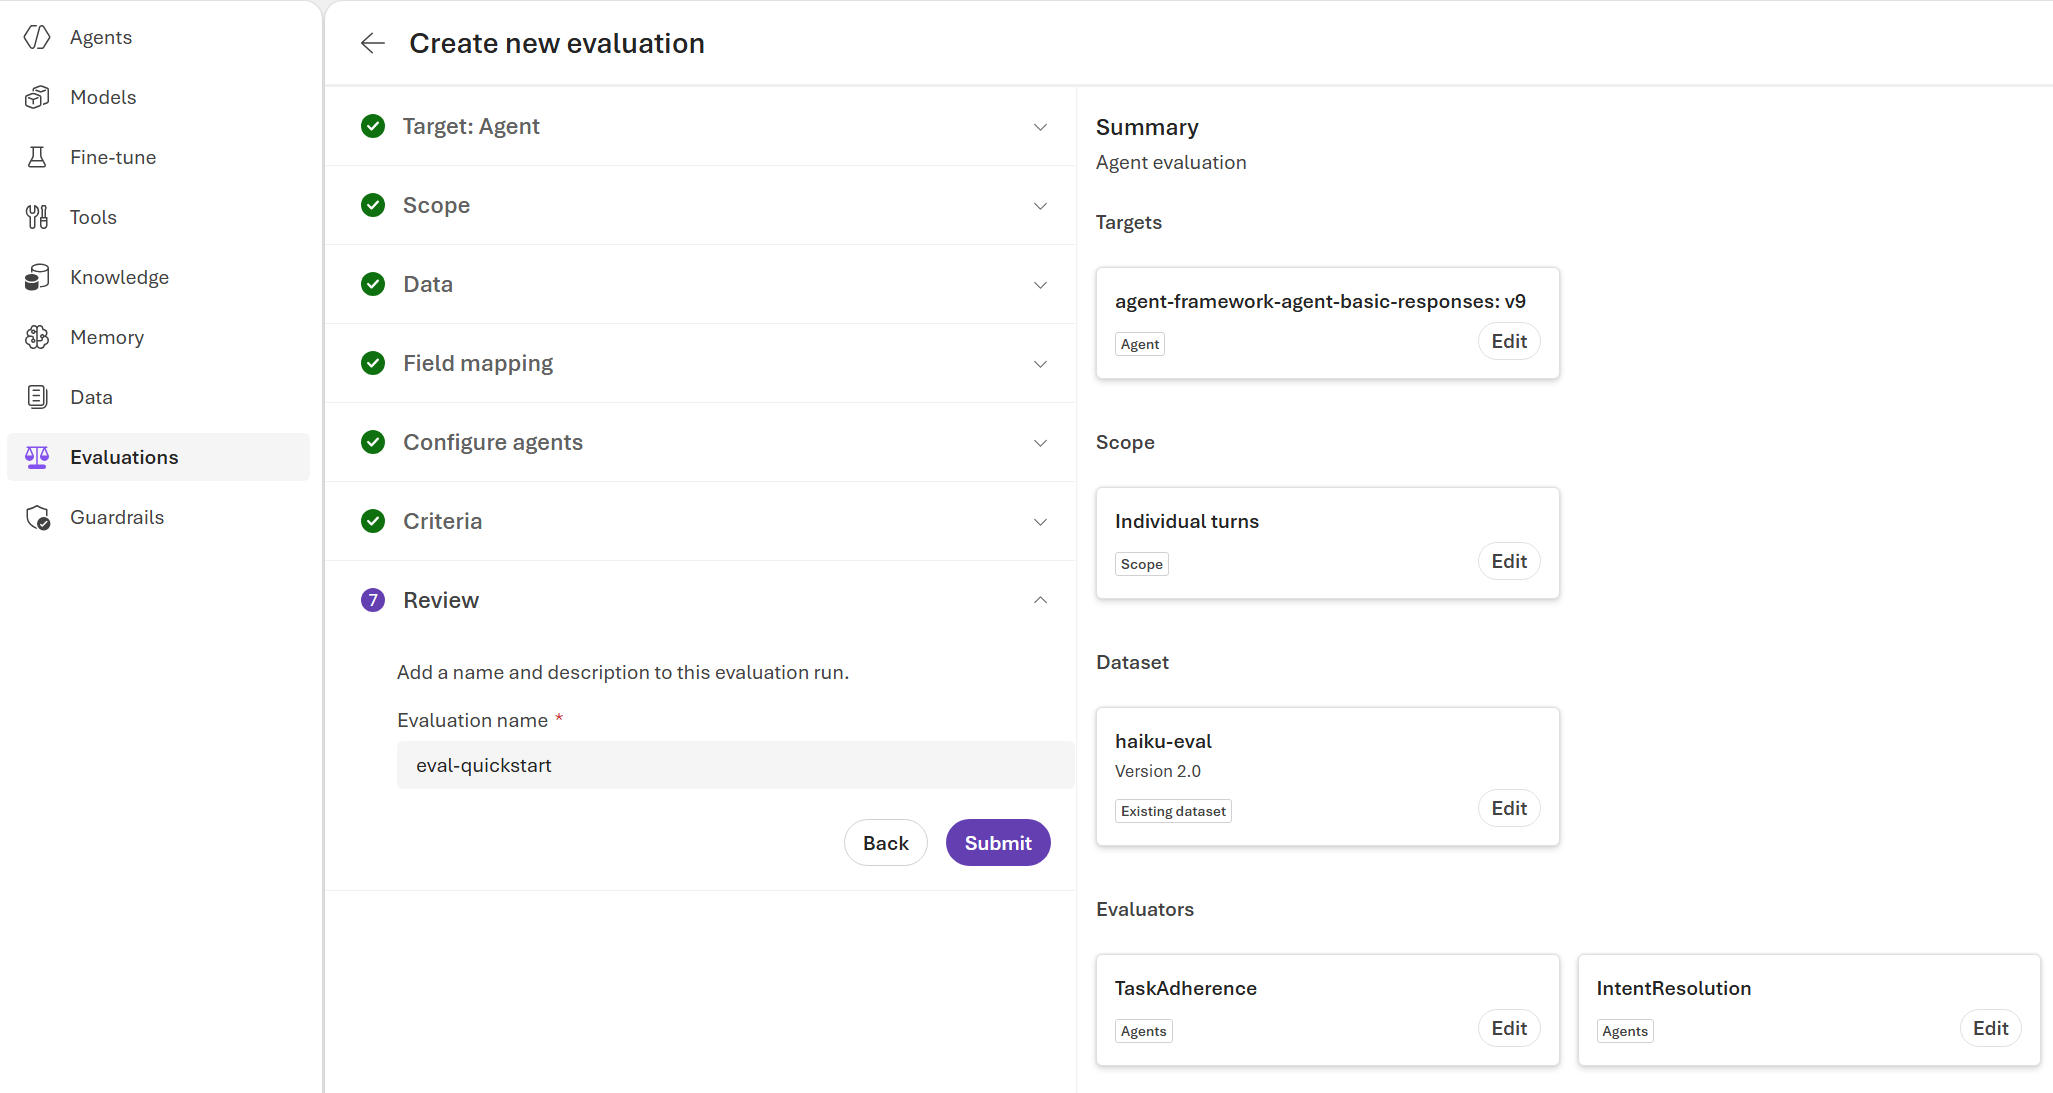
- En el paso Revisar y enviar , escriba un nombre para la evaluación.
- Revise el objetivo, el alcance, la fuente de datos y los evaluadores seleccionados.
- Seleccione Enviar para iniciar la ejecución.
Crea una ejecución que envíe cada consulta de prueba a su agente y aplique los evaluadores. Reemplace por <your-agent-name> el nombre del agente hospedado:
eval_run = client.evals.runs.create(
    eval_id=evaluation.id,
    name="Agent Evaluation Run",
    data_source={
        "type": "azure_ai_target_completions",
        "source": {"type": "file_id", "id": dataset.id},
        "input_messages": {
            "type": "template",
            "template": [
                {
                    "type": "message",
                    "role": "user",
                    "content": {"type": "input_text", "text": "{{item.query}}"},
                }
            ],
        },
        "target": {
            "type": "azure_ai_agent",
            "name": "<your-agent-name>",
            # "version": "1",  # Optional; omit to use the latest version
        },
    },
)

print(f"Evaluation run started: {eval_run.id}")
Crea una ejecución que envíe cada consulta de prueba a su agente y aplique los evaluadores. Reemplace por <your-agent-name> el nombre del agente hospedado:
var createRun = new
{
    name = "Agent Evaluation Run",
    data_source = new
    {
        type = "azure_ai_target_completions",
        source = new { type = "file_id", id = dataset.Id },
        input_messages = new
        {
            type = "template",
            template = new object[]
            {
                new { type = "message", role = "user", content = new { type = "input_text", text = "{{item.query}}" } },
            },
        },
        // Add a "version" property to the target to pin a specific agent version; omit to use the latest.
        target = new { type = "azure_ai_agent", name = "<your-agent-name>" },
    },
};

ClientResult runResult = evalClient.CreateEvaluationRun(
    evaluationId, BinaryContent.Create(BinaryData.FromObjectAsJson(createRun)));
string runId = JsonDocument.Parse(runResult.GetRawResponse().Content.ToString())
    .RootElement.GetProperty("id").GetString()!;
Console.WriteLine($"Evaluation run started: {runId}");
Crea una ejecución que envíe cada consulta de prueba a su agente y aplique los evaluadores. Reemplace por <your-agent-name> el nombre del agente hospedado:
const evalRun = await client.evals.runs.create(evaluation.id, {
  name: "Agent Evaluation Run",
  data_source: {
    type: "azure_ai_target_completions",
    source: { type: "file_id", id: dataset.id },
    input_messages: {
      type: "template",
      template: [
        {
          type: "message",
          role: "user",
          content: { type: "input_text", text: "{{item.query}}" },
        },
      ],
    },
    target: {
      type: "azure_ai_agent",
      name: "<your-agent-name>",
      // version: "1", // Optional; omit to use the latest version
    },
  },
});

console.log(`Evaluation run started: ${evalRun.id}`);
Las evaluaciones normalmente se completan en unos minutos, en función del número de consultas.
Enumerar las evaluaciones recientes:
azd ai agent eval list
    Eval ID                                Name        Status of last run  Runs
    -------                                ----        ------------------  ----
*   eval_b36748dede424e4ba3f8e6c99ca2cf27  agent-eval  Completed           1

* = active eval in current environment
Muestra la evaluación más reciente y sus ejecuciones:
azd ai agent eval show
Eval:   eval_b36748dede424e4ba3f8e6c99ca2cf27
Name:   agent-eval
Agent:  <your-agent-name>
Runs:   1

Recent runs:
  Run ID                                    Status     Passed  Failed  Created
  ------                                    ------     ------  ------  -------
  evalrun_5f72ef189ad24790a32128e6f230b131  Completed  1/1     0       2026-06-17 14:52 UTC
Utilice los resultados para confirmar qué versión del agente se evaluó y qué puntuaciones de evaluación se generaron. Para ver los detalles por evaluador y un vínculo al informe en el portal de Foundry, ejecute azd ai agent eval show <eval-id> --eval-run-id <run-id>.
- La página de detalles muestra el destino, el conjunto de datos, el estado, el uso de tokens y una puntuación de agregado para cada evaluador.
- Seleccione el nombre de ejecución para ver los resultados de nivel de fila: cada consulta, la respuesta del agente, la puntuación del evaluador y la explicación de la puntuación.
Compruebe periódicamente si ha finalizado y, a continuación, muestre el estado y la URL del informe que abre los resultados en el portal Foundry:
import time

while True:
    run = client.evals.runs.retrieve(run_id=eval_run.id, eval_id=evaluation.id)
    if run.status in ["completed", "failed"]:
        break
    time.sleep(5)

print(f"Status: {run.status}")
print(f"Report URL: {run.report_url}")
En el nivel de ejecución, puede ver recuentos agregados de aciertos y fallos para cada evaluador:
print(run.result_counts)
for criteria in run.per_testing_criteria_results:
    print(criteria.testing_criteria, "passed:", criteria.passed, "failed:", criteria.failed)
ResultCounts(errored=0, failed=0, passed=1, total=1, skipped=0)
Intent Resolution passed: 1 failed: 0
Task Adherence passed: 1 failed: 0
Para obtener detalles de nivel de fila, enumere los elementos de salida. Cada resultado incluye el nombre del evaluador, el paso o el error, y una puntuación:
for item in client.evals.runs.output_items.list(run_id=eval_run.id, eval_id=evaluation.id):
    for result in item.results:
        print(item.id, result.name, "passed:", result.passed, "score:", result.score)
Compruebe periódicamente si ha finalizado y, a continuación, muestre el estado y la URL del informe que abre los resultados en el portal Foundry:
JsonElement run = default;
while (true)
{
    ClientResult runStatus = evalClient.GetEvaluationRun(evaluationId, runId, options: null);
    run = JsonDocument.Parse(runStatus.GetRawResponse().Content.ToString()).RootElement;
    string status = run.GetProperty("status").GetString()!;
    if (status is "completed" or "failed") break;
    Thread.Sleep(TimeSpan.FromSeconds(5));
}

Console.WriteLine($"Status: {run.GetProperty("status").GetString()}");
Console.WriteLine($"Report URL: {run.GetProperty("report_url").GetString()}");
En el nivel de ejecución, puede ver recuentos agregados de aciertos y fallos para cada evaluador:
Console.WriteLine(run.GetProperty("result_counts").GetRawText());
foreach (JsonElement criteria in run.GetProperty("per_testing_criteria_results").EnumerateArray())
{
    Console.WriteLine(
        $"{criteria.GetProperty("testing_criteria").GetString()} " +
        $"passed: {criteria.GetProperty("passed").GetInt32()} " +
        $"failed: {criteria.GetProperty("failed").GetInt32()}");
}
Para obtener detalles de nivel de fila, enumere los elementos de salida. Cada resultado incluye el nombre del evaluador, el paso o el error, y una puntuación:
ClientResult outputItems = evalClient.GetEvaluationRunOutputItems(
    evaluationId, runId, limit: 100, order: null, after: null, outputItemStatus: null, options: null);
foreach (JsonElement item in JsonDocument.Parse(outputItems.GetRawResponse().Content.ToString())
    .RootElement.GetProperty("data").EnumerateArray())
{
    foreach (JsonElement result in item.GetProperty("results").EnumerateArray())
    {
        Console.WriteLine(
            $"{item.GetProperty("id").GetString()} {result.GetProperty("name").GetString()} " +
            $"passed: {result.GetProperty("passed")} score: {result.GetProperty("score")}");
    }
}
Compruebe periódicamente si ha finalizado y, a continuación, muestre el estado y la URL del informe que abre los resultados en el portal Foundry:
let run = evalRun;
while (!["completed", "failed"].includes(run.status)) {
  run = await client.evals.runs.retrieve(run.id, {
    eval_id: evaluation.id,
  });
  await new Promise((resolve) => setTimeout(resolve, 5000));
}

console.log(`Status: ${run.status}`);
console.log(`Report URL: ${run.report_url}`);
En el nivel de ejecución, puede ver recuentos agregados de aciertos y fallos para cada evaluador:
console.log(JSON.stringify(run.result_counts));
for (const criteria of run.per_testing_criteria_results) {
  console.log(
    criteria.testing_criteria,
    "passed:",
    criteria.passed,
    "failed:",
    criteria.failed,
  );
}
{"errored":0,"failed":0,"passed":1,"total":1,"skipped":0}
Intent Resolution passed: 1 failed: 0
Task Adherence passed: 1 failed: 0
Para obtener detalles de nivel de fila, enumere los elementos de salida. Cada resultado incluye el nombre del evaluador, el paso o el error, y una puntuación:
for await (const item of client.evals.runs.outputItems.list(run.id, {
  eval_id: evaluation.id,
})) {
  for (const result of item.results) {
    console.log(item.id, result.name, "passed:", result.passed, "score:", result.score);
  }
}
En este inicio rápido se registra un conjunto de datos, una evaluación y un historial de ejecución en el proyecto Foundry. Estos recursos conllevan poco o ningún costo continuo.
