Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Los cuadernos de Microsoft Fabric admiten una interacción perfecta con los datos de Lakehouse mediante Pandas, la biblioteca de Python más popular para la exploración y el procesamiento de datos. En un cuaderno, puedes leer y volver a escribir datos rápidamente en tus recursos de Lakehouse en varios formatos de archivo. En esta guía se proporcionan ejemplos de código que le ayudarán a empezar a trabajar en su propio cuaderno.
Requisitos previos
Obtenga una suscripción a Microsoft Fabric. También puede registrarse para obtener una evaluación gratuita de Microsoft Fabric.
Inicie sesión en Microsoft Fabric.
Cambie a Fabric mediante el conmutador de experiencia en el lado inferior izquierdo de la página principal.
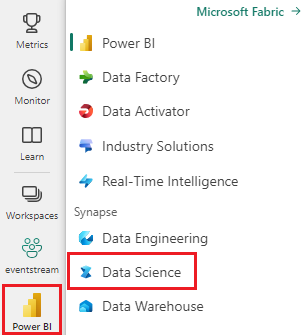
- Complete los pasos descritos en Preparación del sistema para tutoriales de ciencia de datos para crear un cuaderno y adjuntarlo a Lakehouse. Para este artículo, siga los pasos para crear un cuaderno en lugar de importar uno existente.
Utiliza este flujo de trabajo para elegir el patrón adecuado:
- Para archivos individuales en el Lakehouse, léalos o escríbalos con Pandas mediante una ruta dentro de
Files. - Para datos tipo tabla en un Lakehouse, usa tablas Spark y Delta, y luego convierte a Pandas solo cuando el resultado quepa en la memoria de tu cuaderno.
- Si los datos son grandes, guárdalos en Spark para filtrar, agregar y transformar antes de convertirlos a un DataFrame Pandas.
Carga de datos de Lakehouse en un cuaderno
Nota:
Necesita algunos datos en Lakehouse para seguir los pasos descritos en esta sección. Si no tiene datos, siga los pasos descritos en Descarga del conjunto de datos y carga en lakehouse para agregar el archivo churn.csv a Lakehouse.
Una vez que adjuntas un Lakehouse a tu portátil Microsoft Fabric, puedes explorar los datos almacenados sin salir de la página y copiar la ruta de archivo que necesitas para el código del cuaderno. En el explorador Lakehouse, puedes usar el fragmento generado del cuaderno para cargar un archivo en un DataFrame de Spark o Pandas, o copiar la ruta ABFS completa del archivo. Para el Lakehouse predeterminado adjunto al cuaderno, una ruta típica de Archivos se parece a /lakehouse/default/Files/.... Para otros Lakehouses, utiliza la ruta ABFS del explorador de Lakehouse.
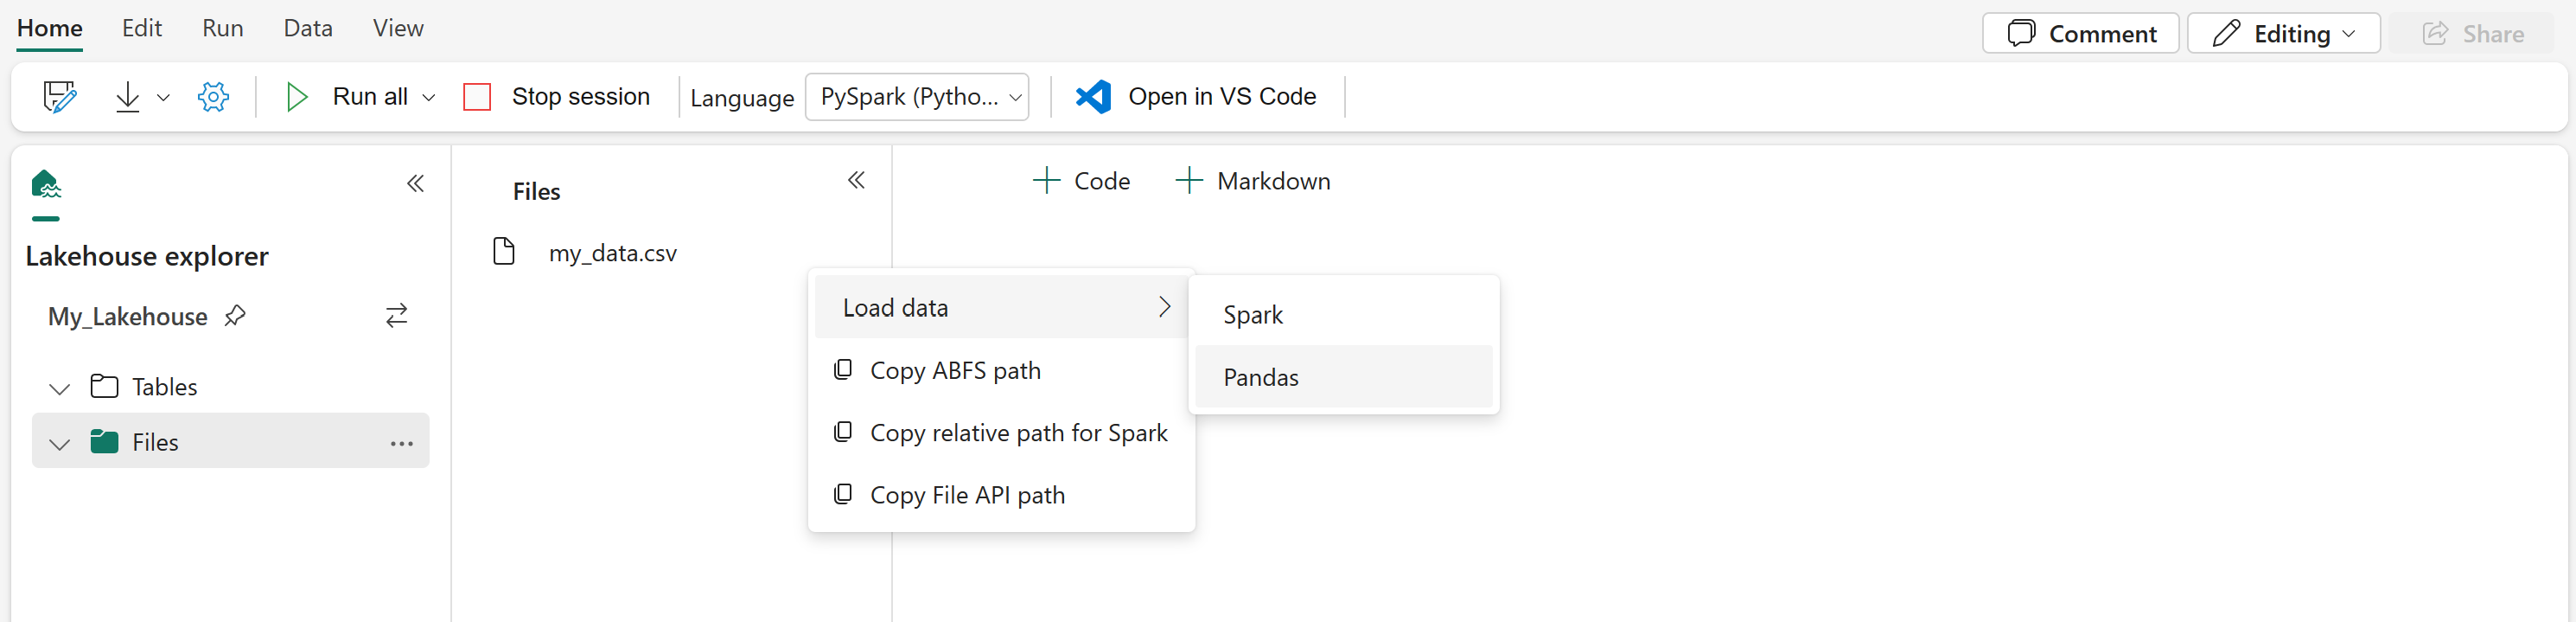
Seleccionar un archivo en el explorador Lakehouse puede generar código que carga el archivo en un DataFrame en tu libreta.

Conversión de un DataFrame de Spark en un DataFrame de Pandas
Importante
toPandas() carga el DataFrame completo de Spark en la memoria del controlador del portátil. Solo úsalo para conjuntos de resultados pequeños o medianos. Si tu conjunto de datos es grande, filtra, agrega o muestrea en Spark antes de convertirlo a Pandas.
Como referencia, este comando muestra cómo convertir un DataFrame de Spark en un DataFrame de Pandas.
# Replace "spark_df" with the name of your own Spark DataFrame
pandas_df = spark_df.toPandas()
Lectura y escritura de varios formatos de archivo
Nota:
Modificar la versión de un paquete específico podría interrumpir otros paquetes que dependen de él. Por ejemplo, la degradación de azure-storage-blob puede causar problemas con los Pandas y otras bibliotecas que se basan en Pandas, incluidas mssparkutils, fsspec_wrapper y notebookutils.
Puede ver la lista de los paquetes preinstalados y sus versiones para cada runtime aquí.
Estos ejemplos de código muestran las operaciones de Pandas para leer y escribir varios formatos de archivo. Estos ejemplos no están diseñados para ejecutarse secuencialmente como en un tutorial, sino que se copiarán y pegarán en su propio cuaderno según sea necesario.
Nota:
Debes reemplazar las rutas de archivo en estos ejemplos de código por la ruta completa del archivo en tu Lakehouse. Para el Lakehouse por defecto adjunto al cuaderno, utiliza una ruta como /lakehouse/default/Files/.... Para otros Lakehouses, usa la ruta ABFS desde el explorador de Lakehouse.
Lectura de datos de un archivo CSV
import pandas as pd

# Read a CSV file from your Lakehouse into a Pandas DataFrame
# For the default Lakehouse attached to the notebook, use the following path pattern:
df = pd.read_csv("/lakehouse/default/Files/FILENAME.csv")

# Verify that the file loaded successfully before continuing
print(df.head())
print(df.shape)
display(df)
Escritura de datos como un archivo CSV
import pandas as pd

# Write a Pandas DataFrame into a CSV file in your Lakehouse
# Replace FILENAME with your own value
df.to_csv("/lakehouse/default/Files/FILENAME.csv", index=False)
Lectura de datos de un archivo de Parquet
import pandas as pd

# Read a Parquet file from your Lakehouse into a Pandas DataFrame
df = pd.read_parquet("/lakehouse/default/Files/FILENAME.parquet")
display(df)
Escribir datos en un archivo Parquet
import pandas as pd

# Write a Pandas DataFrame into a Parquet file in your Lakehouse
df.to_parquet("/lakehouse/default/Files/FILENAME.parquet")
Lectura de datos de un archivo de Excel
import pandas as pd

# Read an Excel file from your Lakehouse into a Pandas DataFrame
# If the file is in a subfolder, add the appropriate folder after Files/
df = pd.read_excel("/lakehouse/default/Files/FILENAME.xlsx")
display(df)
Escritura de datos como un archivo de Excel
import pandas as pd

# Write a Pandas DataFrame into an Excel file in your Lakehouse
df.to_excel("/lakehouse/default/Files/FILENAME.xlsx", index=False)
Lectura de datos de un archivo JSON
import pandas as pd

# Read a JSON file from your Lakehouse into a Pandas DataFrame
df = pd.read_json("/lakehouse/default/Files/FILENAME.json")
display(df)
Escritura de datos como un archivo JSON
import pandas as pd

# Write a Pandas DataFrame into a JSON file in your Lakehouse
df.to_json("/lakehouse/default/Files/FILENAME.json")
Trabajar con tablas Delta
Las tablas delta son el formato de tabla predeterminado en Microsoft Fabric y se almacenan en la sección Tablas de su instancia de Lakehouse. Los archivos y tablas son diferentes ubicaciones de almacenamiento en Fabric, y usan patrones de acceso distintos. Para trabajar con tablas Delta en Pandas, primero lee la tabla en un DataFrame Spark y luego convierte el resultado filtrado a un DataFrame de Pandas solo cuando encaje en la memoria del controlador.
Creación de una tabla Delta de prueba
Para seguir los pasos de esta sección, necesita una tabla Delta en su Lakehouse. Siga los pasos descritos en Descarga del conjunto de datos y carga en lakehouse para agregar el archivo churn.csv a Lakehouse y, a continuación, cree una tabla de prueba desde el archivo churn.csv ejecutando este código en el cuaderno:
import pandas as pd
# Create a test Delta table from the churn.csv file

df = pd.read_csv("/lakehouse/default/Files/churn/raw/churn.csv")
spark_df = spark.createDataFrame(df)
spark_df.write.format("delta").mode("overwrite").saveAsTable("churn_table")
Este paso crea una tabla Delta llamada churn_table que puedes usar para probar los siguientes ejemplos.
Leer datos de una tabla Delta
# Read a Delta table from your Lakehouse into a pandas DataFrame
# This example uses the churn_table created above
spark_df = spark.read.table("churn_table")
pandas_df = spark_df.toPandas()
display(pandas_df)
También puede leer tablas delta mediante la sintaxis de Spark SQL:
# Alternative method using Spark SQL
spark_df = spark.sql("SELECT * FROM churn_table")
pandas_df = spark_df.toPandas()
display(pandas_df)
Escribir un DataFrame de pandas en una tabla de Delta
# Convert pandas DataFrame to Spark DataFrame, then save as Delta table
# Replace TABLE_NAME with your desired table name
spark_df = spark.createDataFrame(pandas_df)
spark_df.write.format("delta").mode("overwrite").saveAsTable("TABLE_NAME")
También puede guardar en una ruta de acceso específica en la sección Tablas:
# Save to a specific path in the Tables section
spark_df = spark.createDataFrame(pandas_df)
spark_df.write.format("delta").mode("overwrite").save("Tables/TABLE_NAME")
Modos de escritura para tablas Delta
Al escribir en tablas Delta, puede especificar diferentes modos:
# Overwrite the entire table
spark_df.write.format("delta").mode("overwrite").saveAsTable("TABLE_NAME")

# Append new data to existing table
spark_df.write.format("delta").mode("append").saveAsTable("TABLE_NAME")
Nota:
Las tablas delta creadas en la sección Tablas de Lakehouse se pueden detectar sin ningún paso adicional de registro o configuración, y se pueden consultar mediante Spark SQL. También aparecen en la interfaz del explorador de Lakehouse (es posible que tenga que actualizar el explorador de Lakehouse para ver los cambios recientes).
Contenido relacionado
- Uso de Data Wrangler para limpiar y preparar los datos
- Comenzar a entrenar modelos de ML