Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Se aplica a:✅ punto de conexión de análisis SQL y Almacenamiento de datos en Microsoft Fabric
Importante
Esta característica se encuentra en versión preliminar.
La agrupación en clústeres de datos en Fabric Data Warehouse organiza los datos para mejorar el rendimiento de las consultas y reducir el uso de proceso. En este tutorial se describen los pasos para crear tablas con agrupación en clústeres de datos, desde la creación de tablas agrupadas hasta la comprobación de su eficacia.
Prerrequisitos
- Una cuenta de inquilino de Microsoft Fabric con una suscripción activa.
- Asegúrese de que tiene un área de trabajo habilitada para Microsoft Fabric: Crear un área de trabajo.
- Asegúrese de que ya ha creado un almacén. Para crear un nuevo almacén, consulte Creación de un almacén en Microsoft Fabric.
- Conocimientos básicos de T-SQL y consulta de datos.
Importar datos de ejemplo
En este tutorial se utiliza el conjunto de datos de muestra NY Taxi. Para importar los datos del taxi de NY en el almacén. Utilice el tutorial para cargar datos de muestra en el Almacén de Datos.
Crea una tabla con agrupamiento de datos
Para este tutorial, necesitamos dos copias de la tabla NYTaxi: la copia normal de la tabla tal como se importa desde el tutorial y una copia que usa la agrupación en clústeres de datos. Use el siguiente comando para crear una nueva tabla mediante CREATE TABLE AS SELECT (CTAS), basada en la tabla NYTaxi original:
CREATE TABLE nyctlc_With_DataClustering
WITH (CLUSTER BY (lpepPickupDatetime))
AS SELECT * FROM nyctlc
Nota:
En el ejemplo se asume el nombre de la tabla dado al conjunto de datos NY Taxi en el tutorial "Cargar datos de ejemplo en Data Warehouse". Si usó un nombre diferente para la tabla, ajuste el comando para reemplazar nyctlc por el nombre de la tabla.
Este comando crea una copia exacta de la tabla original NYTaxi, pero con la distribución de datos en clústeres en la columna lpepPickupDatetime. A continuación, se usa esta columna para realizar consultas.
Consultar datos
Ejecute una consulta en la tabla NYTaxi y repita la misma consulta exacta en la tabla NYTaxi_With_DataClustering para la comparación.
Nota:
Para este análisis, es beneficioso examinar el rendimiento de la caché en frío de ambas ejecuciones, es decir, sin usar las características de almacenamiento en caché de Fabric Data Warehouse. Por lo tanto, ejecute cada consulta exactamente una vez antes de examinar los resultados en Query Insights.
Usamos una consulta que a menudo se repite en el almacén. Esta consulta calcula el importe medio de tarifas por año entre las fechas 2008-12-31 y 2014-06-30:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Regular');
Nota:
La opción de etiqueta utilizada en esta consulta es útil cuando comparamos los detalles de la consulta de la Regular tabla con la que utiliza clustering de datos más adelante, utilizando para ello las vistas de Query Insights.
A continuación, repetimos la misma consulta exacta, pero en la versión de la tabla que usa la agrupación en clústeres de datos:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi_With_DataClustering
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Clustered');
La segunda consulta usa la etiqueta Clustered para permitirnos identificar esta consulta más adelante con Query Insights.
Comprobación de la eficacia de la agrupación en clústeres de datos
Después de configurar la agrupación en clústeres, puede evaluar su eficacia mediante Query Insights. Query Insights en Fabric Data Warehouse captura datos históricos de ejecución de consultas y los agrega a información procesable, como la identificación de consultas de ejecución prolongada o ejecutadas con frecuencia.
En este caso, se usa Información de consulta para comparar la diferencia en los datos analizados entre los casos normales y agrupados.
Use la siguiente consulta:
SELECT
    label,
    submit_time,
    row_count,
    total_elapsed_time_ms,
    allocated_cpu_time_ms,
    result_cache_hit,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb,
    command
FROM
    queryinsights.exec_requests_history
WHERE
    command LIKE '%NYTaxi%'
    AND label IN ('Regular','Clustered')
ORDER BY
    submit_time DESC;
Esta consulta obtiene los detalles de la vista exec_requests_history. Para obtener más información, vea queryinsights.exec_requests_history (Transact-SQL).
La consulta filtra los resultados de las maneras siguientes:
- Captura solo las filas que contienen el
NYTaxitexto en el nombre del comando (como se usó en las consultas de prueba). - Captura solo las filas en las que el valor de la etiqueta era normal o agrupado
Nota:
Los detalles de la consulta pueden tardar unos minutos en estar disponibles en Query Insights. Si la consulta de Query Insights no devuelve ningún resultado, vuelva a intentarlo después de unos minutos.
Al ejecutar esta consulta, observamos los siguientes resultados:

Ambas consultas tienen un recuento de filas de 6 y tiempos de envío similares. La Clustered consulta muestra total_elapsed_time_ms de 1794, allocated_cpu_time_ms de 1676 y data_scanned_remote_storage_mb de 77,519. La consulta Regular muestra total_elapsed_time_ms de 2651, allocated_cpu_time_ms de 2600, y data_scanned_remote_storage_mb de 177.700. Estos números muestran que, aunque ambas consultas devolvieron los mismos resultados, la Clustered versión usó aproximadamente 36% menos tiempo de CPU que la Regular versión y examinó aproximadamente 56% menos datos en el disco. No se usó ninguna caché en ninguna ejecución de consulta. Estos son resultados significativos para ayudar a reducir el tiempo de ejecución de consultas y el consumo, y hacer que la columna lpepPickupDatetime sea un candidato firme para la agrupación en clústeres de datos.
Nota:
Se trata de una tabla pequeña, con aproximadamente 76 millones de filas y 2 GB de volumen de datos. Aunque esta consulta devuelve solo seis filas en su agregación (una por cada año en el intervalo), examina aproximadamente 8,3 millones de filas en el intervalo de fechas proporcionado antes de que se agreguen los resultados. Los datos de producción reales con volúmenes de datos mayores pueden proporcionar resultados más significativos. Los resultados pueden variar en función del tamaño de capacidad, los resultados almacenados en caché o la simultaneidad durante las consultas.
Elige columnas de agrupamiento de tu carga de trabajo
Para las tablas de producción, utiliza patrones de consulta observados en lugar de adivinar qué columnas agrupar. La capacidad operativa de la sqldw-cli habilidad analiza el historial de Query Insights, clasifica patrones de consulta recurrentes por datos escaneados remotamente e identifica columnas usadas en WHERE predicados.
Antes de empezar, instala Skills for Fabric, asegúrate de que el almacén tenga actividad reciente de consultas y confirma que tienes el rol de espacio de trabajo de Colaborador o superior. Luego, abre la CLI de GitHub Copilot y usa un prompt como este:
Use the sqldw-cli skill to recommend clustering columns for
<workspace-name>/<warehouse-name> based on the last seven days of workload.
Rank candidates by total remote data scanned, consider columns used in WHERE
predicates, and explain each column's cardinality and data type suitability.
Use read-only diagnostics.
La habilidad identifica los patrones de consulta con mayor impacto en el escaneo, extrae las tablas y columnas de filtro de esas consultas y clasifica a los candidatos para agrupamiento. Revisa las recomendaciones con estas directrices:
- Prefiero columnas que filtran repetidamente tablas grandes y usan valores de cardinalidad media a alta, como fechas o identificadores.
- Priorice las columnas utilizadas en predicados de intervalo selectivo o de igualdad en la cláusula
WHERE. - No selecciones columnas solo porque aparecen en condiciones de combinación por igualdad. Estas condiciones no se benefician del agrupamiento de datos.
- No uses más de cuatro columnas de agrupación y no añadas más columnas de las que requiere la carga de trabajo.
Por ejemplo, consideremos un almacén de comercio electrónico donde Sales.SalesOrder contiene 1.500 millones de filas y Sales.OrderLine 6.000 millones de filas. Tras analizar las consultas recurrentes, la función puede ofrecer estas recomendaciones:
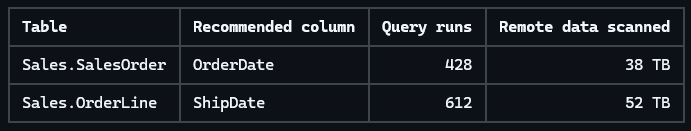
Las columnas de fecha son candidatas fuertes porque filtran las tablas más grandes, soportan predicados de rango común y ofrecen más oportunidades de salto de archivos que columnas de baja cardinalidad como OrderStatus o SalesRegion.
La sqldw-cli capacidad de operaciones es de solo lectura. Recomienda columnas pero no crea ni reemplaza tablas. Después de revisar la recomendación, utiliza CTAS para crear una copia agrupada de la tabla:
CREATE TABLE Sales.SalesOrder_clustered
WITH (CLUSTER BY (OrderDate))
AS
SELECT * FROM Sales.SalesOrder;
Compara las cargas de trabajo agrupadas y no agrupadas para verificar el efecto. Después de validar la tabla agrupada, cambia el nombre de la tabla original y luego cambia el nombre original a la tabla agrupada:
EXEC sp_rename 'Sales.SalesOrder', 'SalesOrder_old';
EXEC sp_rename 'Sales.SalesOrder_clustered', 'SalesOrder';
La tabla original sigue estando disponible en Sales.SalesOrder_old para una reversión. Verifica las cargas de trabajo dependientes y la nueva tabla antes de eliminar la tabla original. Cuando ya no necesites la copia de reversión, elimínala:
DROP TABLE Sales.SalesOrder_old;