Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
El kernel semántico proporciona muchos componentes diferentes, que se pueden usar individualmente o juntos. En este artículo se proporciona información general sobre los distintos componentes y se explica la relación entre ellos.
Conectores de servicio de IA
Los conectores de servicios de IA del Kernel Semántico proporcionan una capa de abstracción que expone varios tipos de servicios de IA de distintos proveedores a través de una interfaz común. Entre los servicios admitidos se incluyen finalización de chat, generación de texto, generación de inserción, texto en imagen, imagen a texto, texto a audio y audio a texto.
Cuando se registra una implementación con el kernel, los servicios de finalización de chat o de generación de texto se usarán por defecto en cualquier llamada de método al kernel. Ninguno de los demás servicios admitidos se usará automáticamente.
Sugerencia
Para obtener más información sobre el uso de servicios de INTELIGENCIA ARTIFICIAL, consulte Adición de servicios de IA a kernel semántico.
Conectores de almacenamiento de vectores (memoria)
Los conectores de almacenamiento de vectores del núcleo semántico ofrecen una capa de abstracción que facilita el acceso a los almacenes de vectores de diferentes proveedores mediante una interfaz común. El Kernel no utiliza automáticamente ningún almacén de vectores registrado, pero la búsqueda de vectores puede exponerse fácilmente como un complemento para el Kernel, en cuyo caso el complemento está disponible para plantillas de solicitud y el modelo de IA de finalización de chat.
Sugerencia
Para obtener más información sobre cómo usar los conectores de memoria, consulte Conectores para almacenes vectoriales.
Funciones y complementos
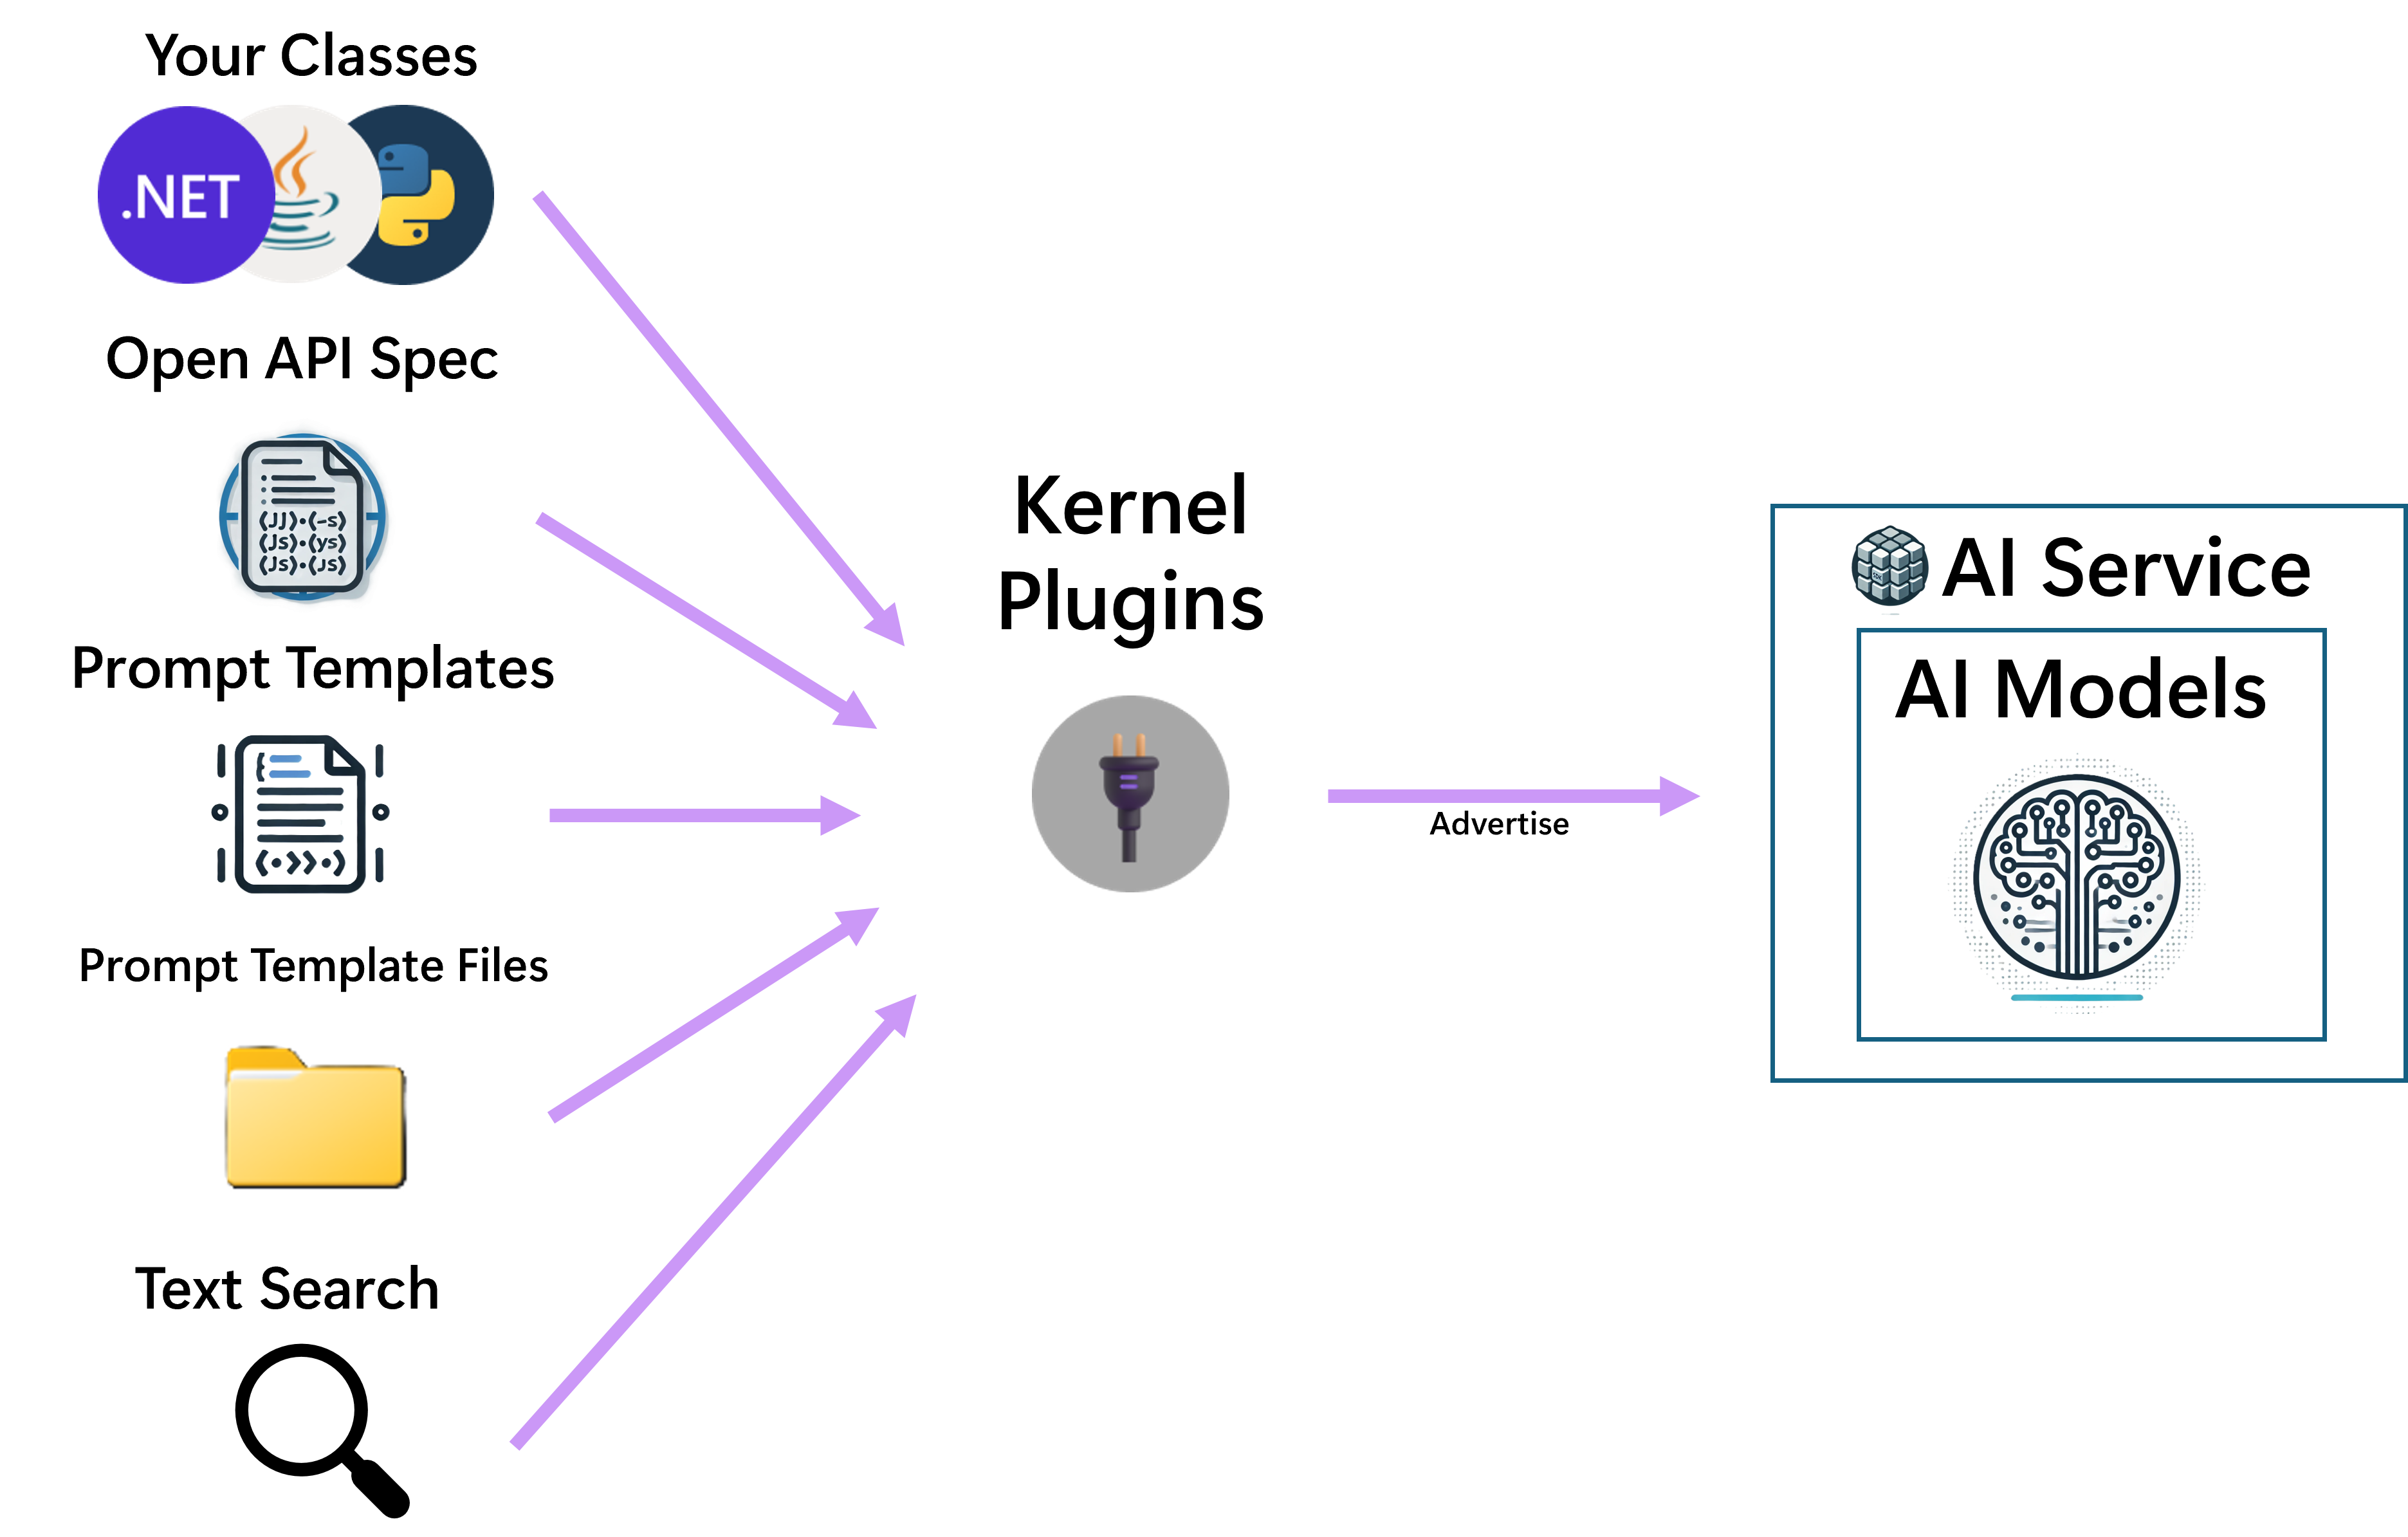
Los complementos se denominan contenedores de funciones. Cada uno puede contener una o varias funciones. Los complementos se pueden registrar con el kernel, lo que permite que el kernel los use de dos maneras:
- Anuncielos a la IA de finalización del chat, de modo que la inteligencia artificial pueda elegirlas para invocarlas.
- Haga que estén disponibles para que se llamen desde una plantilla durante la representación de plantillas.
Las funciones se pueden crear fácilmente a partir de muchos orígenes, como código nativo, especificaciones de OpenAPI, implementaciones de ITextSearch para escenarios rag, pero también desde plantillas de solicitud.
Sugerencia
Para obtener más información sobre los diferentes orígenes de complementos, consulte ¿Qué es un complemento?.
Sugerencia
Para obtener más información sobre cómo presentar complementos a la IA de autocompletado de chat, consulta Llamada a funciones con autocompletado de chat.
Plantillas de prompts
Las plantillas de prompts permiten a un desarrollador o ingeniero de prompts crear una plantilla que combine el contexto y las instrucciones para la IA con la entrada del usuario y la salida de la función. Por ejemplo, la plantilla puede contener instrucciones para el modelo de IA para completar chats y marcadores de posición para la entrada del usuario, además de llamadas codificadas a complementos que siempre deben ejecutarse antes de invocar el modelo de IA de finalización de chat.
Las plantillas de indicaciones se pueden utilizar de dos maneras:
- Como punto de partida de un flujo de finalización de chat pidiendo al kernel que represente la plantilla e invoque el modelo de IA de finalización de chat con el resultado representado.
- Como función complementaria, para que se pueda invocar de la misma manera que cualquier otra función.
Cuando se utiliza una plantilla de solicitud, primero se renderizará, y cualquier referencia a funciones codificadas que contenga se ejecutará. A continuación, el mensaje representado se pasará al modelo de IA de finalización de chat. El resultado generado por la inteligencia artificial se devolverá al autor de la llamada. Si la plantilla de indicaciones se hubiera registrado como una función de complemento, es posible que el modelo de IA de autocompletado de chat haya elegido dicha función para su ejecución y, en este caso, quien la invoca es Kernel semántico, en nombre del modelo de IA.
El uso de plantillas de solicitud como funciones de complemento de esta manera puede dar lugar a flujos bastante complejos. Por ejemplo, considere el escenario, en el que una plantilla de aviso A se registra como complemento.
Al mismo tiempo, se puede pasar una plantilla de solicitud diferente B al kernel para iniciar el flujo de finalización del chat.
B podría tener una llamada codificada de forma fija a A.
Esto daría lugar a los pasos siguientes:
- Comienza la representación de
By la ejecución de la indicación encuentra una referencia aA - Se representa
A. - La salida renderizada de
Ase pasa al modelo de IA de Chat Completion. - El resultado del modelo de IA de finalización de chat se devuelve a
B. - Se completa el renderizado de
B. - La salida renderizada de
Bse pasa al modelo de IA de Chat Completion. - El resultado del modelo de IA de finalización de chat se devuelve al autor de la llamada.
Tenga en cuenta también el escenario en el que no hay ninguna llamada codificada de B a A.
Si la llamada a funciones está habilitada, el modelo de IA de Chat Completion aún puede decidir que se invoque A, ya que requiere datos o funcionalidades que A puede proporcionar.
El registro de plantillas de solicitud como funciones de complemento permite la posibilidad de crear funcionalidad que se describe mediante lenguaje humano en lugar de código real. La separación de la funcionalidad en un complemento como este permite al modelo de inteligencia artificial razonar sobre esto por separado al flujo de ejecución principal y puede dar lugar a mayores tasas de éxito por parte del modelo de IA, ya que puede centrarse en un único problema a la vez.
Consulte el diagrama siguiente para obtener un flujo sencillo que se inicia desde una plantilla de aviso.

Sugerencia
Para obtener más información sobre las plantillas de solicitud, consulte ¿Qué son las solicitudes?.
Filtros
Los filtros proporcionan una manera de realizar acciones personalizadas antes y después de eventos específicos durante el flujo de finalización del chat. Estos eventos incluyen:
- Antes y después de la invocación de la función.
- Antes y después del renderizado de la indicación.
Los filtros deben registrarse con el kernel para invocarse durante el flujo de finalización del chat.
Tenga en cuenta que, dado que las plantillas de solicitud siempre se convierten en KernelFunctions antes de la ejecución, se invocarán filtros de función y solicitud para una plantilla de solicitud. Dado que los filtros están anidados cuando hay más de uno disponible, los filtros de función son los filtros externos y los filtros de solicitud son los filtros internos.

Sugerencia
Para obtener más información sobre los filtros, consulte ¿Qué son los filtros?.