Nota:
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Se aplica a: SQL ServerAzure SQL DatabaseInstancia administrada de Azure SQLBase de datos SQL en Microsoft Fabric
El motor de base de datos de SQL Server procesa consultas en diversas arquitecturas de almacenamiento de datos como tablas locales, tablas con particiones y tablas distribuidas entre varios servidores. Las siguientes secciones cubren cómo el Motor de base de datos procesa consultas y optimiza la reutilización de consultas mediante la caché del plan de ejecución.
Los ejemplos de código de este artículo utilizan la base de datos de ejemplo AdventureWorks2025, AdventureWorksDW2025 o AdventureWorksLT2025, que puedes descargar del repositorio de GitHub Azure Data SQL Samples Repository.
Modos de ejecución
El Motor de base de datos de SQL Server puede procesar sentencias Transact-SQL (T-SQL) usando dos modos de procesamiento distintos:
- Ejecución del modo de fila
- Ejecución del modo por lotes
Ejecución del modo de fila
La ejecución en modo fila es un método de procesamiento de consultas utilizado con tablas e índices de rowstore, donde los datos se almacenan en formato de fila. Cuando se ejecuta una consulta y accede a datos en tablas e índices de almacén de filas, los operadores del árbol de ejecución y los operadores hijos leen cada fila requerida en todas las columnas especificadas en el esquema de objetos. De cada fila leída, el Motor de base de datos recupera las columnas necesarias para el conjunto de resultados, según se hace referencia en una instrucción SELECT, un predicado JOIN o un predicado de filtro.
Nota:
La ejecución en modo fila es muy eficiente para escenarios OLTP, pero puede ser menos eficiente al escanear grandes cantidades de datos, por ejemplo en escenarios de almacenamiento de datos.
Ejecución del modo por lotes
La ejecución en modo por lotes es un método de procesamiento de consultas que procesa varias filas juntas (de ahí el término por lotes). Cada columna dentro de un lote se almacena como un vector en un área de memoria independiente, por lo que el procesamiento del modo por lotes se basa en vectores. El procesamiento en modo por lotes también utiliza algoritmos optimizados para conjuntos avanzados de instrucciones y mayor rendimiento de memoria en procesadores modernos.
La ejecución en modo por lotes se integró y optimizó originalmente alrededor del formato de almacenamiento columnstore. A partir de SQL Server 2019 (15.x) y en Azure SQL Database, la ejecución en modo batch no requiere índices columnstore. Para obtener más información, consulte Modo por lotes en el almacén de filas.
El procesamiento en modo por lotes opera sobre datos comprimidos cuando es posible, y elimina el operador de intercambio que utiliza la ejecución en modo fila. El resultado es un mayor paralelismo y un rendimiento más rápido.
Cuando una consulta se ejecuta en modo batch y accede a datos en índices de columnstore, los operadores del árbol de ejecución y los operadores hijos leen varias filas juntas en segmentos de columna. El Motor de base de datos solo lee las columnas requeridas para el resultado, a las que hace referencia una instrucción SELECT, un predicado JOIN o un predicado de filtro. Para más información sobre los índices de columnstore, véase Arquitectura de Índices de Columnstore.
Nota:
La ejecución en modo por lotes es muy eficiente para escenarios de almacenamiento de datos, donde puede leer y agregar grandes cantidades de datos.
Procesamiento de instrucciones SQL
Procesar una única sentencia T-SQL es la forma más básica en que el Motor de base de datos ejecuta las sentencias T-SQL. Los siguientes pasos ilustran el proceso básico procesando una única SELECT sentencia que solo hace referencia a tablas base locales (sin vistas ni tablas remotas).
Precedencia de los operadores lógicos
Cuando usas más de un operador lógico en una afirmación, NOT se evalúa primero, luego AND, y finalmente OR. Los operadores aritméticos y de bits se manejan antes que los operadores lógicos. Para obtener más información, vea Prioridad del operador.
En el siguiente ejemplo, la condición de color se aplica al modelo producto 21, y no al modelo producto 20, porque AND tiene precedencia sobre OR.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
Usar paréntesis, incluso cuando no son obligatorios, puede mejorar la legibilidad de las consultas y reducir la posibilidad de cometer un error debido a la precedencia del operador. El siguiente ejemplo es más legible que el anterior y tiene el mismo significado.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
Puede cambiar el significado de la consulta si agrega paréntesis para provocar que OR se evalúe primero. La siguiente consulta busca solamente los productos en los modelos 20 y 21 que sean rojos.
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
Optimización de las instrucciones SELECT
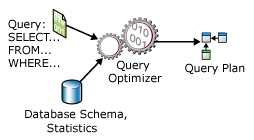
Una instrucción SELECT no es de procedimiento, ya que no expone los pasos exactos que el servidor de bases de datos debe usar para recuperar los datos solicitados. Este comportamiento declarativo implica que el servidor de base de datos debe analizar la sentencia y la base de datos para determinar la forma más eficiente de extraer los datos solicitados. Este proceso se denomina optimización del plan de consultas. El componente que realiza esta tarea es el Optimizador de Consultas. La entrada al Optimizador de Consultas consiste en la consulta, el esquema de la base de datos (definiciones de objetos) y las estadísticas de objetos. La salida del Optimizador de Consultas es un plan de ejecución de consultas, a veces denominado plan de consulta o plan de ejecución. El contenido de un plan de ejecución se describe con más detalle en Almacenamiento en caché y reutilización del plan de ejecución.
El siguiente diagrama ilustra las entradas y salidas del Optimizador de Consultas durante la optimización de una sola SELECT sentencia:
Una SELECT sentencia define solo:
- El formato del conjunto de resultados. Este elemento se especifica principalmente en la lista de selección. Sin embargo, también afectan a la forma final del conjunto de resultados otras cláusulas como
ORDER BYyGROUP BY. - Las tablas que contienen los datos de origen. Se especifica en la cláusula
FROM. - Cómo se relacionan las tablas de forma lógica para la instrucción
SELECT. Esto se define en la expresión de unión, que puede aparecer en la cláusulaWHEREo en una cláusulaONdespués deFROM. - Las condiciones que deben cumplir las filas de las tablas de origen para satisfacer los requisitos de la instrucción
SELECT. Se especifican en las cláusulasWHEREyHAVING.
Un plan de ejecución de consultas define:
La secuencia en la que se tiene acceso a las tablas de origen.
Normalmente, el servidor de bases de datos puede acceder a las tablas base en muchas secuencias para construir el conjunto de resultados. Por ejemplo, si la instrucción
SELECThace referencia a tres tablas, el servidor de la base de datos podría tener acceso primero aTableA, utilizar los datos deTableApara extraer las filas que coincidan con las deTableBy, finalmente, utilizar los datos deTableBpara extraer datos deTableC. Las demás secuencias en las que el servidor de base de datos podría tener acceso a las tablas son:TableC,TableB,TableAo
TableB,TableA,TableCo
TableB,TableC,TableAo
TableC, ,TableA,TableBLos métodos que se usan para extraer los datos de cada tabla.
Por lo general, hay métodos diferentes para tener acceso a los datos de cada tabla. Si solo se requieren unas pocas filas con valores clave específicos, el servidor de bases de datos puede buscar rápidamente filas o escanear un pequeño rango de índice. Si se requieren todas las filas de la tabla, el servidor de base de datos puede en su lugar escanear toda la tabla o todo el índice. Si todas las filas de una tabla son necesarias pero hay un índice cuyas columnas clave están en un
ORDER BY, realizar un escaneo de índice en lugar de un escaneo de tabla podría evitar una ordenación independiente del conjunto de resultados. Si una tabla es muy pequeña, los escaneos completos pueden ser el método más eficiente para casi todos los accesos a la tabla.Los métodos que se usan para realizar cálculos, y cómo filtrar, agregar y ordenar los datos de cada tabla.
A medida que se accede a los datos desde tablas, diferentes métodos realizan cálculos sobre datos, como calcular valores escalares, y agregar y ordenar datos según lo definido en el texto de consulta. Por ejemplo, al usar la cláusula
GROUP BYoORDER BY, y cómo filtrar datos, por ejemplo al usar la cláusulaWHEREoHAVING.
El proceso de selección de un plan de ejecución entre varios planes posibles se conoce como optimización. El Optimizador de consultas es uno de los componentes más importantes del Motor de base de datos. Aunque el Optimizador de Consultas utiliza cierta sobrecarga para analizar la consulta y seleccionar un plan, esta sobrecarga suele ahorrarse varias veces cuando el Optimizador de Consultas elige un plan de ejecución eficiente. Por ejemplo, se pueden dar a dos constructoras planos idénticos para una casa. Si una empresa dedica unos días al principio a planificar cómo construir la casa, y la otra empieza a construir sin planificar, probablemente la que se toma el tiempo de planificar su proyecto termina primero.
El Optimizador de Consultas es un optimizador basado en costes. Cada plan de ejecución posible tiene asociado un costo en términos de la cantidad de recursos del equipo que se utilizan. El optimizador de consultas debe analizar los planes posibles y elegir el de menor costo estimado. Algunas afirmaciones complejas tienen miles de posibles planes de ejecución. En estos casos, el Optimizador de consultas no analiza todas las combinaciones posibles. En lugar de esto, utiliza algoritmos complejos para encontrar un plan de ejecución que tenga un costo razonablemente cercano al mínimo posible.
El Optimizador de Consultas no necesariamente elige el plan de ejecución con el coste estimado más bajo. Encuentra un plan con un coste estimado razonable dentro del tiempo disponible para la optimización. Un plan de ejecución paralelo podría consumir más recursos que un plan serial mientras reduce el tiempo estimado transcurrido.
El SQL Server Query Optimizer se basa en estadísticas cuando estima los costes de recursos de diferentes métodos para extraer información de una tabla o índice. Las estadísticas se mantienen para columnas e índices, y contienen información sobre la densidad1 de los datos subyacentes. Esta información indica la selectividad de los valores en un índice o columna en particular. Por ejemplo, en una tabla que representa automóviles, muchos automóviles tienen el mismo fabricante, pero cada uno dispone de un único número de identificación de vehículo (NIV). Un índice del NIV es más selectivo que un índice del fabricante, porque NIV tiene una densidad inferior a la del fabricante. Si las estadísticas de los índices no están actualizadas, puede que el optimizador de consultas no realice la mejor elección para el estado actual de la tabla. Para obtener más información sobre las densidades, vea Estadísticas.
1 La densidad define la distribución de valores únicos que existen en los datos, o bien el promedio de valores duplicados para una columna determinada. A medida que disminuye la densidad, aumenta la selectividad de un valor.
El Optimizador de Consultas es importante porque permite al servidor de bases de datos adaptarse dinámicamente a las condiciones cambiantes en la base de datos sin necesidad de la intervención de un desarrollador o administrador de bases de datos. Esta función permite a los desarrolladores centrarse en describir el resultado final de la consulta. Pueden confiar en que el Optimizador de Consultas construya un plan de ejecución eficiente para el estado de la base de datos cada vez que se optimice el plan de consulta de una sentencia.
Nota:
SQL Server Management Studio tiene tres opciones para mostrar los planes de ejecución:
- El Plan de Ejecución Estimado, que es el plan compilado, tal como lo produce el Optimizador de Consultas.
- El Plan de Ejecución Real, que es el mismo que el plan compilado más su contexto de ejecución. Este contexto incluye información en tiempo de ejecución disponible tras la finalización de la ejecución, como advertencias de ejecución, o en versiones más recientes del Motor de base de datos, el tiempo transcurrido y el tiempo de CPU utilizado durante la ejecución.
- Las Estadísticas de Consulta en Vivo, que son las mismas que el plan compilado más su contexto de ejecución. Este contexto incluye información en tiempo de ejecución durante el progreso de la ejecución y se actualiza cada segundo. La información en tiempo de ejecución incluye, por ejemplo, el número real de filas que fluyen a través de los operadores.
Procesamiento de una instrucción SELECT
El Motor de base de datos procesa una única SELECT instrucción siguiendo estos pasos:
- El analizador examina la instrucción
SELECTy la divide en unidades lógicas como palabras clave, expresiones, operadores e identificadores. - Se construye un árbol de consultas, a veces denominado árbol de secuencias, que describe los pasos lógicos necesarios para transformar los datos fuente en el formato requerido por el conjunto de resultados.
- El Optimizador de Consultas analiza diferentes formas de acceder a las tablas fuente. Selecciona la serie de pasos que devuelve los resultados más rápido utilizando menos recursos. Actualiza el árbol de consultas para registrar esta serie exacta de pasos. La versión final y optimizada del árbol de la consulta se denomina plan de ejecución.
- El motor relacional comienza a ejecutar el plan. A medida que procesa los pasos que necesitan datos de las tablas base, solicita los conjuntos de filas requeridos al motor de almacenamiento.
- El motor relacional procesa los datos que devuelve el motor de almacenamiento en el formato definido para el conjunto de resultados y devuelve el conjunto de resultados al cliente.
Doblado de constantes y evaluación de expresiones
El motor de base de datos evalúa algunas expresiones constantes con antelación para mejorar el rendimiento de las consultas. Esta técnica de optimización utilizada por el Optimizador de Consultas pretende simplificar las expresiones en tiempo de compilación en lugar de en tiempo de ejecución. Implica evaluar expresiones constantes durante la compilación de consultas para que el plan de ejecución resultante sea más eficaz. Este proceso se denomina plegado constante. Una constante es un literal T-SQL, como 3, 'ABC', '2025-12-31', 1.0e3, o 0x12345678. Por ejemplo, tome esta consulta:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
Aquí, 30 * 12 es una expresión constante. El Motor de base de datos evalúa esta expresión durante la compilación y puede reescribir la consulta internamente como:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
Expresiones que pueden plegarse
El Motor de base de datos utiliza plegado constante con los siguientes tipos de expresiones:
- Expresiones aritméticas, como
1 + 1y5 / 3 * 2, que solo incluyen constantes. - Expresiones lógicas, como
1 = 1y1 > 2 AND 3 > 4, que solo incluyen constantes. - Funciones integradas que el Motor de base de datos considera susceptibles de plegado, incluyendo
CASTyCONVERT. Generalmente, una función intrínseca es reducible si es función solo de sus entradas y no de otra información contextual, comoSETopciones, ajustes de idioma, opciones de base de datos y claves de cifrado. Las funciones no deterministas no pueden plegarse. Excepto algunas excepciones, las funciones deterministas integradas pueden doblarse. - Métodos deterministas de tipos CLR definidos por el usuario y funciones definidas por el usuario con valores escalares deterministas del CLR. Para obtener más información, vea Doblado constante para las funciones y métodos definidos por el usuario CLR.
Nota:
Los tipos de objetos grandes constituyen una excepción. Si el tipo de salida del proceso de plegado es un tipo de objeto grande (text, ntext, image, nvarchar(max), varchar(max), varbinary(max), json o xml), el Motor de base de datos no pliega la expresión.
Expresiones no plegables
El resto de tipos de expresiones no pueden plegarse. En concreto, los siguientes tipos de expresiones no pueden plegarse:
- Expresiones no constantes como una expresión cuyo resultado dependa del valor de una columna.
- Expresiones cuyos resultados dependan de una variable o parámetro locales, como
@x. - Funciones no deterministas.
- Funciones T-SQL definidas por el usuario.
- Expresiones cuyos resultados dependan de la configuración de idioma.
- Expresiones cuyos resultados dependen de
SETlas opciones. - Expresiones cuyos resultados dependan de las opciones de configuración del servidor.
Ejemplos de expresiones constantes que pueden plegarse y que no pueden plegarse
Considere la siguiente consulta:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
Si la PARAMETERIZATION opción de base de datos no está configurada como FORCED para esta consulta, la expresión 117.00 + 1000.00 se evalúa y se reemplaza por su resultado, 1117.00, antes de compilar la consulta. Los beneficios de este plegado de constantes incluyen:
- La expresión no tiene que evaluarse repetidas veces durante el tiempo de ejecución.
- El valor de la expresión tras su evaluación es utilizado por el Optimizador de Consultas para estimar el tamaño del conjunto de resultados de la parte de la consulta
TotalDue > 117.00 + 1000.00.
Por otro lado, si dbo.f es una función escalar definida por el usuario, la expresión dbo.f(100) no se pliega, porque el Motor de base de datos no pliega expresiones que involucran funciones definidas por el usuario, aunque sean deterministas. Para más información sobre la parametrización, véase Parametrización forzada.
Evaluación de expresiones
Además, algunas expresiones cuyas constantes no se pliegan, pero cuyos argumentos se conocen en tiempo de compilación tanto si se trata de parámetros como de constantes, se evalúan mediante el estimador (de cardinalidad) del tamaño del conjunto de resultados que forma parte del optimizador durante la optimización.
Se evalúan las funciones integradas siguientes y los operadores especiales en tiempo de compilación específicamente, si se conocen todas sus entradas: UPPER, LOWER, RTRIM, DATEPART( YY only ), GETDATE, CAST y CONVERT. Los siguientes operadores también se evalúan en tiempo de compilación si se conocen todas sus entradas:
- Operadores aritméticos:
+,-,*,/, unario- - Operadores lógicos:
AND,OR,NOT - Operadores de comparación:
<,>,<=,>=,<>,LIKE,IS NULL,IS NOT NULL
El optimizador de consultas no evalúa ninguna otra función ni operador durante la estimación de la cardinalidad.
Ejemplos de evaluación de expresiones en tiempo de compilación
Observe este procedimiento almacenado:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
Durante la optimización de la instrucción SELECT del procedimiento, el optimizador de consultas intenta evaluar la cardinalidad esperada del conjunto de resultados para la condición OrderDate > @d + 1. La expresión @d + 1 no admite el plegado de constantes porque @d es un parámetro. Sin embargo, el valor del parámetro ya se conoce durante la optimización. Este valor permite al Optimizador de Consultas estimar con precisión el tamaño del conjunto de resultados, lo que le ayuda a seleccionar un buen plan de consulta.
Ahora considere un ejemplo similar al anterior, excepto que una variable @d2 local reemplaza @d + 1 en la consulta y la expresión se evalúa en una SET instrucción en lugar de en la consulta.
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
Cuando la SELECT sentencia en MyProc2 se optimiza en el Motor de base de datos, el valor de @d2 no se conoce. Por lo tanto, el Optimizador de Consultas utiliza una estimación predeterminada para la selectividad de OrderDate > @d2 (en este caso, el 30 por ciento).
Procesar otras instrucciones
Los pasos básicos para procesar una SELECT sentencia se aplican a otras sentencias T-SQL como INSERT, UPDATE, y DELETE. Las sentencias UPDATE y DELETE deben dirigirse al conjunto de filas que se van a modificar o eliminar. El proceso de identificación de estas filas es el mismo que se utiliza para identificar las filas de origen que contribuyen al conjunto de resultados de una instrucción SELECT . Ambas UPDATE sentencias INSERT pueden contener sentencias incrustadas SELECT que proporcionan los valores de datos para actualizar o insertar.
Incluso las sentencias del Lenguaje de Definición de Datos (DDL), como CREATE PROCEDURE o ALTER TABLE, se resuelven en una serie de operaciones relacionales sobre las tablas de catálogo del sistema y a veces (como ALTER TABLE ADD COLUMN) contra las tablas de datos.
Tablas de trabajo
El motor relacional puede necesitar construir una tabla de trabajo para realizar una operación lógica especificada en una sentencia T-SQL. Las tablas de trabajo son tablas internas que contienen resultados intermedios. Se generan tablas de trabajo para determinadas consultas GROUP BY, ORDER BY, o UNION. Por ejemplo, si una ORDER BY cláusula hace referencia a columnas que no están cubiertas por ningún índice, el motor relacional podría necesitar generar una tabla de trabajo para ordenar el conjunto de resultados en el orden solicitado. Las tablas de trabajo también se utilizan en ocasiones a modo de colas que contienen temporalmente el resultado de ejecutar parte de un plan de consulta. Las mesas de trabajo se crean en tempdb y luego se eliminan automáticamente cuando ya no se necesitan.
Resolución de vistas
El procesador de consultas del Motor de base de datos trata de forma diferente las vistas indexadas y no indexadas:
- La base de datos almacena las filas de una vista indexada en el mismo formato que una tabla. Si el Optimizador de Consultas decide usar una vista indexada en un plan de consulta, trata la vista indexada igual que una tabla base.
- Solo se almacena la definición de una vista no indizada, y no las filas de la vista. El Optimizador de Consultas incorpora la lógica de la definición de la vista en el plan de ejecución que construye para la sentencia T-SQL que hace referencia a la vista no indexada.
La lógica que utiliza el Optimizador de Consultas para decidir cuándo usar una vista indexada es similar a la lógica que emplea para decidir cuándo usar un índice en una tabla. Si los datos en la vista indexada cubren total o parcialmente la instrucción T-SQL, y el Optimizador de Consultas determina que un índice en la vista es la ruta de acceso de bajo coste, elige el índice independientemente de si la consulta hace referencia a la vista por nombre.
Cuando una sentencia T-SQL hace referencia a una vista no indexada, el analizador y el Optimizador de consultas analizan la definición tanto de la sentencia T-SQL como de la vista y luego las resuelven en un único plan de ejecución. La sentencia T-SQL y la vista no tienen planes separados.
Por ejemplo, considere la vista siguiente:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
Basándose en esta visión, ambas sentencias T-SQL realizan las mismas operaciones sobre las tablas base y producen los mismos resultados:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
La función Showplan de SQL Server Management Studio (SSMS) muestra que el motor relacional construye el mismo plan de ejecución para ambas SELECT sentencias.
Uso de sugerencias con vistas
Si colocas sugerencias en vistas en una consulta, pueden entrar en conflicto con otras sugerencias que se descubren cuando la vista se expande para acceder a sus tablas base. Cuando ocurre este conflicto, la consulta devuelve un error. Por ejemplo, considere la siguiente vista que contiene una sugerencia de tabla en su definición:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
Ahora supongamos que usted ingresa la siguiente consulta:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
La consulta falla porque la sugerencia SERIALIZABLE en la vista Person.AddrState se propaga a las tablas Person.Address y Person.StateProvince de la vista cuando se expande. No obstante, la expansión de la vista también mostrará la sugerencia NOLOCK en Person.Address. Dado que las indicaciones SERIALIZABLE y NOLOCK entran en conflicto, la consulta resultante es incorrecta.
Las sugerencias de tabla PAGLOCK, NOLOCK, ROWLOCK, TABLOCK y TABLOCKX entran en conflicto entre sí, al igual que las sugerencias de tabla HOLDLOCK, NOLOCK, READCOMMITTED, REPEATABLEREAD y SERIALIZABLE.
Las sugerencias pueden propagarse por los niveles de las vistas anidadas. Por ejemplo, supongamos que una consulta aplica la sugerencia HOLDLOCK a una vista v1. Cuando v1 se amplía, la vista v2 forma parte de su definición. La definición dev2incluye una sugerencia NOLOCK en una de sus tablas base. Sin embargo, esta tabla también hereda la sugerencia HOLDLOCK de la consulta de la vista v1. Dado que las sugerencias NOLOCK y HOLDLOCK entran en conflicto, se produce un error en la consulta.
Cuando usas la pista FORCE ORDER en una consulta que contiene una vista, la posición de la vista en la construcción ordenada determina el orden de unión de las tablas dentro de la vista. Por ejemplo, la siguiente consulta realiza una selección entre tres tablas y una vista:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
Y View1 se define como se muestra en el siguiente ejemplo:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
El orden de combinación en el plan de consulta es Table1, Table2, TableA, TableB, Table3.
Resolución de índices en vistas
Como con cualquier índice, el Motor de base de datos elige usar una vista indexada en su plan de consulta solo si el Query Optimizer considera que es beneficioso hacerlo.
Puedes crear vistas indexadas en cualquier edición del Motor de base de datos. En algunas ediciones, el Optimizador de Consultas considera automáticamente la vista indexada, mientras que en otras es necesario usar la sugerencia de tabla NOEXPAND. El uso automático de una vista indexada por parte del Optimizador de Consultas solo es compatible en ediciones específicas de SQL Server.
Nota:
Azure SQL Database e Instancia Administrada de Azure SQL admiten el uso automático de vistas indexadas sin especificar la NOEXPAND pista.
El Optimizador de Consultas utiliza una vista indexada cuando se cumplen las siguientes condiciones:
- Las siguientes opciones de sesión están establecidas en
ON:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
- La
NUMERIC_ROUNDABORTopción de sesión está configurada comoOFF. - El Optimizador de Consultas encuentra una coincidencia entre las columnas de índice de la vista y los elementos de la consulta, tales como:
- Predicados de condición de búsqueda en la cláusula
WHERE - Operaciones de combinación
- Funciones de agregado
- Cláusulas
GROUP BY - Referencias de tablas
- Predicados de condición de búsqueda en la cláusula
- El costo estimado de utilización del índice es el más bajo de todos los mecanismos de acceso que tiene en cuenta el optimizador de consultas.
- Todas las tablas a las que se hace referencia en la consulta (directamente o con la expansión de una vista para acceder a sus tablas subyacentes) que se correspondan con una referencia a tabla de la vista indexada deben tener el mismo conjunto de indicaciones aplicado a ellas.
Nota:
Las indicaciones READCOMMITTED y READCOMMITTEDLOCK siempre se consideran como indicaciones diferentes en este contexto, independientemente del nivel de aislamiento de la transacción actual.
Además de los requisitos de las sugerencias de tabla y opciones SET, estas reglas son las mismas que usa el Optimizador de consultas para determinar si un índice de la tabla satisface una consulta. No necesitas especificar nada más en la consulta para que se use una vista indexada.
Una consulta no tiene que hacer referencia explícita a una vista indexada en la cláusula FROM del Optimizador de consultas para usar dicha vista. Si la consulta contiene referencias a columnas de las tablas base que también se encuentran en la vista indizada y el optimizador de consultas considera que la vista indizada constituye el mecanismo de acceso de menor costo, el optimizador elige la vista indizada, de forma similar a como elige los índices de la tabla base cuando no se hace referencia directa a los mismos en una consulta. El optimizador de consultas puede elegir la vista cuando contiene columnas a las que no se hace referencia en la consulta, siempre y cuando la vista ofrezca la opción de costo más bajo para incluir una o varias de las columnas especificadas en la consulta.
El optimizador de consultas trata una vista indexada referenciada en la cláusula FROM como una vista estándar. Expande la definición de la vista en la consulta al inicio del proceso de optimización. A continuación se realiza la coincidencia de vista indizada. Puede que se use la vista indexada en el plan de ejecución final seleccionado por el Optimizador de consultas o que, en su lugar, el plan materialice los datos necesarios de la vista mediante el acceso a las tablas base a las que hace referencia la vista. El Optimizador de consultas elige la alternativa de menor costo.
Uso de sugerencias con vistas indizadas
Puede evitar que los índices de la vista se utilicen en una consulta mediante el uso de la sugerencia de consulta EXPAND VIEWS o utilizar la sugerencia de tabla NOEXPAND para exigir el uso de un índice de una vista indexada especificada en la cláusula FROM de una consulta. Sin embargo, debe dejar que sea el optimizador de consultas el que determine dinámicamente los mejores métodos de acceso para cada consulta. Limite la utilización de EXPAND y NOEXPAND a casos específicos en los que se haya comprobado que el rendimiento mejora significativamente.
La opción
EXPAND VIEWSdetermina que el Optimizador de consultas no use ninguno de los índices de la vista en toda la consulta.Cuando especificas
NOEXPANDpara una vista, el Optimizador de Consultas considera usar cualquier índice definido en la vista. Cuando se especificaNOEXPANDcon la cláusulaINDEX()opcional, el Optimizador de consultas está obligado a usar los índices especificados. Puedes especificarNOEXPANDsolo para una vista indexada y no puedes especificarla para una vista que no esté indexada. El uso automático de una vista indexada por parte del Optimizador de Consultas solo es compatible en ediciones específicas de SQL Server.Nota:
Azure SQL Database e Instancia Administrada de Azure SQL admiten el uso automático de vistas indexadas sin especificar la
NOEXPANDpista.
Cuando no se especifica NOEXPAND ni EXPAND VIEWS en una consulta que contiene una vista, ésta se expande para tener acceso a las tablas subyacentes. Si la consulta que compone la vista contiene sugerencias de tabla, éstas se propagan a las tablas subyacentes. (Este proceso se explica con más detalle en la resolución de vistas.) Mientras el conjunto de pistas que existen en las tablas subyacentes de la vista sea idéntico entre sí, la consulta puede coincidir con una vista indexada. La mayoría de las veces, estas pistas coinciden entre sí porque se heredan directamente de la vista. Sin embargo, si la consulta hace referencia a tablas en lugar de vistas y las sugerencias aplicadas directamente en estas tablas no son idénticas, no se puede seleccionar dicha consulta para que coincida con una vista indexada. Si las sugerencias INDEX, PAGLOCK, ROWLOCK, TABLOCKX, UPDLOCK o XLOCK se aplican a las tablas a las que se hace referencia en la consulta después de la expansión de la vista, la consulta no se puede seleccionar para la coincidencia de vistas indexadas.
Si una sugerencia de tabla en forma de INDEX ( index_val [ ,...n] ) hace referencia a una vista de una consulta y no se especifica también la sugerencia NOEXPAND, se pasa por alto la sugerencia de índice. Para especificar el uso de un determinado índice, use NOEXPAND.
Generalmente, cuando el Optimizador de Consultas empareja una vista indexada con una consulta, aplica cualquier sugerencia especificada en las tablas o vistas de la consulta directamente a la vista indexada. Si el Optimizador de Consultas decide no usar una vista indexada, propaga cualquier sugerencia directamente a las tablas referenciadas en la vista. Para más información, véase resolución de pantalla. Esta propagación no se aplica a las sugerencias de combinación. Solo se aplican en su posición original en la consulta. El Optimizador de Consultas no tiene en cuenta las pistas de unión al emparejar consultas con vistas indexadas. Si un plan de consulta utiliza una vista indexada que coincide con parte de una consulta que contiene una sugerencia de combinación, no se utiliza la sugerencia de combinación en el plan.
No se permiten sugerencias en las definiciones de vistas indexadas. El Motor de base de datos ignora las pistas dentro de las definiciones de vistas indexadas al mantenerlas o al ejecutar consultas que usan vistas indexadas.
Para obtener más información, vea Sugerencias de tabla.
Resolución de vistas con particiones distribuidas
El procesador de consultas del Motor de base de datos optimiza el rendimiento de las vistas particionadas distribuidas. El aspecto más importante del rendimiento de las vistas con particiones distribuidas es la minimización de la cantidad de datos transferidos entre los servidores miembro.
El Motor de base de datos crea planes inteligentes y dinámicos que hacen un uso eficiente de consultas distribuidas para acceder a datos de tablas miembros remotas:
- El Procesador de consultas usa en primer lugar OLE DB para recuperar las definiciones de la restricción CHECK de cada tabla miembro. Este método permite al procesador de consultas mapear la distribución de los valores clave entre las tablas de miembros.
- El Procesador de Consultas compara los rangos de clave especificados en una cláusula de instrucción
WHERET-SQL con el mapa que muestra cómo se distribuyen las filas en las tablas miembros. El procesador de consultas construye entonces un plan de ejecución de consultas que utiliza consultas distribuidas para recuperar solo aquellas filas remotas que son necesarias para completar la sentencia T-SQL. El plan de ejecución también está diseñado de tal manera que cualquier acceso a tablas de miembros remotos, ya sea para datos o metadatos, se retrasa hasta que se requiere la información.
Por ejemplo, imagine un sistema en el que una tabla Customers está particionada en Server1 (CustomerID de 1 a 3 299 999), Server2 (CustomerID de 3 300 000 a 6 599 999) y Server3 (CustomerID de 6 600 000 a 9 999 999).
Tome como ejemplo el plan de ejecución que se crea para esta consulta ejecutada en Server1:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
El plan de ejecución para esta consulta extrae las filas con los valores clave de CustomerID de 3200000 a 3299999 de la tabla miembro local, y emite una consulta distribuida para recuperar las filas con los valores de clave de 3300000 a 3400000 de Server2.
El Motor de base de datos Query Processor también puede incorporar lógica dinámica en planes de ejecución de consultas para sentencias T-SQL en las que los valores clave no se conocen en el momento en que debe construirse el plan. Tome como ejemplo este procedimiento almacenado:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
El Motor de base de datos no puede predecir qué valor clave proporciona el @CustomerIDParameter parámetro cada vez que se ejecuta el procedimiento. Como el valor clave no puede predecirse, el procesador de consultas tampoco puede predecir a qué tabla de miembros debe acceder. Para manejar este caso, el Motor de base de datos construye un plan de ejecución que tiene lógica condicional, denominada filtros dinámicos, para controlar a qué tabla miembro se accede, basándose en el valor del parámetro de entrada. Suponiendo que el GetCustomer procedimiento almacenado se ejecutó en Server1, la lógica del plan de ejecución puede representarse como se muestra en la siguiente salida:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
El Motor de base de datos a veces construye este tipo de planes de ejecución dinámicos incluso para consultas que no están parametrizadas. El Optimizador puede parametrizar una consulta de modo que el plan de ejecución pueda volver a usarse. Si el Optimizador de Consultas parametriza una consulta que hace referencia a una vista particionada, ya no puede asumir que las filas requeridas provienen de una tabla base especificada. Luego debe usar filtros dinámicos en el plan de ejecución.
Ejecutar un procedimiento almacenado y un desencadenador
El Motor de base de datos almacena solo el código fuente de procedimientos almacenados y disparadores. La primera vez que se ejecuta un procedimiento almacenado o un desencadenador, el origen se compila en un plan de ejecución. Si el procedimiento almacenado o el desencadenador se ejecutan de nuevo antes de que el plan de ejecución quede anticuado en la memoria, el motor relacional detecta el plan existente y vuelve a utilizarlo. Si el plan caduca en memoria, se construye un nuevo plan. Este proceso es similar al que sigue el Motor de base de datos para todas las sentencias T-SQL. La principal ventaja de rendimiento que tienen los procedimientos almacenados y los disparadores en el Motor de base de datos en comparación con los lotes de T-SQL dinámico es que sus sentencias T-SQL siempre son las mismas. Por lo tanto, el motor relacional los hace coincidir fácilmente con los planes de ejecución existentes. El procedimiento almacenado y los planes del desencadenador se reutilizan fácilmente.
El plan de ejecución para los procedimientos almacenados y los desencadenadores se ejecuta aparte del plan de ejecución del lote que llama al procedimiento almacenado o que activa el desencadenador. Esta separación permite una mayor reutilización del procedimiento almacenado y de los planes de ejecución de desencadenadores.
Almacenamiento en caché y reutilización de planes de ejecución
El Motor de base de datos utiliza memoria para almacenar tanto planes de ejecución como búferes de datos. El porcentaje de memoria asignada a planes de ejecución o búferes de datos se ajusta dinámicamente, dependiendo del estado del sistema. La parte de memoria que almacena planes de ejecución se llama caché de planes.
Almacenes de la caché de planes
La caché de planes tiene dos almacenes para todos los planes compilados:
- El almacenamiento de caché de Planes de Objetos (OBJCP), para planes relacionados con objetos persistidos, como procedimientos almacenados, funciones y disparadores.
- El almacenamiento de caché SQL Plans (SQLCP) almacena planes relacionados con consultas autoparametrizadas, dinámicas o preparadas.
La siguiente consulta proporciona información sobre el uso de memoria para estos dos almacenes de caché:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
El caché de planes tiene dos tiendas adicionales que no almacenan planes:
- El almacén de caché Bound Trees (PHDR), para estructuras de datos utilizadas durante la compilación de planes para vistas, restricciones y valores predeterminados. Estas estructuras se conocen como bound trees o árboles algebrizer.
- El almacén de caché de procedimientos almacenados extendidos (XPROC), para procedimientos de sistema predefinidos, como sp_executesql o xp_cmdshell. Estos procedimientos almacenados utilizan una DLL en lugar de sentencias T-SQL. La estructura en caché contiene solo el nombre de la función y el nombre de la DLL donde se implementa el procedimiento.
Componentes del plan de ejecución
Los planes de ejecución del Motor de base de datos tienen los siguientes componentes principales:
Plan compilado (o plan de consulta)
El plan de consulta generado por el proceso de compilación es principalmente una estructura de datos reentrante de solo lectura usada por cualquier número de usuarios. Almacena información sobre:
Operadores físicos que implementan la operación descrita por los operadores lógicos.
El orden de estos operadores, que determina el orden en el que se accede a los datos, se filtran y se agregan.
El número de filas estimadas que fluyen a través de los operadores.
Nota:
El plan de consulta también almacena información sobre los objetos estadísticos utilizados para la Estimación de Cardinalidad.
Qué objetos complementarios se deben crear, como tablas de trabajo o archivos de trabajo en
tempdb.
El plan de consulta no almacena ninguna información del contexto del usuario ni información de tiempo de ejecución. El Motor de base de datos determina el número de hilos de trabajo cada vez que recupera un plan de la caché de planes. Un plan paralelo en caché también puede ejecutarse en serie.
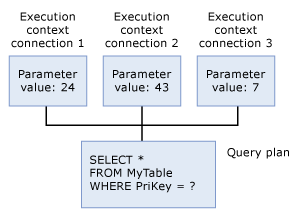
Contexto de ejecución
Cada usuario que ejecuta actualmente la consulta tiene una estructura de datos que contiene los datos específicos para su ejecución, como los valores de los parámetros. Esta estructura de datos se denomina contexto de ejecución. Las estructuras de datos del contexto de ejecución se vuelven a utilizar, pero su contenido no. Si otro usuario ejecuta la misma consulta, las estructuras de datos se reinicializan con el contexto del nuevo usuario.
Reutilizar planes para sentencias idénticas
Cuando el Motor de base de datos ejecuta cualquier sentencia T-SQL, primero revisa la caché del plan para verificar que existe un plan de ejecución existente para la misma instrucción T-SQL. La sentencia T-SQL se considera existente si literalmente coincide con una sentencia T-SQL ejecutada previamente con un plan almacenado en caché, carácter por carácter. El Motor de base de datos reutiliza cualquier plan existente que encuentre, ahorrando la carga de recompilar la instrucción T-SQL. Si no existe un plan de ejecución, el Motor de base de datos genera un nuevo plan de ejecución para la consulta.
Nota:
La caché del plan no persiste planes de ejecución para algunas sentencias T-SQL, como las sentencias de operaciones masivas que se ejecutan en rowstore o las que contienen literales grandes de cadena. Estos planes existen solo mientras la consulta está en curso.
El Motor de base de datos utiliza un algoritmo eficiente para encontrar cualquier plan de ejecución existente para cualquier instrucción T-SQL específica. En la mayoría de los sistemas, los recursos mínimos que utiliza esta exploración son menores que los que se ahorran al reutilizar los planes existentes en lugar de compilar cada sentencia T-SQL.
Los algoritmos para emparejar nuevas sentencias T-SQL con planes de ejecución existentes y no utilizados en la caché del plan requieren que todas las referencias a objetos estén completamente calificadas. Por ejemplo, supongamos que Person es el esquema por defecto para el usuario que ejecuta las siguientes SELECT sentencias. Aunque este ejemplo no requiere que especifiques completamente la tabla Person para ejecutarse, significa que la segunda instrucción no coincide con un plan existente, pero la tercera sí coincide:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
Cambiar cualquiera de las siguientes SET opciones para una ejecución dada afecta la capacidad de reutilizar planos, porque el Motor de base de datos realiza un plegado constante y estas opciones afectan los resultados de dichas expresiones:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
Almacenamiento en caché de varios planes para la misma consulta
Las consultas y los planes de ejecución se identifican de forma única en el Motor de base de datos, como una huella digital:
- El hash del plan de consulta es un valor hash binario calculado sobre el plan de ejecución de una consulta dada, y se utiliza para identificar de forma única planes de ejecución similares.
- El hash de consulta es un valor hash binario calculado sobre el texto T-SQL de una consulta, y se utiliza para identificar consultas de forma única.
Puedes recuperar un plan compilado de la caché del plan usando un identificador del plan. Este identificador transitorio permanece constante solo mientras el plan permanece en la caché. El identificador del plan es un valor hash derivado del plan compilado del lote completo. El handle del plan para un plan compilado se mantiene igual aunque una o más sentencias del lote se recompilen.
Nota:
Si compilas un plan para un lote en lugar de una sola sentencia, puedes usar el handle del plan y los desplazamientos de las sentencias para obtener el plan para las sentencias individuales del lote.
El sys.dm_exec_requests DMV contiene las columnas statement_start_offset y statement_end_offset de cada registro. Estas columnas se refieren a la sentencia actualmente en ejecución de un lote o de un objeto persistente que se está ejecutando. Para más información, consulte sys.dm_exec_requests.
El sys.dm_exec_query_stats DMV también contiene estas columnas para cada registro. Estas columnas se refieren a la posición de una sentencia dentro de un lote u objeto persistente. Para más información, vea sys.dm_exec_query_stats.
El texto T-SQL real de un lote se almacena en un espacio de memoria separado de la caché de planes, llamado caché SQL Manager (SQLMGR). Puedes recuperar el texto T-SQL de un plan compilado desde la caché de SQL Manager usando un SQL handle. Este identificador transitorio permanece constante solo mientras al menos un plan que lo referencia permanece en la caché de planes. El handle SQL es un valor hash derivado de todo el texto del lote, y está garantizado que será único para cada lote.
Nota:
Como un plan compilado, el texto T-SQL se almacena por lote, incluyendo los comentarios. El identificador SQL contiene el hash MD5 del texto completo del lote y está garantizado que es único para cada lote.
La siguiente consulta proporciona información sobre el uso de memoria para la caché de SQL Manager:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
Existe una relación de uno a muchos entre un identificador SQL y los identificadores de plan. Esta condición ocurre cuando la clave de caché para los planes compilados es diferente. Esta diferencia puede deberse a cambios en las opciones SET entre dos ejecuciones del mismo lote.
Considere el siguiente procedimiento almacenado:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
Verifica lo que puedes encontrar en la caché del plan usando la siguiente consulta:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
Este es el conjunto de resultados.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Ahora ejecuta el procedimiento almacenado con un parámetro diferente, sin otros cambios en el contexto de ejecución:
EXECUTE usp_SalesByCustomer 8;
GO
Verifica de nuevo lo que puedas encontrar en la caché del plan. Este es el conjunto de resultados.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Observa que el usecounts valor aumenta a 2, lo que significa que el mismo plan almacenado en caché se reutiliza as-is, porque las estructuras de datos del contexto de ejecución se reutilizan. Ahora cambia la SET ANSI_DEFAULTS opción y ejecuta el procedimiento almacenado usando el mismo parámetro.
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
Verifica de nuevo lo que puedas encontrar en la caché del plan. Este es el conjunto de resultados.
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
Observe que ahora hay dos entradas en la salida de la DMV sys.dm_exec_cached_plans:
- La
usecountscolumna muestra el valor1en el primer registro. Este valor representa el plan ejecutado una vez conSET ANSI_DEFAULTS OFF. - La
usecountscolumna muestra el valor2en el segundo registro. Este valor representa el plan ejecutado conSET ANSI_DEFAULTS ON, porque se ejecutó dos veces. - El otro valor
memory_object_addresshace referencia a una entrada diferente del plan de ejecución en la caché de planes. Pero el valorsql_handlees el mismo para ambas entradas porque hacen referencia al mismo lote.- La ejecución con
ANSI_DEFAULTSconfigurado enOFFtiene un nuevoplan_handle, y está disponible para reutilizarlo en llamadas que tienen el mismo conjunto deSETopciones. El nuevo identificador del plan es necesario porque el contexto de ejecución se reinicializó debido a los cambios en las opcionesSET. Pero ese cambio no provoca una recompilación: ambas entradas se refieren al mismo plan y consulta, como demuestran los mismos valoresquery_plan_hashyquery_hash.
- La ejecución con
Esta situación significa que tienes dos entradas de plan en la caché correspondientes al mismo lote. Subraya la importancia de asegurarse de que las opciones SET de la caché del plan sean las mismas cuando se ejecutan repetidamente las mismas consultas. Este enfoque optimiza la reutilización del plan y mantiene el tamaño de la caché del plan en su mínimo requerido.
Sugerencia
Un problema común es que los distintos clientes pueden tener valores predeterminados diferentes para las SET opciones. Por ejemplo, una conexión realizada a través de SQL Server Management Studio establece QUOTED_IDENTIFIER automáticamente en ON, mientras que SQLCMD establece QUOTED_IDENTIFIER en OFF. Ejecutar las mismas consultas desde estos dos clientes da lugar a múltiples planes (como se describió en el ejemplo anterior).
Eliminar planes de ejecución del caché de planes
Los planes de ejecución permanecen en la caché del plan mientras haya suficiente memoria para almacenarlos. Cuando existe presión de memoria, el Motor de base de datos de SQL Server utiliza un enfoque basado en costes para decidir qué planes de ejecución eliminar de la caché de planes. Para tomar una decisión basada en costes, el Motor de base de datos de SQL Server aumenta y disminuye una variable de coste actual para cada plan de ejecución en función de los siguientes factores.
Cuando un proceso de usuario inserta un plan de ejecución en la caché, el proceso de usuario establece el coste actual igual al coste original de compilación de la consulta. Para planes de ejecución ad hoc, el proceso de usuario establece el coste actual en cero. Después de eso, cada vez que un proceso de usuario hace referencia a un plan de ejecución, restablece el coste actual al coste original de compilación. Para planes de ejecución ad hoc, el proceso de usuario aumenta el coste actual. Para todos los planes, el valor máximo del costo actual es el costo de compilación original.
Cuando existe presión de memoria, el Motor de base de datos de SQL Server elimina los planes de ejecución de la caché del plan. Para determinar qué planes eliminar, el Motor de base de datos de SQL Server examina repetidamente el estado de cada plan de ejecución y elimina los planes cuando su coste actual es cero. Un plan de ejecución con coste corriente nulo no se elimina automáticamente cuando existe presión de memoria. Solo se elimina cuando el Motor de base de datos de SQL Server examina el plan y el coste actual es cero. Al examinar un plan de ejecución, el Motor de base de datos de SQL Server impulsa el coste actual hacia cero reduciendo el coste actual si una consulta no está usando actualmente el plan.
El Motor de base de datos de SQL Server sigue examinando los planes de ejecución hasta eliminar suficientes planes para satisfacer los requisitos de memoria. Mientras existe presión de memoria, un plan de ejecución puede ver su costo incrementado y reducido más de una vez. Cuando la presión de memoria deja de existir, el Motor de base de datos de SQL Server deja de disminuir el coste actual de los planes de ejecución no utilizados. Todos los planes de ejecución permanecen en la caché del plan, incluso si su coste es cero.
El motor de base de datos de SQL Server usa el monitor de recursos y los subprocesos de trabajo de usuario para liberar memoria de la memoria caché del plan en respuesta a la presión de memoria. El monitor de recursos y los hilos de trabajadores de usuario pueden examinar simultáneamente planes para disminuir el coste actual de cada plan de ejecución no utilizado. El monitor de recursos quita los planes de ejecución de la caché de planes cuando hay presión de memoria global. Libera memoria para aplicar las directivas correspondientes a la memoria del sistema, memoria de procesos, memoria del grupo de recursos y tamaño máximo de todas las memorias de caché.
El tamaño máximo de todas las memorias de caché es una función del tamaño del grupo de búferes y no puede exceder la memoria máxima del servidor. Para más información sobre cómo configurar la memoria máxima del servidor, consulte la opción max server memory en sp_configure.
Los subprocesos de trabajo de usuario quitan los planes de ejecución de la caché de planes cuando existe presión de memoria caché única. Aplican las directivas del tamaño máximo de la memoria caché única y de las entradas máximas de la memoria caché única.
En los ejemplos siguientes se muestra qué planes de ejecución se quitan de la caché de planes:
- Se suele hacer referencia a un plan de ejecución como si su costo nunca llegara a ser cero. El plan permanece en la caché del plan y no se elimina a menos que haya presión de memoria y el coste actual sea cero.
- Se insertó un plan de ejecución ad hoc y no se vuelve a hacer referencia a él antes de que exista presión de memoria. Dado que los planes ad hoc se inicializan con un coste actual de cero, cuando el Motor de base de datos de SQL Server examina el plan de ejecución, detecta el coste actual cero y elimina el plan de la caché del plan. El plan de ejecución ad hoc permanece en la caché del plan con un coste corriente cero cuando no existe presión de memoria.
Para quitar manualmente un único plan o todos los planes de la memoria caché, utilice DBCC FREEPROCCACHE. También puedes usar DBCC FREESYSTEMCACHE para borrar cualquier caché, incluida la caché de planes. SQL Server 2016 (13.x) y versiones posteriores, use ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE para borrar la caché del procedimiento (plan) para la base de datos en el ámbito actual.
Un cambio en algunos ajustes de configuración mediante sp_configure y reconfigure también provoca la eliminación de planes de la caché de planes. Puede encontrar la lista de estos parámetros de configuración en la sección Comentarios del artículo DBCC FREEPROCCACHE. Cuando realizas este cambio de configuración, se escribe el siguiente mensaje informativo en el registro de errores:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Recompilación de planes de ejecución
Ciertos cambios en una base de datos pueden hacer que un plan de ejecución sea ineficiente o inválido. El Motor de base de datos detecta estos cambios y marca el plan como no válido. Después, debe volver a compilarse un nuevo plan para la próxima conexión que ejecute la consulta. Las condiciones que invalidan un plan incluyen:
- Cambios en una tabla o vista referenciada por la consulta (
ALTER TABLEyALTER VIEW). - Cambios en un solo procedimiento, lo que eliminaría todos los planes para ese procedimiento de la caché (
ALTER PROCEDURE). - Cambios en los índices utilizados por el plan de ejecución.
- Actualizaciones de las estadísticas utilizadas por el plan de ejecución, ya sea generadas explícitamente por una sentencia como
UPDATE STATISTICSo generadas automáticamente. - Eliminar un índice utilizado por el plan de ejecución.
- Una llamada explícita a
sp_recompile. - Numerosos cambios en las claves (generados por las instrucciones
INSERToDELETEde otros usuarios que modifican una tabla a la que hace referencia la consulta). - Para tablas con desencadenadores, si el número de filas de las tablas insertadas o eliminadas crece significativamente.
- Ejecutar un procedimiento almacenado usando la opción
WITH RECOMPILE.
La mayoría de las recompilaciones son necesarias ya sea para la corrección de la sentencia o para conseguir planes de ejecución de consultas potencialmente más rápidos.
Cuando una instrucción dentro de un lote desencadena la recompilación, solo esa sentencia se recompila, no todo el lote. Esta regla se aplica tanto si el lote se presenta mediante un procedimiento almacenado, trigger, lote ad hoc o declaración preparada.
La recompilación a nivel de instrucción beneficia el rendimiento porque, en la mayoría de los casos, un pequeño número de sentencias provoca recompilaciones y sus penalizaciones asociadas, en términos de tiempo de CPU y bloqueos. Por tanto, estas penalizaciones se evitan para las otras instrucciones del lote que no necesitan ser recompiladas.
El evento extendido sql_statement_recompile (XEvent) envía informes de recompilaciones de nivel de instrucción. Este XEvent se produce cuando un lote de cualquier tipo requiere una recompilación de nivel de instrucción. Este requisito incluye procedimientos almacenados, disparadores, lotes ad hoc y consultas. Los lotes pueden enviarse a través de varias interfaces, incluyendo sp_executesql, SQL dinámico, métodos Prepare o métodos Execute.
La recompile_cause columna de sql_statement_recompile XEvent contiene un código entero que indica el motivo de la recompilación. La siguiente lista contiene las posibles razones:
- Opciones de cursor modificadas
- Compilación diferida
- Permiso
FOR BROWSEmodificado -
OPTION (RECOMPILE)solicitado - El plan parametrizado ha sido descartado
- Vista particionada modificada
- Plan que afecta a la versión de la base de datos modificado
- Entorno de notificación de consultas modificado
- Falta el plan en el almacén de consultas
- Error al forzar el plan de Almacén de consultas
- Directiva que fuerza el plan del almacén de consultas modificada
- Conjunto de filas remoto modificado
- Esquema modificado
-
SETopción modificada - Estadísticas modificadas
- Tabla temporal modificada
Nota:
Cuando configuras la AUTO_UPDATE_STATISTICS opción de base de datos en ON, las consultas se recompilan cuando se dirigen a tablas o vistas indexadas cuyas estadísticas se actualizan o cuyas cardinalidades cambian significativamente desde la última ejecución. Este comportamiento se aplica a tablas estándar definidas por el usuario, a tablas temporales y a tablas insertadas y eliminadas creadas por desencadenadores DML.
Configurar AUTO_UPDATE_STATISTICS para OFF detiene estas recompilaciones, pero las estadísticas desactualizadas suelen degradar el rendimiento de las consultas más que las recompilaciones. Para más información, consulta la opción AUTO_UPDATE_STATISTICS . Las tablas insertadas y eliminadas de los disparadores DML INSTEAD OF se crean en tempdb, por lo que siguen la AUTO_UPDATE_STATISTICS configuración de tempdb.
Utilizar parámetros explícitos para la reutilización del plan
El uso de parámetros, incluidos parámetros nombrados en aplicaciones ADO.NET y marcadores de parámetros en aplicaciones OLE DB y ODBC, puede aumentar la reutilización de planes de ejecución.
Advertencia
Valide siempre los datos especificados por el usuario mediante comprobaciones de tipo, longitud, formato e intervalo. Para obtener más información, consulte SQL injection.
La única diferencia entre las dos instrucciones SELECT siguientes son los valores que se comparan en la cláusula WHERE :
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
La única diferencia entre los planes de ejecución para estas consultas es el valor que se almacena para la comparación con la columna ProductSubcategoryID . Aunque el objetivo es que el Motor de base de datos siempre reconozca que las sentencias generan esencialmente el mismo plan y reutilice los planes, a veces el Motor de base de datos no detecta esta similitud en sentencias complejas de T-SQL.
Separar constantes de la sentencia T-SQL mediante parámetros ayuda al motor relacional a reconocer planes duplicados. Utiliza los parámetros de las siguientes maneras:
En T-SQL, utiliza
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;Este método se recomienda para scripts T-SQL, procedimientos almacenados o disparadores que generan sentencias SQL de forma dinámica.
ADO.NET con
SqlClientutiliza parámetros nombrados, como@Parm. OLE DB y ODBC utilizan marcadores de parámetros. Los marcadores de parámetros son signos de interrogación (?) que sustituyen a una constante en una sentencia SQL y están vinculados a una variable del programa. Por ejemplo, podría hacer lo siguiente en una aplicación ODBC:Use
SQLBindParameterpara enlazar una variable de entero al primer marcador de parámetro de una instrucción SQL.Coloque el valor entero en la variable.
Ejecuta la sentencia, especificando el marcador de parámetro (
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
El proveedor de base de datos OLE Native Client de SQL Server y el controlador ODBC de SQL Server Native Client utilizan
sp_executesqlpara enviar sentencias a SQL Server cuando se utilizan marcadores de parámetros en aplicaciones.Escribir procedimientos almacenados, que usan parámetros por diseño.
Si no incorporas explícitamente parámetros en el diseño de tus aplicaciones, también puedes confiar en que el Optimizador de Consultas parametrice automáticamente ciertas consultas usando el comportamiento por defecto de la parametrización simple. O bien, puede forzar que el Optimizador de consultas tenga en cuenta la parametrización de todas las consultas de la base de datos si establece la opción PARAMETERIZATION de la instrucción ALTER DATABASE en FORCED.
Parametrización simple
En el Motor de base de datos, usar parámetros o marcadores de parámetros en sentencias T-SQL aumenta la capacidad del motor relacional para emparejar nuevas sentencias T-SQL con planes de ejecución ya compilados.
Advertencia
Valide siempre los datos especificados por el usuario mediante comprobaciones de tipo, longitud, formato e intervalo. Para obtener más información, consulte SQL injection.
Si una sentencia T-SQL se ejecuta sin parámetros, el Motor de base de datos parametriza internamente la sentencia para aumentar la posibilidad de hacerla coincidir con un plan de ejecución existente. Este proceso se denomina parametrización. El valor por defecto es la parametrización simple, y puedes activar la parametrización forzada para una base de datos.
Considere esta declaración:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
Puedes especificar el valor 1 al final de la instrucción como parámetro. El motor relacional construye el plan de ejecución para este lote como si especificaras un parámetro en lugar de un valor como 1. Debido a esta simple parametrización, el Motor de base de datos reconoce que las siguientes dos sentencias generan esencialmente el mismo plan de ejecución y reutiliza el primer plan para la segunda:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
Al procesar sentencias T-SQL complejas, el motor relacional puede tener dificultades para determinar qué expresiones pueden parametrizarse. Para aumentar la capacidad del motor relacional de emparejar sentencias T-SQL complejas con planes de ejecución existentes y no utilizados, especifique explícitamente los parámetros usando sp_executesql o marcadores de parámetro.
Nota:
Cuando se utilizan los +operadores , -, *, /, o % aritméticos para realizar la conversión implícita o explícita de valores constantes de tipo int, smallint, tinyint o bigint a los tipos de datos float, reales, decimales o numéricos, el Motor de base de datos aplica reglas específicas para calcular el tipo y la precisión de los resultados de la expresión. Estas reglas difieren dependiendo de si la consulta está parametrizada. Por lo tanto, expresiones similares utilizadas en consultas pueden, en ciertos casos, producir resultados diferentes.
Bajo el comportamiento por defecto de parametrización simple, el Motor de base de datos parametriza una clase relativamente pequeña de consultas. No obstante, se puede especificar que, con algunas limitaciones, todas las consultas de una base de datos se parametricen al establecer la opción PARAMETERIZATION del comando ALTER DATABASE en FORCED. Este cambio puede mejorar el rendimiento de bases de datos que experimentan altos volúmenes de consultas concurrentes al reducir la frecuencia de compilaciones de consultas.
O bien, puede especificar que una sola consulta, y cualquier otra que sea sintácticamente equivalente pero solo se diferencie en los valores de parámetros, sea parametrizada.
Sugerencia
Cuando se utiliza una solución de mapeo objeto-relacional (ORM) como Entity Framework (EF), las consultas de aplicación como árboles manuales de consultas LINQ o ciertas consultas SQL en bruto pueden no estar parametrizadas. Esta limitación afecta a la reutilización de planes y a la capacidad de rastrear consultas en la Almacén de consultas. Para más información, consulte Almacenamiento en caché y parametrización de consultas de EF y Consultas SQL sin formato de EF.
Parametrización forzada
Puedes anular el comportamiento predeterminado de parametrización simple del Motor de base de datos especificando que todas las instrucciones SELECT, INSERT, UPDATE y DELETE de una base de datos se parametricen, con determinadas limitaciones. Activa la parametrización forzada estableciendo la opción PARAMETERIZATION en FORCED en la instrucción ALTER DATABASE. Puede que la parametrización forzada mejore el rendimiento de determinadas bases de datos al reducir la frecuencia de las compilaciones y recopilaciones de consultas. Las bases de datos que pueden beneficiarse de la parametrización forzada suelen ser las que experimentan grandes volúmenes de consultas simultáneas de orígenes como las aplicaciones de punto de venta.
Cuando se establece la opción PARAMETERIZATION en FORCED, cualquier valor literal que aparezca en una sentencia SELECT, INSERT, UPDATE o DELETE, presentada de cualquier manera, se convierte en un parámetro durante la compilación de la consulta. Las excepciones son los literales que aparecen en las siguientes construcciones de consulta:
- Instrucciones
INSERT...EXECUTE. - Instrucciones incluidas en los cuerpos de procedimientos almacenados, desencadenadores o funciones definidas por el usuario. El Motor de base de datos ya reutiliza planes de consulta para estas rutinas.
- Declaraciones preparadas que ya están parametrizadas en la aplicación del lado del cliente.
- Instrucciones que contienen llamadas a métodos XQuery, en las que el método aparece en un contexto en el que los argumentos suelen incluir parámetros, como una cláusula
WHERE. Si el método aparece en un contexto en el que los argumentos no se parametrizarán, el resto de la instrucción se parametriza. - Sentencias dentro de un cursor T-SQL. (Las instrucciones
SELECTcontenidas en cursores de la API incluyen parámetros). - Construcciones de consulta obsoletas.
- Cualquier instrucción que se ejecute en el contexto de
ANSI_PADDINGoANSI_NULLSestablecido enOFF. - Instrucciones que contienen más de 2.097 literales aptos para parametrización.
- Declaraciones que hacen referencia a variables, como
WHERE T.col2 >= @bb. - Instrucciones que contienen la sugerencia de consulta
RECOMPILE. - Declaraciones que contienen una cláusula
COMPUTE. - Declaraciones que contienen una cláusula
WHERE CURRENT OF.
Las siguientes cláusulas de consulta no están parametrizadas. En estos casos, las cláusulas son las únicas que no se parametrizan. Otras cláusulas de la misma consulta podrían ser candidatas para la parametrización forzada.
- El
<select_list>de cualquierSELECTafirmación. Esta lista incluyeSELECTlistas de subconsultas ySELECTlistas dentro de sentenciasINSERT. - Instrucciones
SELECTde subconsulta que aparezcan dentro de una instrucciónIF. - Las cláusulas
TOP,TABLESAMPLE,HAVING,GROUP BY,ORDER BY,OUTPUT...INTOoFOR XMLde una consulta. - Argumentos, directos o como subexpresiones, a
OPENROWSET,OPENQUERY,OPENDATASOURCE,OPENXML, o a cualquier operadorFULLTEXT. - Los argumentos pattern y escape_character de una cláusula
LIKE. - El argumento de estilo de una cláusula
CONVERT. - Constantes de tipo entero dentro de una cláusula
IDENTITY. - Constantes especificadas mediante la sintaxis de extensiones ODBC.
- Expresiones que admiten el doblado de constantes y son argumentos de los operadores
+,-,*,/y%. Al considerar la elegibilidad para la parametrización forzada, el Motor de base de datos considera que una expresión es plegable de forma constante cuando se cumple cualquiera de las siguientes condiciones:- No aparecen columnas, variables ni subconsultas en la expresión.
- La expresión contiene una cláusula
CASE.
- Argumentos para las cláusulas de hint de consulta, incluyendo el argumento number_of_rows de la
FASThint de consulta, el argumento number_of_processors de laMAXDOPhint de consulta y el argumento number de laMAXRECURSIONhint de consulta.
La parametrización ocurre a nivel de sentencias T-SQL individuales. En otras palabras, las instrucciones individuales de un lote están parametrizadas. Tras compilar, una consulta parametrizada se ejecuta en el contexto del lote en el que se envió originalmente. Si un plan de ejecución para una consulta está almacenado en caché, puedes determinar si la consulta fue parametrizada referenciando la sql columna de la sys.syscacheobjects vista de gestión dinámica. Si una consulta está parametrizada, los nombres y tipos de datos de los parámetros aparecen antes del texto del lote enviado en esta columna, como (@1 TINYINT).
Nota:
Los nombres de parámetros son arbitrarios. Los usuarios o aplicaciones no deberían depender de un orden de nombres concreto. Además, los siguientes elementos pueden cambiar entre distintas versiones de SQL Server y distintas actualizaciones acumulativas (CU): nombres de parámetros, elección de literales parametrizados y el espaciado en el texto parametrizado.
Tipos de datos de parámetros
Cuando el Motor de base de datos parametriza literales, los parámetros se convierten a los siguientes tipos de datos:
- Los literales enteros cuyo tamaño de otro modo encajaría dentro del tipo de dato int se parametrizan como int. Los literales enteros más grandes que forman parte de predicados que involucran cualquier operador de comparación (incluidos
<,<=,=,>,!>,!<,<>,ALL,>=,!=,SOME,BETWEEN,ANYyIN) se parametrizan como numeric(38,0). Los literales más grandes que no forman parte de predicados que involucran operadores de comparación se parametrizan como numérico, cuya precisión es lo suficientemente grande como para soportar su tamaño y cuya escala es 0. - Literales numéricos de punto fijo que forman parte de predicados que implican operadores de comparación se parametrizan como numeric, cuya precisión es 38 y cuya escala es lo suficientemente grande para admitir su tamaño. Literales numéricos de punto fijo que no forman parte de predicados que involucran operadores de comparación parametrizan a numérico cuya precisión y escala son lo suficientemente grandes para soportar su tamaño.
- Los literales numéricos de coma flotante se parametrizan a float(53).
- Los literales de cadenas no Unicode se parametrizan a varchar(8000) si el literal encaja dentro de 8.000 caracteres, y a varchar(max) si es mayor a 8.000 caracteres.
- Los literales de cadenas Unicode se parametrizan como nvarchar(4000) si el literal encaja dentro de 4.000 caracteres Unicode, y como nvarchar(max) si el literal es mayor que 4.000 caracteres.
- Los literales binarios se parametrizan a varbinary(8000) si el literal encaja dentro de 8.000 bytes. Si es mayor que 8.000 bytes, se convierte a varbinary(max).
- Los literales monetarios se convierten en parámetros como money.
Instrucciones para utilizar la parametrización forzada
Considera los siguientes puntos cuando configures la opción PARAMETERIZATION en FORCED:
- La parametrización forzada cambia las constantes literales en una consulta a parámetros al compilar una consulta. Por tanto, puede que el optimizador de consultas elija planes menos adecuados para las consultas. En concreto, es menos probable que el optimizador de consultas haga coincidir la consulta con una vista indizada o un índice de una columna calculada. Puede que también elija planes menos adecuados para consultas formuladas en tablas con particiones y vistas con particiones distribuidas. No utilices la parametrización forzada para entornos que dependen mucho de vistas indexadas y de índices en columnas calculadas. Generalmente, solo los profesionales experimentados en bases de datos deberían utilizar la
PARAMETERIZATION FORCEDopción tras determinar que no afecta negativamente al rendimiento. - Las consultas distribuidas que hacen referencia a más de una base de datos se pueden elegir para la parametrización forzada siempre que la opción
PARAMETERIZATIONse establezca enFORCEDen la base de datos en cuyo contexto se ejecuta la consulta. - Configurar la opción
PARAMETERIZATIONenFORCEDhace que se vacíen todos los planes de consulta de la caché de planes de una base de datos, excepto aquellos que se estén compilando, recompilando o ejecutando en ese momento. Los planes para consultas que se están compilando o ejecutándose durante el cambio de configuración se parametrizan la siguiente vez que se ejecuta la consulta. - Configurar la
PARAMETERIZATIONopción es una operación en línea que no requiere bloqueos exclusivos a nivel de base de datos. - El valor actual de la opción
PARAMETERIZATIONse mantiene al volver a adjuntar o restaurar una base de datos.
Puedes anular el comportamiento de la parametrización forzada especificando que se intente una parametrización simple en una sola consulta y en cualquier otra consulta que sea sintácticamente equivalente pero que difiera solo en sus valores de parámetro. Por el contrario, puede especificar que se trate de forzar la parametrización solo en un conjunto de consultas sintácticamente equivalentes, aunque la parametrización forzada esté deshabilitada en la base de datos. Utiliza plan guides para este propósito.
Nota:
Cuando la opción PARAMETERIZATION está establecida en FORCED, la notificación de mensajes de error podría ser distinta a cuando la opción PARAMETERIZATION se establece en SIMPLE: podrían notificarse varios mensajes de error con una parametrización forzada, en la que se notificarían menos mensajes con la parametrización simple, y los números de línea en los que ocurren los errores podrían indicarse incorrectamente.
Cuando se habilite la parametrización forzada, la parametrización simple aún puede ocurrir. Por ejemplo, la siguiente consulta no se puede parametrizar según las reglas de parametrización forzada:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
Sin embargo, se puede parametrizar según las reglas de parametrización simple. Cuando la parametrización forzada se intenta pero falla, después se sigue intentando la parametrización simple.
Preparación de instrucciones SQL
El Motor de base de datos permite preparar sentencias T-SQL antes de su ejecución. Si una aplicación necesita ejecutar una instrucción T-SQL varias veces, puede utilizar la API de la base de datos para:
- Prepara la declaración una vez. Este paso compila la instrucción T-SQL en un plan de ejecución.
- Ejecutar el plan de ejecución precompilado cada vez que necesite ejecutar la sentencia. Este enfoque impide recompilar la sentencia T-SQL en cada ejecución después de la primera vez. Las funciones y los métodos de la API controlan la preparación y la ejecución de las instrucciones. El proveedor de OLE DB Native Client de SQL Server y el controlador ODBC de SQL Server Native Client soportan el modelo prepare/execute para ejecutar sentencias T-SQL. En una solicitud de preparación, el proveedor o el controlador envían la instrucción a SQL Server con una solicitud para preparar la instrucción. El Motor de base de datos compila un plan de ejecución y devuelve un handle de ese plan al proveedor o controlador. En una solicitud de ejecución, el proveedor o el controlador envían al servidor una solicitud para ejecutar el plan asociado al identificador.
Las sentencias preparadas no pueden crear objetos temporales en el Motor de base de datos. Las instrucciones preparadas no pueden hacer referencia a procedimientos almacenados del sistema que creen objetos temporales, como tablas temporales. Estos procedimientos deben ejecutarse directamente.
El uso excesivo del modelo preparar/ejecutar puede degradar el rendimiento. Si una instrucción se ejecuta solo una vez, la ejecución directa requiere solo un viaje de ida y vuelta de red al servidor. Preparar y ejecutar una sentencia T-SQL ejecutada solo una vez requiere un viaje extra de ida y vuelta en red: un viaje para preparar la instrucción y otro para ejecutarla.
Preparar una instrucción es más eficaz si usas marcadores de parámetros. Por ejemplo, suponga que se solicita ocasionalmente a una aplicación que recupere información de productos de la base de datos de ejemplo AdventureWorksLT2025 . Hay dos formas en que la aplicación puede realizar esta tarea.
Utilizando el primer enfoque, la aplicación puede ejecutar una consulta separada para cada producto solicitado:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
Usando el segundo enfoque, la aplicación realiza las siguientes operaciones:
Prepara una instrucción que contiene un marcador de parámetro (
?).SELECT * FROM Production.Product WHERE ProductID = ?;Enlaza una variable de programa al marcador de parámetros.
Cada vez que se necesite información de productos, llena la variable enlazada con el valor de clave y ejecuta la instrucción.
El segundo enfoque es más eficiente cuando la sentencia se ejecuta más de tres veces.
En el Motor de base de datos, el modelo prepare/execute no tiene una ventaja significativa de rendimiento sobre la ejecución directa, debido a la forma en que el Motor de base de datos reutiliza los planes de ejecución. El Motor de base de datos dispone de algoritmos eficientes para emparejar sentencias T-SQL actuales con planes de ejecución generados para ejecuciones previas de la misma sentencia T-SQL. Si una aplicación ejecuta una sentencia T-SQL con marcadores de parámetros varias veces, el Motor de base de datos reutiliza el plan de ejecución de la primera ejecución para la segunda y las ejecuciones posteriores (a menos que el plan caduque de la caché de planes). El modelo de preparación y ejecución sigue teniendo estas ventajas:
- Encontrar un plan de ejecución mediante un handle identificador es más eficiente que los algoritmos usados para emparejar una sentencia T-SQL con planes de ejecución existentes.
- La aplicación puede controlar cuándo se crea el plan de ejecución y cuándo se reutiliza.
- El modelo de preparación y ejecución se puede transportar a otras bases de datos, incluidas las versiones anteriores de SQL Server.
Sensibilidad de los parámetros
La sensibilidad de parámetros, también conocida como parameter sniffing, se refiere a un proceso en el que el Motor de base de datos detecta los valores actuales de los parámetros durante la compilación o recompilación, y los pasa al Query Optimizer para ayudar potencialmente a generar planes de ejecución de consultas más eficientes.
Los valores de parámetros se examinan durante la compilación o la recompilación de los siguientes tipos de lotes:
- procedimientos almacenados
- Consultas enviadas mediante
sp_executesql - Consultas preparadas
Para más información sobre problemas de parameter sniffing, véase:
- Investigación y resolución de problemas de sensibilidad de parámetros
- Utilizar parámetros explícitos para la reutilización del plan
- Optimización de planes sensibles a parámetros
- Solución de problemas de las consultas en el plan de ejecución de consultas que distingue entre parámetros en Azure SQL Database
- Solución de problemas de consultas con problemas del plan de ejecución de consultas confidenciales de parámetros en Azure SQL Managed Instance
Cuando una consulta en el Motor de base de datos utiliza la sugerencia OPTION (RECOMPILE), el Query Optimizer convierte los parámetros y las variables locales en constantes de compilación que pueden plegarse y reducirse a literales. Durante la compilación, el optimizador conoce y puede utilizar los valores actuales de tiempo de ejecución de los parámetros y variables locales tal como existen inmediatamente antes de esa sentencia. La OPTION (RECOMPILE) sugerencia permite al optimizador generar un plan de consulta más óptimo adaptado a los valores específicos y aprovechar los mejores índices subyacentes en tiempo de ejecución. En el caso de los parámetros, este proceso hace referencia no a los valores pasados originalmente al procedimiento almacenado o por lotes, sino a sus valores en el momento de la recompilación. Estos valores pueden modificarse dentro del procedimiento antes de llegar a la sentencia que incluye RECOMPILE. Este comportamiento puede mejorar el rendimiento de consultas con datos de entrada muy variables o sesgados, a costa de compilar la consulta cada vez que se ejecuta. Este coste puede ser alto. Evita usar la RECOMPILE sugerencia sin evaluar su impacto en toda la carga de trabajo.
Variables locales y estimaciones de cardinalidad
Cuando una consulta utiliza variables locales, el Motor de base de datos no puede determinar sus valores en momento de compilación, por lo que estima la cardinalidad usando estadísticas o heurísticas disponibles. Si existen estadísticas, normalmente usa el valor All Density (también conocido como densidad media) del histograma estadístico para calcular cuántas filas coinciden con el predicado. Sin embargo, si no hay estadísticas disponibles para la columna, el Motor de base de datos recurre a estimaciones heurísticas, como asumir 10% de selectividad para predicados de igualdad y 30% para desigualdades y rangos. Estas estimaciones podrían llevar a planes de ejecución menos precisos. Este es un ejemplo de una consulta que usa una variable local.
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
En este caso, el Motor de base de datos no utiliza el valor 100 para optimizar la consulta. Usa una estimación general.
Procesamiento en paralelo de consultas
El Motor de base de datos proporciona consultas paralelas para optimizar la ejecución de consultas y las operaciones de índice en ordenadores que tienen más de un microprocesador (CPU). Debido a que el Motor de base de datos puede realizar una consulta o una operación de índice en paralelo utilizando varios hilos de trabajadores del sistema operativo, la operación termina rápida y eficientemente.
Durante la optimización de consultas, el Motor de base de datos busca consultas u operaciones de índice que puedan beneficiarse de la ejecución paralela. Para estas consultas, el Motor de base de datos inserta operadores de intercambio en el plan de ejecución de la consulta para preparar la consulta para la ejecución paralela. Un operador de intercambio es un operador de un plan de ejecución de consultas que proporciona administración de procesos, redistribución de datos y control del flujo. El operador de intercambio incluye los operadores lógicos Distribute Streams, Repartition Streams y Gather Streams como subtipos; uno o más de estos pueden aparecer en la salida de Showplan de un plan de consulta en una consulta paralela.
Importante
Ciertos constructos inhiben la capacidad del Motor de base de datos para usar paralelismo en todo el plan de ejecución, o en partes del mismo plan.
Entre las construcciones que impiden el paralelismo se incluyen las siguientes:
| Construir | Descripción |
|---|---|
| UDF escalares | Para más información sobre funciones escalares definidas por el usuario, véase Crear funciones definidas por el usuario. A partir de SQL Server 2019 (15.x), el Motor de base de datos de SQL Server puede insertar estas funciones en línea y desbloquear el uso del paralelismo durante el procesamiento de consultas. Para más información sobre el inlining escalar de UDF, véase Procesamiento inteligente de consultas en bases de datos SQL. |
| Consulta remota | Para obtener más información sobre Remote Query, consulte Referencia del operador showplan lógico y físico. |
| Cursores dinámicos | Para más información sobre cursores, consulta DECLARE CURSOR. |
| Consultas recursivas | Para más información sobre la recursión, consulte Directrices para Definir y Usar Expresiones Comunes Recursivas y Recursión en T-SQL. |
| Funciones con valores de tabla de múltiples instrucciones (MSTVF) | Para más información sobre los MSTVF, véase Crear funciones definidas por el usuario (Motor de base de datos). |
TOP (palabra clave) |
Para obtener más información, vea TOP. |
Un plan de ejecución de consultas puede contener el atributo NonParallelPlanReason en el elemento QueryPlan, que describe por qué no se usó el paralelismo. Los valores de este atributo incluyen:
| Valor NonParallelPlanReason | Descripción |
|---|---|
MaxDOPSetToOne |
Grado máximo de paralelismo establecido en 1. |
EstimatedDOPIsOne |
El grado estimado de paralelismo es 1. |
NoParallelWithRemoteQuery |
El paralelismo no se admite para las consultas remotas. |
NoParallelDynamicCursor |
Los planes paralelos no se admiten para los cursores dinámicos. |
NoParallelFastForwardCursor |
Los planes paralelos no se admiten para los cursores de avance rápido. |
NoParallelCursorFetchByBookmark |
Los planes paralelos no se admiten para los cursores que capturan por marcador. |
NoParallelCreateIndexInNonEnterpriseEdition |
La creación de índices en paralelo no se admite para ediciones que no sean Enterprise. |
NoParallelPlansInDesktopOrExpressEdition |
Los planes paralelos no se admiten para Desktop y Express Edition. |
NonParallelizableIntrinsicFunction |
La consulta hace referencia a una función intrínseca que no se puede paralelizar. |
CLRUserDefinedFunctionRequiresDataAccess |
El paralelismo no se admite para una UDF de CLR que requiere acceso a datos. |
TSQLUserDefinedFunctionsNotParallelizable |
La consulta hace referencia a una función definida por el usuario de T-SQL que no se podía paralelizar. |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
Las variables de tabla no admiten transacciones anidadas paralelas. |
DMLQueryReturnsOutputToClient |
La consulta DML devuelve el resultado al cliente y no se puede paralelizar. |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
La combinación de planes de serie y paralelos no se admite para una sola compilación de índice en línea. |
CouldNotGenerateValidParallelPlan |
Error al comprobar el plan paralelo; se realizará una conmutación por recuperación a la opción de serie. |
NoParallelForMemoryOptimizedTables |
El paralelismo no se admite para las tablas OLTP en memoria a las que se hace referencia. |
NoParallelForDmlOnMemoryOptimizedTable |
El paralelismo no se admite para DML en una tabla OLTP en memoria. |
NoParallelForNativelyCompiledModule |
El paralelismo no se admite para los módulos compilados de forma nativa a los que se hace referencia. |
NoRangesResumableCreate |
Error al generar intervalos para una operación de creación reanudable. |
Tras la inserción de operadores de intercambio, el resultado es un plan de ejecución de consultas en paralelo. Un plan de ejecución de consultas en paralelo puede usar más de un subproceso de trabajo. Un plan de ejecución en serie, usado por una consulta no paralela (en serie), solo usa un subproceso de trabajo para su ejecución. El número real de hilos de trabajo usados por una consulta paralela se determina en la inicialización de la ejecución del plan de consulta y depende de la complejidad del plan y del grado de paralelismo.
El grado de paralelismo (DOP) especifica el número máximo de procesadores que pueden usarse para ejecutar una tarea paralela. DOP no indica el número total de hilos de trabajo que utiliza una consulta. El límite de DOP se establece por tarea. No es un límite por solicitud ni por consulta. Esto significa que durante una ejecución de consultas en paralelo, una sola solicitud puede generar varias tareas que se asignan a un programador. Podrían usarse simultáneamente más procesadores de los especificados en el MAXDOP en un momento dado de la ejecución de consultas, cuando diferentes tareas se ejecutan simultáneamente. Para obtener más información, consulte la guía de arquitectura de tareas y subprocesos.
El Optimizador de Consultas no utiliza un plan de ejecución paralelo para una consulta si alguna de las siguientes condiciones es cierta:
El plan de ejecución en serie es trivial, o no supera la configuración de umbral de coste para el paralelismo.
El plan de ejecución en serie tiene un coste total estimado de subárbol menor al de cualquier plan de ejecución en paralelo explorado por el optimizador.
La consulta contiene operadores escalares o relacionales que no se pueden ejecutar en paralelo. Es posible que algunos operadores hagan que una sección del plan de consulta se ejecute en modo de serie, o que todo el plan se ejecute en modo de serie.
Nota:
El coste total estimado de subárbol de un plan en paralelo puede ser menor que el umbral de coste de la configuración del paralelismo. En otras palabras, el coste total estimado del subárbol del plan serial superaba al del otro, y se elegía el plan de consulta con el menor coste total estimado del subárbol.
Grado de paralelismo (DOP)
El Motor de base de datos detecta automáticamente el mejor grado de paralelismo para cada instancia de una ejecución de consulta paralela o de una operación de lenguaje de definición de datos (DDL) de índice. Determina este valor basándose en los siguientes criterios:
Si SQL Server se ejecuta en un equipo que dispone de más de un microprocesador o CPU, por ejemplo, un equipo de multiproceso simétrico (SMP). Solo los equipos con más de una CPU pueden utilizar consultas en paralelo.
Si hay suficientes subprocesos de trabajo disponibles. Cada operación de consulta o índice requiere que se ejecute un determinado número de subprocesos de trabajo. La ejecución de un plan en paralelo requiere más subprocesos de trabajo que un plan en serie, y el número de subprocesos de trabajo aumenta con el grado de paralelismo. Cuando no se puede satisfacer el requisito de hilos de trabajo del plan paralelo para un grado específico de paralelismo, el Motor de base de datos de SQL Server disminuye automáticamente el grado de paralelismo, o ejecuta el plan paralelo de forma serial.
El tipo de operación de consulta o índice ejecutado. Las operaciones de índice que crean o reconstruyen un índice, o que eliminan un índice agrupado y las consultas que utilizan intensamente los ciclos de la CPU son los candidatos idóneos para un plan de paralelismo. Por ejemplo, las combinaciones de tablas grandes, agregaciones importantes y la ordenación de grandes conjuntos de resultados son buenos candidatos. Las consultas básicas, frecuentemente encontradas en aplicaciones de procesamiento de transacciones, encuentran que la coordinación adicional necesaria para ejecutar una consulta en paralelo supera el posible aumento de rendimiento. Para distinguir entre las consultas que se benefician del paralelismo y las que no, el Motor de base de datos de SQL Server compara el coste estimado de ejecutar la operación de índice o la consulta con el valor de umbral de coste para el paralelismo . Los usuarios pueden cambiar el valor por defecto de
5usando sp_configure si las pruebas adecuadas detectan que un valor diferente es más adecuado para la carga de trabajo en ejecución.Si hay un número suficiente de filas que se van a procesar. Si el Optimizador de consultas determina que el número de filas es demasiado bajo, no proporciona operadores de intercambio para distribuir las filas. Por lo tanto, los operadores se ejecutan en serie. Ejecutar los operadores en un plan en serie evita los escenarios en que los costos de arranque, distribución y coordinación exceden las ganancias logradas mediante la ejecución de operadores en paralelo.
Si hay estadísticas actuales disponibles. Si no es posible establecer el grado de paralelismo más alto, se tienen en cuenta los grados inferiores antes de abandonar el plan en paralelo. Por ejemplo, cuando creas un índice agrupado en una vista, las estadísticas no pueden evaluarse, porque el índice agrupado aún no existe. En este caso, el Motor de base de datos de SQL Server no puede proporcionar el grado de paralelismo más alto para la operación de índice. Sin embargo, algunos operadores, como el ordenamiento y el escaneo, se siguen beneficiando de la ejecución en paralelo.
Nota:
Las operaciones de índices en paralelo están únicamente disponibles en las ediciones Enterprise, Developer y Evaluation de SQL Server.
En tiempo de ejecución, el Motor de base de datos de SQL Server determina si la carga de trabajo actual del sistema y la información de configuración descrita previamente permiten la ejecución en paralelo. Si se garantiza la ejecución en paralelo, el Motor de base de datos de SQL Server determina el número óptimo de subprocesos de trabajo y propaga la ejecución del plan en paralelo a dichos subprocesos. Cuando una operación de consulta o índice empieza a ejecutarse en varios subprocesos de trabajo para la ejecución en paralelo, se usa el mismo número de subprocesos hasta que la operación se completa. El Motor de base de datos de SQL Server vuelve a examinar el número óptimo de decisiones de subprocesos de trabajo cada vez que se recupera un plan de ejecución de la caché de planes. Por ejemplo, una ejecución de un plan paralelo en caché puede ejecutarse en serie, una ejecución posterior del mismo plan puede usar tres hilos de trabajo, y una tercera ejecución puede usar cuatro hilos de trabajo.
Los operadores de actualización y eliminación de un plan de ejecución de consultas en paralelo se ejecutan en serie, pero la cláusula WHERE de una instrucción UPDATE o DELETE se puede ejecutar en paralelo. Los cambios reales de los datos se aplican en serie a la base de datos.
A partir del nivel de compatibilidad de bases de datos 110, la SELECT ... INTO instrucción puede ejecutarse en paralelo. Otras formas del operador insert funcionan igual que en versiones anteriores.
A partir del nivel de compatibilidad de bases de datos 130, la INSERT ... SELECT instrucción puede ejecutarse en paralelo al insertar en heaps o índices clustered columnstore (CCI), y al usar la TABLOCK pista. También se habilitan insertos en tablas temporales locales (identificadas por el # prefijo) y tablas temporales globales (identificadas por ## prefijos) para paralelismo usando la TABLOCK pista. Para obtener más información, consulte INSERT.
Los cursores estáticos y los cursores impulsados por conjuntos clave pueden ser poblados mediante planes de ejecución en paralelo. Sin embargo, el comportamiento de los cursores dinámicos solo puede proporcionarse mediante la ejecución en serie. El optimizador de consultas siempre genera un plan de ejecución en serie para una consulta que es parte de un cursor dinámico.
Anulación de grados de paralelismo
El grado de paralelismo establece el número de procesadores que se van a utilizar en la ejecución de planes paralelos. Puedes configurar esta configuración en varios niveles:
A nivel de servidor, utilizando la opción de configuración del servidor max degree of parallelism (
MAXDOP).Se aplica a: SQL Server
SQL Server 2019 (15.x) introdujo recomendaciones automáticas para configurar la opción de
MAXDOPconfiguración del servidor durante el proceso de instalación. La interfaz de usuario del programa de instalación permite aceptar la configuración recomendada o introducir su propio valor. Para obtener más información, vea la página Configuración del Motor de base de datos: MaxDOP.A nivel de carga de trabajo, utilizando la
MAX_DOPopción de configuración de grupo de carga de trabajo Resource Governor.Se aplica a: SQL Server
A nivel de base de datos, utilizando la
MAXDOPconfiguración con alcance de base de datos.Aplica a: SQL Server, Azure SQL Database y Azure SQL Managed Instance
A nivel de instrucción de consulta o de índice, mediante la
MAXDOPsugerencia de consulta o laMAXDOPopción de índice. Por ejemplo, puedes usar laMAXDOPopción para controlar, aumentando o reduciendo, el número de procesadores dedicados a una operación de índice online. De este modo, puedes equilibrar los recursos utilizados por una operación de índice con los de los usuarios concurrentes.Aplica a: SQL Server, Azure SQL Database y Azure SQL Managed Instance
Al configurar la max degree of parallelism opción en 0 (por defecto), el Motor de base de datos puede utilizar todos los procesadores disponibles hasta un máximo de 64 procesadores en una ejecución paralela del plan. Aunque el Motor de base de datos establece un objetivo de ejecución de 64 procesadores lógicos cuando la MAXDOP opción está configurada en 0, puedes establecer manualmente un valor diferente si es necesario. Configurar MAXDOP en 0 para las consultas y los índices permite al Motor de base de datos utilizar todos los procesadores disponibles hasta un máximo de 64 procesadores para las consultas o índices dados en una ejecución paralela de plan.
MAXDOP no es un valor forzado para todas las consultas paralelas, sino un objetivo tentativo para todas las consultas elegibles para paralelismo. Esto significa que si no hay suficientes hilos worker disponibles en tiempo de ejecución, una consulta podría ejecutarse con un grado menor de paralelismo que el especificado por la opción de configuración del servidor MAXDOP.
Sugerencia
Para más información, consulte las recomendaciones de MAXDOP para obtener directrices sobre cómo configurar MAXDOP a nivel de servidor, base de datos, consulta o pista.
Ejemplo de consulta en paralelo
La siguiente consulta cuenta el número de pedidos realizados en un trimestre específico, comenzando el 1 de abril de 2024, y en los que al menos una línea del pedido fue recibida por el cliente después de la fecha prometida. Esta consulta muestra el número de dichos pedidos agrupados por orden de prioridad y de manera ascendente.
Este ejemplo utiliza nombres teóricos de tabla y columna.
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
Se supone que los índices siguientes están definidos en las tablas lineitem y orders:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
Éste es un posible plan en paralelo generado para la consulta mostrada anteriormente:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
La siguiente ilustración muestra un plan de consulta ejecutado con un grado de paralelismo igual a 4 y que implica una unión de dos tablas.
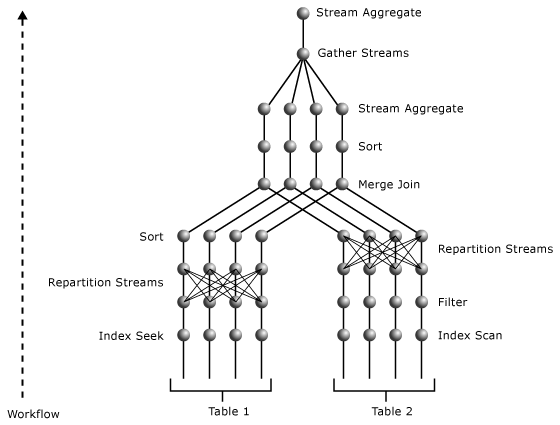
El plan paralelo contiene tres operadores de paralelismo. Tanto el operador Index Seek del índice o_datkey_ptr como el operador Index Scan del índice l_order_dates_idx se realizan en paralelo. Este proceso produce varios flujos exclusivos, que pueden determinarse a partir de los operadores de paralelismo más cercanos por encima del Escaneo de Índice y de los operadores de búsqueda de índices, respectivamente. Ambos operadores están reparticionando el tipo de intercambio. Reorganizan los datos entre los flujos y producen el mismo número de flujos en su salida que en su entrada. Este número de flujos equivale al grado de paralelismo.
El operador de paralelismo por encima del l_order_dates_idx operador Index Scan reparticiona sus flujos de entrada usando el valor de L_ORDERKEY como clave. De este modo, los mismos valores de L_ORDERKEY finalizan en el mismo flujo de salida. Al mismo tiempo, los flujos de salida conservan el orden de la columna L_ORDERKEY para cumplir los requisitos de entrada del operador Merge Join.
El operador de paralelismo por encima del operador Index Seek reparticiona sus flujos de entrada usando el valor de O_ORDERKEY. Como su entrada no está ordenada según los valores de la columna O_ORDERKEY y esta columna es la columna de unión en el operador Merge Join, el operador Sort entre los operadores de paralelismo y Merge Join asegura que la entrada esté ordenada para el operador Merge Join en las columnas de unión. El operador Sort, al igual que el operador Merge Join, se ejecuta en paralelo.
El operador de paralelismo más alto recopila los resultados de varios flujos en un solo flujo. Las agregaciones parciales que realiza el operador Stream Aggregate que está situado debajo del operador Parallelism se acumulan en un solo valor SUM para cada valor diferente de O_ORDERPRIORITY en el operador Stream Aggregate situado encima del operador Parallelism. Como este plan tiene dos segmentos de intercambio, con un grado de paralelismo igual a 4, utiliza ocho hilos de trabajo.
Para más información sobre los operadores usados en este ejemplo, consulte la referencia de operadores de plano lógico y físico.
Operaciones de índice en paralelo
Los planes de consulta para operaciones de índice que crean o reconstruyen un índice, o eliminan un índice agrupado, pueden soportar operaciones paralelas y multihilo en ordenadores que tienen múltiples procesadores.
Nota:
Las operaciones de índice paralelo solo están disponibles en la edición Enterprise.
Motor de base de datos utiliza los mismos algoritmos para determinar el grado de paralelismo (el número total de hilos de trabajo separados a ejecutar) para operaciones de índice que para otras consultas. La opción de configuración del servidor grado máximo de paralelismo establece el grado máximo de paralelismo para una operación de índice. Puedes anular el valor max degree of parallelism para operaciones de índice individuales estableciendo la opción de índice MAXDOP en las sentencias CREATE INDEX, ALTER INDEX, DROP INDEX y ALTER TABLE.
Cuando el Motor de base de datos de SQL Server construye un plan de ejecución de índice, el número de operaciones paralelas se establece al valor más bajo entre estos valores:
- El número de procesadores, o CPUs, en el ordenador.
- El número especificado en la opción de configuración del
max degree of parallelismservidor. - El número de CPUs que no están ya por encima de un umbral de trabajo realizado para los subprocesos de trabajo de SQL Server.
Por ejemplo, en un ordenador que tiene ocho CPUs, pero donde max degree of parallelism está establecido en 6, la operación de índice utiliza no más de seis hilos de trabajo paralelos. Si cinco de las CPU del equipo han excedido ya el umbral de trabajo de SQL Server cuando se crea un plan de ejecución de índice, el plan de ejecución especificará únicamente tres subprocesos de trabajo en paralelo.
Las principales fases de una operación de índice paralelo incluyen:
- Un subproceso de trabajo de coordinación recorre la tabla rápida y aleatoriamente para calcular la distribución de las claves de índice. El hilo de trabajo coordinador establece los límites de clave que crean un número de rangos de clave igual al grado de operaciones paralelas, donde cada rango de clave se estima que cubre un número similar de filas. Por ejemplo, si hay cuatro millones de filas en la tabla y el grado de paralelismo es 4, el hilo de trabajo coordinador determina los valores clave que delimitan cuatro conjuntos de filas con 1 millón de filas en cada conjunto. Si el hilo de trabajo coordinador no puede establecer suficientes rangos de claves para usar todas las CPUs, se reduce el grado de paralelismo en consecuencia.
- El subproceso de trabajo de coordinación genera un número de subprocesos de trabajo igual al grado de operaciones en paralelo y espera hasta que estos subprocesos de trabajo finalicen su trabajo. Cada subproceso de trabajo recorre la tabla base mediante un filtro que recupera solo filas con valores de clave en el rango asignado al subproceso de trabajo. Cada subproceso de trabajo crea una estructura de índice para las filas en su rango con clave. En el caso de un índice con particiones, cada subproceso de trabajo genera un número especificado de particiones. Las particiones no se comparten entre los subprocesos de trabajo.
- Una vez completados todos los hilos de trabajo paralelos, el hilo de trabajo coordinador conecta las subunidades índice en un solo índice. Esta fase solo se aplica a operaciones de índice sin conexión.
Las sentencias individuales CREATE TABLE o ALTER TABLE pueden tener múltiples restricciones que requieren crear un índice. Estas operaciones de creación de índice se llevan a cabo en serie, aunque cada operación de creación de índice puede ser una operación en paralelo en un equipo con varias CPU.
Arquitectura de consultas distribuidas
El Motor de base de datos soporta dos métodos para referenciar fuentes de datos heterogéneas de OLE DB en sentencias T-SQL:
Nombres de servidores vinculados
Utiliza los procedimientos almacenados del sistema
sp_addlinkedserverysp_addlinkedsrvloginpara dar un nombre de servidor a una fuente de datos OLE DB. Puedes referenciar objetos en estos servidores enlazados en sentencias T-SQL con nombres de cuatro partes. Por ejemplo, si un nombre de servidor vinculado deDeptSQLSrvrse define en otra instancia de SQL Server, la instrucción siguiente hace referencia a una tabla de ese servidor:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;También puedes especificar el nombre del servidor enlazado en una
OPENQUERYinstrucción para abrir un conjunto de filas desde la fuente de datos de OLE DB. Luego puedes referenciar este conjunto de filas como una tabla en las sentencias de T-SQL.Nombres de conectores ad hoc
Para referencias poco frecuentes a una fuente de datos, especifica las funciones
OPENROWSEToOPENDATASOURCEcon la información necesaria para conectarse al servidor vinculado. Luego puedes referenciar el conjunto de filas de la misma manera que referencias una tabla en las sentencias T-SQL:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
El Motor de base de datos utiliza OLE DB para comunicarse entre el motor relacional y el motor de almacenamiento. El motor relacional desglosa cada sentencia T-SQL en una serie de operaciones sobre conjuntos de filas básicos de OLE DB que el motor de almacenamiento abre desde las tablas base. Este proceso significa que el motor relacional también puede abrir conjuntos de filas básicos de OLE DB en cualquier fuente de datos de OLE DB.
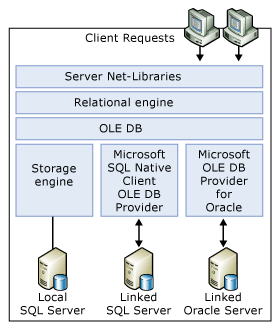
El motor relacional utiliza la interfaz de programación de aplicaciones (API) OLE DB para abrir los conjuntos de filas en servidores vinculados, capturar las filas y administrar las transacciones.
Para cada fuente de datos de OLE DB a la que accedas como servidor enlazado, el servidor que ejecuta SQL Server debe tener un proveedor de OLE DB. El conjunto de operaciones T-SQL que puedes usar contra una fuente de datos específica de OLE DB depende de las capacidades del proveedor de OLE DB.
Para cada instancia de SQL Server, los miembros del rol de servidor fijo sysadmin pueden habilitar o deshabilitar el uso de nombres de conectores ad hoc para un proveedor de OLE DB utilizando la propiedad SQL ServerDisallowAdhocAccess. Cuando se habilita el acceso ad hoc, cualquier usuario que inicie sesión en esa instancia puede ejecutar sentencias T-SQL que contengan nombres de conectores ad hoc, referenciando cualquier fuente de datos en la red a la que el proveedor de OLE DB pueda acceder. Para controlar el acceso a fuentes de datos, los miembros del rol de servidor fijo sysadmin pueden desactivar el acceso ad hoc para ese proveedor de OLE DB, limitando así a los usuarios solo a aquellas fuentes de datos referenciadas por nombres de servidor enlazados definidos por los administradores. De forma predeterminada, el acceso ad hoc está habilitado para el proveedor OLE DB de SQL Server y deshabilitado para los demás proveedores OLE DB.
Las consultas distribuidas pueden permitir a los usuarios acceder a otra fuente de datos (por ejemplo, archivos, fuentes de datos no relacionales como Active Directory, etc.) utilizando el contexto de seguridad de la cuenta de Windows bajo la que se ejecuta el servicio SQL Server. SQL Server suplanta adecuadamente la cuenta de inicio de sesión en los inicios de sesión de Windows. Sin embargo, esa suplantación no es posible para las cuentas de inicio de sesión de SQL Server. Esta limitación puede permitir potencialmente que un usuario de consulta distribuida acceda a otra fuente de datos para la que no tiene permisos, pero la cuenta bajo la que se ejecuta el servicio SQL Server sí tiene permisos. Utilice sp_addlinkedsrvlogin para definir los inicios de sesión específicos con acceso autorizado al servidor vinculado correspondiente. Este control no está disponible para nombres ad hoc, así que hay que tener precaución al habilitar un proveedor de OLE DB para acceso ad hoc.
Cuando es posible, el Motor de base de datos delega operaciones relacionales como uniones, restricciones, proyecciones, ordenaciones y operaciones GROUP BY al origen de datos OLE DB. El Motor de base de datos no carga de forma predeterminada la tabla base en SQL Server ni realiza las operaciones relacionales por sí mismo. El Motor de base de datos consulta al proveedor de OLE DB para determinar el nivel de gramática SQL que soporta y, basándose en esa información, envía tantas operaciones relacionales como sea posible al proveedor.
El Motor de base de datos especifica un mecanismo para que un proveedor de OLE DB devuelva estadísticas que indican cómo se distribuyen los valores clave dentro de la fuente de datos de OLE DB. Este mecanismo permite al Motor de base de datos Query Optimizer analizar mejor el patrón de datos en la fuente de datos frente a los requisitos de cada sentencia T-SQL, aumentando la capacidad del Query Optimizer para generar planes de ejecución óptimos.
Procesamiento de consultas en tablas e índices particionados
El Motor de base de datos soporta procesamiento de consultas consciente de particiones para tablas e índices particionados. Esta sección describe cómo el procesador de consultas gestiona los objetos particionados, cómo interpretar planes de ejecución que implican particionamiento y las mejores prácticas para mejorar el rendimiento de las consultas en objetos particionados.
Nota:
Las tablas e índices particionados son compatibles con SQL Server Standard Edition, comenzando con SQL Server 2016 (13.x) con Service Pack 1.
Nueva operación de búsqueda orientada a particiones
En el Motor de base de datos, el procesador de consultas ve internamente una tabla particionada como un índice multicolumna con PartitionID como columna inicial.
PartitionID es una columna calculada oculta usada internamente para representar el valor de ID de la partición que contiene una fila específica. Por ejemplo, supongamos que la tabla T, definida como T(a, b, c), está particionada en la columna a, y tiene un índice agrupado en la columna b. Esta tabla particionada se trata como una tabla no particionada con el esquema T(PartitionID, a, b, c) y un índice agrupado sobre la clave compuesta (PartitionID, b). Esta representación permite al Optimizador de Consultas realizar operaciones de búsqueda basadas en PartitionID en cualquier tabla o índice particionado.
Ahora, la eliminación de particiones se lleva a cabo durante esta operación de búsqueda.
Además, el Optimizador de Consultas se amplía para que se pueda realizar una operación de búsqueda o escaneo con una condición en PartitionID (como columna inicial lógica) y posiblemente otras columnas clave de índice. El procesador de consultas realiza entonces una búsqueda de segundo nivel, con una condición diferente, sobre una o más columnas adicionales, para cada valor distinto que cumpla con la condición para la operación de búsqueda de primer nivel. Esta operación, llamada partition skip scan, permite al Optimizador de Consultas realizar una operación de búsqueda o escaneo basada en una condición para determinar las particiones a las que acceder, y una operación de búsqueda de índice de segundo nivel dentro de ese operador para devolver filas de estas particiones que cumplen una condición diferente. Por ejemplo, considere la siguiente consulta.
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
Para este ejemplo, supongamos que la tabla T, definida como T(a, b, c), está particionada en la columna a, y tiene un índice agrupado en la columna b. La siguiente función de partición define los límites de partición para la tabla T:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
Para llevar a cabo la consulta, el procesador de consultas realiza una operación de búsqueda de primer nivel para localizar todas las particiones que cumplan con la condición T.a < 10. Esta operación identifica las particiones a las que acceder. Dentro de cada partición identificada, el procesador realiza una búsqueda de segundo nivel en el índice agrupado en columna b para encontrar las filas que cumplen la condición T.b = 2 y T.a < 10.
La siguiente ilustración es una representación lógica de la operación de exploración con omisión de particiones. En ella se muestra la tabla T con datos en las columnas a y b. Las particiones están numeradas del 1 al 4; las líneas discontinuas representan los límites de las particiones. Una operación de búsqueda de primer nivel en las particiones (no mostrada en la ilustración) determina que las particiones 1, 2 y 3 cumplen la condición de búsqueda implícita por el particionamiento definido para la tabla y el predicado en la columna a (T.a < 10). El camino recorrido por la búsqueda de segundo nivel se ilustra con la línea curva. Esencialmente, la operación busca en cada una de estas particiones filas que cumplen la condición b = 2. El coste total de la operación es el mismo que el de tres búsquedas de índice separadas.
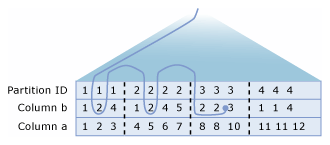
Visualización de la información de creación de particiones en los planes de ejecución de consultas
Examina los planes de ejecución de consultas en tablas e índices particionados usando las sentencias SET SHOWPLAN_XML T-SQL SET o SET STATISTICS XML, o usando la salida gráfica del plan de ejecución en SSMS. Por ejemplo, puedes mostrar el plan de ejecución en tiempo de compilación seleccionando Mostrar Plan de Ejecución Estimado en la barra de herramientas del Editor de Power Query y el plan de ejecución en tiempo de ejecución seleccionando Incluir Plan de Ejecución Real.
Utilizando estas herramientas, puedes encontrar la siguiente información:
- Las operaciones como escaneos, búsquedas, inserciones, actualizaciones, fusiones y eliminaciones acceden a tablas o índices particionados.
- Las particiones a las que tiene acceso la consulta. Por ejemplo, los planes de ejecución en tiempo de ejecución incluyen el recuento total de particiones accedidas y los rangos de particiones contiguas a las que se accede.
- Cuando se utiliza una operación de exploración con omisión de particiones en una operación de búsqueda o escaneo para recuperar datos de una o más particiones.
Mejoras de la información sobre particiones
El Motor de base de datos proporciona información mejorada de particionamiento tanto para planes de ejecución en tiempo de compilación como en tiempo de ejecución. Los planes de ejecución proporcionan ahora la siguiente información:
- Un atributo opcional
Partitionedque indica que un operador, como buscar, escanear, insertar, actualizar, fusionar o eliminar, se realiza en una tabla particionada. - Un nuevo elemento
SeekPredicateNewcon un subelementoSeekKeysque incluyePartitionIDcomo columna principal de clave de índice y condiciones de filtro que especifican búsquedas de rango enPartitionID. La presencia de dosSeekKeyssubelementos indica un escaneo de salto de partición enPartitionID. - Información de resumen que proporciona el número total de particiones a las que se ha tenido acceso. Esta información está disponible únicamente en planes de ejecución en tiempo real.
Para mostrar cómo aparece esta información tanto en la salida gráfica del plan de ejecución como en la salida XML de Showplan, considere la siguiente consulta sobre la tabla con particiones fact_sales. Esta consulta actualiza datos en dos particiones.
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
En la siguiente ilustración, se muestran las propiedades del operador Clustered Index Seek en el plan de ejecución del entorno de ejecución para esta consulta. Para ver la definición de la fact_sales tabla y la definición de la partición, véase Ejemplo.
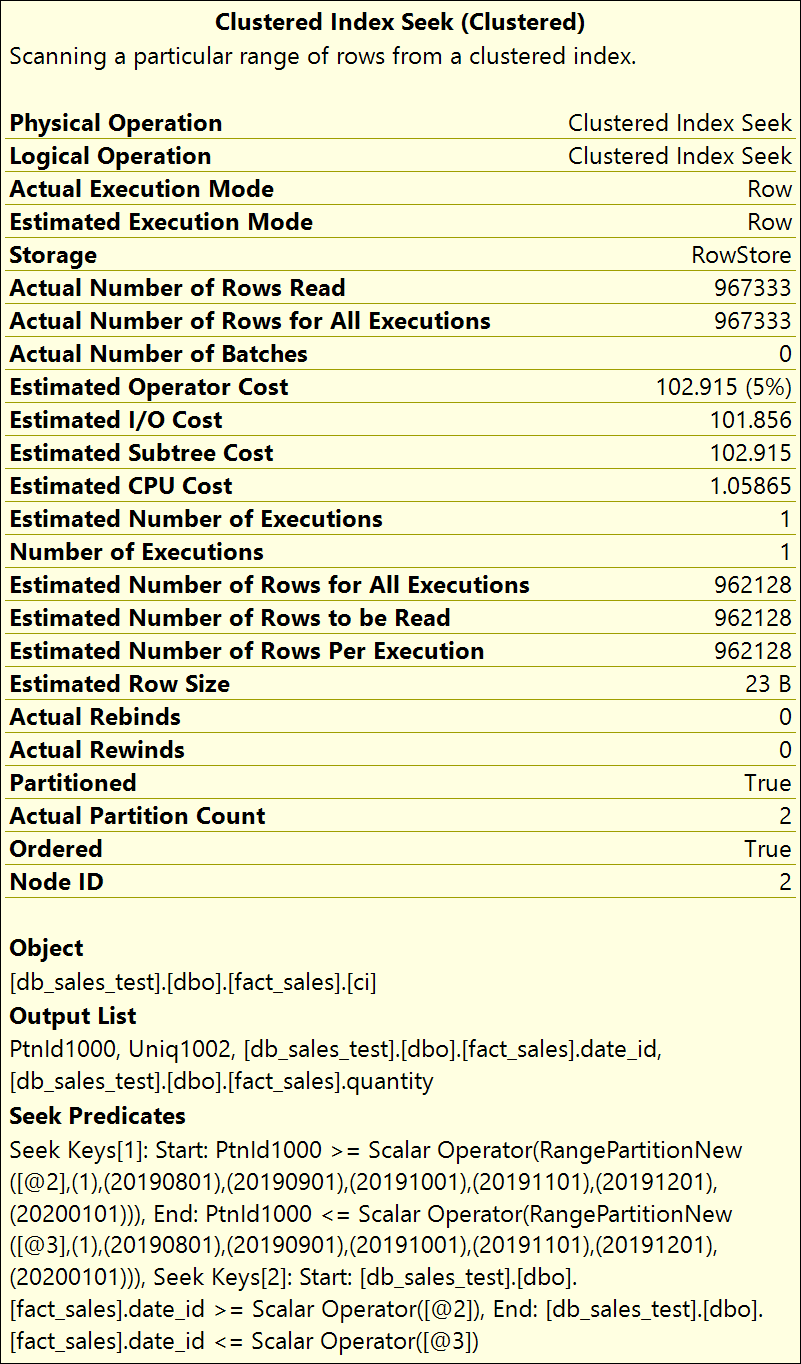
Atributo particionado
Cuando un operador como Index Seek se ejecuta en un índice o tabla con particiones, el atributo Partitioned aparece en los planes de tiempo de compilación y de ejecución y se establece en True (1). El atributo no se muestra cuando está configurado en False (0).
El atributo Partitioned puede aparecer en los siguientes operadores físicos y lógicos:
- Examen de tablas
- Examen de índice
- Búsqueda en el índice
- Insertar
- Actualizar
- Eliminar
- Fusionar
Como se muestra en la ilustración anterior, este atributo aparece en las propiedades del operador en el que está definido. En la salida XML Showplan, este atributo aparece como Partitioned="1" en el nodo RelOp del operador en el que está definido.
Predicado de búsqueda nuevo
En la salida de XML Showplan, el SeekPredicateNew elemento aparece en el operador en el que está definido. Puede contener hasta un máximo de dos apariciones del subelemento SeekKeys . El primer elemento SeekKeys especifica la operación de búsqueda de primer nivel a nivel de identificador de partición del índice lógico. Es decir, esta operación de búsqueda determina las particiones a las que deben accederse para cumplir las condiciones de la consulta. El segundo SeekKeys elemento especifica la búsqueda de segundo nivel que ocurre dentro de cada partición identificada en la búsqueda de primer nivel.
Información resumida de particiones
En los planes de ejecución en tiempo de ejecución, la información del resumen de particiones proporciona un recuento de las particiones a las que se ha accedido y la identidad de las particiones reales accedidas. Esta información puede utilizarse para comprobar que la consulta tiene acceso a las particiones correctas y que todas las demás particiones no se consideran.
Se proporciona la siguiente información: Actual Partition County Partitions Accessed.
Actual Partition Count es el número total de particiones a las que la consulta ha tenido acceso.
Partitions Accessed, en la salida de XML Showplan, es la información resumida de la partición que aparece en el nuevo elemento RuntimePartitionSummary del nodo RelOp del operador en el que está definida. El siguiente ejemplo muestra los contenidos del elemento RuntimePartitionSummary , que indica que se ha tenido acceso a un total de dos particiones (particiones 2 y 3).
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
Mostrar la información de la partición utilizando otros métodos de showplan
Los métodos del plan de presentación SHOWPLAN_ALL, SHOWPLAN_TEXT y STATISTICS PROFILE no notifican la información de particiones que se describe en este artículo, con la siguiente excepción. Como parte del predicado SEEK , las particiones a las que se va a tener acceso están identificadas por un predicado de intervalo definido sobre la columna calculada que representa el identificador de la partición. En el ejemplo siguiente se muestra el predicado SEEK para un operador Clustered Index Seek . Se obtiene acceso a las particiones 2 y 3, y el operador de búsqueda filtra las filas que cumplen con la condición date_id BETWEEN 20190802 AND 20190902.
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
Interpretación de planes de ejecución para montones con particiones
Un montón con particiones se trata como un índice lógico sobre el identificador de partición. En un plan de ejecución, la eliminación de particiones en un heap particionado se representa como un Table Scan operador con un SEEK predicado sobre el ID de partición. El siguiente ejemplo muestra la información de Showplan proporcionada:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
Interpretación de planes de ejecución para combinaciones por colocación
La combinación colocada puede darse cuando dos tablas presentan particiones que usan funciones de partición iguales o equivalentes y las columnas de partición de ambos lados de la combinación se especifican en la condición de combinación de la consulta. El optimizador de consultas puede generar un plan en el que las particiones de cada tabla que tengan los mismos identificadores de partición se combinen de forma independiente. Las uniones colocadas pueden ser más rápidas que las uniones no colocadas, puesto que pueden requerir menos memoria y tiempo de procesamiento. El Optimizador de consultas elige un plan no colocado o colocado en función de las estimaciones de costos.
En un plan colocado, la combinación Nested Loops lee una o varias particiones de índice o tabla combinada de la parte interna. Los números en el interior de los operadores Constant Scan representan los números de partición.
Cuando se generan planes paralelos para combinaciones por colocación para índices o tablas con particiones, aparece un operador Parallelism entre los operadores de combinación Constant Scan y Nested Loops . En este caso, los distintos subprocesos de trabajo de la parte exterior de la combinación leen y trabajan en una partición diferente.
La siguiente ilustración muestra un plan de consulta paralela para una combinación por colocación.
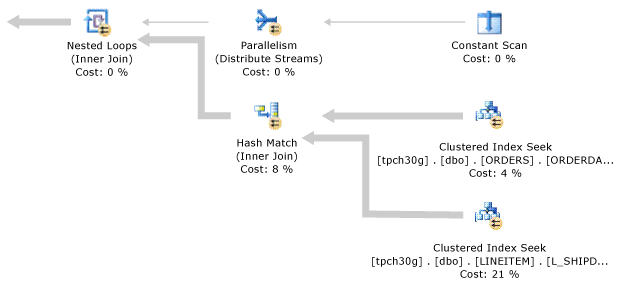
Estrategia de ejecución de consultas en paralelo para objetos con particiones
El procesador de consultas utiliza una estrategia de ejecución paralela para consultas que seleccionan en objetos con particiones. Como parte de la estrategia de ejecución, el procesador de consultas determina las particiones de tabla requeridas para la consulta y la proporción de subprocesos de trabajo que se han de asignar a cada partición. En la mayoría de los casos, el procesador de consultas asigna a cada partición un número igual, o casi igual, de subprocesos de trabajo y, después, ejecuta la consulta en paralelo en las particiones. En los párrafos siguientes se explica la asignación de subprocesos de trabajo con más detalle.
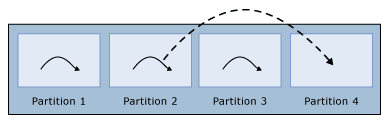
Si el número de subprocesos de trabajo es menor que el número de particiones, el procesador de consultas asigna cada subproceso de trabajo a una partición diferente, pero deja inicialmente una o más particiones sin un subproceso de trabajo asignado. Cuando un hilo de trabajo termina de ejecutarse en una partición, el procesador de consultas lo asigna a la siguiente partición hasta que a cada partición se le asigne un único hilo de trabajo. Esta asignación es el único caso en el que el procesador de consultas reasigna hilos de trabajo a otras particiones.
Muestra el subproceso de trabajo reasignado después de finalizar. Si el número de subprocesos de trabajo es igual al número de particiones, el procesador de consultas asigna un subproceso de trabajo a cada partición. Cuando un subproceso de trabajo finaliza, no se reasigna a otra partición.
Si el número de subprocesos de trabajo es mayor que el número de particiones, el procesador de consultas asigna un número igual de subprocesos de trabajo a cada partición. Si el número de hilos de trabajo no es un múltiplo exacto del número de particiones, el procesador de consultas asigna un hilo de trabajo extra a algunas particiones para poder usar todos los hilos de trabajo disponibles. Si solo hay una partición, todos los hilos de trabajo se asignan a esa partición. En el siguiente diagrama, hay cuatro particiones y 14 hilos de trabajo. Cada partición tiene asignados tres hilos de trabajo, y dos particiones tienen un hilo de trabajo adicional, para un total de 14 asignaciones de hilos de trabajo. Cuando un subproceso de trabajo finaliza, no se reasigna a otra partición.
Aunque los ejemplos anteriores sugieren una forma sencilla de asignar hilos de trabajo, la estrategia real es más compleja y tiene en cuenta otras variables que ocurren durante la ejecución de la consulta. Por ejemplo, si la tabla está particionada y tiene un índice agrupado en columna A y una consulta tiene la cláusula WHERE A IN (13, 17, 25)de predicado , el procesador de consultas asigna uno o más hilos de trabajo a cada uno de estos tres valores de búsqueda (A = 13, A = 17, y A = 25) en lugar de cada partición de tabla. Solo es necesario ejecutar la consulta en las particiones que contienen estos valores, y si todos estos predicados de búsqueda están en la misma partición de tabla, todos los hilos de trabajo se asignan a la misma partición de tabla.
Por tomar otro ejemplo, supongamos que la tabla tiene cuatro particiones en columna A con puntos de contorno (10, 20, 30), un índice en la columna B, y la consulta tiene una cláusula de predicado WHERE B IN (50, 100, 150). Debido a que las particiones de la tabla se basan en los valores de A, los valores de B pueden aparecer en cualquiera de las particiones de la tabla. Así, el procesador de consultas busca cada uno de los tres valores de B (50, 100, 150) en cada una de las cuatro particiones de la tabla. El procesador de consultas asigna los hilos de trabajo proporcionalmente para poder ejecutar cada uno de estos 12 escaneos de consulta en paralelo.
Particiones de tabla basadas en la columna A |
Busca columna B en cada partición de tabla |
|---|---|
Partición de la tabla 1: A < 10 |
B = 50, , B = 100, B = 150 |
Partición de la tabla 2: A >= 10 AND A < 20 |
B = 50, , B = 100, B = 150 |
Partición de la tabla 3: A >= 20 AND A < 30 |
B = 50, , B = 100, B = 150 |
Partición de la tabla 4: A >= 30 |
B = 50, , B = 100, B = 150 |
procedimientos recomendados
Para mejorar el rendimiento de consultas que acceden a una gran cantidad de datos de grandes tablas e índices particionados, sigue estas mejores prácticas:
Distribuya cada partición entre varios discos. Este enfoque es especialmente relevante al usar discos duros mecánicos.
Cuando sea posible, utilice un servidor con memoria principal suficiente para alojar en ella las particiones con una mayor frecuencia de acceso, o todas las particiones, con el fin de reducir el coste de la E/S.
Si los datos que consultas no cabien en memoria, comprime las tablas y los índices para reducir el coste de E/S.
Utilice un servidor con procesadores rápidos y tantos núcleos de procesador como pueda permitirse, con el fin de sacar partido de la capacidad de procesamiento de las consultas en paralelo.
Asegúrese de que el servidor dispone de un ancho banda de controlador de E/S suficiente.
Cree un índice agrupado en cada tabla grande con particiones para aprovechar las optimizaciones de escaneo de B-tree.
Al cargar datos en bloque en tablas particionadas, sigue las recomendaciones de buenas prácticas del documento técnico, La Guía de Rendimiento de Carga de Datos.
Ejemplo
El ejemplo siguiente crea una base de datos de prueba que contiene una única tabla con siete particiones. Para ver la información de particionamiento tanto para planes de compilación como de ejecución, utilice las herramientas descritas en Mostrar información de particionamiento en los planes de ejecución de consultas al ejecutar las consultas en este ejemplo.
Nota:
Este ejemplo inserta más de 1 millón de filas en la tabla. En función de su hardware, la ejecución de este ejemplo puede tomar varios minutos. Antes de ejecutar este ejemplo, compruebe que tiene más de 1,5 GB de espacio en disco disponible.
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO
Contenido relacionado
- Referencia de operador de plan de presentación lógico y físico
- Información general sobre Extended Events
- Procedimientos recomendados para supervisar cargas de trabajo con Almacén de consultas
- Estimación de cardinalidad (SQL Server)
- Procesamiento de consultas inteligente en bases de datos SQL
- Prioridad de operador (Transact-SQL)
- Información general sobre el plan de ejecución
- Centro de rendimiento para el motor de base de datos SQL Server y Azure SQL Database