Resolución de duplicados y nulos
Los problemas de calidad de los datos, como los registros duplicados y los valores nulos, pueden comprometer tus análisis y procesos posteriores. Si los duplicados surgen de cargas de datos simultáneas o valores NULL aparecen debido a datos de origen incompletos, solucionar estos problemas es una responsabilidad principal de los ingenieros de datos que trabajan en Azure Databricks.
En esta unidad, usted aprenderá cómo identificar y resolver valores duplicados, faltantes y nulos mediante los enfoques SQL y PySpark.
Identificación de registros duplicados
Antes de poder eliminar duplicados, tiene que encontrarlos. Los duplicados suelen producirse cuando el mismo registro aparece varias veces en una tabla, a menudo debido a problemas de integración de datos, ingesta repetida o operaciones de escritura simultáneas.
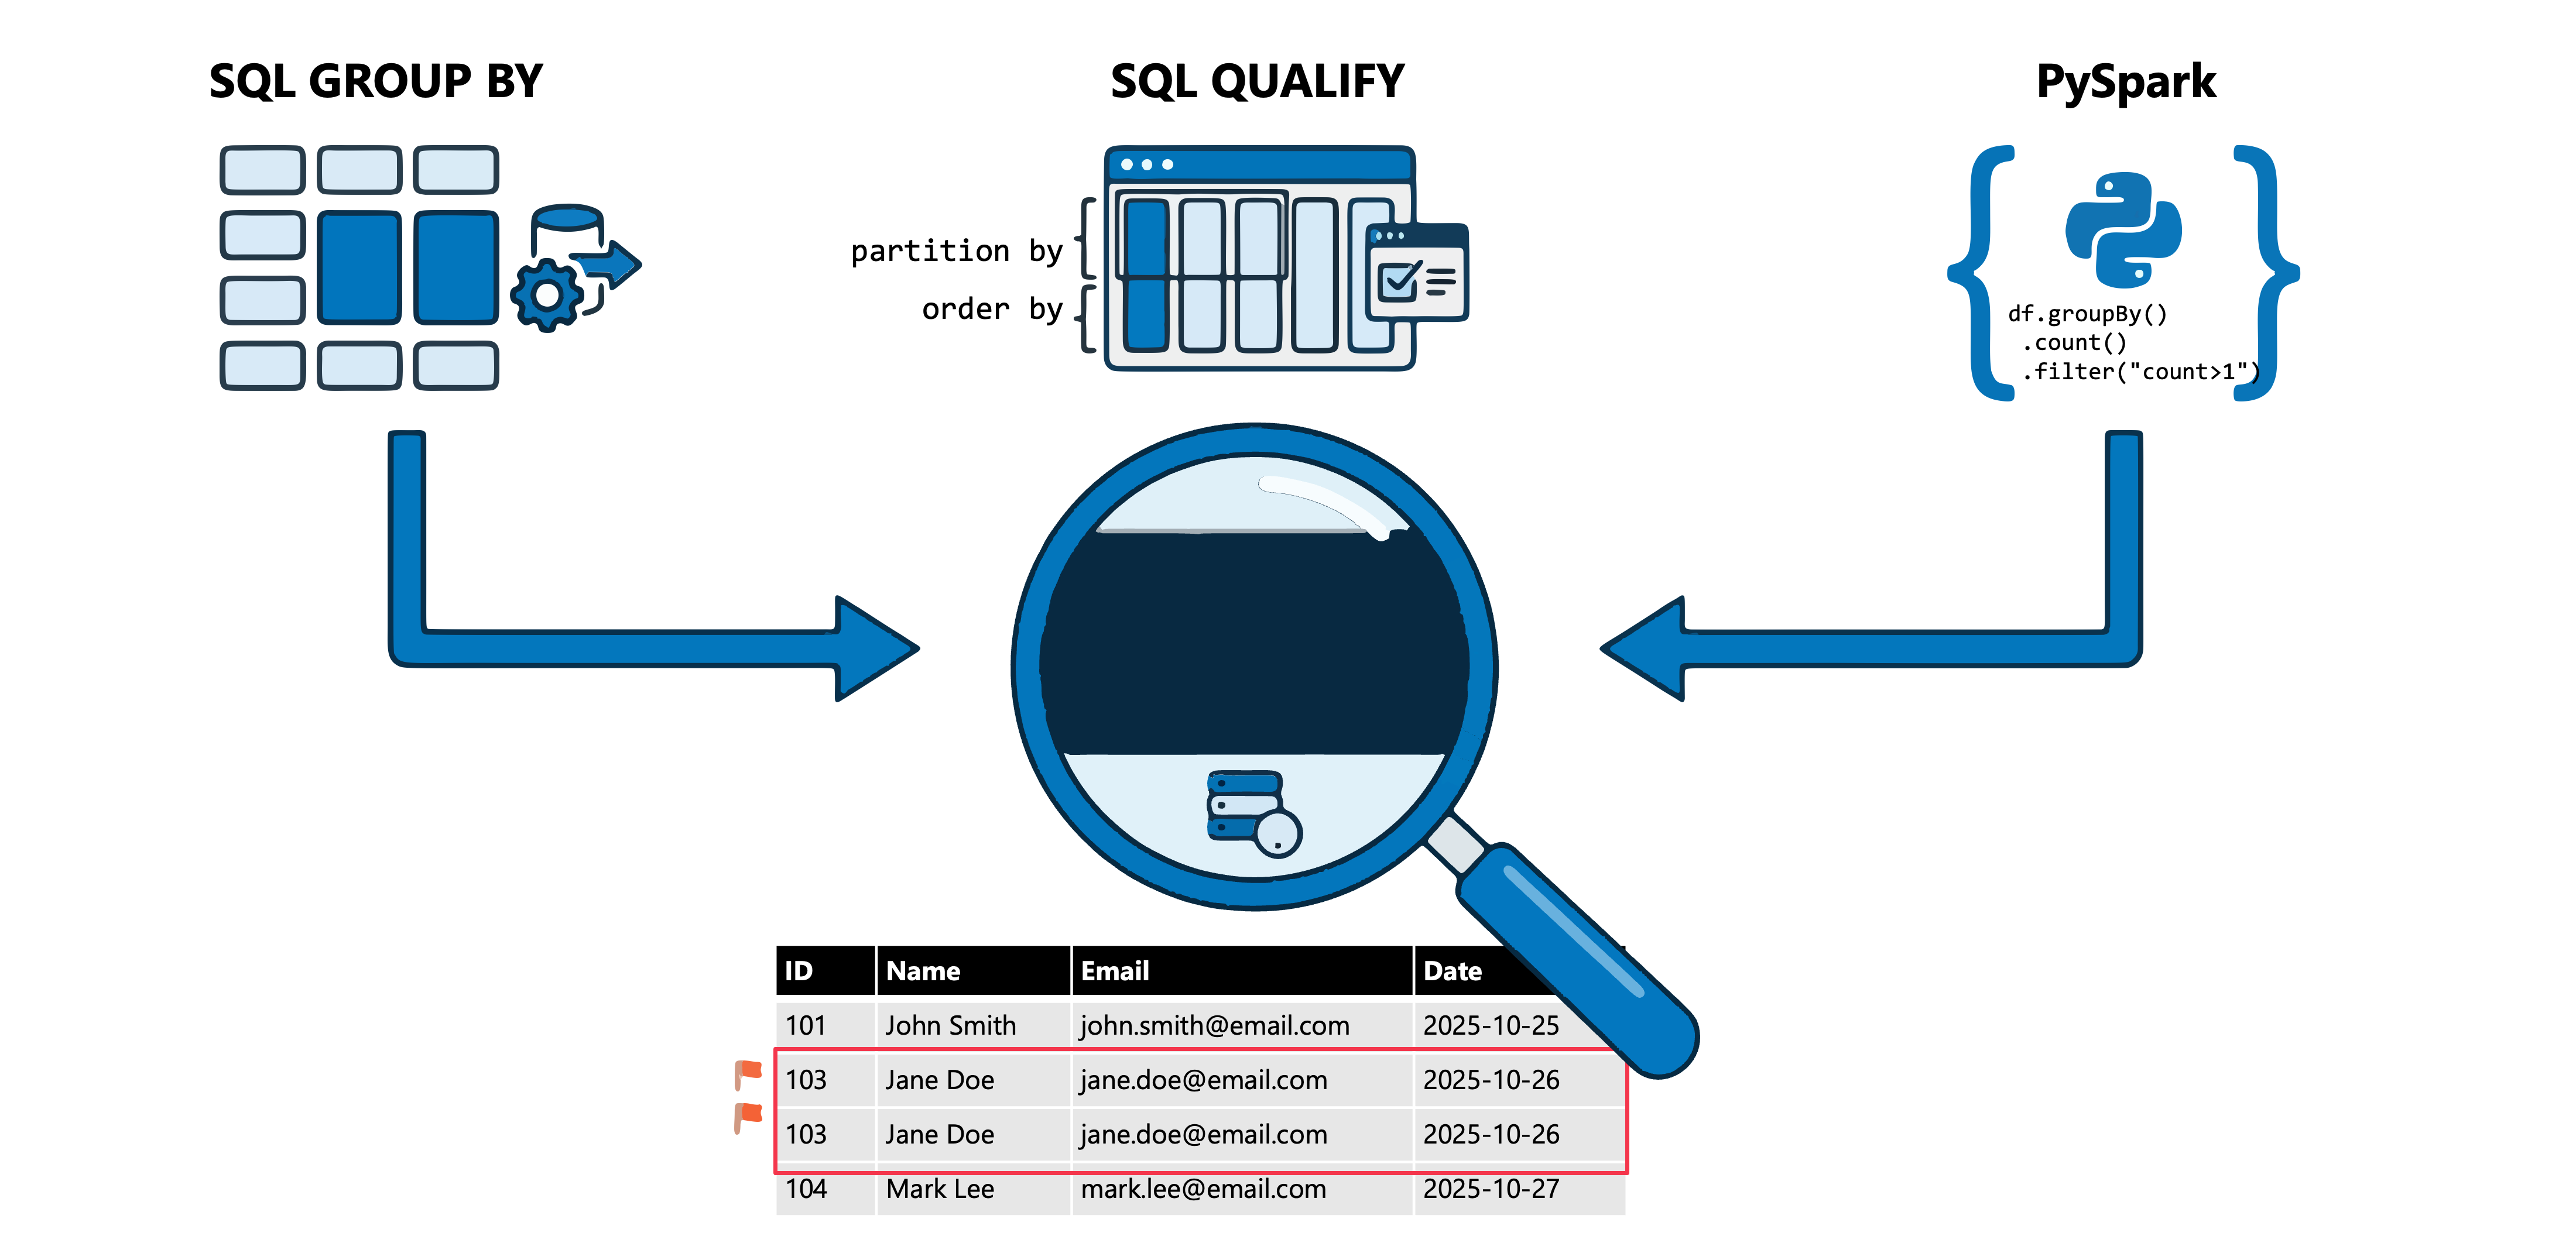
Usar GROUP BY y HAVING para buscar duplicados
La manera más sencilla de identificar duplicados es agrupando registros y contando repeticiones. La HAVING cláusula filtra los resultados agrupados para mostrar solo los valores que aparecen más de una vez.
SELECT
    customer_id,
    email,
    COUNT(*) AS occurrence_count
FROM sales.customers
GROUP BY customer_id, email
HAVING COUNT(*) > 1
ORDER BY occurrence_count DESC;
Esta consulta devuelve todas las combinaciones de customer_id y email que aparecen varias veces en la tabla, lo que le ayuda a comprender el ámbito de la duplicación.
Uso de QUALIFY con funciones de ventana
La QUALIFY cláusula proporciona un enfoque más sencillo filtrando los resultados de las funciones de ventana directamente, sin necesidad de subconsultas. Este enfoque es particularmente útil cuando necesita ver las filas duplicadas reales, no solo los recuentos.
SELECT *
FROM sales.customers
QUALIFY COUNT(*) OVER (PARTITION BY customer_id, email) > 1;
Esta consulta podría devolver resultados como:
| customer_id | Correo electrónico | nombre | fecha_de_creación | estado |
|---|---|---|---|---|
| 1001 | jane@contoso.com | Jane Doe | 2024-01-15 | Active |
| 1001 | jane@contoso.com | Jane D. | 2024-03-20 | Active |
| 1002 | bob@fabrikam.com | Bob Smith | 2024-02-10 | Pendiente |
| 1002 | bob@fabrikam.com | Robert Smith | 11/02/2024 | Active |
Con este patrón, obtendrá todas las columnas de las filas duplicadas, lo que facilita la investigación del origen de la duplicación.
Búsqueda de duplicados mediante PySpark
En PySpark, puede usar funciones de ventana combinadas con el filtrado para identificar registros duplicados:
from pyspark.sql.functions import count
from pyspark.sql.window import Window

window_spec = Window.partitionBy("customer_id", "email")

duplicates_df = (
    df.withColumn("row_count", count("*").over(window_spec))
    .filter("row_count > 1")
    .drop("row_count")
)

display(duplicates_df)
Como alternativa, use el exceptAll() método para comparar el dataframe original con una versión desduplicada:
df_duplicates = df.exceptAll(df.dropDuplicates(["customer_id", "email"]))
display(df_duplicates)
El exceptAll() método realiza una diferencia establecida que conserva los duplicados. Devuelve todas las filas del primer DataFrame que no están en el segundo DataFrame, manteniendo las ocurrencias duplicadas. Así es como funciona:
-
df.dropDuplicates(["customer_id", "email"])crea un DataFrame con una fila para cada combinación única -
exceptAll()compara el dataframe original con esta versión desduplicada. - Para cada combinación única, una ocurrencia se "empareja" y se quita, dejando solo las duplicaciones sobrantes.
Por ejemplo, si el cliente 1001 aparece tres veces en el DataFrame original y una vez en la versión desduplicada, exceptAll() devuelve dos filas (las apariciones adicionales).
Nota:
A diferencia de except(), que quita todas las filas coincidentes y devuelve resultados distintos, exceptAll() conserva la estructura duplicada. Si tiene tres filas idénticas en el original y otra en el conjunto desduplicado, exceptAll() devuelve exactamente dos filas.
Eliminación de registros duplicados
Una vez que haya identificado duplicados, puede elegir una estrategia de resolución en función de los requisitos de datos.
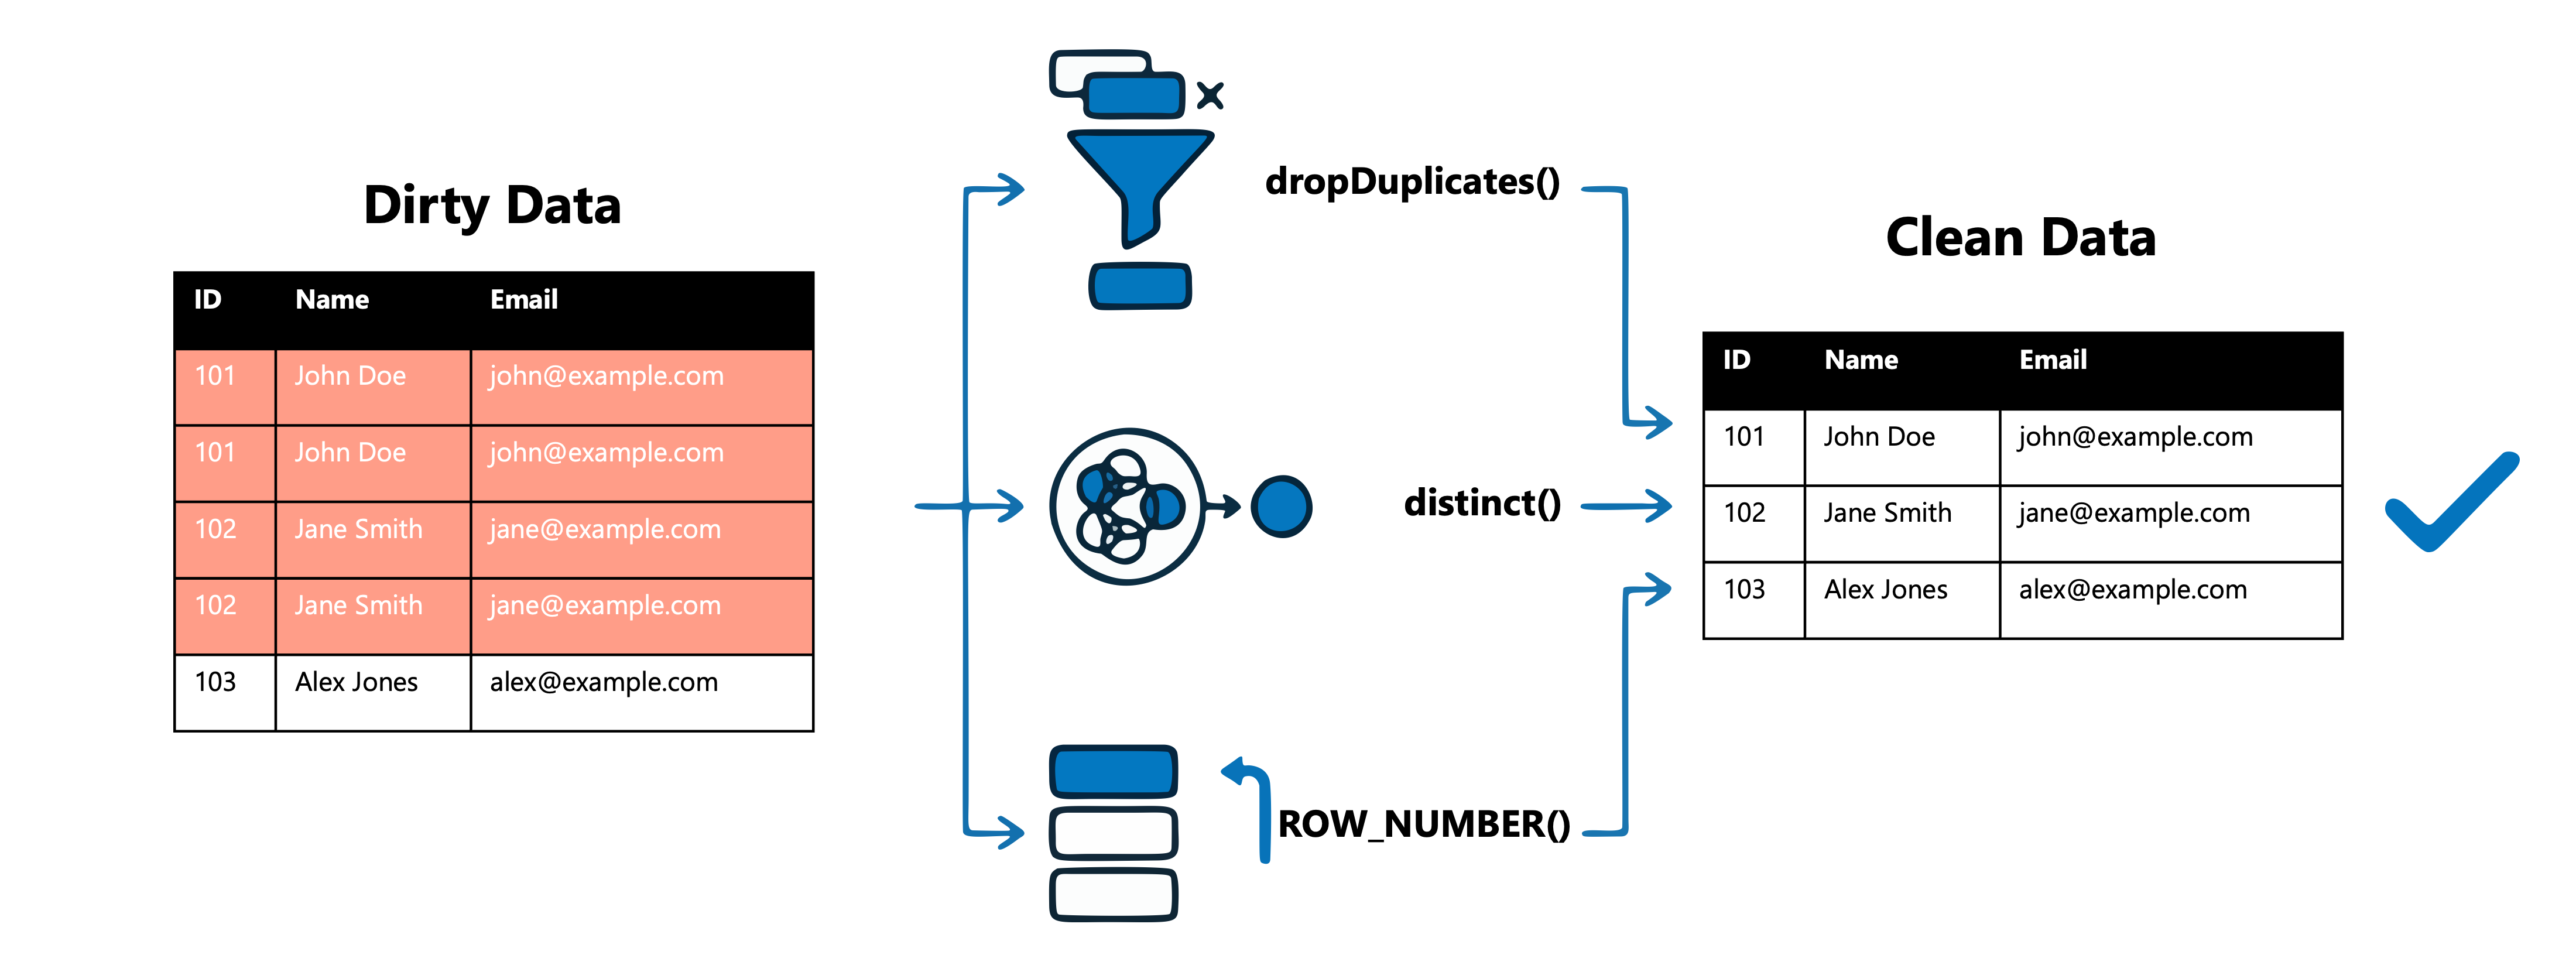
Eliminación de duplicados en PySpark
El dropDuplicates() método quita filas duplicadas basadas en columnas especificadas y mantiene una fila para cada combinación. Cuando las filas difieren en otras columnas, no se garantiza la fila que permanece:
df_clean = df.dropDuplicates(["customer_id", "email"])
Para la desduplicación de filas completa en todas las columnas, use distinct():
df_unique = df.distinct()
Conservar filas específicas utilizando ROW_NUMBER
Cuando necesite controlar qué duplicado mantener, use ROW_NUMBER() con QUALIFY para seleccionar registros en función de criterios como la actualización más reciente:
SELECT *
FROM sales.customers
QUALIFY ROW_NUMBER() OVER (
    PARTITION BY customer_id
    ORDER BY updated_at DESC
) = 1;
Esta consulta particiona los registros por customer_id, los ordena por updated_at en orden descendente y mantiene solo el registro más reciente para cada cliente.
Manejar valores nulos y faltantes
Los valores NULL representan datos desconocidos o que faltan. Según los requisitos de análisis, es posible que tenga que quitar filas con valores NULL, reemplazarlas por valores predeterminados o usar la imputación estadística.
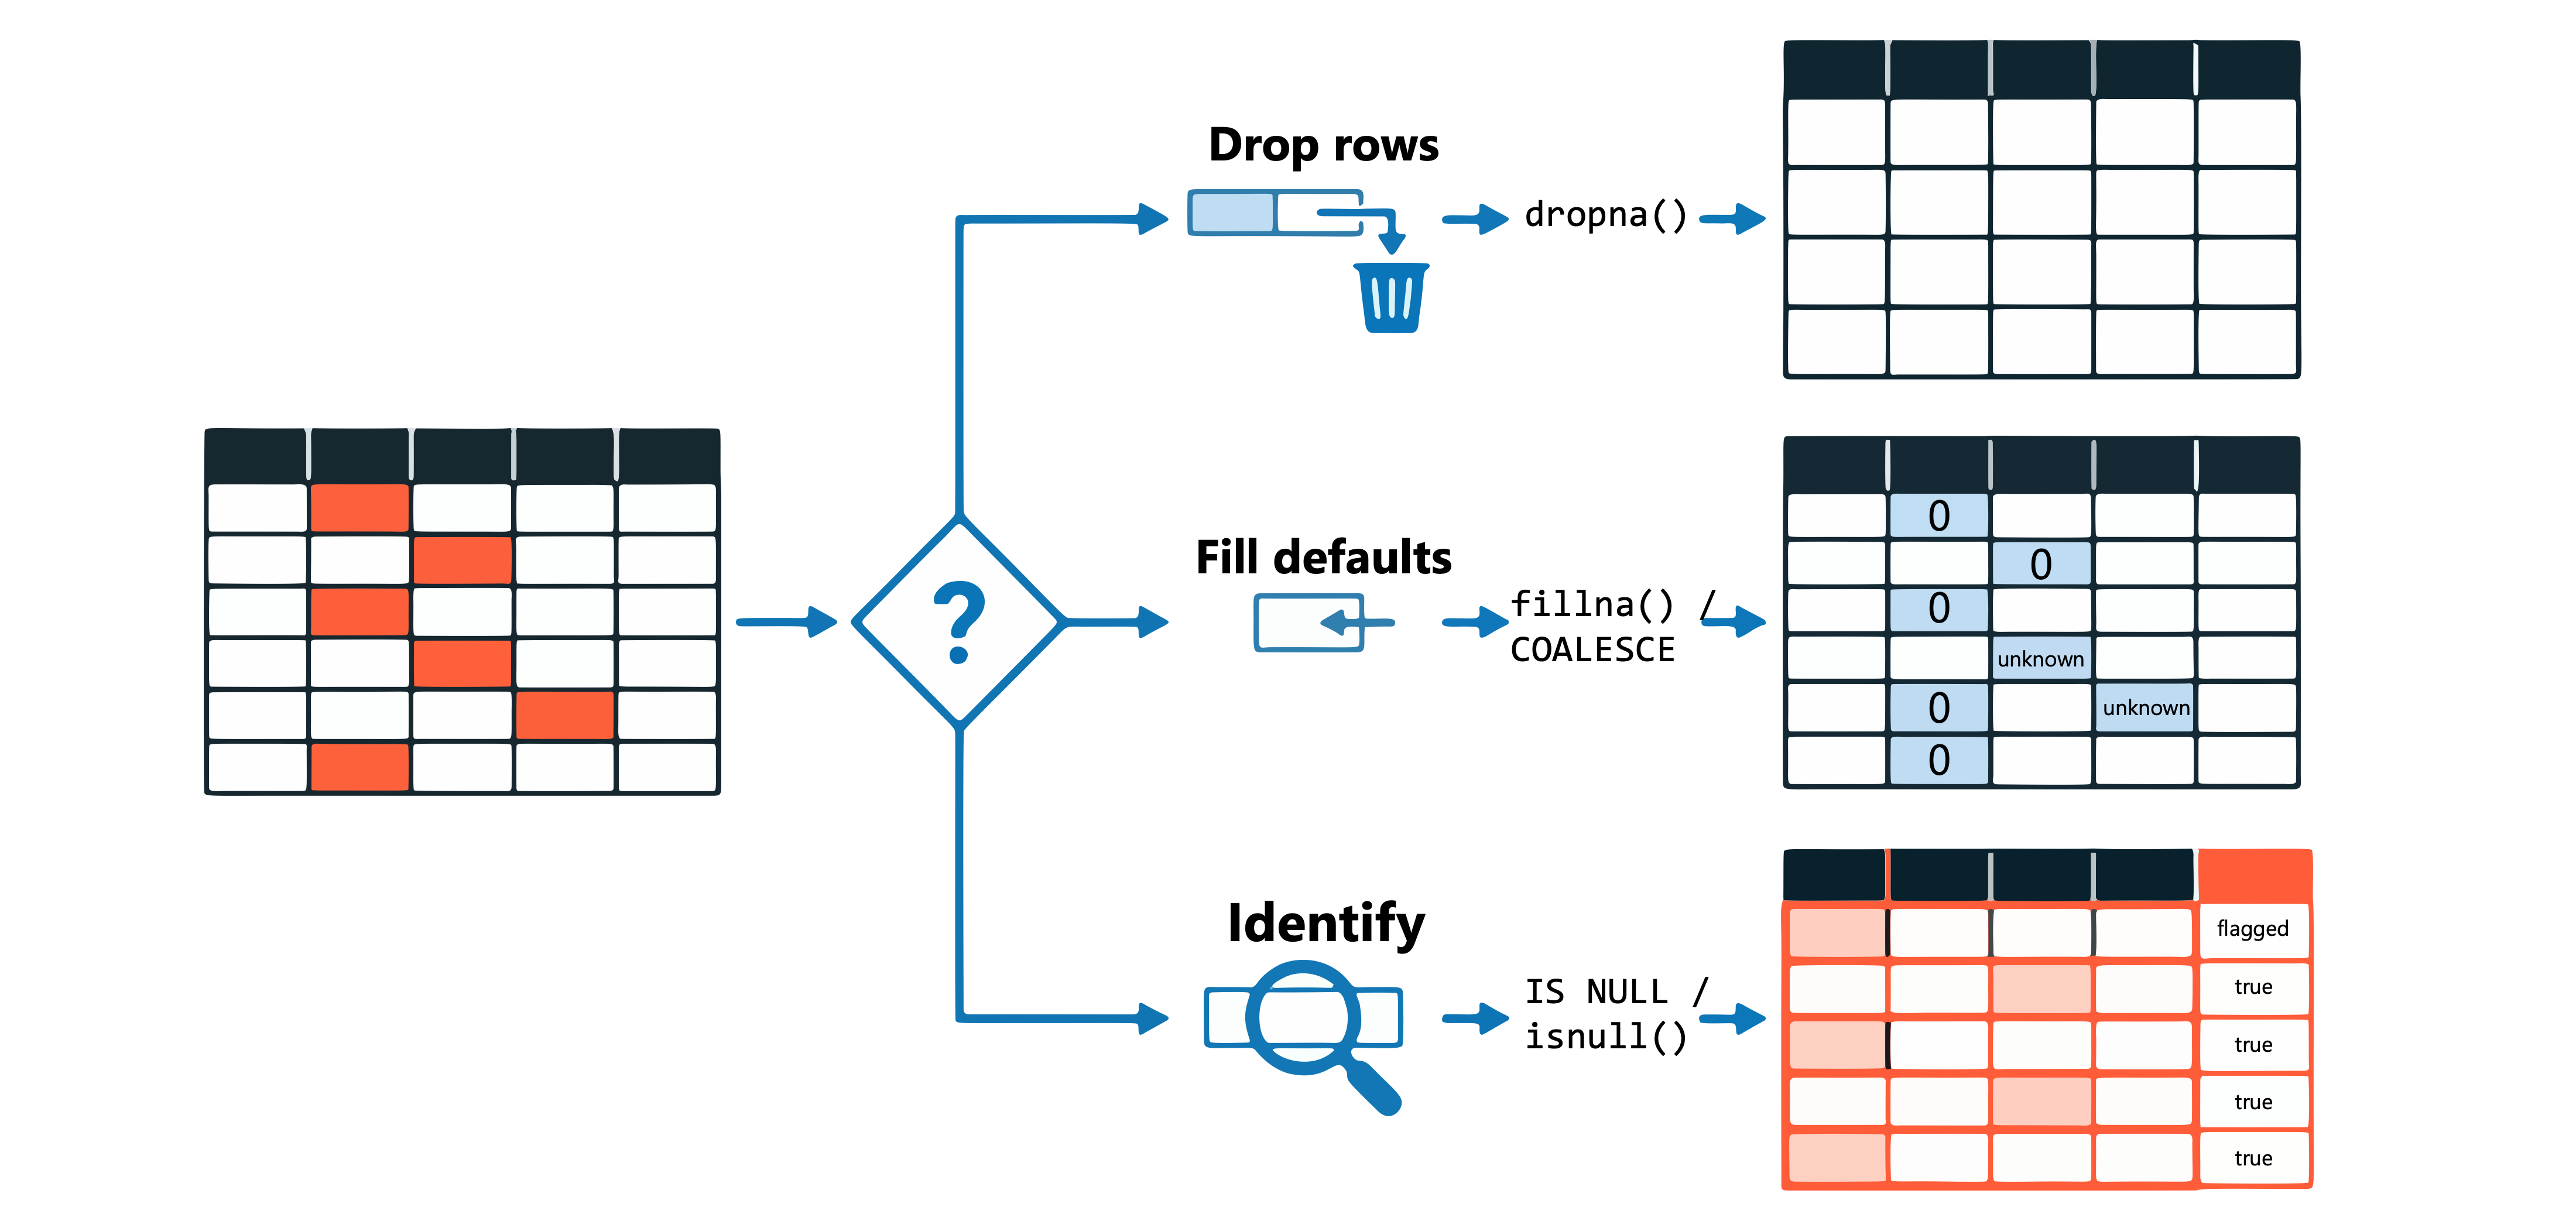
Identifica valores nulos
Use la función isnull() o el operador IS NULL para buscar registros con valores faltantes.
SELECT *
FROM sales.transactions
WHERE amount IS NULL
   OR customer_id IS NULL;
Para contar ocurrencias nulas por columna:
SELECT
    COUNT(*) AS total_rows,
    COUNT(*) - COUNT(amount) AS null_amount_count,
    COUNT(*) - COUNT(customer_id) AS null_customer_count
FROM sales.transactions;
Quitar filas con valores NULL
En PySpark, el dropna() método quita las filas que contienen valores NULL:
# Drop rows where any column is null
df_clean = df.dropna()

# Drop rows where all columns are null
df_clean = df.dropna(how="all")

# Drop rows where specific columns are null
df_clean = df.dropna(subset=["customer_id", "amount"])
El how parámetro controla el comportamiento: "any" quita filas con al menos un valor NULL (valor predeterminado), mientras que "all" quita las filas solo cuando todas las columnas especificadas son null.
Rellenar NULL con valores predeterminados
El fillna() método reemplaza los valores NULL por los valores predeterminados especificados:
# Fill null values with a single value (applies only to columns whose data type matches)
df_filled = df.fillna(0)

# Fill specific columns with different values
df_filled = df.fillna({
    "amount": 0,
    "status": "Unknown",
    "quantity": 1
})
En SQL, use la COALESCE función para proporcionar valores predeterminados:
SELECT
    customer_id,
    COALESCE(amount, 0) AS amount,
    COALESCE(status, 'Unknown') AS status
FROM sales.transactions;
Elección de la estrategia correcta
La estrategia de gestión de valores nulos adecuada depende del contexto de datos.
| Scenario | Enfoque recomendado |
|---|---|
| Valores NULL en campos obligatorios, como identificadores | Eliminar las filas |
| Nulos en campos numéricos para agregación | Rellenar con cero o promedio |
| Valores NULL en campos de categorías opcionales | Rellenar con un marcador de posición como "Desconocido" |
| Valores NULL que sesgarían el análisis | Quitar o rellenar en función del conocimiento del dominio |
Sugerencia
Documente sus decisiones de manejo de nulos. Los futuros analistas deben comprender por qué se reemplazaron o quitaron determinados valores para interpretar correctamente los resultados de la consulta.
Comprender cómo identificar y resolver estos problemas de calidad de datos le prepara para crear canalizaciones de datos más confiables. Con datos limpios, tus transformaciones posteriores y análisis generan resultados fiables.