Transformación de datos con uniones y operadores de conjunto
Los flujos de trabajo de ingeniería de datos suelen requerir la combinación de información de varios conjuntos de datos. Las combinaciones combinan tablas horizontalmente mediante la coincidencia de filas en columnas relacionadas, mientras que los operadores set combinan tablas verticalmente mediante la anexión, intersección o exclusión de filas. Comprender cuándo usar cada enfoque le ayuda a crear canalizaciones de transformación eficaces.
En esta unidad, aprenderá a combinar tablas en función de las relaciones y aplicar operadores de conjuntos para combinar conjuntos de datos con esquemas coincidentes.
Combinar tablas con uniones
Combina filas de dos tablas a partir de una columna relacionada. El tipo de combinación determina qué filas aparecen en el resultado y cómo se controlan las filas no coincidentes.
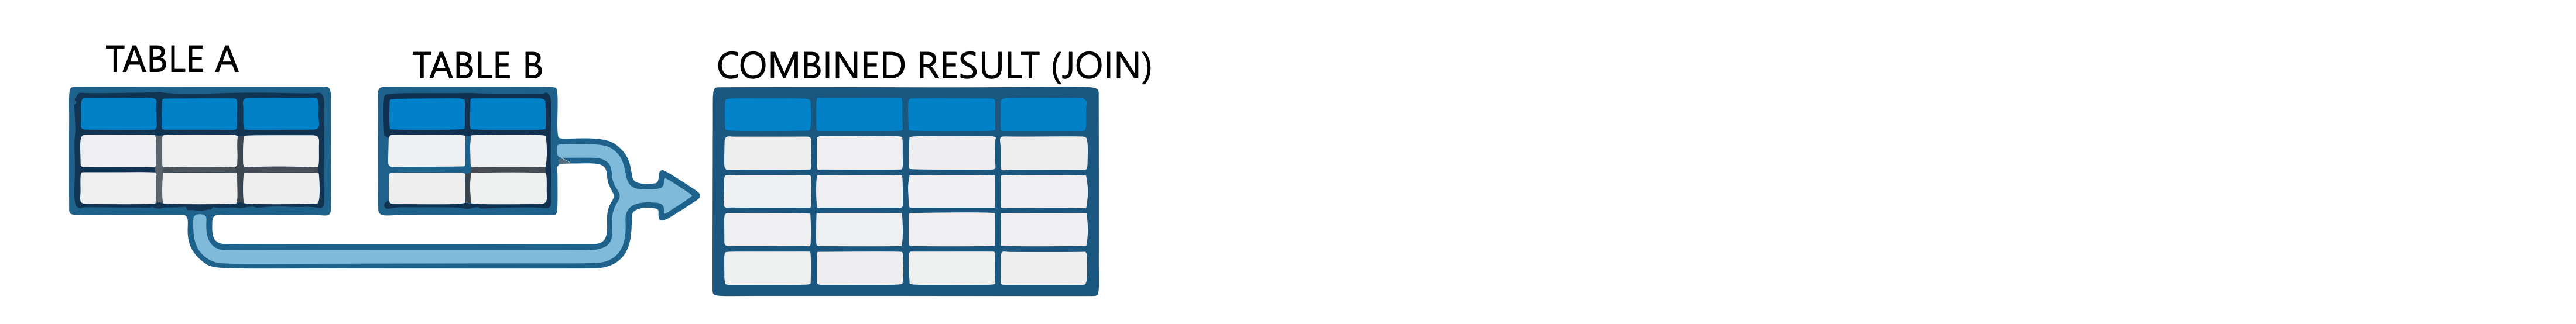
Descripción de los tipos de combinación
Cada tipo de combinación sirve para un propósito específico en la transformación de datos:

| Tipo de combinación | Description | Caso de uso |
|---|---|---|
INNER |
Devuelve solo filas coincidentes de ambas tablas. | Vinculación de pedidos con clientes válidos |
LEFT |
Devuelve todas las filas de la tabla izquierda; agrega valores NUL para la tabla correcta cuando no hay ninguna coincidencia | Incluir todos los clientes, incluso sin pedidos |
RIGHT |
Devuelve todas las filas de tabla correctas; agrega valores NUL para la tabla izquierda cuando no hay ninguna coincidencia | Incluir todos los departamentos, incluso sin empleados |
FULL |
Devuelve todas las filas de ambas tablas; agrega valores NUL para no coincidencias | Combinación de conjuntos de datos para buscar huecos en cualquiera de los lados |
SEMI |
Devuelve filas de tabla izquierda que tienen coincidencias en la tabla derecha. | Filtrar los clientes que han realizado pedidos |
ANTI |
Devuelve filas de tabla izquierda que no tienen ninguna coincidencia en la tabla derecha. | Buscar clientes que nunca hayan realizado pedidos |
CROSS |
Devuelve el producto cartesiano de todas las filas. | Generar todas las combinaciones posibles |
Combinación de tablas con SQL
La JOIN cláusula combina tablas basadas en una condición especificada con ON o USING. En los ejemplos siguientes se usan tablas de empleados y departamentos:
CREATE TEMP VIEW employee(id, name, deptno) AS
    VALUES (105, 'Chloe', 5),
           (103, 'Paul',  3),
           (101, 'John',  1),
           (102, 'Lisa',  2),
           (104, 'Evan',  4),
           (106, 'Amy',   6);

CREATE TEMP VIEW department(deptno, deptname) AS
    VALUES (3, 'Engineering'),
           (2, 'Sales'),
           (1, 'Marketing');
Para asociar los empleados con sus departamentos, use una unión interna:
-- Inner join: only employees with matching departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
INNER JOIN department d ON e.deptno = d.deptno;
Una combinación interna devuelve solo tres filas: empleados cuyos números de departamento existen en la tabla de departamento. Los empleados de los departamentos 4, 5 y 6 no aparecen porque esos departamentos no están en la tabla de departamentos.
Cuando necesite incluir todos los empleados independientemente de las coincidencias de departamento, use una unión izquierda:
-- Left join: all employees, NULL for missing departments
SELECT e.id, e.name, e.deptno, d.deptname
FROM employee e
LEFT JOIN department d ON e.deptno = d.deptno;
Esto devuelve los seis empleados. Aquellos sin departamentos coincidentes muestran NULL en la columna deptname.
Combinar tramas de datos con PySpark
El método de join() PySpark proporciona la misma funcionalidad. El how parámetro especifica el tipo de combinación:
df_employee = spark.table("employee")
df_department = spark.table("department")

# Inner join
df_inner = df_employee.join(
    df_department,
    on=df_employee.deptno == df_department.deptno,
    how="inner"
)
display(df_inner)
Para las combinaciones externas izquierda, derecha o completa, cambie el parámetro how:
# Left join: keep all employees
df_left = df_employee.join(
    df_department,
    on="deptno",
    how="left"
)

# Full outer join: keep all rows from both tables
df_full = df_employee.join(
    df_department,
    on="deptno",
    how="full"
)
Cuando la columna de combinación tiene el mismo nombre en ambos DataFrames, pase el nombre de columna como una cadena. Este enfoque evita columnas duplicadas en el resultado.
Filtrar datos con uniones semijoin y antijoin
Los joins semi y anti filtran los datos en función de la existencia en otra tabla. Una combinación semi devuelve filas de la tabla izquierda que tienen coincidencias, sin incluir columnas de la tabla derecha:
-- Find employees who belong to listed departments
SELECT *
FROM employee
LEFT SEMI JOIN department ON employee.deptno = department.deptno;
Una combinación anti devuelve lo opuesto: filas que no tienen coincidencias.
-- Find employees in departments not listed
SELECT *
FROM employee
LEFT ANTI JOIN department ON employee.deptno = department.deptno;
En PySpark, use how="semi" o how="anti":
# Employees with matching departments
df_semi = df_employee.join(df_department, on="deptno", how="semi")

# Employees without matching departments
df_anti = df_employee.join(df_department, on="deptno", how="anti")
Combinar filas con operadores de conjunto
Los operadores de conjunto funcionan verticalmente, combinando filas de consultas con la misma estructura de columnas. A diferencia de las combinaciones, los operadores de conjuntos no coinciden con las condiciones: apilan o comparan conjuntos de resultados completos.
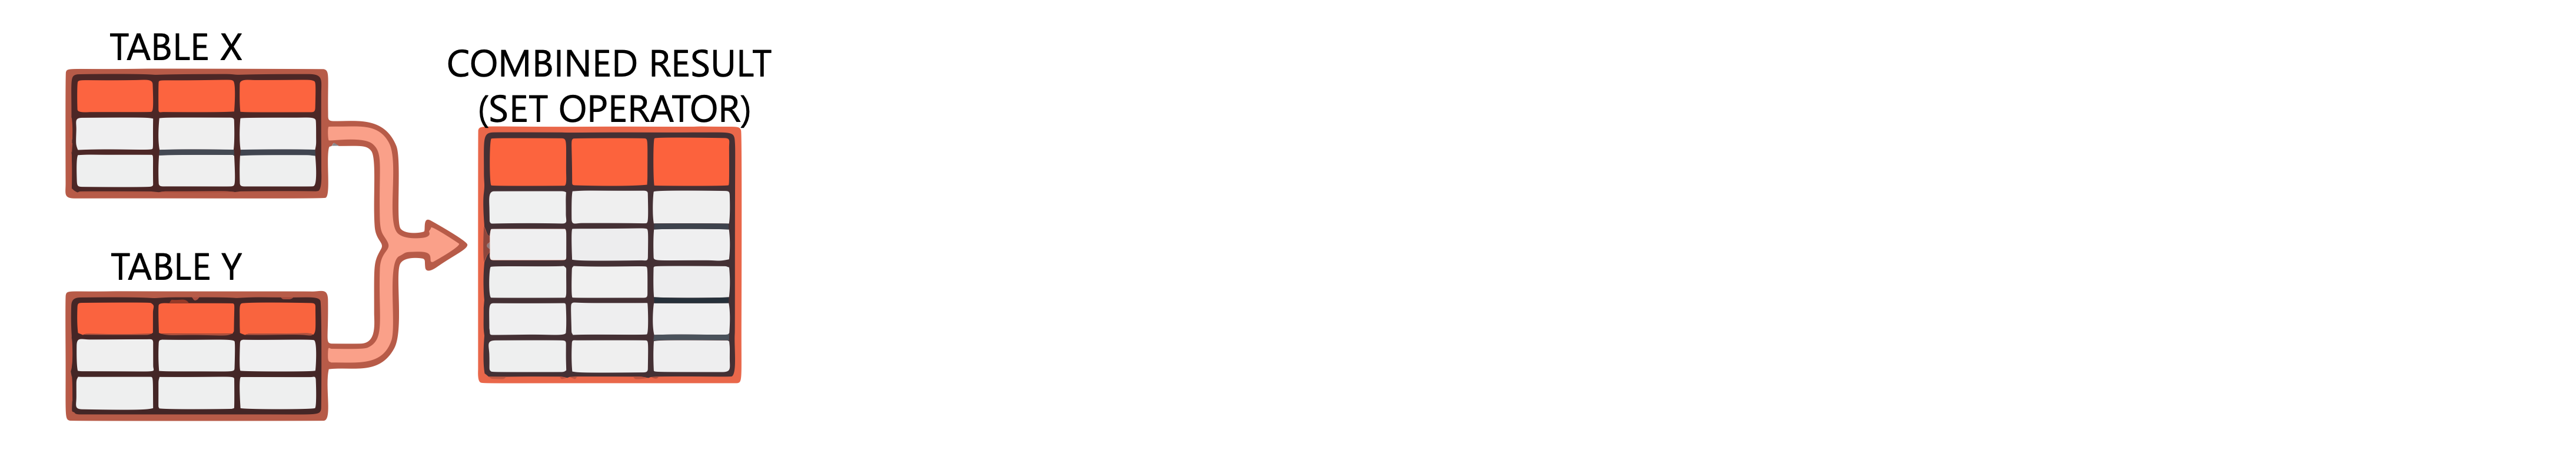
Descripción de los operadores de conjunto
Azure Databricks admite tres operadores de conjunto:
| Operator | Description | Comportamiento |
|---|---|---|
UNION |
Combina filas de ambas consultas | Quita duplicados de forma predeterminada; usar ALL para mantenerlos |
INTERSECT |
Devuelve filas que existen en ambas consultas. | Solo aparecen filas coincidentes |
EXCEPT |
Devuelve las filas de la primera consulta que no están en la segunda. | Quita duplicados de forma predeterminada |
Ambas consultas deben tener el mismo número de columnas con tipos de datos compatibles.
Combinar conjuntos de datos con UNION
UNION anexa filas de una consulta a otra. De forma predeterminada, quita duplicados:
-- Combine active and archived customers (no duplicates)
SELECT customer_id, name, email FROM active_customers
UNION
SELECT customer_id, name, email FROM archived_customers;
Para conservar todas las filas, incluidos los duplicados, use UNION ALL:
-- Combine all rows, keeping duplicates
SELECT customer_id, name, email FROM active_customers
UNION ALL
SELECT customer_id, name, email FROM archived_customers;
Use UNION ALL cuando sepa que no hay duplicados o cuando los duplicados son significativos. Funciona mejor porque omite el paso de desduplicación.
En PySpark, use union() para combinar DataFrames. Tenga en cuenta que pySpark union() se comporta como UNION ALL, mantiene duplicados:
df_active = spark.table("active_customers")
df_archived = spark.table("archived_customers")

# Combine both tables (keeps duplicates)
df_combined = df_active.union(df_archived)

# Remove duplicates if needed
df_distinct = df_active.union(df_archived).distinct()
Encontrar filas comunes con INTERSECT
INTERSECT devuelve solo las filas que aparecen en ambas consultas. Esto ayuda a identificar los datos superpuestos:
-- Find customers in both active and archived tables
SELECT customer_id FROM active_customers
INTERSECT
SELECT customer_id FROM archived_customers;
Esta consulta identifica a los clientes que de alguna manera aparecen en ambas tablas, lo que resulta útil para las comprobaciones de calidad de los datos o para identificar los registros que necesitan conciliación.
Excluir filas con EXCEPT
EXCEPT devuelve filas de la primera consulta que no existe en la segunda. Esto ayuda a identificar brechas o registros únicos:
-- Find active customers not in the archived table
SELECT customer_id FROM active_customers
EXCEPT
SELECT customer_id FROM archived_customers;
También puede usar MINUS como sinónimo de EXCEPT:
-- Same result using MINUS syntax
SELECT customer_id FROM active_customers
MINUS
SELECT customer_id FROM archived_customers;
Al igual que UNION, tanto INTERSECT como EXCEPT quitan duplicados de forma predeterminada. Agregue ALL para conservar duplicados cuando sea necesario.
Sugerencia
Al encadenar operaciones de conjunto, recuerde que INTERSECT tiene mayor prioridad que UNION y EXCEPT. Use paréntesis para controlar el orden de evaluación.
Elegir entre combinaciones y operadores de conjuntos
La elección entre combinaciones y operadores de conjunto depende del objetivo de transformación. Las combinaciones combinan columnas de tablas relacionadas horizontalmente, mientras que los operadores set combinan filas verticalmente.
Usaremos combinaciones cuando necesite:
- Enriquecimiento de registros mediante la adición de columnas de tablas relacionadas
- Coincidir registros basados en relaciones clave
- Filtrar los datos en función de la existencia en otra tabla (combinaciones semi/anti)
Use operadores de conjuntos cuando necesite:
- Anexar registros de varios orígenes con esquemas idénticos
- Búsqueda de registros comunes entre conjuntos de datos
- Identificación de registros únicos para un conjunto de datos
Ambos enfoques forman la base de canalizaciones de transformación de datos eficaces. En la unidad siguiente, explorará cómo cargar datos transformados en tablas de destino en el Catálogo de Unity.