Herramientas de infraestructura como código
- 15 minutos
El propósito de un sistema de administración de configuración (CM) en cualquier sector, incluida la tecnología de la información, es mantener y conservar los procesos para compilar, diseñar y ensamblar un producto creado de forma óptima. Hay dos métodos principales:
- El método imperativo
- El método declarativo
El método imperativo
El método imperativo, que registra la secuencia exacta de instrucciones necesarias para aprovisionar y mantener un recurso (por ejemplo, una máquina virtual, un contenedor de aplicaciones, un repositorio de almacenamiento o un perfil de usuario) según las especificaciones escritas. En este caso, el estado final de la infraestructura es el resultado de la ejecución de estas instrucciones de forma secuencial.
El método declarativo
El método declarativo, en el que el estado final de la infraestructura se define directamente, y el sistema que mantiene esa infraestructura debe ensamblar un plan o itinerario de operaciones cuyo resultado final sea el estado declarado.
La elección de las empresas de una plataforma de CM y una metodología de infraestructura como código, implica lo que consideran más importante de conservar y ampliar: sus métodos o sus objetivos. Ambos enfoques ofrecen ventajas y desventajas. En esta lección se examina la postura básica y las metodologías admitidas por las principales plataformas de CM y se proporcionan introducciones breves a las propias plataformas.
Plantillas de Azure Resource Manager
El sistema de plantillas de Azure Resource Manager de Microsoft es una herramienta para generar una especificación explícita para uno o más recursos en la nube. Una plantilla de Azure Resource Manager está diseñada para ser un inventario completo de los valores y parámetros necesarios para ejecutar instrucciones de Azure a fin de aprovisionar recursos nuevos y actualizar los existentes. Este inventario se expresa en JSON, un formato que se ha vuelto casi omnipresente en el desarrollo de software. Las plantillas de Azure Resource Manager son exclusivas de Azure y no pueden especificar recursos para una infraestructura multinube.
Las plantillas de Azure Resource Manager se pueden generar manualmente, pero con más frecuencia se generan (y editan) a través de Azure Portal o mediante herramientas como Visual Studio y Visual Studio Code. En la figura 4 se muestra una plantilla para aprovisionar una cuenta de almacenamiento de Azure. La plantilla incluye las secciones siguientes:
Una sección de parámetros en la que se definen valores de parámetro como el nombre de la cuenta de almacenamiento que el usuario va a especificar cuando se ejecute la plantilla, así como los valores predeterminados opcionales y los valores permitidos.
Una sección de recursos en la que se definen los recursos de Azure que la plantilla va a crear o actualizar.
Una plantilla de Azure Resource Manager también puede incluir otras secciones, como una sección de funciones para definir funciones reutilizables ejecutadas por la plantilla (por ejemplo, una función que genere un nombre de cuenta único mediante expresiones de programación integradas admitidas por Azure Resource Manager), una sección de variables para definir las variables que se usan en la plantilla, y una sección de salidas en la que se define el valor o los valores devueltos cuando se ejecuta la plantilla. Las plantillas suelen tener cientos o incluso miles de líneas de longitud. La plantilla de la figura 4 es sencilla, pero muestra algunas de las características más importantes de las plantillas de Azure Resource Manager, incluida la capacidad de definir los parámetros que debe proporcionar un usuario, así como las restricciones de las entradas, la capacidad de definir los recursos que componen una solución y la de usar la entrada proporcionada por el usuario para especificar atributos para los recursos que se crean o actualizan.
{
    "$schema": "https://schema.management.azure.com/schemas/2015-01-01/deploymentTemplate.json#",
    "contentVersion": "1.0.0.0",
    "parameters": {
        "storageAccountType": {
            "type": "string",
            "defaultValue": "Standard_LRS",
            "allowedValues": [
                "Standard_LRS",
                "Standard_GRS"
            ],
            "metadata": {
                "description": "Storage Account type"
            }
        },
        "storageAccountName": {
            "type": "string"
        }
    },
    "resources": [
        {
            "type": "Microsoft.Storage/storageAccounts",
            "name": "[parameters('storageAccountName')]",
            "location": "[resourceGroup().location]",
            "apiVersion": "2018-07-01",
            "sku": {
                "name": "[parameters('storageAccountType')]"
            },
            "kind": "StorageV2"
        }
    ]
}
Figura 4: Plantilla sencilla de Azure Resource Manager para aprovisionar una cuenta de Azure Storage.
Las plantillas de Azure Resource Manager se pueden ejecutar con comandos de PowerShell o la CLI, mediante aplicaciones escritas en C# y otros lenguajes de programación, o bien desde Azure Portal. En la figura 5 se muestra cómo aparece la plantilla de la figura 4 en el portal. El portal proporciona la interfaz de usuario para crear un grupo de recursos o seleccionar uno existente, y genera una interfaz para las entradas definidas en la sección de parámetros de la plantilla; en este caso, el nombre y el tipo de la cuenta de almacenamiento, que se selecciona en una lista desplegable que se genera a partir de la enumeración allowedValues en la plantilla en lugar de escribirse de forma libre.
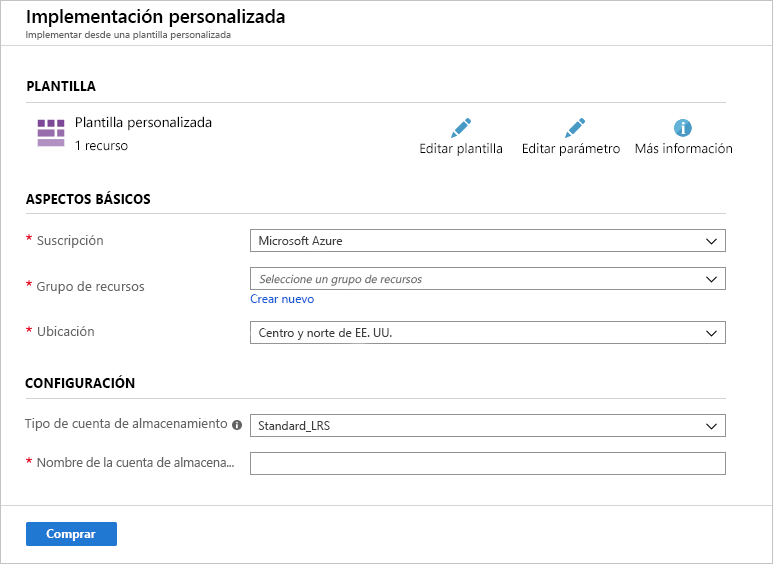
Figura 5: Plantilla de Azure Resource Manager representada en Azure Portal.
La creación de una cuenta de almacenamiento mediante Azure Portal normalmente requiere muchas entradas. La plantilla las reduce solo a las necesarias para una implementación determinada. Imagine una plantilla más compleja que implemente docenas de recursos relacionados que requieren cientos de parámetros, pero que reduce todo el proceso a tres de los cuatro parámetros especificados por el usuario y un sencillo clic de botón. Además, una plantilla de Azure Resource Manager es idempotente, lo que significa que se puede ejecutar tantas veces como se quiera y el resultado será siempre el mismo. Aprovisionará recursos nuevos y actualizará los existentes.
Una plantilla de Azure Resource Manager proporciona una definición completa, inequívoca e idempotente de un recurso, o un conjunto de recursos, que se puede usar para automatizar implementaciones y actualizaciones. Las plantillas de Azure Resource Manager son un ejemplo de infraestructura como código que usa un enfoque declarativo para definir la infraestructura de la nube.
Puppet
El concepto de infraestructura como código se diseñó originalmente para aplicarse a las plataformas en la nube en general, incluidas las nubes públicas, así como las plataformas de nube híbrida como VMware vCloud y OpenStack. Las plantillas de Azure Resource Manager son específicas de Azure, pero Puppet es una plataforma de CM completa que funciona entre plataformas en la nube. Puppet es la versión moderna de los experimentos de 2006 de Luke Kanies con la extensión de una capa de abstracción sobre entornos operativos de varios servidores. Su motor es un administrador de configuración cuyos trabajos principales son los siguientes:
- Tomar una entrada de una especificación del estado óptimo y deseado de un sistema para la entrega de una aplicación o servicio.
- Determinar la secuencia de pasos necesarios para aprovisionar un sistema que se encuentre en ese estado o uno similar.
- Ejecutar los pasos necesarios para lograr este estado.
En resumen, lo que un script de otro administrador de configuración buscaría para definir y preservar con el fin de automatizar, Puppet lo crea como resultado de sus cálculos.
Puppet administra la configuración de los recursos y servicios mediante un clúster de servidores a través de un nodo de controlador central denominado maestro del que se realiza una copia de seguridad mediante replicaciones. Como su nombre implica, la plataforma Puppet establece una relación maestro y agente entre los nodos centrales y un número variable de nodos de cliente en los que se instalan los agentes de Puppet.
En lugar de usar JSON como las plantillas de Azure Resource Manager, Puppet usa instrucciones inspiradas en el lenguaje de programación Ruby en el que se escribió originalmente. Un conjunto de instrucciones para Puppet que represente una tarea de administración de infraestructura (por ejemplo, el aprovisionamiento de un servidor con Linux, MySQL y otros componentes de una pila LAMP) se representa mediante un módulo, que en realidad es un directorio que contiene varios archivos en una estructura concreta. Lo más importante de estos archivos es el manifiesto, que está escrito en un lenguaje específico de dominio (DSL) único para Puppet. Este DSL no es técnicamente un lenguaje de programación porque no indica los pasos que debe llevar a cabo un intérprete o procesador para realizar una tarea.
Como se muestra en la figura 6, la arquitectura de un sistema que ejecuta la plataforma Puppet es sorprendentemente poco sofisticada. En Puppet, un nodo, como los de Kubernetes o OpenStack, es un servidor (físico o virtual) pero que participa en la plataforma colectiva. Hay nodos maestros y nodos de agente. Los servidores que el maestro administra tienen agentes activos instalados. La comunicación se realiza a través de canales SSH. Normalmente, estos canales se protegen a través de una subred local sin acceso a Internet. Los módulos para las instrucciones de Puppet se pueden almacenar en un repositorio, y recuperarse de este, aunque no es necesario que la conexión sea privada y el propio Puppet no reconoce el repositorio como un agente o un nodo.
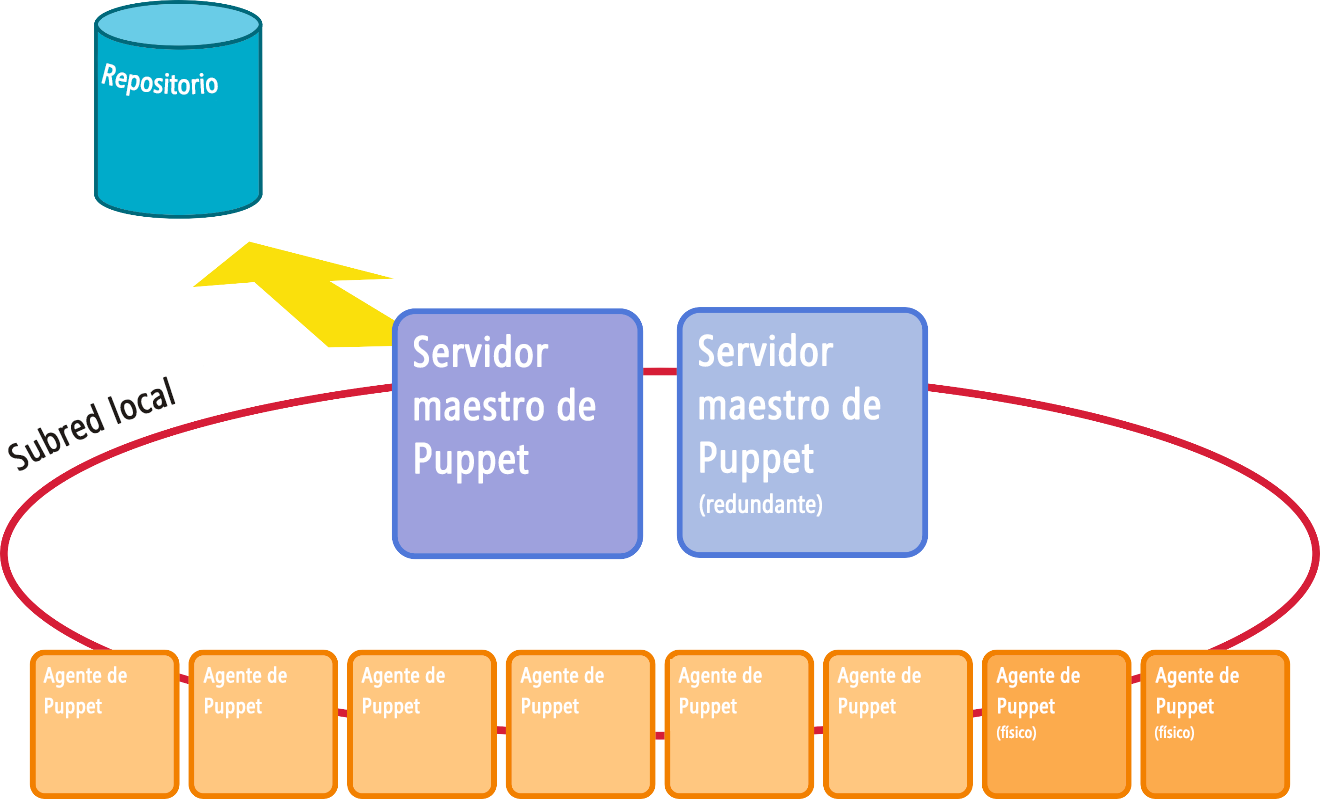
Figura 6: Arquitectura de implementación estándar de Puppet.
Chef
Chef se basa en agentes capaces de analizar un sistema en tiempo real e informar de su configuración y estado. La arquitectura de implementación básica es sencilla (Figura 7). El servidor está diseñado para funcionar de forma remota desde una estación de trabajo. Todos los nodos, incluido el servidor, se cargan con Chef, aunque la funcionalidad se distribuye entre ellos. Los nodos cliente reciben instrucciones generadas por script del servidor por medio de la estación de trabajo del administrador.
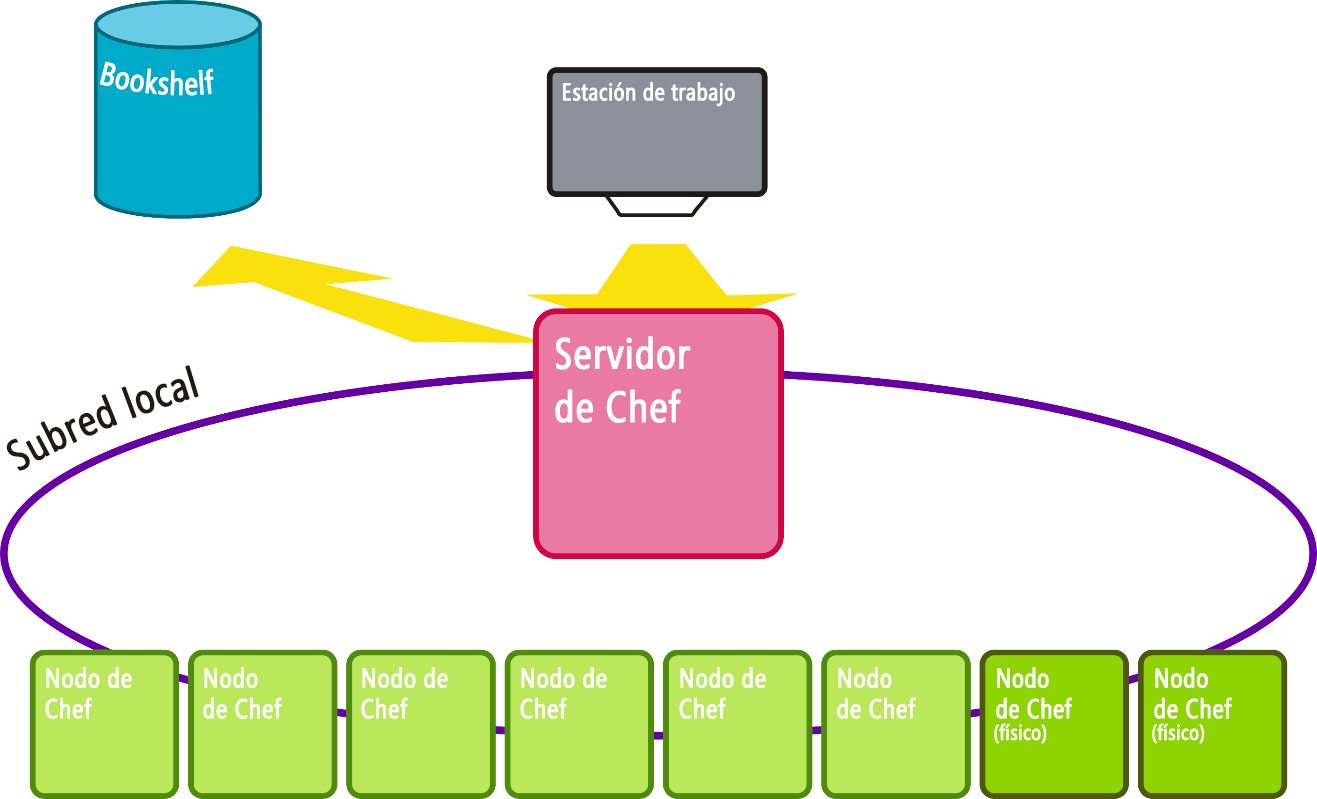
Figura 7: Arquitectura de implementación estándar de Chef.
Muchas metáforas de Chef se basan en la cocina. Un script de Chef se denomina receta. Sus instrucciones están escritas en Ruby en lugar de en un DSL basado en Ruby, por lo que los desarrolladores familiarizados con Ruby se sienten cómodos con ellos. Todas las recetas se incluyen en una guía paso a paso, que sirve como medio de entrega de Chef. Para administrar la configuración de una clase de tareas, un operador escribe una guía paso a paso o la adquiere de un repositorio público. El intérprete del lado cliente para estas instrucciones es un agente denominado Knife (cuchillo) instalado en cada nodo de servidor. Knife recibe instrucciones sobre SSH mediante una CLI.
A diferencia de Puppet, una receta de Chef es un programa que se prueba, se refina y se conserva. Pero el modo en que se escribe es algo más abstracto que cualquiera de los scripts dependientes del sistema que se han mencionado antes. El uso que hace de Ruby es más simbólico, y Knife es capaz de traducir instrucciones abstractas en detalles concretos. Estas instrucciones no son declaraciones como en Puppet, ni instrucciones de objetivos o estados deseados, sino comandos un tanto imperativos. Por ejemplo, cada uno de los nodos de servidor de un centro de datos puede tener instaladas diferentes distribuciones de Linux. Una receta puede indicar a Knife que determine la versión de Linux que está instalada en un nodo y, en una cláusula condicional, indicar qué edición de un paquete es la más adecuada para esa versión. También puede realizar ajustes en el archivo de configuración local de ese paquete.
Las instrucciones de Chef a Knife son explícitas. Chef se centra en la definición y el refinamiento posterior de los métodos por los que se alcanza y mantiene una versión operativa de una solución. El perfeccionamiento continuo sigue siendo posible; no es necesario grabar en piedra las secuencias de instrucciones, como suele ser habitual con los scripts independientes. Pero al menos hay una metodología para guiar el camino. Puede ser deliberada sin interrumpir los procesos existentes, especialmente si esos procesos, o para ser más concretos, sus recetas, se crean para ser resistentes y para comprobar si determinadas condiciones han cambiado antes de confirmar las modificaciones importantes de las configuraciones. Dicho esto, Chef ha sufrido actualizaciones evolutivas a lo largo de los años que han exigido cambios estructurales en sus propias recetas.
Red Hat Ansible
Ansible es una herramienta de CM que comparte algunos rasgos con Puppet, aunque también se suscribe al concepto de una lista de inventario completa, como las plantillas de Azure Resource Manager. Su objetivo es generar un único script que instala, configura y mantiene un servicio o aplicación determinados en cualquier infraestructura de servidor. Se basa en el concepto de inserción de la configuración. A diferencia de la situación con Puppet y Chef, donde los agentes del lado cliente realizan solicitudes de configuraciones actualizadas desde un servidor central, no hay agentes remotos en el sistema de Ansible.
Las tareas de configuración de cada nodo (no los "clientes", porque no hay ninguna relación directa entre ellos y el servidor) se basan en cuadernos de estrategias comunes. En realidad, un cuaderno de estrategias es una base de datos, no un script informativo, que contiene las condiciones que se deben cumplir para que una configuración se complete ---, por ejemplo, para que se instalen los componentes de una pila LAMP. El servidor de Ansible adapta este cuaderno de estrategias para las peculiaridades y excentricidades de cada nodo, y usa su base de datos de inventario de infraestructura como guía.
Tanto el cuaderno de estrategias como el inventario se escriben en YAML, un lenguaje creado originalmente como una alternativa a JSON para la codificación de datos. En la figura 8 se muestra un segmento de un cuaderno de estrategias de un repositorio de Ansible de código abierto1 que configura usuarios para MySQL una vez que se ha instalado su paquete. No hay sintaxis para instrucciones, solo claves y valores. Como estos valores representan estados de transición, en este caso, para cada usuario de MySQL, el servidor de Ansible encuentra el mejor método para aplicar estos cambios a la lista del sistema que va a configurar. Como algunos defensores de Ansible han afirmado, esto se puede considerar un tipo de configuración de estado deseado, siempre y cuando ese estado sea algo que se pueda expresar de forma explícita con YAML.
- name : Ensure mysql started
  become: yes
  service: name=mysql state=started enabled=yes

- name: Update MySQL root password for all root accounts
  mysql_user: name=root
              host={{ item }}
              password={{ mysql_root_password }}
              login_user=root
              login_password=""
              state=present
  with_items:
    - 127.0.0.1
    - ::1
    - localhost
Figura 8: Script de Ansible de ejemplo escrito en YAML.
Resumen
La administración de configuración simplifica el trabajo de la administración de los recursos de nube de la misma forma que una cosechadora simplifica el trabajo de recolectar el grano del campo. Una plataforma de CM eleva el rol de administración del servidor de tarea a profesión. Siempre es consciente de la visión general y busca maneras de integrar nuevas configuraciones en los sistemas existentes en lugar de reaccionar al impacto que causan.
En esta lección, se han analizado las principales plataformas de administración de configuración y se ha proporcionado el contexto del término infraestructura como código. Pero incluso las plataformas de CM no proporcionan toda la funcionalidad que los administradores necesitan para administrar soluciones en la nube de forma eficaz. El siguiente paso son las plataformas de orquestación, siendo Terraform una de las más populares y que, intencionadamente, es el tema de la lección siguiente.
Referencias
- Cuaderno de estrategias de la pila LAMP de Ansible en GitHub. https://github.com/jasodeep/ansible-lamp-stack-playbook.
Comprobación de conocimientos
Comentarios
¿Le ha resultado útil esta página?
No
¿Necesita ayuda con este tema?
¿Desea intentar usar Ask Learn para aclarar o guiarle a través de este tema?