Elección de un formato de tabla de datos
Los ingenieros de datos se enfrentan a una decisión crítica al principio de cada canalización de datos: ¿qué formato de tabla debe almacenar los datos? Esta opción afecta al rendimiento de las consultas, la confiabilidad de las transacciones, la interoperabilidad con otras plataformas y el mantenimiento a largo plazo de la arquitectura de lakehouse.
Azure Databricks admite varios formatos de almacenamiento, cada uno diseñado para diferentes escenarios. Comprender sus diferencias le ayuda a seleccionar el formato adecuado para sus requisitos específicos.
Descripción de los formatos de archivo frente a los formatos de tabla
Antes de comparar las opciones, es importante distinguir entre formatos de archivo y formatos de tabla. Un formato de archivo como Parquet, CSV o JSON define cómo se almacenan físicamente los datos en el disco. Un formato de tabla como Delta Lake o Apache Iceberg se basa en formatos de archivo agregando una capa de metadatos que realiza un seguimiento de las transacciones, los cambios de esquema y las ubicaciones de archivos de datos.
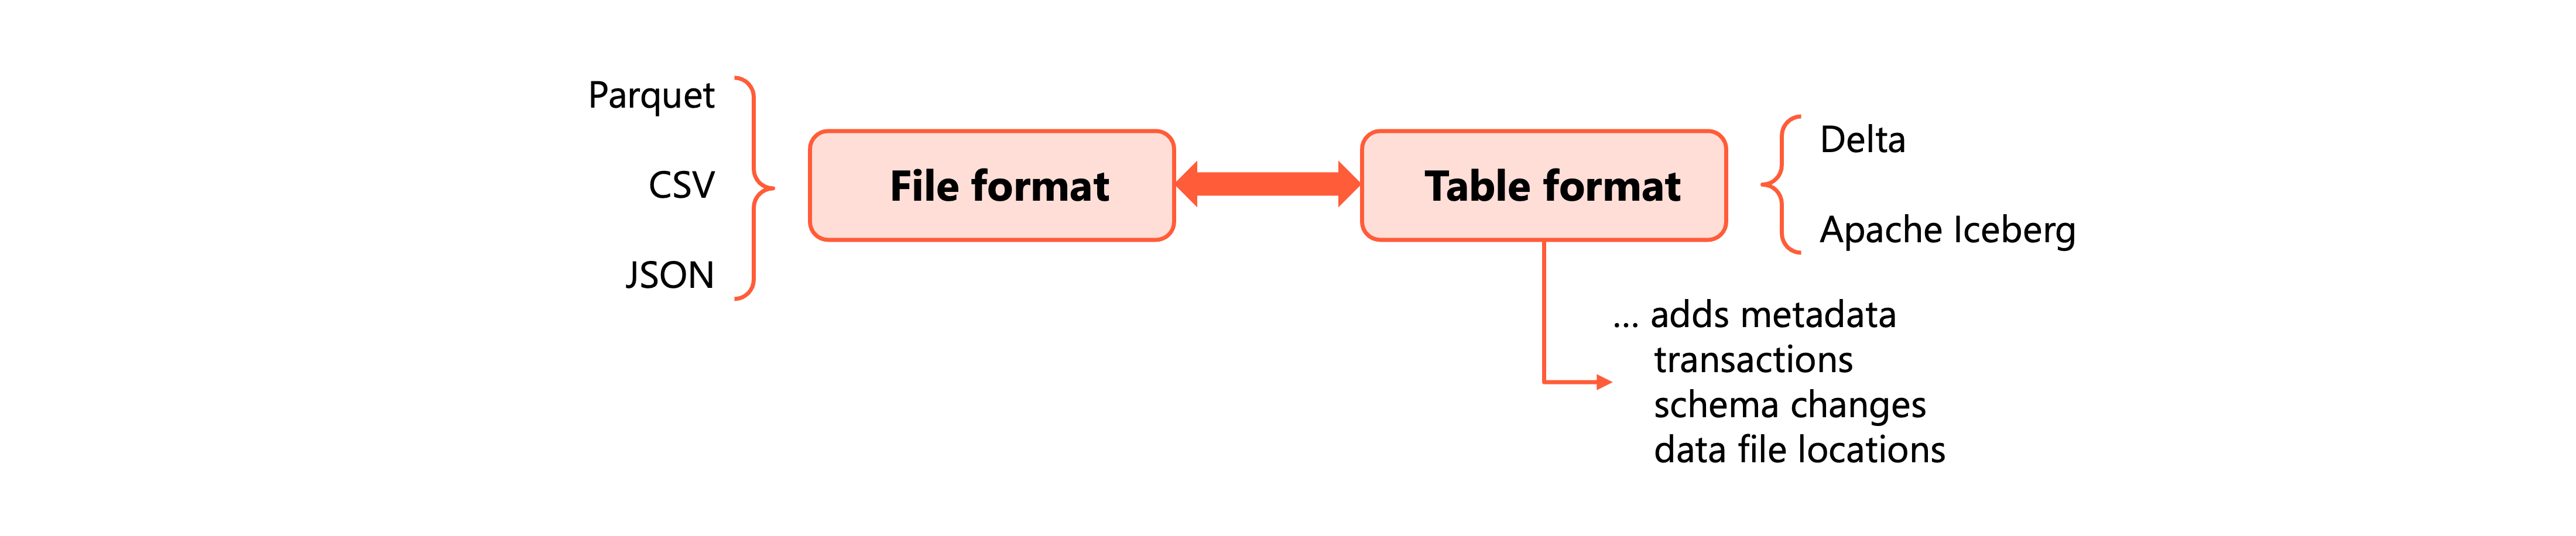
Delta Lake y Apache Iceberg utilizan Parquet como formato de archivo subyacente. La diferencia clave radica en la capa de metadatos que permite características avanzadas como transacciones ACID, viajes en tiempo y evolución del esquema.
Cómo Parquet almacena los datos de forma diferente
Parquet usa almacenamiento en columnas en lugar de almacenamiento basado en filas. Esta diferencia fundamental afecta significativamente al rendimiento de las consultas analíticas.
En formatos basados en filas como CSV, los datos se organizan por registro. La lectura de una sola columna requiere examinar todas las filas del archivo. En formatos de columnas como Parquet, los datos de cada columna se almacenan juntos. Cuando una consulta solo necesita columnas específicas, Parquet lee solo esas columnas y omite el resto por completo.
Parquet organiza los datos en grupos de filas, cada uno de los cuales contiene fragmentos de columna. Cada fragmento de columna almacena estadísticas, incluidos los valores mínimo y máximo de ese segmento de datos. Al ejecutar una consulta con una condición de filtro, el motor de consultas comprueba primero estas estadísticas. Si el valor del filtro está fuera del intervalo mínimo/máximo de un grupo de filas, el motor omite la lectura de esa sección completa.
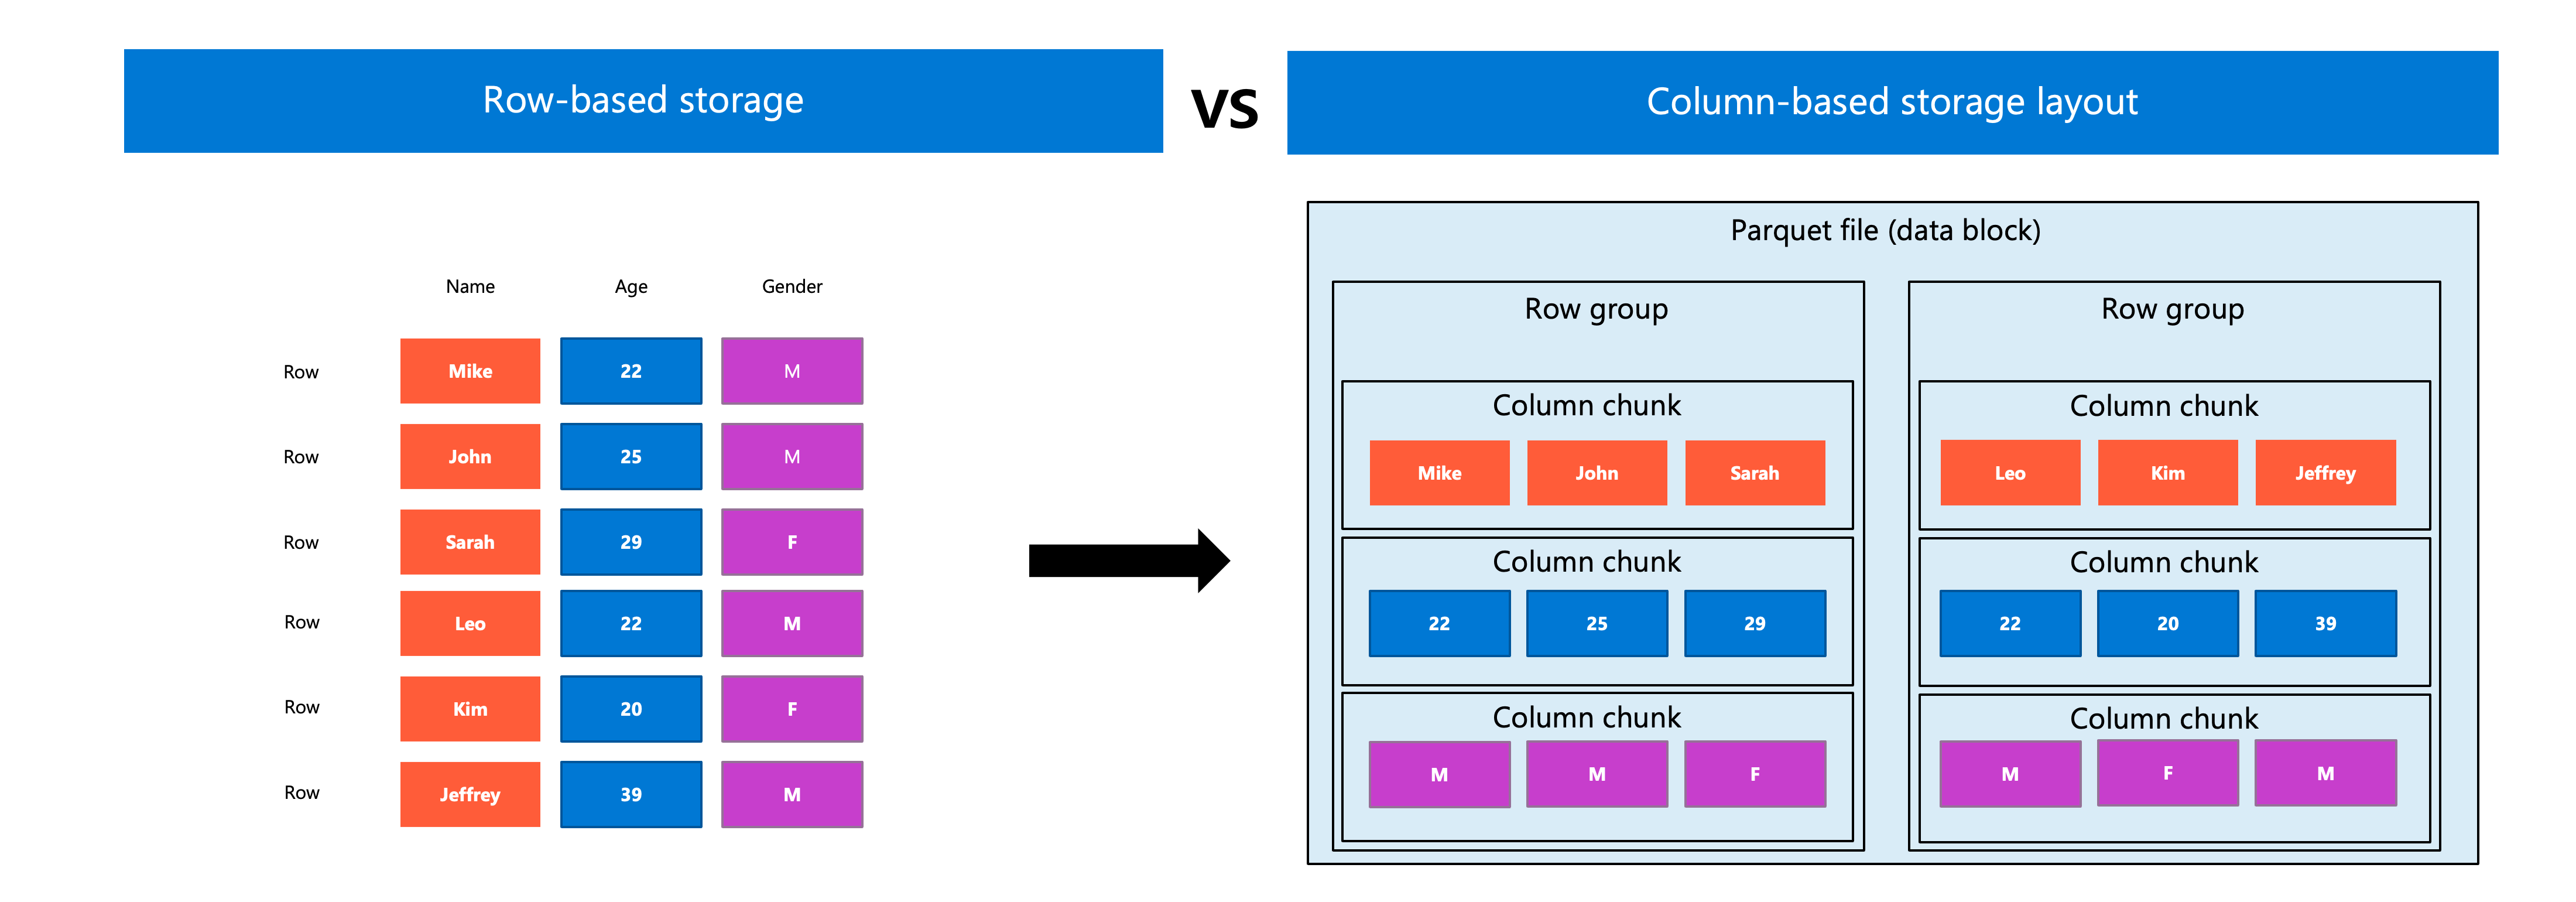
Este enfoque en columnas proporciona dos técnicas de optimización que mejoran drásticamente el rendimiento del análisis:
- Poda de columnas: El motor solo lee las columnas a las que hace referencia su consulta, lo que reduce sustancialmente la E/S.
- Predicado pushdown: Las condiciones del filtro se evalúan contra las estadísticas de la columna antes de leer los datos, omitiendo por completo los grupos de filas irrelevantes.
En el caso de las cargas de trabajo analíticas que normalmente acceden a un subconjunto de columnas a través de muchas filas, Parquet supera considerablemente los formatos basados en filas.
Delta Lake como formato predeterminado
Delta Lake es el formato de almacenamiento predeterminado para todas las tablas de Azure Databricks. Al crear una tabla sin especificar un formato, Azure Databricks usa automáticamente Delta Lake.
Delta Lake extiende los archivos Parquet con un registro de transacciones que registra cada cambio en la tabla. Este registro habilita varias funcionalidades que Parquet solo no proporciona:
Transacciones ACID: varios lectores y escritores simultáneos pueden acceder a la misma tabla sin daños en los datos. Cada transacción se completa completamente o no tiene ningún efecto.
Viaje en el tiempo: consulte versiones anteriores de la tabla mediante marcas de tiempo o números de versión. Revierte los cambios si es necesario.
Aplicación y evolución del esquema: La tabla valida los datos entrantes contra su esquema definido, evitando que datos corruptos o incompatibles ingresen a su lakehouse. Cuando cambian los requisitos, puede agregar nuevas columnas, modificar tipos de datos o cambiar el nombre de las columnas sin volver a escribir los datos existentes.
Lote y streaming unificados: Utilice la misma tabla como fuente de procesamiento por lotes y como fuente o receptor de transmisión.
Delta Lake se integra profundamente con la plataforma de Azure Databricks. Las características como los clústeres líquidos y la optimización predictiva están disponibles tanto para Delta Lake como para las tablas administradas de Apache Iceberg en Unity Catalog. Sin embargo, el flujo de cambios de datos es específico de Delta Lake y se basa en su registro de transacciones.
En la mayoría de los escenarios de Azure Databricks, Delta Lake es la opción recomendada. Proporciona las ventajas de rendimiento de Parquet con garantías transaccionales que requieren los sistemas de datos de producción.
Apache Iceberg para escenarios multiplataforma
Apache Iceberg es un formato de tabla abierto alternativo que Azure Databricks admite para tablas administradas y externas. Al igual que Delta Lake, Iceberg ofrece transacciones ACID, evolución de esquemas y capacidades de viaje en el tiempo creadas sobre archivos Parquet.
La estructura lógica jerárquica y bien definida de Iceberg hace que sea altamente flexible, soportando la escalabilidad y optimizaciones avanzadas. Admite poda de manifiesto, estadísticas a nivel de archivo, particionamiento oculto y evolución de particiones.
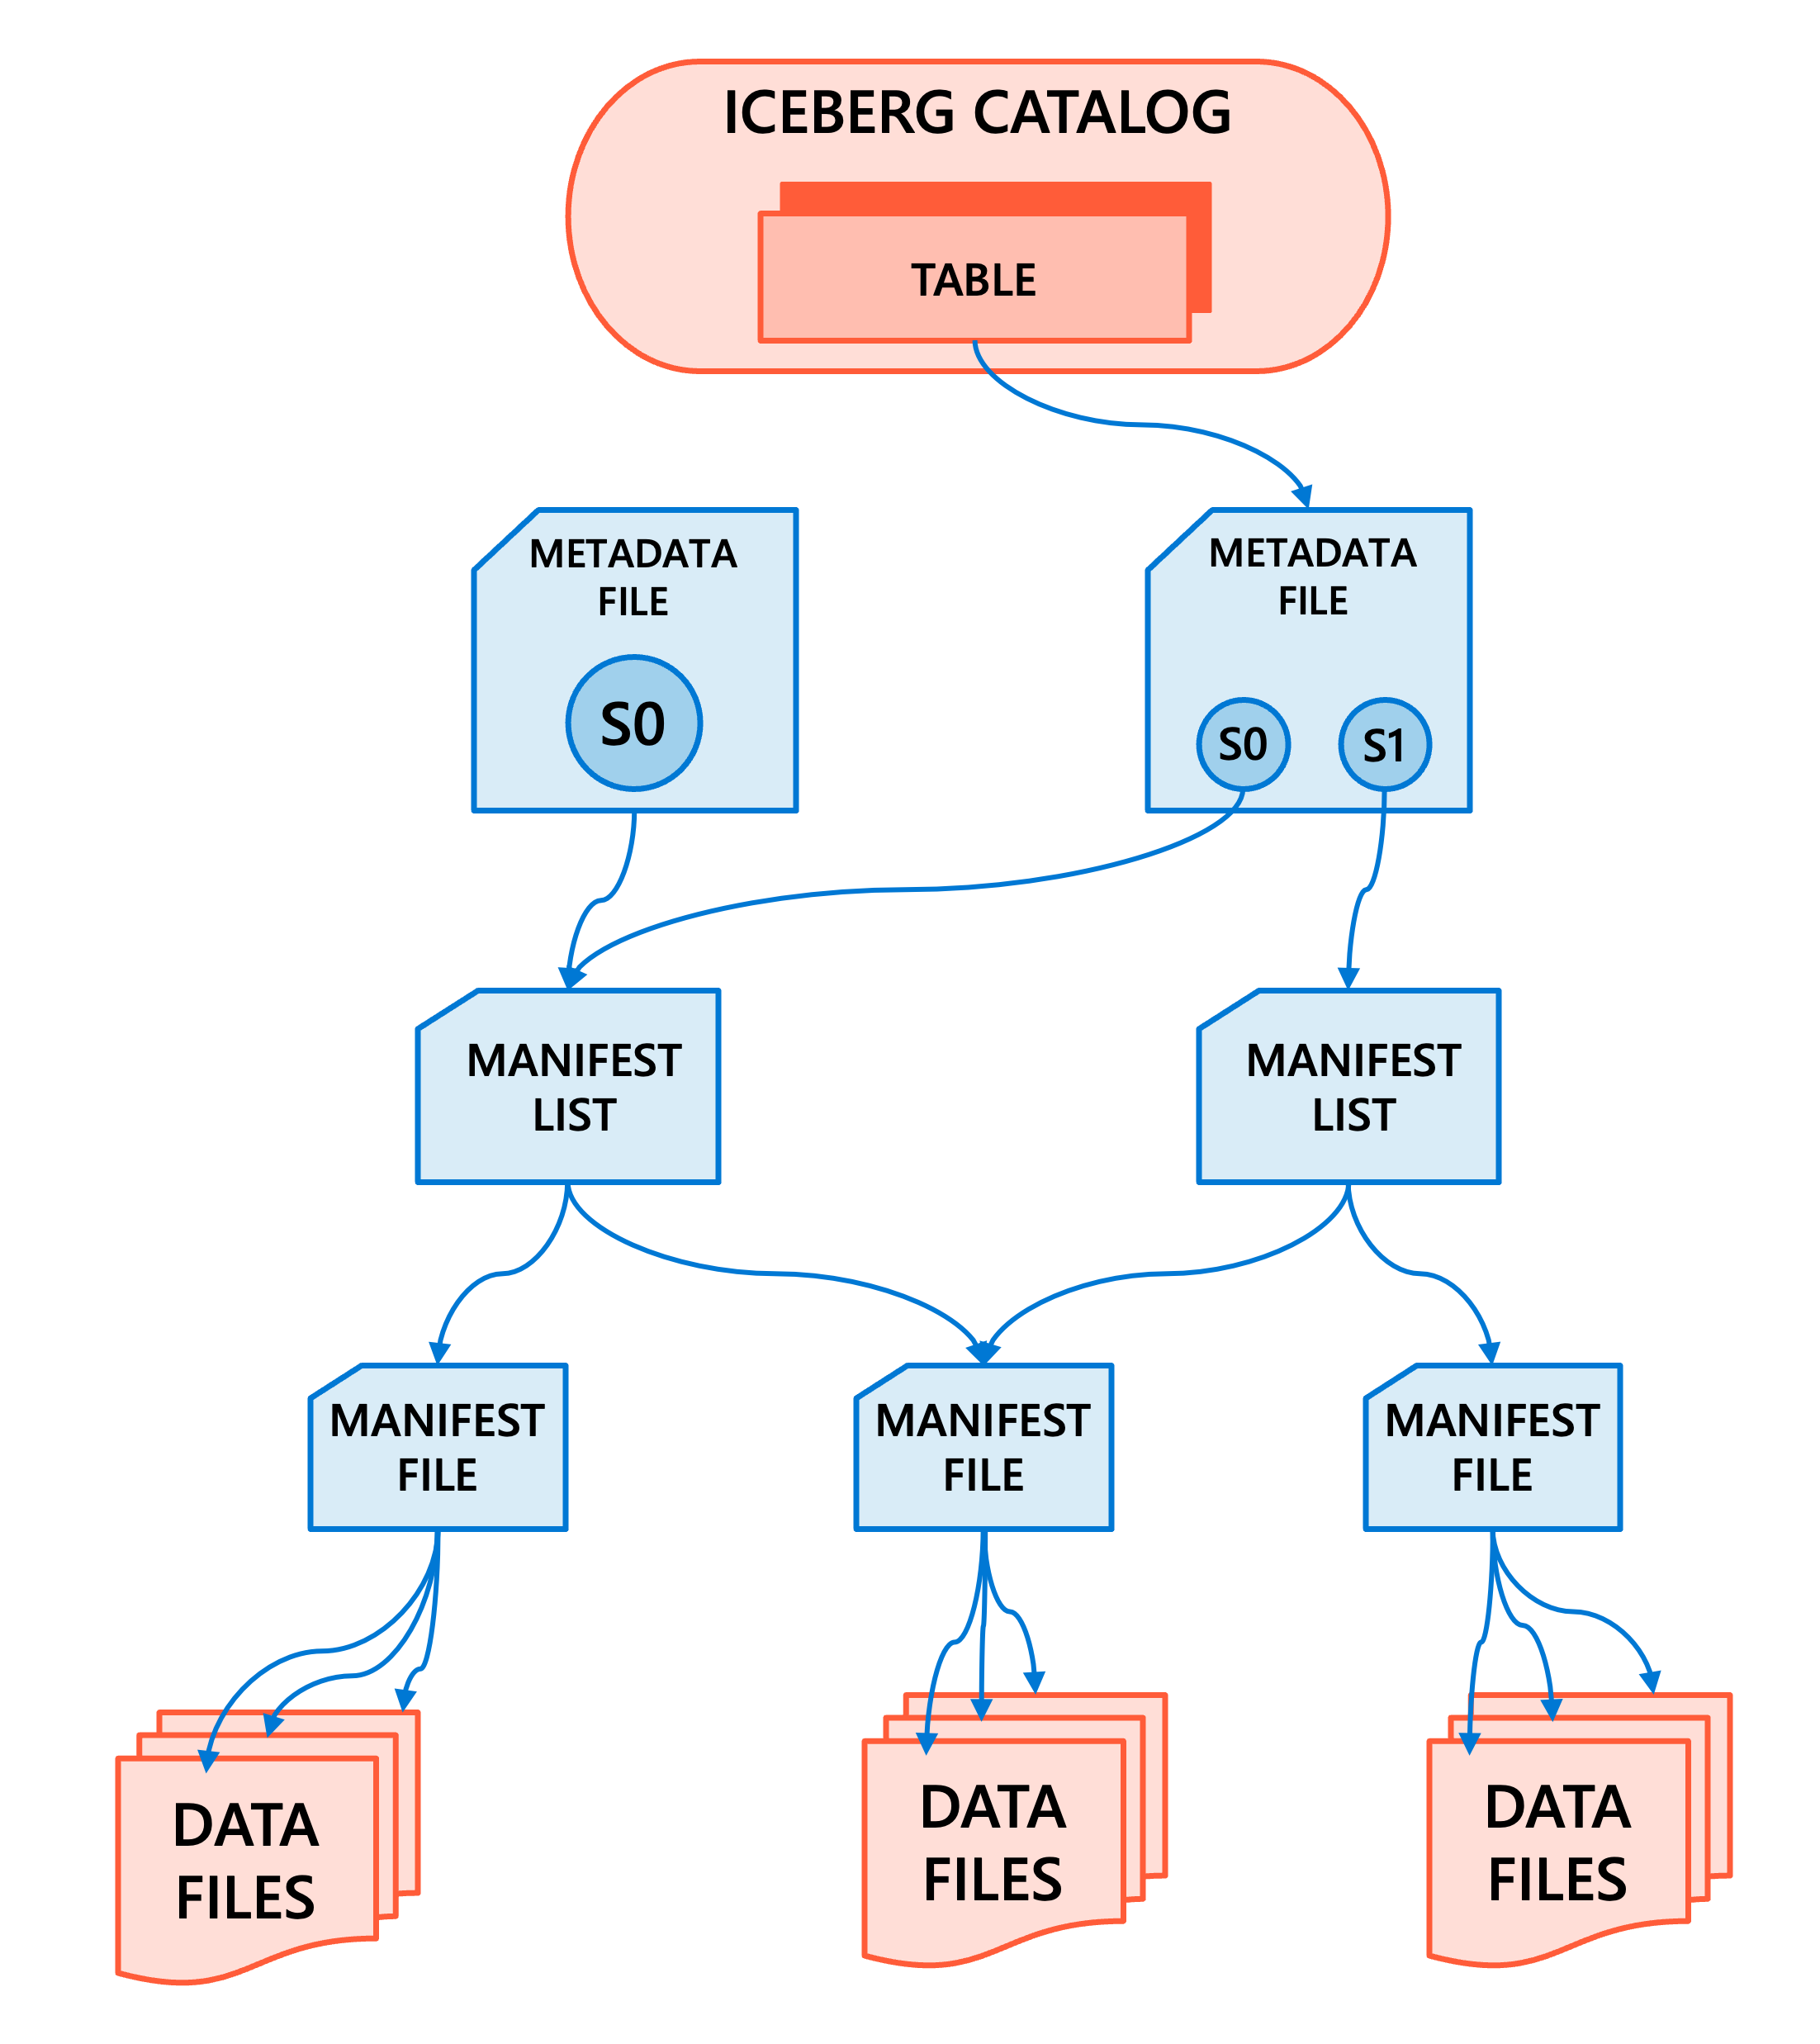
La razón principal para elegir El Iceberg es la interoperabilidad. Iceberg se adopta ampliamente en todo el ecosistema de datos, incluidas plataformas como Snowflake, Amazon Athena, Trino, Apache Spark y Apache Flink. Si su organización ejecuta cargas de trabajo en varias plataformas que necesitan leer y escribir en las mismas tablas, Iceberg proporciona un formato común que todas las plataformas comprenden.
El catálogo de Unity puede administrar directamente las tablas de Iceberg, lo que permite a Azure Databricks servir como catálogo de Iceberg para motores externos. También puede leer tablas Iceberg administradas por otros catálogos como AWS Glue o Snowflake Horizon Catalog a través de conexiones de tablas externas.
Tenga en cuenta Iceberg cuando:
- Es necesario acceder a los datos mediante varios motores de procesamiento fuera de Azure Databricks.
- Su organización ha adoptado Iceberg como estándar para el intercambio de datos multiplataforma.
- Está integrando con sistemas que no admiten Delta Lake.
En el caso de las cargas de trabajo que se ejecutan principalmente en Azure Databricks, Delta Lake sigue siendo el formato recomendado debido a sus características de optimización y integración de plataformas más profundas.
Cuando se aplican formatos basados en filas
CSV y JSON siguen siendo opciones válidas para escenarios específicos, aunque sean menos eficaces para el análisis a gran escala.
Use CSV o JSON cuando:
- Recibe datos de sistemas externos en estos formatos como zona de aterrizaje inicial.
- Necesita datos legibles para humanos para la depuración o la inspección rápida.
- Está integrándose con sistemas que únicamente admiten formatos basados en texto.
- Los volúmenes de datos son lo suficientemente pequeños como para que las diferencias de rendimiento sean insignificantes.
Para el almacenamiento persistente de datos analíticos, convierta archivos CSV o JSON entrantes en tablas de Delta Lake durante la ingesta. Esta conversión captura las mejoras de eficiencia del almacenamiento en columnas al agregar garantías transaccionales.
Aplicar criterios de decisión
La selección de un formato de tabla depende de sus requisitos específicos. Comience con Delta Lake como opción predeterminada y, a continuación, evalúe alternativas solo cuando las restricciones específicas las requieran.
| Consideración | Delta Lake | Apache Iceberg | CSV/JSON |
|---|---|---|---|
| Rendimiento del análisis | Excelente | Excelente | Poor |
| Transacciones ACID | Sí | Sí | No |
| Viaje en el tiempo | Sí | Sí | No |
| Integración de Azure Databricks | Profundo | Compatible | Básico |
| Compatibilidad multiplataforma | Creciente | Ancho | Universal |
| Opción recomendada para producción | Sí | Sí (cuando se requiere interoperabilidad) | No (solo zona de aterrizaje) |
Su elección también depende de los estándares de la organización. Si el equipo de arquitectura ha establecido convenciones para los formatos de tabla, alinee con esas decisiones para mantener la coherencia en la plataforma de datos.