Evaluación de la IA generativa
Las evaluaciones son evaluaciones sistemáticas del rendimiento, la confiabilidad y la seguridad de las aplicaciones de IA generativas. Le ayudan a validar si una aplicación está produciendo respuestas útiles, basadas y compatibles con directivas en los escenarios que más importan a los usuarios.
Las evaluaciones son cruciales por varias razones:
- Control de calidad: ayudan a garantizar que los sistemas de inteligencia artificial cumplan el estándar esperado de utilidad, claridad y confiabilidad.
- Validación de seguridad: exponen comportamientos perjudiciales o de incumplimiento de directivas antes de que lleguen a los usuarios finales.
- Comparación de cambios: permiten comparar los cambios de solicitud, recuperación, modelo y herramienta con evidencia en lugar de anécdotas.
- Confianza del usuario: las aplicaciones evaluadas de forma coherente son más fáciles de mejorar y facilitar a las partes interesadas la confianza.
Evaluaciones asistidas por IA en Microsoft Foundry
Normalmente, las aplicaciones de IA generativa necesitan más de una métrica. En el portal de Foundry, los evaluadores integrados se organizan en tres grupos de alto nivel: Agente, Calidad y Seguridad. En el catálogo completo, esos grupos se expanden a familias de evaluadores, como calidad de uso general, similitud textual, RAG, riesgo y seguridad, y evaluadores de agentes. Esa estructura le ayuda a probar diferentes modos de error en lugar de tratar la evaluación como una única puntuación de precisión.
Los evaluadores asistidos por IA en el catálogo de calidad, además de muchos evaluadores de agentes, necesitan una conexión de Azure OpenAI con un modelo GPT implementado que admita la finalización del chat. En su lugar, los evaluadores de seguridad y Groundedness Pro usan los servicios de evaluación hospedados de Microsoft, por lo que no dependen de una implementación de modelo de evaluador. Esa distinción afecta a los requisitos previos, la planificación de costos y los evaluadores que puede ejecutar en una región determinada.
Evaluación con Microsoft Foundry
Utilice el portal Foundry cuando quiera un flujo de trabajo guiado. El flujo del portal actual le permite elegir un destino de evaluación (agente, modelo o conjunto de datos), cargar o generar un conjunto de datos, seleccionar evaluadores integrados o personalizados, confirmar la asignación de datos e inspeccionar los resultados en el portal.
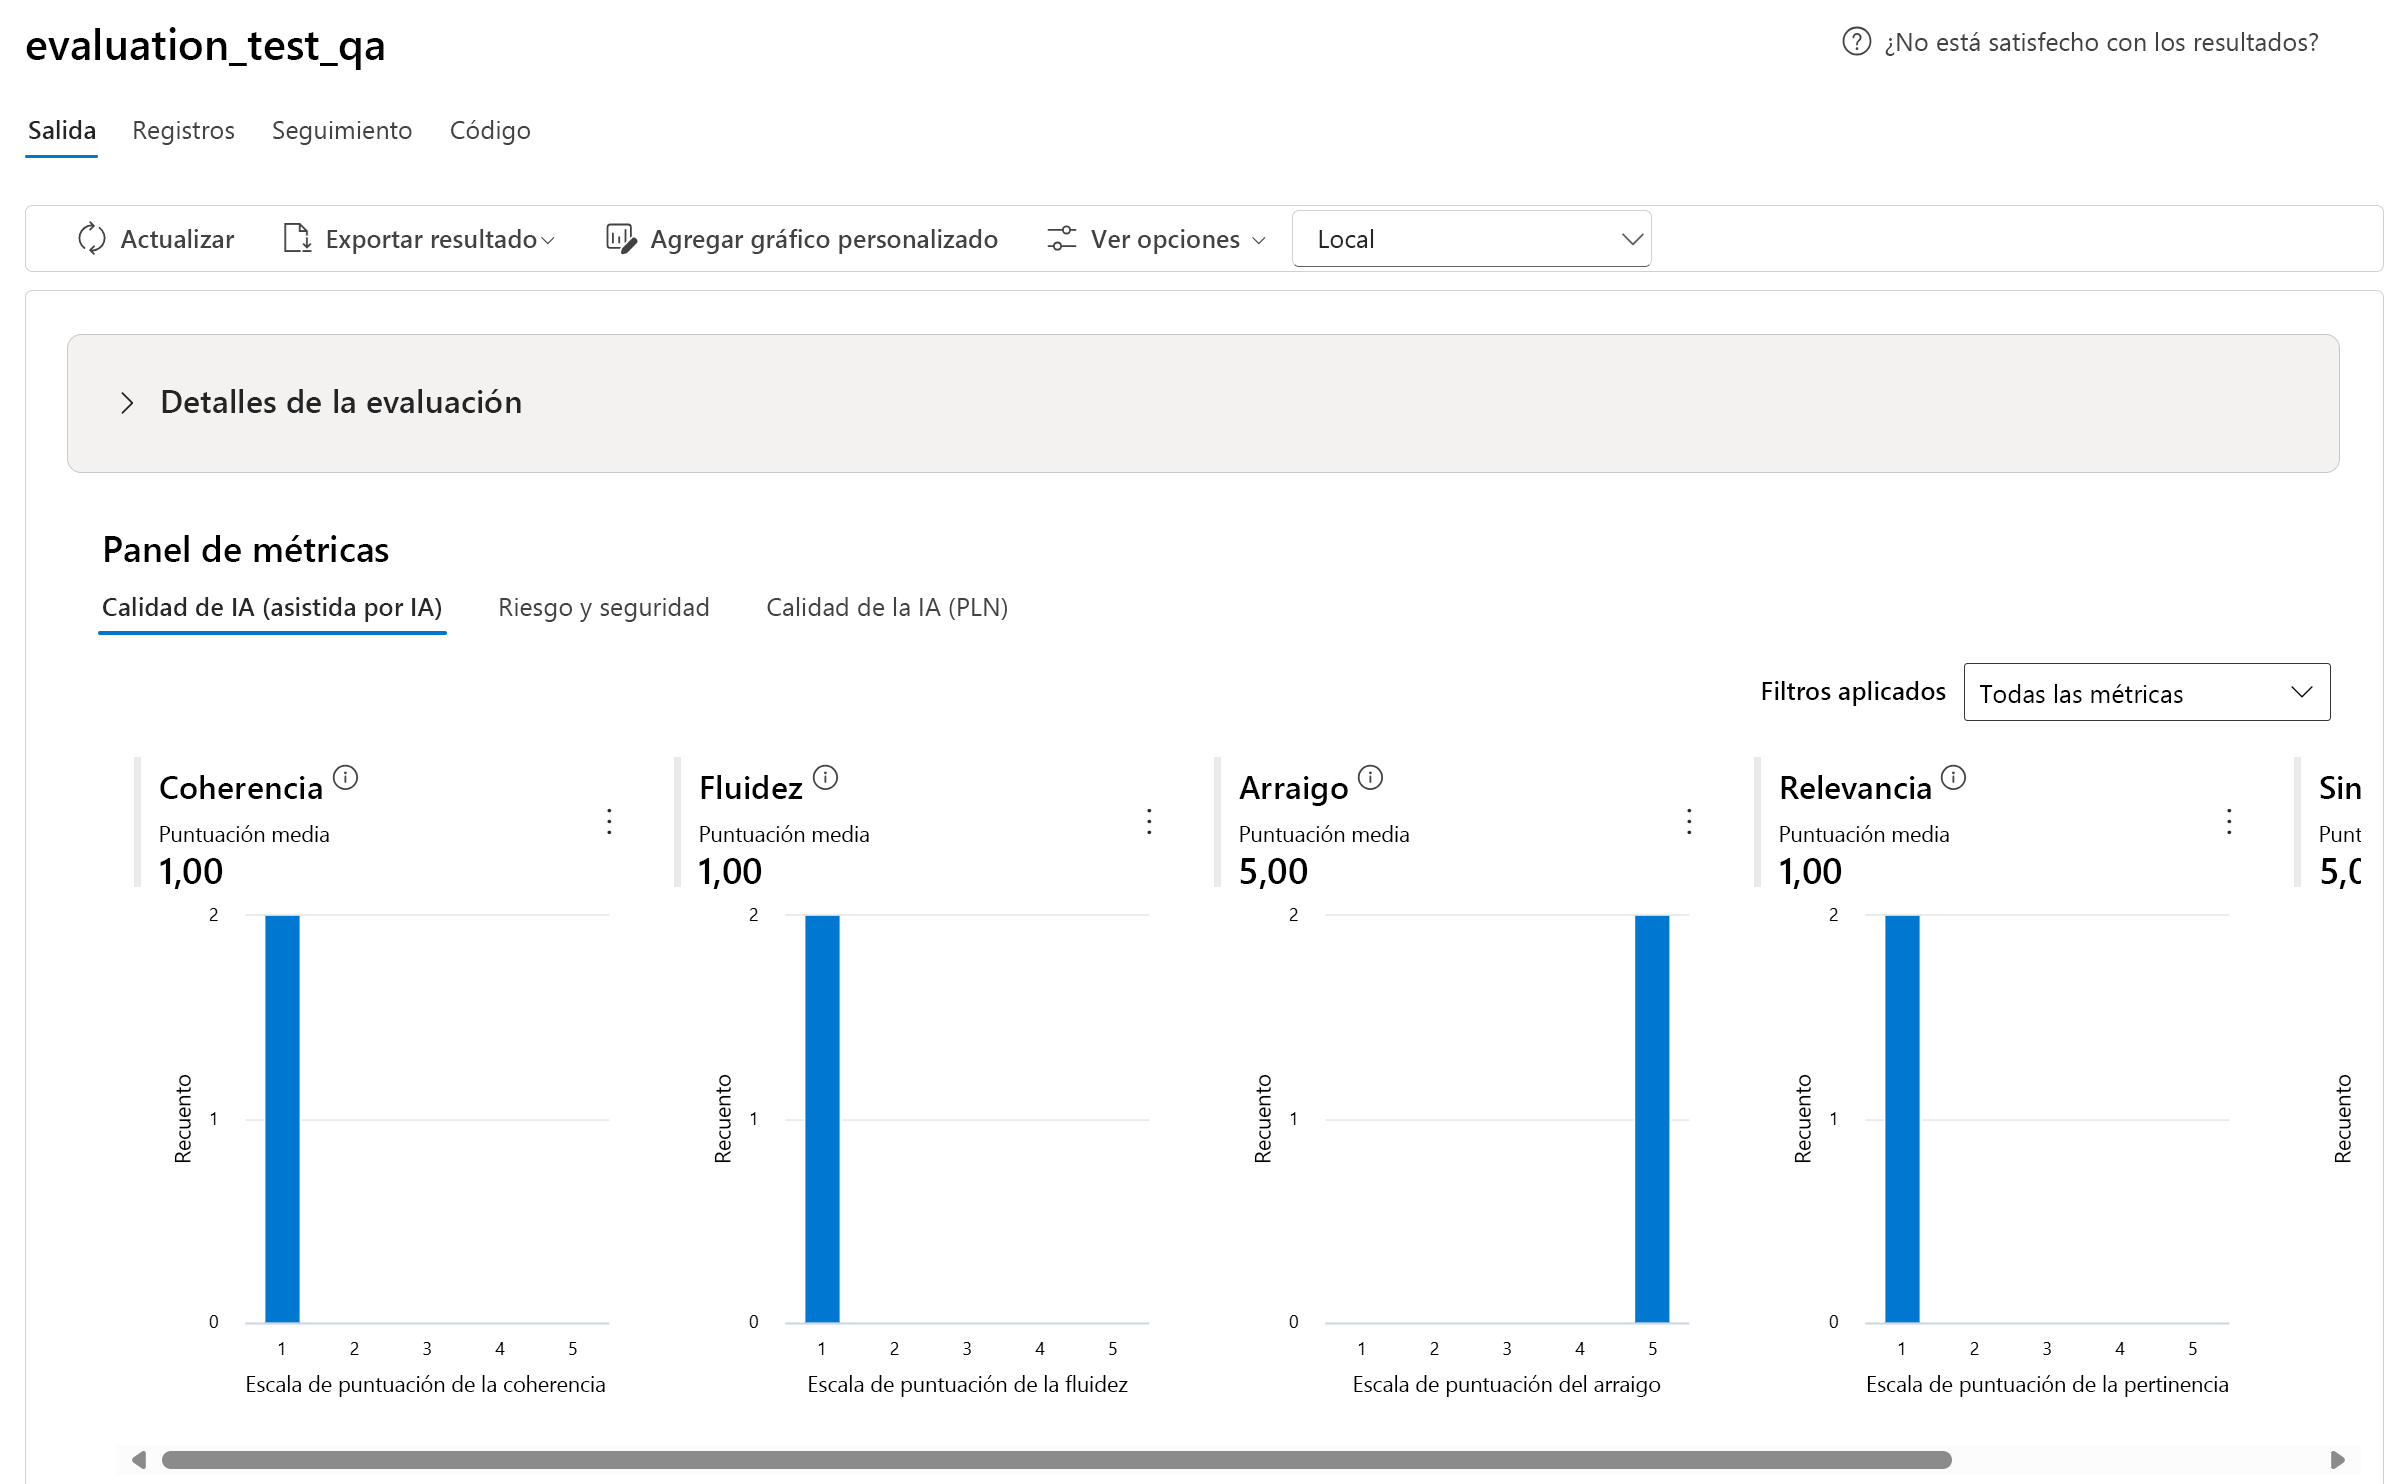
La imagen muestra un panel de evaluación con detalles de ejecución y un resumen de métricas. El panel incluye gráficos para varios evaluadores, le permite filtrar las métricas y proporciona vistas de calidad y de riesgo y seguridad. Este tipo de página de resultados le ayuda a ver la tendencia general de una ejecución antes de inspeccionar pares individuales de solicitud y respuesta.
Una vez completada una ejecución, revise las métricas de agregado y los resultados de nivel de fila. Las métricas agregadas muestran el movimiento general, mientras que los resultados a nivel de fila muestran los mensajes que fallaron, las puntuaciones y etiquetas que recibieron, y por qué el evaluador los marcó así.
Uso de flujos de trabajo del SDK para la automatización
Use flujos de trabajo del SDK cuando necesite automatización repetible, pruebas de implementación previa a mayor escala o integración de CI/CD. Las instrucciones actuales de evaluación en la nube admiten evaluaciones de conjuntos de datos JSONL o CSV, evaluaciones de destino del modelo, evaluaciones de destino del agente, evaluaciones de respuesta del agente (por ID de respuesta), evaluaciones de datos sintéticos (versión preliminar) y evaluaciones del equipo rojo. Esas ejecuciones están almacenadas en su proyecto Foundry, para que pueda revisarlas en el portal junto con otras evaluaciones; también puede programarlas o configurar una evaluación continua de las respuestas muestreadas de los agentes de producción.
Dado que la evaluación en la nube está actualmente en versión preliminar y, dado que algunas características de evaluación tienen compatibilidad específica de la región, confirme los términos de versión preliminar actuales, las regiones admitidas y los límites operativos antes de usarlos como puerta de versión de producción.
Independientemente de la herramienta que elija, combine la evaluación automatizada con la revisión humana dirigida. A menudo, una muestra pequeña y representativa revisada por personas muestra problemas de tono, respuestas incompletas o salidas engañosas pero creíbles que las puntuaciones agregadas pueden ocultar.
Sugerencia
Para conocer los procedimientos actuales, consulte Ejecutar evaluaciones desde el portal de Microsoft Foundry, Ejecutar evaluaciones en la nube mediante el SDK de Microsoft Foundry, Ver los resultados de evaluación en el portal de Microsoft Foundry y Límites de frecuencia, soporte técnico de regiones y características empresariales para su evaluación.