Evaluación del rendimiento de las consultas con planes de ejecución y DMV
Cuando una consulta se ejecuta más lenta de lo esperado, el primer paso es comprender cómo lo ejecuta el motor de base de datos. Los planes de ejecución muestran los operadores exactos, los métodos de acceso a datos y los costos de recursos que el optimizador eligió para una consulta. Las vistas de administración dinámica (DMV) complementan esto exponiendo los datos de rendimiento en tiempo de ejecución para todas las consultas de la base de datos, por lo que puede encontrar las consultas más costosas antes de profundizar en un plan en particular.
Leer planes de ejecución
Un plan de ejecución es el conjunto de instrucciones que genera el optimizador de consultas para recuperar y procesar datos. Define las tablas a las que acceder primero, tanto si usar índices como examinar tablas, y cómo combinar, filtrar, ordenar y agregar resultados. El optimizador evalúa varios planes candidatos y selecciona el que tiene el costo estimado más bajo.
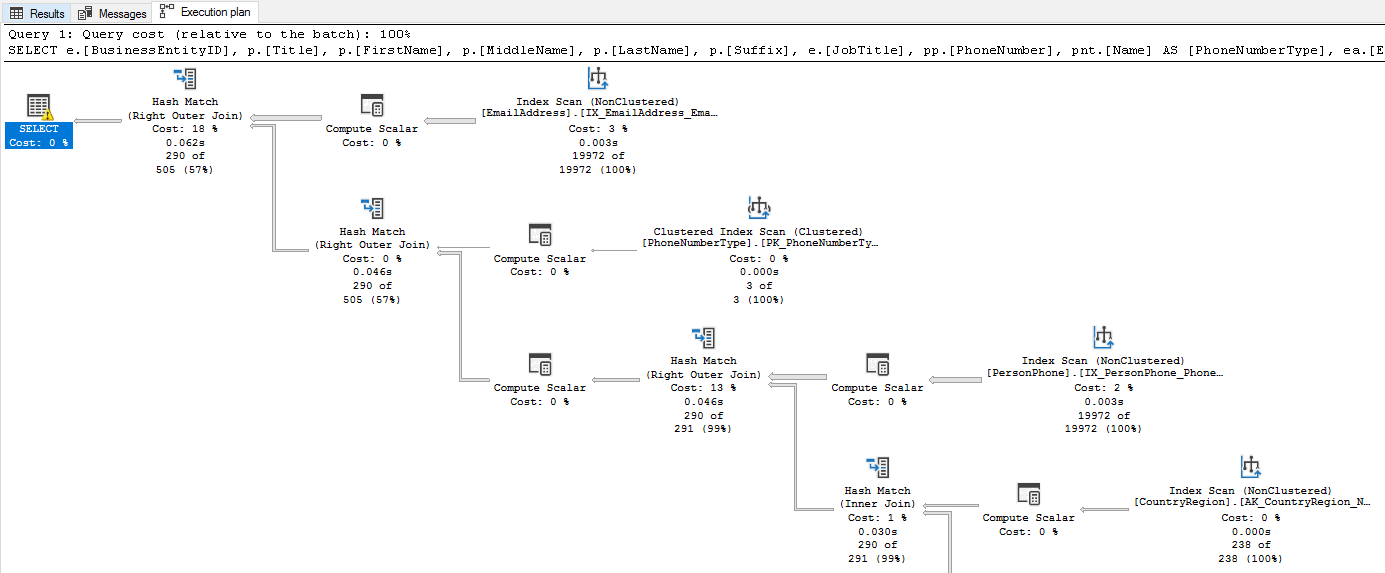
Hay dos tipos de planes de ejecución:
- Plan de ejecución estimado: generado sin ejecutar la consulta. Muestra los operadores planificados y los recuentos de filas estimados en función de las estadísticas. Use planes estimados para el análisis rápido sin afectar a la base de datos.
- Plan de ejecución real: capturado durante la ejecución de la consulta. Incluye el plan estimado más recuentos de filas reales, tiempos de ejecución reales, concesiones de memoria y advertencias. El plan real revela discrepancias entre lo que esperaba el optimizador y lo que realmente sucedió.
Para mostrar un plan estimado, ejecute SET SHOWPLAN_XML ON antes de la consulta o seleccione Mostrar plan de ejecución estimado en SQL Server Management Studio (SSMS). Para capturar un plan real, ejecute SET STATISTICS XML ON o seleccione Incluir plan de ejecución real en SSMS antes de ejecutar la consulta.
Aunque los planes estimados y reales son similares, las métricas en tiempo de ejecución del plan son cruciales para diagnosticar problemas de rendimiento. Por ejemplo, si el recuento estimado de filas de un escaneo de tabla es de 100, pero el recuento de filas real es 10 000, podría indicar que las estadísticas están obsoletas y conducen a una selección de plan incorrecta. El optimizador compila el plan en función de las estadísticas la primera vez que encuentra una consulta. Si esas estadísticas no reflejan la distribución de datos actual, el plan puede funcionar mal.
Identificación de problemas comunes en los planes de ejecución
Los planes de ejecución se leen de izquierda a derecha, de arriba abajo. Los primeros operadores acceden a las tablas base y el operador final genera el resultado de la consulta. Busque estos problemas comunes:
Los tipos de operador indican cómo accede el motor a los datos. Hay muchos tipos de operador, cada uno de los cuales representa un método diferente para recuperar o procesar datos. Por ejemplo, un operador Index Seek representa un método muy eficaz que tiene como destino filas específicas mediante claves de índice. Por otro lado, un operador Table Scan o Index Scan representa un método menos eficaz que lee todas las filas. Si ve un análisis en una tabla grande, es probable que necesite un índice. Por ejemplo, si la aplicación de comercio electrónico consulta pedidos por fecha y el plan muestra una exploración de índice agrupado en la tabla Orders, agregar un índice no agrupado en la columna OrderDate podría convertir esa exploración en una búsqueda. Tenga en cuenta que no todos los escaneos son malos. Si una tabla es pequeña o la condición de búsqueda devuelve la mayoría de las filas de una tabla, un examen podría ser el método de acceso más eficaz. Tenga en cuenta siempre el contexto de la consulta y el tamaño de los datos. Conozca los datos y use planes de ejecución para confirmar si el método de acceso tiene sentido.
Los recuentos de filas estimados frente a reales revelan si las suposiciones del optimizador coinciden con la realidad. El optimizador basa su plan en estadísticas, metadatos que describen la distribución y la densidad de datos en las tablas. Si esas estadísticas están obsoletas, los recuentos de filas estimados y reales difieren. Cuando el optimizador subestima los recuentos de filas, podría elegir un nested loop join (que procesa una fila cada vez desde la tabla interna de una combinación) cuando un hash join (que crea una tabla hash en memoria para búsquedas rápidas) sería más rápido, o asignar demasiada poca memoria para una operación de ordenación. Las estadísticas pueden quedar obsoletas después de cambios significativos en los datos, por lo que actualizar las estadísticas con UPDATE STATISTICS o habilitar las actualizaciones automáticas de estadísticas puede ayudar al optimizador a tomar mejores decisiones.
Los operadores de búsqueda de claves aparecen cuando el motor encuentra filas a través de un índice no clúster, pero necesita columnas adicionales del índice agrupado. Para cada fila coincidente, el motor realiza un recorrido de ida y vuelta adicional al índice agrupado para recuperar esas columnas. Si el filtro devuelve muchas filas, esas consultas adicionales se acumulan rápidamente. Por ejemplo, si la aplicación de comercio electrónico filtra los pedidos por CustomerID , pero también selecciona OrderDate, TotalAmounty , y ShippingAddressel índice no agrupado en CustomerID no incluye esas columnas, el plan muestra una búsqueda de claves para cada pedido coincidente. Puede eliminar las búsquedas de claves agregando las columnas que faltan como columnas incluidas en el índice. Tenga en cuenta que las columnas incluidas aumentan el tamaño del índice, lo que puede ralentizar las escrituras, por lo que pesa la ventaja de rendimiento de lectura frente a la sobrecarga de escritura.
Las flechas gruesas entre operadores representan la cantidad de filas que circulan entre ellos. Una flecha inesperadamente gruesa al principio del plan (leer de izquierda a derecha, arriba abajo) a menudo significa que falta un filtro o índice que deja pasar demasiadas filas.
Las sugerencias de índice que faltan aparecen como texto resaltado verde en la parte superior del plan de ejecución gráfico en SSMS. Cuando el optimizador detecta que un índice podría reducir significativamente el costo de una consulta, muestra una recomendación directamente en el plan. Haga clic con el botón derecho en la sugerencia y seleccione Faltan detalles del índice para generar una CREATE INDEX instrucción que puede revisar y ejecutar. Estas sugerencias son una de las ventajas más fáciles que puede obtener al leer un plan de ejecución.
Las advertencias aparecen como un triángulo amarillo con un signo de exclamación (⚠) en el operador afectado. Cada advertencia apunta a una oportunidad de optimización. Entre las advertencias comunes se incluyen las siguientes:
- Estadísticas que faltan: el optimizador no pudo encontrar estadísticas para una columna, por lo que se adivinaron en recuentos de filas en lugar de usar la distribución de datos real. Para corregir este problema, cree estadísticas en las columnas usadas en las consultas o actualice las estadísticas existentes si están obsoletas.
- Concesión excesiva de memoria: la consulta solicitó más memoria de la que necesitaba, desperdiciando recursos que otras consultas podían usar. Este problema suele ocurrir cuando el optimizador sobrestima los recuentos de filas. La actualización de estadísticas o la reescritura de la consulta para filtrar filas anteriormente puede ayudar a reducir las concesiones de memoria.
-
Sin predicado de unión: dos tablas se unen sin una condición adecuada, produciendo un producto cartesiano que devuelve todas las combinaciones de filas posibles. Compruebe si a la consulta le falta una cláusula
ONo si es incorrecta. -
Conversión implícita: un error de coincidencia de tipos de datos obliga al motor a convertir valores en tiempo de ejecución, lo que puede convertir una búsqueda de índice en un examen. Por ejemplo, si una
WHEREcláusula compara unnvarcharparámetro con unavarcharcolumna, el motor convierte todas las filas de la columna ennvarcharantes de compararlas. Para corregir conversiones implícitas, alinee los tipos de datos de sus parámetros de consulta con las definiciones de las columnas. -
Desbordamiento por ordenación o hash: una operación de ordenación o hash se quedó sin memoria concedida y volcó los resultados intermedios en tempdb. Estas operaciones son el segundo factor más común del uso elevado de la CPU después de los escaneos. Si ve una advertencia de vertido, es probable que el optimizador subestime los recuentos de filas y solicite muy poca memoria. Ejecutar
UPDATE STATISTICSpara actualizar las estadísticas de la tabla o reescribir la consulta para reducir el número de filas antes de la ordenación puede a menudo eliminar el desbordamiento.
Los planes de ejecución son una herramienta eficaz para comprender el rendimiento de las consultas. Muestran exactamente cómo el motor ejecuta una consulta de búsqueda y dónde están los cuellos de botella. Al aprender a leer los planes de ejecución de forma eficaz, puede identificar y corregir rápidamente problemas de rendimiento en las consultas de base de datos.
Consulta de DMV para datos de rendimiento en tiempo de ejecución
Las DMV exponen datos de rendimiento acumulados y en tiempo real del motor de base de datos. Azure SQL Database requiere VIEW DATABASE STATE permiso para consultarlos. Aunque los planes de ejecución muestran cómo se ejecuta una sola consulta, las DMV muestran lo que sucede en todas las consultas, lo que le ayuda a encontrar primero las más costosas.
Búsqueda de las consultas más costosas
El tiempo de CPU, las lecturas lógicas y el recuento de ejecuciones son las métricas más comunes para identificar consultas costosas. El tiempo elevado de CPU o las lecturas lógicas indican que una consulta consume muchos recursos, mientras que un recuento de ejecución elevado significa que incluso una consulta moderadamente costosa puede tener un gran impacto en el rendimiento general. Empiece por revisar las consultas principales por promedio de tiempo de CPU o lecturas lógicas para buscar candidatos para la optimización.
sys.dm_exec_query_stats devuelve estadísticas de rendimiento agregadas para los planes de consulta almacenados en caché. Únalo con sys.dm_exec_sql_text para ver el texto de la consulta y sys.dm_exec_query_plan para recuperar el plan de ejecución.
La consulta siguiente busca las 10 consultas principales por tiempo medio de CPU:
SELECT TOP 10
    qs.total_worker_time / qs.execution_count AS avg_cpu_time,
    qs.execution_count,
    qs.total_logical_reads / qs.execution_count AS avg_logical_reads,
    SUBSTRING(st.text, (qs.statement_start_offset / 2) + 1,
        ((CASE qs.statement_end_offset
            WHEN -1 THEN DATALENGTH(st.text)
            ELSE qs.statement_end_offset
        END - qs.statement_start_offset) / 2) + 1) AS query_text
FROM sys.dm_exec_query_stats AS qs
CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) AS st
ORDER BY avg_cpu_time DESC;
Este script le ayuda a identificar qué consultas merecen su atención. Alto avg_logical_reads en relación con el tamaño del conjunto de resultados a menudo apunta a índices que faltan o planes ineficaces. Sin embargo, tenga cuidado al interpretar estos resultados. Una consulta con un tiempo medio elevado de CPU que solo se ejecuta una vez al día podría importar menos de una consulta moderada que se ejecuta miles de veces por hora. Tenga en cuenta siempre el costo medio y el recuento de ejecuciones al priorizar. También puede ordenar por avg_logical_reads para buscar consultas intensivas en E/S, que a menudo indican que faltan índices o que los métodos de acceso son ineficaces.
Verificar las consultas que se están ejecutando actualmente
Aunque la consulta anterior muestra las consultas históricas más costosas de la memoria caché del plan, sys.dm_exec_requests proporciona una instantánea de cada solicitud que se está ejecutando actualmente. Incluye columnas para el tiempo de CPU, lecturas, escrituras, tipo de espera, tiempo de espera e ID de la sesión de bloqueo. Use esta vista para detectar consultas activas que consumen demasiados recursos o que están bloqueadas en espera de bloqueos. Esta vista es una de las DMV más importantes para la supervisión y solución de problemas de rendimiento en tiempo real.
SELECT
    r.session_id,
    r.status,
    r.command,
    r.wait_type,
    r.wait_time,
    r.blocking_session_id,
    r.cpu_time,
    r.logical_reads,
    t.text AS query_text
FROM sys.dm_exec_requests AS r
CROSS APPLY sys.dm_exec_sql_text(r.sql_handle) AS t
WHERE r.session_id > 50
ORDER BY r.cpu_time DESC;
Esta consulta filtra las sesiones del sistema (identificadores de sesión 1-50) y los pedidos por tiempo de CPU. También puede ordenar por logical_reads para encontrar consultas con uso intensivo de E/S. Las columnas wait_type y wait_time le ayudan a identificar si una consulta está esperando bloqueos, E/S u otros recursos.
Detección de índices que faltan
Anteriormente, vimos cómo los planes de ejecución pueden mostrar las sugerencias de índice que faltan para una sola consulta. Las DMV de índice que faltan proporcionan una vista más amplia de los índices que el optimizador usaría en todas las consultas si existían. Estas vistas son una excelente manera de encontrar oportunidades de optimización que afectan a varias consultas.
sys.dm_db_missing_index_details muestra la tabla, las columnas de igualdad y desigualdad y las columnas incluidas.
sys.dm_db_missing_index_group_stats proporciona una medida de mejora que calcula la reducción de costos.
SELECT
    mid.statement AS table_name,
    mid.equality_columns,
    mid.inequality_columns,
    mid.included_columns,
    migs.avg_total_user_cost * migs.avg_user_impact *
        (migs.user_seeks + migs.user_scans) AS improvement_measure
FROM sys.dm_db_missing_index_groups AS mig
INNER JOIN sys.dm_db_missing_index_group_stats AS migs
    ON migs.group_handle = mig.index_group_handle
INNER JOIN sys.dm_db_missing_index_details AS mid
    ON mig.index_handle = mid.index_handle
ORDER BY improvement_measure DESC;
Esta consulta calcula una improvement_measure para cada recomendación de índice que falta, que es un producto del costo medio de las consultas que se beneficiarían del índice, la mejora porcentual media y el número de veces que se ejecutaron esas consultas. La ordenación por esta medida le ayuda a priorizar qué índices faltantes crear primero. Sin embargo, recuerde que estos resultados son solo recomendaciones basadas en las consultas que se encuentran actualmente en la memoria caché del plan. Revise siempre las columnas de índice sugeridas y pruebe su impacto en el rendimiento de las consultas y la sobrecarga de escritura antes de agregarlas a producción.
Nota:
Las recomendaciones de índice que faltan son sugerencias, no directivas. Pruebe siempre el impacto de un nuevo índice en el rendimiento de las consultas y la sobrecarga de escritura antes de agregarlo a producción.
Monitoreo de sesiones activas y de tareas en espera
sys.dm_exec_sessions proporciona información sobre todas las sesiones autenticadas, incluido el tiempo de inicio de sesión, el nombre de host, el nombre del programa y la CPU acumulativa y las lecturas. Combínelo con sys.dm_os_waiting_tasks para ver qué tareas están en espera y qué recursos están esperando. Estas vistas son esenciales al diagnosticar bloqueos y contención de recursos en una unidad posterior.
Ponlo todo junto
Los planes de ejecución y las DMV proporcionan una imagen completa del comportamiento de las consultas. Comience con las DMV para identificar las consultas más costosas. A continuación, explore sus planes de ejecución para comprender por qué son costosos. ¿Es la falta de un índice lo que provoca el análisis? ¿Las estadísticas obsoletas provocan errores de estimación de filas? ¿Una búsqueda de clave que puedes eliminar? Este enfoque sistemático, desde la visión del sistema hasta el análisis de consultas individuales, es la manera más eficaz de encontrar y corregir cuellos de botella de rendimiento.
Conclusiones clave
Los planes de ejecución revelan la estrategia del optimizador para una consulta y los planes reales incluyen métricas en tiempo de ejecución que exponen discrepancias entre los recuentos de filas estimados y reales. Al leer un plan, concéntrese en los tipos de operadores (búsqueda frente a exploración), las estimaciones del recuento de filas, las advertencias y los operadores de búsqueda por clave. Las DMV proporcionan datos de rendimiento de todo el sistema: se usa sys.dm_exec_query_stats para encontrar las consultas más costosas, sys.dm_exec_requests para las consultas que se están ejecutando actualmente y DMV de índices que faltan para detectar oportunidades de optimización. Empiece con las DMV para identificar dónde están los problemas más importantes, y luego profundice en los planes de ejecución individuales para comprender por qué.