Identificar y resolver bloqueos e interbloqueos
El bloqueo es normal en una base de datos que usa el bloqueo. Una transacción contiene un bloqueo. Otra transacción espera. Se espera un breve bloqueo que dura unos milisegundos. Se convierte en un problema cuando dura lo suficiente para afectar a los usuarios. Los interbloqueos son la forma más grave: dos transacciones se bloquean permanentemente y el motor de base de datos tiene que terminar una para interrumpir el ciclo.
Bloqueos
El bloqueo se produce cuando una sesión contiene un bloqueo en un recurso y otra sesión solicita un bloqueo en conflicto en el mismo recurso. La sesión que solicita espera hasta que la primera sesión libere su bloqueo.
Los recursos pueden ser filas, páginas o incluso tablas completas. Los bloqueos pueden ser compartidos (para lectura) o exclusivos (para escritura). Cuando una sesión solicita un bloqueo que entra en conflicto con un bloqueo existente, queda bloqueada hasta que la sesión que posee el bloqueo inicial confirma o revierte su transacción y libera sus bloqueos.
Identificación de cadenas de bloqueo
En Azure SQL Database, el Aislamiento de instantánea de lectura confirmada (RCSI) está habilitado de forma predeterminada, por lo que las operaciones de lectura utilizan el control de versiones de fila en lugar de bloqueos compartidos. Esta configuración reduce significativamente el bloqueo entre lectores y escritores. Sin embargo, el bloqueo entre dos escritores o el bloqueo causado por transacciones explícitas con niveles de aislamiento más altos, sigue sucediendo.
La sesión en la parte superior de una cadena de bloqueo se denomina bloqueador principal. Todas las demás sesiones bloqueadas están esperando, directa o indirectamente, a que el bloqueador de encabezado libere sus bloqueos. Para buscar el bloqueador de encabezado, consulte sys.dm_exec_requests y busque sesiones donde blocking_session_id sea distinto de cero.
SELECT
    r.session_id,
    r.blocking_session_id,
    r.wait_type,
    r.wait_time,
    r.wait_resource,
    t.text AS query_text,
    r.status,
    r.command
FROM sys.dm_exec_requests AS r
CROSS APPLY sys.dm_exec_sql_text(r.sql_handle) AS t
WHERE r.blocking_session_id <> 0
ORDER BY r.wait_time DESC;
Para encontrar el bloqueador de encabezado en esos resultados, busque el identificador de sesión que bloquea a otros pero no se bloquea a sí mismo. Por ejemplo, supongamos que la consulta devuelve estas filas:
| identificador_de_sesión | blocking_session_id |
|---|---|
| 55 | 52 |
| 60 | 52 |
| 52 | 0 |
Las sesiones 55 y 60 están bloqueadas por la sesión 52, y la sesión 52 tiene un blocking_session_id de 0, lo que significa que nada la bloquea. La sesión 52 es el bloqueador de encabezado. Una vez que lo identifique, consulte sys.dm_exec_sessions y sys.dm_exec_requests filtrados por ese ID de sesión para ver qué se está ejecutando y por qué está manteniendo bloqueos.
Tenga en cuenta que RCSI elimina el bloqueo entre lectores y escritores, pero no entre dos escritores. Considere un escenario en el que la sesión 52 ejecuta una actualización por lotes dentro de una transacción explícita:
-- Session 52
BEGIN TRANSACTION;
UPDATE Orders SET Status = 'Processing' WHERE Region = 'West';
-- Transaction stays open while application does other work
Esta actualización adquiere bloqueos exclusivos en cada fila coincidente. Ahora la sesión 55 intenta actualizar una de esas mismas filas:
-- Session 55
UPDATE Orders SET Priority = 1 WHERE OrderId = 4820;
La sesión 55 espera porque la sesión 52 ya contiene un bloqueo exclusivo en esa fila y no se ha confirmado. Una consulta SELECT con esas filas se seguiría realizando correctamente en RCSI porque lee una versión de fila en lugar de solicitar un bloqueo compartido. Cuando RCSI elimina el bloqueo de lector-escritor de forma predeterminada, el bloqueo que suele encontrarse en Azure SQL Database implica dos sesiones que necesitan escribir en las mismas filas.
Reconocimiento de escenarios de bloqueo comunes
Comprender por qué se produce el bloqueo le ayuda a evitarlo. El motor de Azure SQL Database administra automáticamente bloqueos, pero determinados patrones conducen a un bloqueo más largo:
Una consulta de larga duración que mantiene bloqueos durante un período prolongado. La consulta se está ejecutando y progresa activamente, pero mantiene bloqueos en todo momento. Otras sesiones que necesitan bloqueos en conflicto en los mismos recursos esperan hasta que finaliza la consulta. Para resolver este problema, busque formas de optimizar la consulta, como agregar índices o volver a escribirla para tocar menos filas.
Una sesión inactiva con una transacción no confirmada. Una sesión ejecuta una instrucción dentro de una transacción explícita y luego deja de ejecutarse, pero nunca llega a confirmarse ni a revertirse. Los bloqueos de la transacción permanecen indefinidamente. Este problema suele ocurrir cuando una aplicación experimenta un tiempo de espera o una cancelación de consulta, pero no emite un ROLLBACK correspondiente. Use SET XACT_ABORT ON para que los errores en tiempo de ejecución revierten automáticamente la transacción.
Una sesión que no recuperó todas las filas de resultados. Una aplicación envía una consulta, pero no recupera todas las filas del conjunto de resultados. Los bloqueos se pueden mantener en las filas que aún no se han recuperado. Asegúrese de que su aplicación recupere todas las filas de resultados completamente.
Una sesión en un estado de reversión. Una consulta que finalizó (con KILL o por un interbloqueo) está revirtiendo sus cambios. La reversión puede llevar mucho tiempo cuando se trata de modificaciones grandes, mientras que la sesión continúa manteniendo bloqueos durante este proceso. Espere a que se complete la reversión y evite modificaciones de lotes grandes durante períodos de alta actividad.
Una conexión huérfana. Una aplicación cliente se bloquea o se reinicia una estación de trabajo sin cerrar limpiamente la conexión de la base de datos. El servidor no detecta inmediatamente la desconexión, por lo que los bloqueos de esa sesión permanecen mantenidos. Termine la sesión huérfana con KILL <session_id>;.
Nota:
Dos de estos escenarios se mitigan en Azure SQL Database de forma predeterminada. RCSI reduce el impacto de las filas de resultados no recuperadas porque las consultas SELECT no adquieren bloqueos compartidos en el control de versiones de fila, por lo que las filas no recuperadas no bloquean los escritores. La recuperación acelerada de bases de datos (ADR) hace que las reversiones largas sean poco frecuentes, ya que pueden deshacer los cambios casi instantáneamente, independientemente del tamaño de la transacción. Los tres escenarios restantes (consultas de larga duración, sesiones inactivas con transacciones no confirmadas y conexiones huérfanas) siguen siendo totalmente relevantes porque implican bloqueos de escritura exclusivos que RCSI y ADR no pueden liberar antes.
Resolución del bloqueo activo
Cuando encuentre bloqueo activo:
- Identifique el bloqueador de cabeza mediante la consulta DMV mostrada anteriormente.
- Determine si la transacción de la sesión de bloqueo puede finalizar por sí sola o si está esperando una entrada externa.
- Si la sesión de bloqueo es una conexión huérfana o abandonada, termínala utilizando
KILL <session_id>; - Revise el plan de ejecución de la consulta de bloqueo para ver las oportunidades de optimización, como los índices que faltan.
Para evitar que el bloqueo sea periódico, mantenga las transacciones cortas. Ejecute solo las instrucciones mínimas necesarias dentro de una transacción y confirme inmediatamente. Utilice SET XACT_ABORT ON en el código de su aplicación para que cualquier error en tiempo de ejecución revierta automáticamente toda la transacción, lo que impide que las transacciones a medio completar mantengan bloqueos indefinidamente. Mueva toda la lógica orientada al usuario fuera de los límites de transacción.
Interbloqueos
El deadlock se produce cuando dos o más transacciones forman una dependencia circular. Cada transacción contiene un bloqueo que los otros necesitan, y ninguna de las dos puede continuar. Este es un ejemplo concreto:
- La transacción A actualiza la fila 1 y adquiere un bloqueo exclusivo.
- La transacción B actualiza la fila 2 y adquiere un bloqueo exclusivo.
- La transacción A intenta actualizar la fila 2 y está bloqueada por la transacción B.
- La transacción B intenta actualizar la fila 1 y está bloqueada por la transacción A.
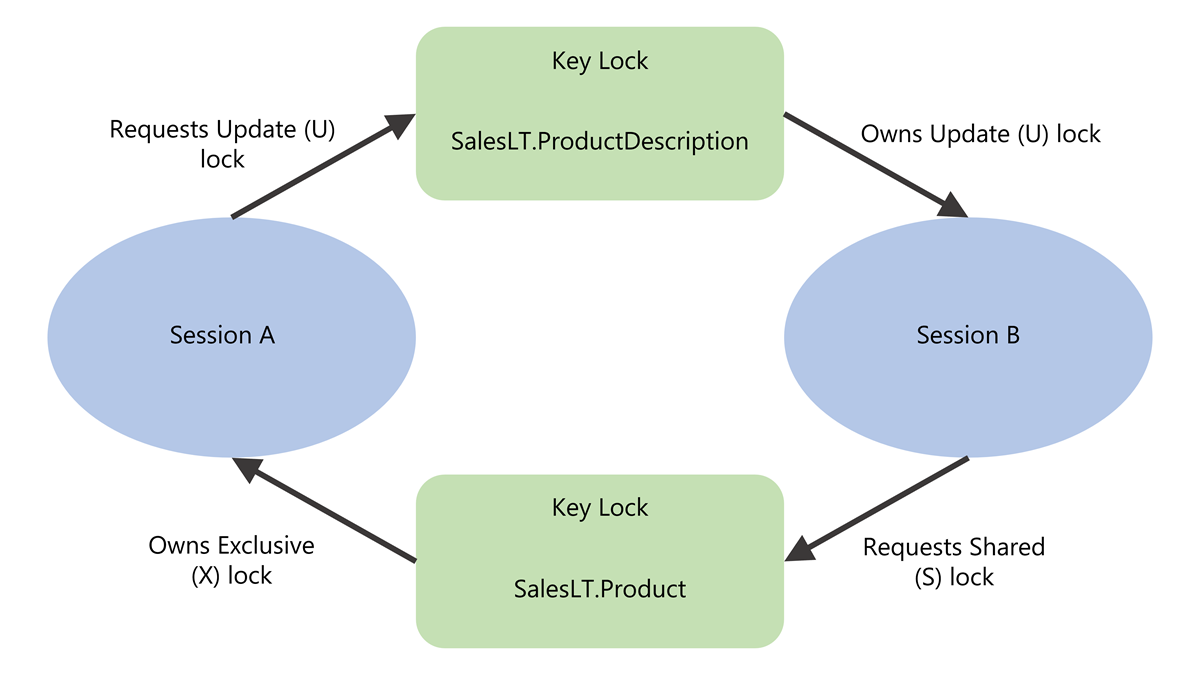
Ninguna transacción puede finalizar. El monitor de interbloqueo del motor de base de datos comprueba periódicamente estos ciclos, con un intervalo predeterminado de cinco segundos que cae a un mínimo de 100 milisegundos cuando los interbloqueos son frecuentes. Cuando detecta un ciclo, elige la transacción que es menos costosa para revertirla como víctima, la revierte y devuelve el error 1205 a la aplicación. Esta reversión permite a la otra transacción finalizar.
Captura de información de interbloqueo
En SQL Server y Azure SQL Managed Instance, la system_health sesión de eventos extendidos captura eventos de interbloqueo de forma predeterminada. Puede consultar el informe de interbloqueo desde su búfer circular utilizando sys.dm_xe_session_targets y sys.dm_xe_sessions.
En Azure SQL Database, el enfoque es diferente. Puede crear una sesión de eventos extendidos personalizada que capture el evento sqlserver.database_xml_deadlock_report y lo consulte mediante las VMD sys.dm_xe_database_sessions y sys.dm_xe_database_session_targets con ámbito de base de datos. En el ejemplo siguiente se crea una sesión de captura de interbloqueos y se consulta su búfer circular:
-- Create and start the session
CREATE EVENT SESSION [deadlocks] ON DATABASE
ADD EVENT sqlserver.database_xml_deadlock_report
ADD TARGET package0.ring_buffer
WITH (STARTUP_STATE = ON, MAX_MEMORY = 4 MB);
GO

ALTER EVENT SESSION [deadlocks] ON DATABASE STATE = START;
GO

-- Query deadlock events from the ring buffer
DECLARE @tracename sysname = N'deadlocks';

SELECT
    d.value('(/event/@timestamp)[1]', 'datetime2') AS deadlock_time,
    d.query('/event/data[@name=''xml_report'']/value/deadlock') AS deadlock_xml
FROM (
    SELECT CAST(target_data AS XML) AS rb
    FROM sys.dm_xe_database_sessions AS s
    INNER JOIN sys.dm_xe_database_session_targets AS t
        ON CAST(t.event_session_address AS BINARY(8)) = CAST(s.address AS BINARY(8))
    WHERE s.name = @tracename
        AND t.target_name = N'ring_buffer'
) AS ring_buffer
CROSS APPLY rb.nodes(
    '/RingBufferTarget/event[@name=''database_xml_deadlock_report'']'
) AS xevent(d)
ORDER BY deadlock_time DESC;
El gráfico de interbloqueo incluye tres secciones. La lista de víctimas identifica qué transacción se ha terminado. La lista de procesos muestra cada proceso implicado, incluido el texto de la consulta, el nivel de aislamiento y el modo de bloqueo. La lista de recursos muestra los recursos bloqueados y qué proceso posee y espera en cada uno.
En Azure SQL Database, también puede configurar alertas de interbloqueo a través de Azure Portal para recibir notificaciones cuando se produzcan interbloqueos.
Evitar interbloqueos
No puede eliminar todos los interbloqueos, pero puede reducir significativamente la frecuencia con la que se producen:
- Obtener acceso a objetos en un orden coherente: si todas las transacciones modifican la tabla A antes de la tabla B, las dependencias circulares no se pueden formar. Normalice los patrones de acceso a través de procedimientos almacenados.
- Mantener las transacciones cortas: las transacciones más cortas mantienen los bloqueos durante menos tiempo, lo que reduce la posibilidad de dependencias circulares.
- Usar niveles de aislamiento de control de versiones de fila: RCSI elimina los bloqueos compartidos para las operaciones de lectura, lo que elimina un origen común de ciclos de interbloqueo. El bloqueo optimizado en Azure SQL Database reduce aún más la probabilidad de interbloqueo.
- Agregar índices adecuados: cuando las consultas analizan muchas filas, adquieren bloqueos en una amplia gama de datos. Agregar índices que restrinjan el análisis a menos filas reduce los conflictos de bloqueo.
- Usar el forzado de un plan con el almacén de consultas: si un cambio de plan provocó que una consulta analizara más filas y adquiriera más bloqueos, forzar el plan anterior puede reducir los interbloqueos mientras investiga.
Manejo de interbloqueos en el código de la aplicación
Las aplicaciones siempre deben incluir lógica de reintento para los errores de interbloqueo. Cuando se elige una transacción como víctima de un interbloqueo, el motor de base de datos la revierte y devuelve el error 1205. La aplicación debe detectar este error, pausar brevemente y volver a enviar la transacción.
BEGIN TRY
    BEGIN TRANSACTION;
    -- Your data modification statements
    COMMIT TRANSACTION;
END TRY
BEGIN CATCH
    IF ERROR_NUMBER() = 1205
    BEGIN
        ROLLBACK TRANSACTION;
        WAITFOR DELAY '00:00:01';  -- Brief pause before retry
        -- Retry logic here
    END
    ELSE
    BEGIN
        ROLLBACK TRANSACTION;
        THROW;
    END
END CATCH;
Sugerencia
Aleatorice el retardo entre intentos para evitar que las mismas dos transacciones vuelvan a bloquearse inmediatamente. Un patrón común es esperar entre uno y tres segundos con un componente aleatorio.
Conclusiones clave
El bloqueo es normal, pero el bloqueo extendido afecta a los usuarios, por lo que usas sys.dm_exec_requests para encontrar el bloqueador principal y comprender lo que está haciendo. Entre los escenarios comunes se incluyen consultas de larga duración, sesiones inactivas con transacciones no confirmadas y conexiones huérfanas, todas las cuales aborda manteniendo las transacciones cortas, usando SET XACT_ABORT ON y garantizando que las aplicaciones administren correctamente las conexiones y los conjuntos de resultados. Los interbloqueos se forman cuando las transacciones crean dependencias de bloqueo circular y el motor de base de datos las resuelve automáticamente finalizando la transacción menos costosa y devolviendo el error 1205. Puede reducir reduce la frecuencia de interbloqueos accediendo a los objetos en un orden coherente, manteniendo las transacciones cortas, utilizando niveles de aislamiento de control de versiones de fila y agregando índices adecuados. El código de la aplicación siempre debe incluir lógica de reintento para el error 1205 para que pueda recuperarse automáticamente cuando se elija como víctima de interbloqueo.