Nota
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Esta página describe cómo ingerir datos en Databricks Lakeflow Connect utilizando APIs SQL y Spark, que ofrecen mayores niveles de personalización de la tubería de ingestión en comparación con los conectores gestionados. Úsalo para elegir un enfoque de ingestión por fuente de datos y nivel de personalización de la canalización.
Capas de la pila ETL
Algunos conectores funcionan en un nivel de la pila ETL. Por ejemplo, Databricks ofrece conectores totalmente administrados para aplicaciones empresariales como Salesforce y bases de datos como SQL Server. Otros conectores operan en varias capas de la pila ETL. Por ejemplo, puedes usar APIs SQL y Spark tanto en Structured Streaming para personalización completa como en pipelines Lakeflow para una experiencia más gestionada.
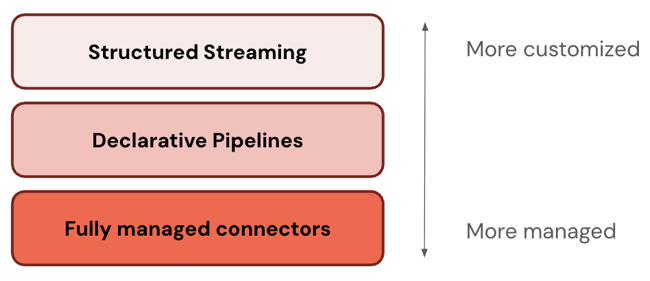
Databricks recomienda empezar con la capa más administrada. Si no cumple los requisitos (por ejemplo, si no es compatible con el origen de datos), vaya a la siguiente capa.
En la tabla siguiente se describen las tres capas de productos de ingesta, ordenados de la mayoría personalizables a la mayoría administrados:
| Nivel | Descripción |
|---|---|
| Transmisión estructurada | Apache Spark Structured Streaming es un motor de streaming que ofrece tolerancia a errores de un extremo a otro con garantías de procesamiento exactamente una vez mediante las API de Spark. |
| Canalizaciones de Lakeflow | Las canalizaciones de Lakeflow amplían Structured Streaming, ofreciendo un marco declarativo para crear canalizaciones de datos. Puede definir las transformaciones que se van a realizar en los datos y las canalizaciones de Lakeflow administran la orquestación, la supervisión, la calidad de los datos, los errores, etc. Ofrecen más automatización y menos sobrecarga que Structured Streaming. |
| Conectores administrados | Los conectores totalmente administrados se integran en las canalizaciones de Lakeflow y ofrecen aún más automatización para las fuentes de datos más populares. Amplían la funcionalidad de canalizaciones de Lakeflow para incluir también autenticación específica del origen, CDC, control de casos perimetrales, mantenimiento de API a largo plazo, reintentos automatizados, evolución automatizada del esquema, etc. Por lo tanto, ofrecen aún más automatización para los orígenes de datos admitidos. |
Elegir una opción
La siguiente tabla enumera las opciones de ingestión de SQL y Spark por fuente de datos y nivel de personalización de la canalización. Para una experiencia de ingesta totalmente automatizada, use conectores administrados en su lugar.
Ejemplos de SQL para la ingesta incremental desde el almacenamiento de objetos en la nube usan la sintaxis CREATE STREAMING TABLE. Ofrece a los usuarios de SQL una experiencia de ingesta escalable, por lo que es la alternativa recomendada a COPY INTO.
| Fuente | Más personalización | Algunas personalizaciones | Más automatización |
|---|---|---|---|
| Almacenamiento de objetos en la nube |
Cargador automático con streaming estructurado (Python, Scala) |
Cargador automático con canalizaciones de Lakeflow (Python, SQL) |
Cargador automático con Databricks SQL (SQL) |
| Servidores SFTP |
Ingesta de archivos de servidores SFTP (Python, SQL) |
N/A | N/A |
| Apache Kafka |
Structured Streaming con la fuente de Kafka (Python, Scala) |
Canalizaciones de Lakeflow con origen en Kafka (Python, SQL) |
Databricks SQL con fuente Kafka (SQL) |
| Google Pub/Sub |
Structured Streaming con fuente Pub/Sub (Python, Scala) |
Canalizaciones de Lakeflow con origen Pub/Sub (Python, SQL) |
Databricks SQL con origen Pub/Sub (SQL) |
| Apache Pulsar |
Structured Streaming with Pulsar source (Streaming estructurado con origen de Pulsar) (Python, Scala) |
Canalizaciones de Lakeflow con fuente Pulsar (Python, SQL) |
Databricks SQL con origen Pulsar (SQL) |
Programaciones de ingesta
Puede configurar los pipelines de ingesta para que se ejecuten en una programación recurrente o de forma continua.
| Caso de uso | Modo de canalización |
|---|---|
| Ingesta por lotes | Desencadenado: procesa nuevos datos según una programación o cuando se desencadena manualmente. |
| Ingesta de streaming | Continuo: procesa los nuevos datos a medida que llegan al origen. |