Nota
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
En la ingeniería de datos, el backfilling se refiere al proceso de procesar de manera retroactiva los datos históricos a través de una canalización de datos diseñada para procesar datos actuales o de streaming.
Normalmente, se trata de un flujo independiente que envía datos a las tablas existentes. En la ilustración siguiente se muestra un flujo de reposición que envía datos históricos a las tablas bronce de la canalización.
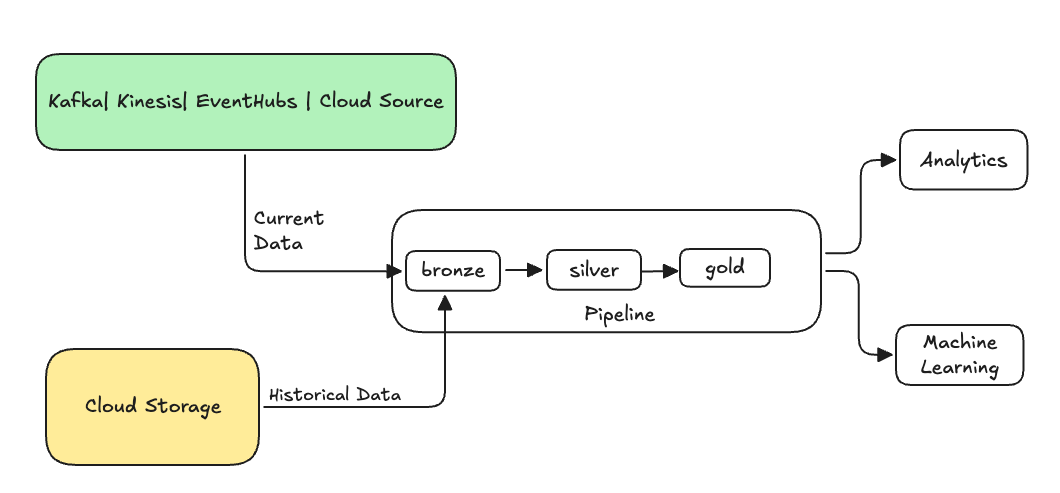
Algunos escenarios que pueden requerir un reposición:
- Procese datos históricos de un sistema heredado para entrenar un modelo de aprendizaje automático (ML) o crear un panel de análisis histórico de tendencias.
- Reprocesar un subconjunto de datos debido a un problema de calidad en las fuentes de datos ascendentes.
- Los requisitos empresariales cambiaron y necesita rerrellenar los datos durante un período de tiempo diferente que no estaba cubierto por la canalización inicial.
- La lógica de negocios ha cambiado y debe volver a procesar los datos históricos y actuales.
El flujo de relleno que usas depende de la tabla objetivo y de los datos fuente. Para un AUTO CDC objetivo de dimensión que cambia lentamente (SCD) Tipo 1 con una instantánea autorizada, se utiliza un flujo único AUTO CDC FROM SNAPSHOT . Para una migración SCD que reproduzca cambios históricos, utiliza un flujo AUTO CDC de una sola vez.
Para rellenos de solo anexado: Utiliza un flujo de anexado especializado con la opción ONCE para rellenar una tabla de streaming de solo anexado. Consulte append_flow o CREATE FLOW (canalizaciones) para obtener más información sobre la ONCE opción.
Consideraciones al reponer datos históricos en una tabla de transmisión
- Normalmente, anexe los datos a la tabla de streaming bronze. Las capas de plata y oro aguas abajo captan los nuevos datos de la capa de bronce.
- Asegúrese de que la canalización puede controlar los datos duplicados correctamente en caso de que los mismos datos se anexen varias veces.
- Asegúrese de que el esquema de datos históricos es compatible con el esquema de datos actual.
- Considera el tamaño del volumen de datos y el acuerdo de nivel de servicio (SLA) de procesamiento requerido, y configura en consecuencia los tamaños del clúster y del lote.
Ejemplo: añadir un relleno a un pipeline existente
En este ejemplo, supongamos que tiene una canalización que ingiere datos de registro de eventos sin procesar desde un origen de almacenamiento en la nube, a partir del 1 de enero de 2025. Más tarde te das cuenta de que quieres rellenar los datos históricos de los tres últimos años para casos de uso de análisis e informes posteriores. Todos los datos están en una ubicación, particionada por año, mes y día, en formato JSON.
Canalización inicial
Este es el código de canalización inicial que ingiere incrementalmente los datos de registro de eventos sin procesar del almacenamiento en la nube.
Pitón
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
incremental_load_path = f"{source_root_path}/*/*/*"

# create a streaming table and the default flow to ingest streaming events
@dp.table(name="registration_events_raw", comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2025-01-01T00:00:00.000+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}") # safeguard to not process data before begin_year
    )
SQL
-- create a streaming table and the default flow to ingest streaming events
CREATE OR REFRESH STREAMING LIVE TABLE registration_events_raw AS
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025'; -- safeguard to not process data before begin_year
Aquí usamos la opción modifiedAfter Auto Loader para asegurarnos de que no estamos procesando todos los datos de la ubicación de almacenamiento en la nube. El procesamiento incremental se corta en ese límite.
Sugerencia
Otros orígenes de datos, como Kafka, Kinesis y Azure Event Hubs, tienen opciones de lector equivalentes para lograr el mismo comportamiento.
Reposición de datos de 3 años anteriores
Ahora quiere agregar uno o varios flujos para rellenar los datos anteriores. En este ejemplo, siga estos pasos:
- Use l flujo
append once. Esto realiza una reposición única sin continuar ejecutándose después de ese rellenado inicial. El código permanece en la canalización, y si esta se actualiza por completo, la reposición de datos se vuelve a ejecutar. - Cree tres flujos de reposición, uno para cada año (en este caso, los datos se dividen por año en la ruta). Para Python, parametrizamos la creación de los flujos, pero en SQL repetimos el código tres veces, una vez para cada flujo.
Si está trabajando en un proyecto propio y no usa computación sin servidor, es posible que quiera actualizar el número máximo de trabajadores de la canalización. Aumentar el número máximo de trabajadores garantiza que tiene los recursos para procesar los datos históricos mientras continúa procesando los datos de streaming actuales dentro del SLA (Acuerdo de Nivel de Servicio) esperado.
Sugerencia
Si usa el proceso sin servidor con el escalado automático mejorado (valor predeterminado), el clúster aumenta automáticamente el tamaño cuando aumenta la carga.
Pitón
from pyspark import pipelines as dp

source_root_path = spark.conf.get("registration_events_source_root_path")
begin_year = spark.conf.get("begin_year")
backfill_years = spark.conf.get("backfill_years") # e.g. "2024,2023,2022"
incremental_load_path = f"{source_root_path}/*/*/*"

# meta programming to create append once flow for a given year (called later)
def setup_backfill_flow(year):
    backfill_path = f"{source_root_path}/year={year}/*/*"
    @dp.append_flow(
        target="registration_events_raw",
        once=True,
        name=f"flow_registration_events_raw_backfill_{year}",
        comment=f"Backfill {year} Raw registration events")
    def backfill():
        return (
            spark
            .read
            .format("json")
            .option("inferSchema", "true")
            .load(backfill_path)
        )

# create the streaming table
dp.create_streaming_table(name="registration_events_raw", comment="Raw registration events")

# append the original incremental, streaming flow
@dp.append_flow(
        target="registration_events_raw",
        name="flow_registration_events_raw_incremental",
        comment="Raw registration events")
def ingest():
    return (
        spark
        .readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .option("cloudFiles.inferColumnTypes", "true")
        .option("cloudFiles.maxFilesPerTrigger", 100)
        .option("cloudFiles.schemaEvolutionMode", "addNewColumns")
        .option("modifiedAfter", "2024-12-31T23:59:59.999+00:00")
        .load(incremental_load_path)
        .where(f"year(timestamp) >= {begin_year}")
    )

# parallelize one time multi years backfill for faster processing
# split backfill_years into array
for year in backfill_years.split(","):
    setup_backfill_flow(year) # call the previously defined append_flow for each year
SQL
-- create the streaming table
CREATE OR REFRESH STREAMING TABLE registration_events_raw;

-- append the original incremental, streaming flow
CREATE FLOW
  registration_events_raw_incremental
AS INSERT INTO
  registration_events_raw BY NAME
SELECT * FROM STREAM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/*/*/*",
  format => "json",
  inferColumnTypes => true,
  maxFilesPerTrigger => 100,
  schemaEvolutionMode => "addNewColumns",
  modifiedAfter => "2024-12-31T23:59:59.999+00:00"
)
WHERE year(timestamp) >= '2025';


-- one time backfill 2024
CREATE FLOW
  registration_events_raw_backfill_2024
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2024/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2023
CREATE FLOW
  registration_events_raw_backfill_2023
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2023/*/*",
  format => "json",
  inferColumnTypes => true
);

-- one time backfill 2022
CREATE FLOW
  registration_events_raw_backfill_2022
AS INSERT INTO ONCE
  registration_events_raw BY NAME
SELECT * FROM read_files(
  "/Volumes/gc/demo/apps_raw/event_registration/year=2022/*/*",
  format => "json",
  inferColumnTypes => true
);
Esta implementación resalta varios patrones importantes.
Separación de responsabilidades
- El procesamiento incremental es independiente de las operaciones de reposición.
- Cada flujo tiene su propia configuración y configuración de optimización.
- Hay una distinción clara entre las operaciones incrementales y de reposición.
Ejecución controlada
- El uso de la
ONCEopción garantiza que cada reposición se ejecute exactamente una vez. - El flujo de reposición permanece en el gráfico de canalización, pero después de completarse, se vuelve inactivo. Está listo para su uso en la actualización completa, automáticamente.
- Hay una pista de auditoría clara de las operaciones de reposición en la definición de la canalización.
Optimización del procesamiento
- Puede dividir las reposiciones grandes en varias reposiciones más pequeñas para acelerar el procesamiento o para tener más control sobre el procesamiento.
- El escalado automático mejorado escala dinámicamente el tamaño del clúster en función de la carga del clúster actual.
Evolución del esquema
- Usar
schemaEvolutionMode="addNewColumns"maneja los cambios de esquema adecuadamente. - Usted dispone de una inferencia de esquema consistente en los datos históricos y actuales.
- Hay un control seguro de las nuevas columnas en los datos más recientes.
Añadir un backfill a una tabla AUTO CDC SCD Tipo 1
Utiliza un flujo único AUTO CDC FROM SNAPSHOT para añadir una instantánea autorizada a un destino SCD Tipo 1 que también recibe una fuente continua de captura de datos de cambios (CDC). La versión de instantánea y la columna de secuenciación de CDC forman un dominio de ordenación. Un evento CDC más reciente tiene prioridad sobre una instantánea antigua, mientras que una instantánea más reciente tiene prioridad sobre un evento CDC antiguo.
Requirements
Antes de añadir el relleno, asegúrate de que los caudales cumplan los siguientes requisitos:
- El destino utiliza SCD Tipo 1.
- El objetivo tiene exactamente un flujo
AUTO CDC FROM SNAPSHOTy uno o más flujosAUTO CDCcon nombres únicos. - Todos los flujos usan el mismo número de claves en el mismo orden. Los nombres de las claves del flujo de instantáneas se comparan sin distinguir entre mayúsculas y minúsculas con los nombres de las claves de
AUTO CDC. Los flujos múltiplesAUTO CDCdeben usar nombres de clave y casing idénticos. - La versión snapshot y cada columna de secuenciación de CDC tienen exactamente el mismo tipo de datos.
- El
AUTO CDC FROM SNAPSHOTflujo no define las expectativas. - Los
AUTO CDCflujos no utilizanIGNORE NULL UPDATES. En Python, no definaignore_null_updates,ignore_null_updates_column_listniignore_null_updates_except_column_list. - La canalización utiliza el modo activado. Este patrón no soporta pipelines continuos.
Ambos tipos de flujo pueden usar la interfaz de pipeline SQL o Python. Puedes mezclar flujos SQL y Python en el mismo destino.
La instantánea debe representar el estado completo de la fuente en su versión. Si falta una clave destino en la instantánea, AUTO CDC FROM SNAPSHOT considera la ausencia como una eliminación en la versión de la instantánea. Un evento CDC con una versión más reciente preserva o restaura la clave.
Añade el backfill
Para añadir un relleno de instantánea de una sola vez y continuar procesando eventos CDC, sigue estos pasos:
- Mantenga la tabla de destino existente y sus flujos
AUTO CDCen curso en la definición del pipeline. - Defina la instantánea de referencia y su versión. Para una callback en Python, la primera invocación debe devolver una instantánea y una versión. Devuelve
Nonesolo después de que al menos una instantánea haya sido procesada. - Añade un
AUTO CDC FROM SNAPSHOTflujo cononce=Trueen Python oONCESQL. Para un relleno de datos SQL en un destino existente, incluya una consultaWITH VERSION. Un flujo de instantáneas SQL sinWITH VERSIONsolo admite una carga inicial en un destino vacío. - Ejecute una actualización del pipeline activada para procesar el relleno de datos y los eventos de CDC en curso.
El siguiente ejemplo comienza con una tubería de Python existente que procesa cambios de forma incremental de customers_cdc. Supongamos que ya has ejecutado este pipeline y rellenado el destino customers:
from pyspark import pipelines as dp
from pyspark.sql.functions import col, expr

@dp.view
def customers_cdc():
    return (
        spark.readStream.table("main.bronze.customers_cdc")
        .withColumn("change_timestamp", col("change_timestamp").cast("timestamp"))
    )


dp.create_streaming_table("customers")

dp.create_auto_cdc_flow(
    name="customers_incremental_cdc",
    target="customers",
    source="customers_cdc",
    keys=["customer_id"],
    sequence_by=col("change_timestamp"),
    apply_as_deletes=expr("operation = 'DELETE'"),
    except_column_list=["operation", "change_timestamp"],
    stored_as_scd_type=1,
)
Para rellenar ese destino existente con el estado de customers_snapshot a fecha de 1 de enero de 2025, añada el siguiente código a la misma definición del pipeline. Mantenga la tabla de destino existente y el flujo AUTO CDC:
from datetime import datetime, timezone
from typing import Optional, Tuple

from pyspark.sql import DataFrame

backfill_version = datetime(2025, 1, 1, tzinfo=timezone.utc)


def backfill_snapshot_and_version(
    latest_snapshot_version: Optional[datetime],
) -> Optional[Tuple[DataFrame, datetime]]:
    if latest_snapshot_version is None:
        return (spark.read.table("main.legacy.customers_snapshot"), backfill_version)
    return None


dp.create_auto_cdc_from_snapshot_flow(
    target="customers",
    source=backfill_snapshot_and_version,
    keys=["customer_id"],
    stored_as_scd_type=1,
    once=True,
)
La callback debe devolver una instantánea y una versión en su primera invocación. Si regresa None antes de que se procese cualquier snapshot, la actualización de la canalización falla. Después de procesar la instantánea, devolver None indica que no hay instantáneas adicionales disponibles.
La versión snapshot es un datetime de Python, que corresponde al tipo TIMESTAMP de Spark SQL. El flujo AUTO CDC existente convierte change_timestamp a TIMESTAMP para que los dos tipos de secuenciación coincidan exactamente. El ejemplo usa Python para ambos flujos, pero puedes definir cualquiera de los dos flujos en SQL y mezclar flujos SQL y Python en el mismo objetivo. Para la sintaxis SQL, incluyendo la consulta requerida WITH VERSION para un destino no vacío, véase CREATE FLOW (pipelines).
Una vez que el flujo de instantánea se haya confirmado correctamente, las actualizaciones incrementales posteriores lo omitirán, mientras que el flujo AUTO CDC seguirá procesando nuevos eventos.
Important
Una actualización completa del destino vuelve a ejecutar el flujo de instantáneas único. Mantén la instantánea disponible y asegúrate de que sigue representando el estado previsto antes de realizar una actualización completa.
Este patrón unificado de relleno no soporta objetivos SCD Tipo 2 ni bitemporales.
Ejemplo: Reposición de un destino SCD durante una migración
Un escenario común de migración es una tabla de dimensiones que cambian lentamente (SCD) que ya existe en un sistema heredado con años de historia acumulada, pero cuya fuente de cambios original ya no está disponible. Dado que los eventos de cambio originales han desaparecido, lo que se hace es reproducir el historial de la tabla heredada en la nueva tabla de destino AUTO CDC una sola vez y, a continuación, conectar una nueva fuente de CDC para el futuro. Para obtener más información sobre AUTO CDC y los tipos SCD, consulta Las API de AUTO CDC: simplifican la captura de datos de cambios con canalizaciones.
El patrón es un flujo puntual AUTO CDC hacia la misma tabla de streaming a la que se dirige el flujo continuo AUTO CDC. Un AUTO CDC destino acepta solo flujos AUTO CDC, por lo que la semilla también debe ser un flujo AUTO CDC. Un flujo de adición simple INSERT INTO ONCE en la misma tabla no valida:
-
Cree la tabla de streaming de destino en la que escribe su flujo
AUTO CDC. -
Inicializa el historial heredado una vez con un
AUTO CDC ONCEflujo que lee la tabla SCD heredada como un flujo, secuenciado por la columna de inicio de validez heredada. Reproduzca las filas heredadas como eventos de cambio en lugar de darles forma usted mismo.AUTO CDCcrea las columnas de historial de__START_ATy__END_ATpara un destino SCD de tipo 2, así que no escriba esas columnas directamente. -
Adjunte el flujo continuo
AUTO CDCque lee la fuente de cambios actualizada.AUTO CDCresuelve el orden para cada clave, por lo que la transición debe cumplirse para cada clave de negocio por separado: el primer cambio en producción de cada clave debe producirse después del último cambio generado a partir de datos semilla de esa misma clave. Un valor de secuencia que es simplemente posterior al máximo global de legado puede seguir siendo obsoleto para una clave individual, y el primer cambio en vivo de esa clave se ignora o ordena incorrectamente.
El siguiente código crea una tabla de streaming que sigue los pasos anteriores:
CREATE OR REFRESH STREAMING TABLE customers_history;

-- One-time seed: replay the legacy history as change events
CREATE FLOW customers_history_seed
AS AUTO CDC ONCE INTO customers_history
FROM stream(legacy.customers_scd2)
KEYS (customer_id)
SEQUENCE BY valid_from
STORED AS SCD TYPE 2;

-- Ongoing live CDC into the same target
CREATE FLOW customers_history_cdc
AS AUTO CDC INTO customers_history
FROM stream(customers_cdc_bronze)
KEYS (customer_id)
SEQUENCE BY change_timestamp
STORED AS SCD TYPE 2;
Ambos flujos deben coincidir en sus claves, su tipo SCD y el tipo de datos de su columna de secuenciación. En el ejemplo anterior, ambos flujos se secuencian según una marca de tiempo, que utiliza un único momento de corte para separar el historial inicial de la fuente en directo. Si las secuencias de la tabla heredada tienen un valor de un tipo diferente al de la transmisión en directo, emite una de ellas para que los tipos coincidan.
La misma forma funciona para un objetivo SCD Tipo 1: cambia STORED AS SCD TYPE 2 a STORED AS SCD TYPE 1 en ambos flujos, y el objetivo mantiene solo la fila actual por clave. Antes de basarse en cualquiera de las dos estructuras, valide con una muestra de claves que el primer cambio en producción de una clave inicializada produzca exactamente una nueva versión y cierre correctamente la versión anterior. Suele aparecer un desfase en la secuencia de teclas en ese paso.
Recursos adicionales
- Cargue y procese datos de forma incremental con los flujos de canalización de Lakeflow
- Use flujos en las canalizaciones de Lakeflow
- Las API AUTO CDC: simplifican la captura de datos modificados con canalizaciones
- append_flow
- create_auto_cdc_from_snapshot_flow
- create_auto_cdc_flow
- CREATE FLOW (canalizaciones)