Nota
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
La ejecución de consultas adaptables (AQE) es la reoptimización de consultas que se produce durante el procesamiento de consultas.
Antes de que se ejecute una consulta, el optimizador elige un plan de consulta basado en estimaciones del tamaño de los datos. Esas estimaciones pueden ser erróneas si faltan estadísticas de tabla o están obsoletas, si los datos están sesgados o en etapas posteriores de una consulta compleja. Un plan basado en estimaciones erróneas podría usar una estrategia de join lenta, crear demasiadas tareas pequeñas tras un shuffle, o crear algunas tareas sobredimensionadas que retrasen toda la etapa. AQE soluciona estos problemas reoptimizando el plan mientras se ejecuta la consulta, basándose en el tamaño real de los datos.
Al final de cada shuffle o intercambio de broadcast, Azure Databricks ofrece estadísticas precisas de los datos producidos hasta el momento. AQE utiliza estas estadísticas para elegir una mejor estrategia física, elegir un número y tamaño óptimos de particiones posteriores a la reorganización, o aplicar optimizaciones que de otro modo requieren sugerencias de consulta, como el manejo de skew joins.
AQE está habilitado de forma predeterminada. No necesitas cambiar tus consultas para beneficiarte de ello. Comprueba si AQE ha cambiado un plan de consulta al diagnosticar una consulta lenta. Ajusta los ajustes de AQE solo cuando los valores predeterminados no se ajusten a tu carga de trabajo. Consulte Planes de consulta y Configuración.
Capacidades
AQE tiene cuatro características principales:
- Cambia dinámicamente la combinación de combinación de ordenación en combinación hash de difusión.
- Fusiona las particiones de manera dinámica (las particiones pequeñas en otras de tamaño razonable) después del intercambio aleatorio. Las tareas muy pequeñas tienen un rendimiento de E/S peor y tienden a sufrir más de la sobrecarga de programación y la sobrecarga de configuración de tareas. La combinación de tareas pequeñas ahorra recursos y mejora el rendimiento del clúster.
- Controla dinámicamente el sesgo en la fusión mediante combinación de ordenación y la combinación de hash aleatoria mediante la división (y replicación si es necesario) de las tareas sesgadas en tareas de tamaño uniforme aproximadamente.
- Detecta y propaga dinámicamente relaciones vacías, que son partes de una consulta que no devuelven filas.
Consultas admitidas
AQE se aplica a consultas que cumplen ambas condiciones:
- La consulta no es una consulta de streaming.
- La consulta contiene al menos un exchange (normalmente de un join, agregado o ventana), al menos una subconsulta, o ambas.
AQE reoptimiza cada consulta soportada, pero el resultado podría ser el mismo plan que el optimizador compiló antes de que se ejecutara la consulta. Para comprobar si AQE cambió el plan de una consulta, consulte Planes de consulta.
Planes de consulta
Las consultas aplicadas a AQE contienen uno o varios AdaptiveSparkPlan nodos, normalmente como nodo raíz de cada consulta principal o subconsulta. Cada nodo AdaptiveSparkPlan tiene un indicador isFinalPlan. La bandera aparece false antes y durante la ejecución de la consulta, y cambia a true cuando termina la consulta.
Para ver un plan de consulta, utiliza la interfaz de Spark, DataFrame.explain(), o SQL EXPLAIN. Cada uno muestra información diferente sobre cómo AQE cambia el plan.
Interfaz de usuario de Spark
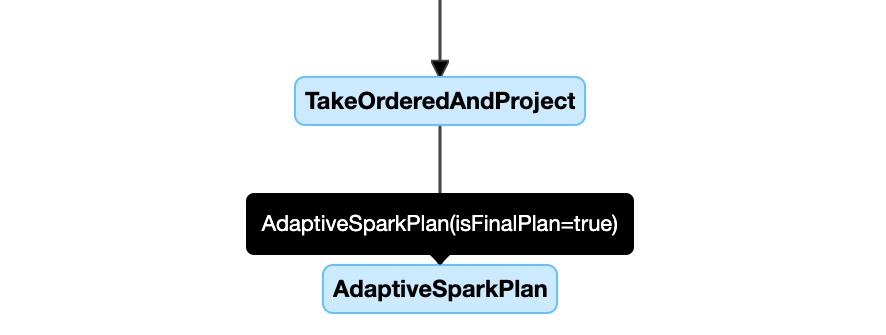
El diagrama del plan de consulta en la interfaz de Spark muestra el plan más reciente y se actualiza a medida que se ejecuta la consulta. Los nodos que ya se han ejecutado y tienen métricas no cambian. Los nodos que aún no se han ejecutado podrían cambiar a medida que AQE reoptimice el plan.
Este ejemplo muestra un diagrama de plan de consulta:
DataFrame.explain()
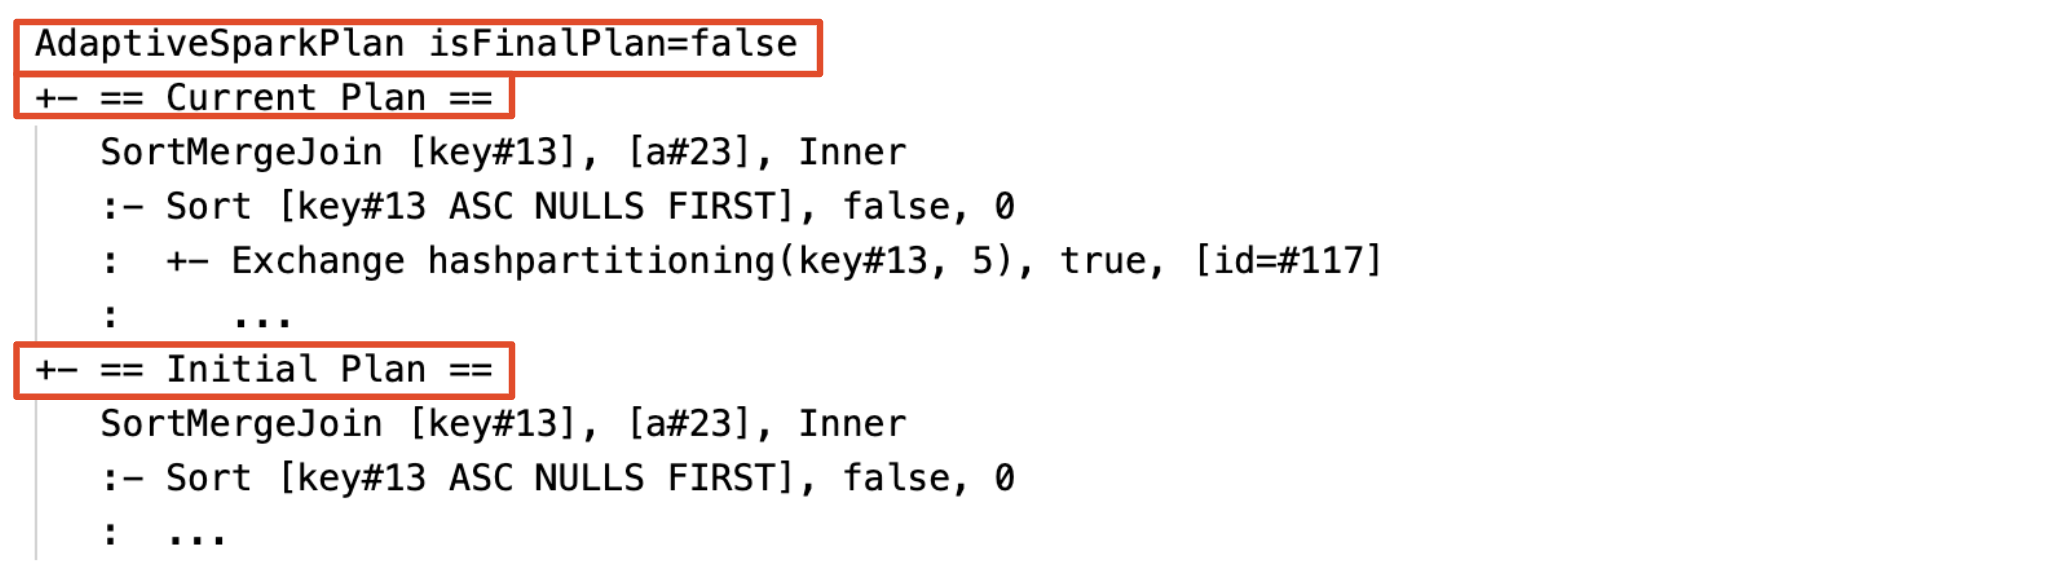
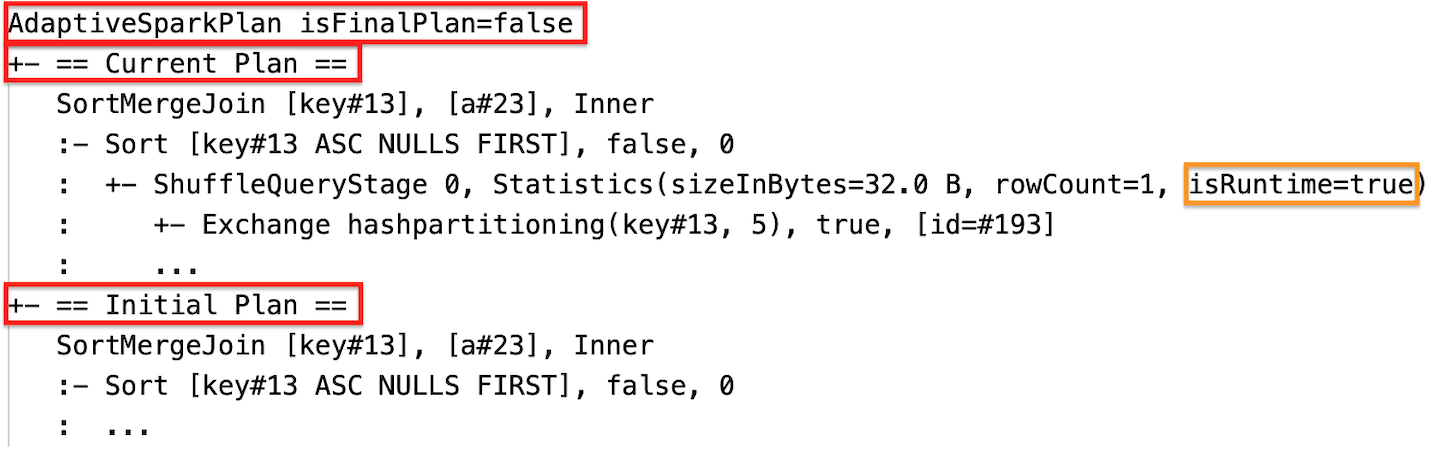
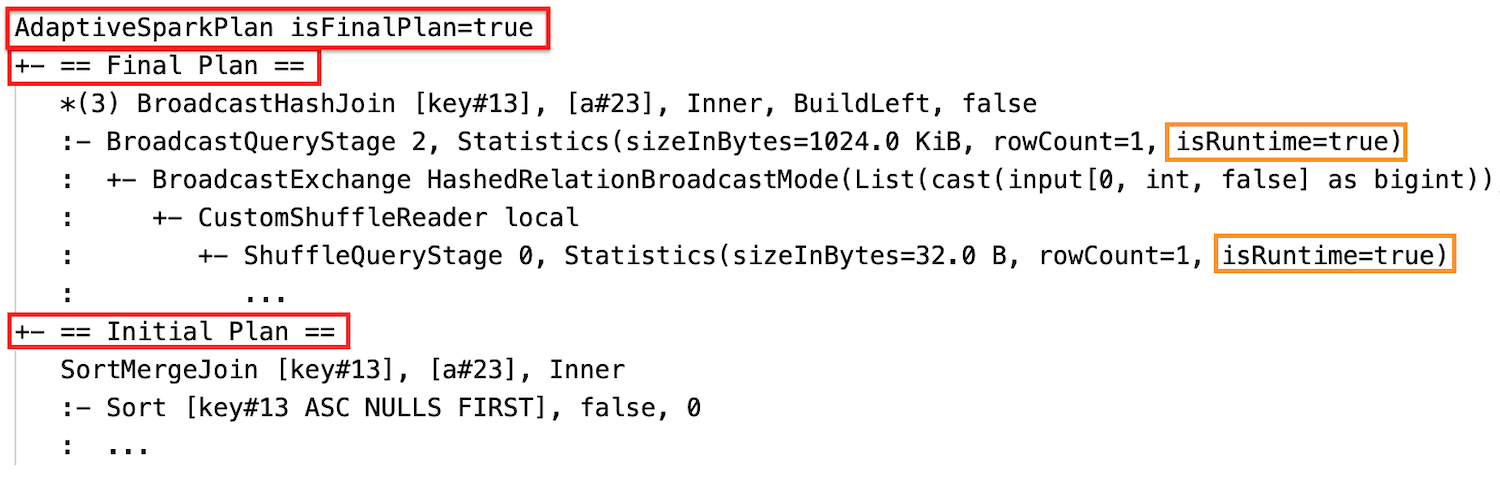
DataFrame.explain() muestra dos planes bajo cada nodo AdaptiveSparkPlan: el plan inicial, antes de que AQE aplique cualquier optimización, y el plan actual. El plan actual cambia a medida que se ejecuta la consulta y se convierte en el plan final cuando termina la consulta.
La salida incluye estadísticas de datos para cada etapa de mezcla y de difusión. Las estadísticas dependen de si la etapa se ha ejecutado:
- Antes y durante la ejecución de etapas,
isRuntimeestáfalsey las estadísticas son estimaciones en tiempo de compilación. Por ejemplo:Statistics(sizeInBytes=1024.0 KiB, rowCount=4, isRuntime=false). - Después de que se ejecute la etapa,
isRuntimeestátruey las estadísticas son mediciones de tiempo de ejecución. Por ejemplo:Statistics(sizeInBytes=658.1 KiB, rowCount=2.81E+4, isRuntime=true).
Estas capturas muestran DataFrame.explain() la salida antes, durante y después de la ejecución:
Antes de la ejecución
Durante la ejecución
Después de la ejecución
SQL EXPLAIN
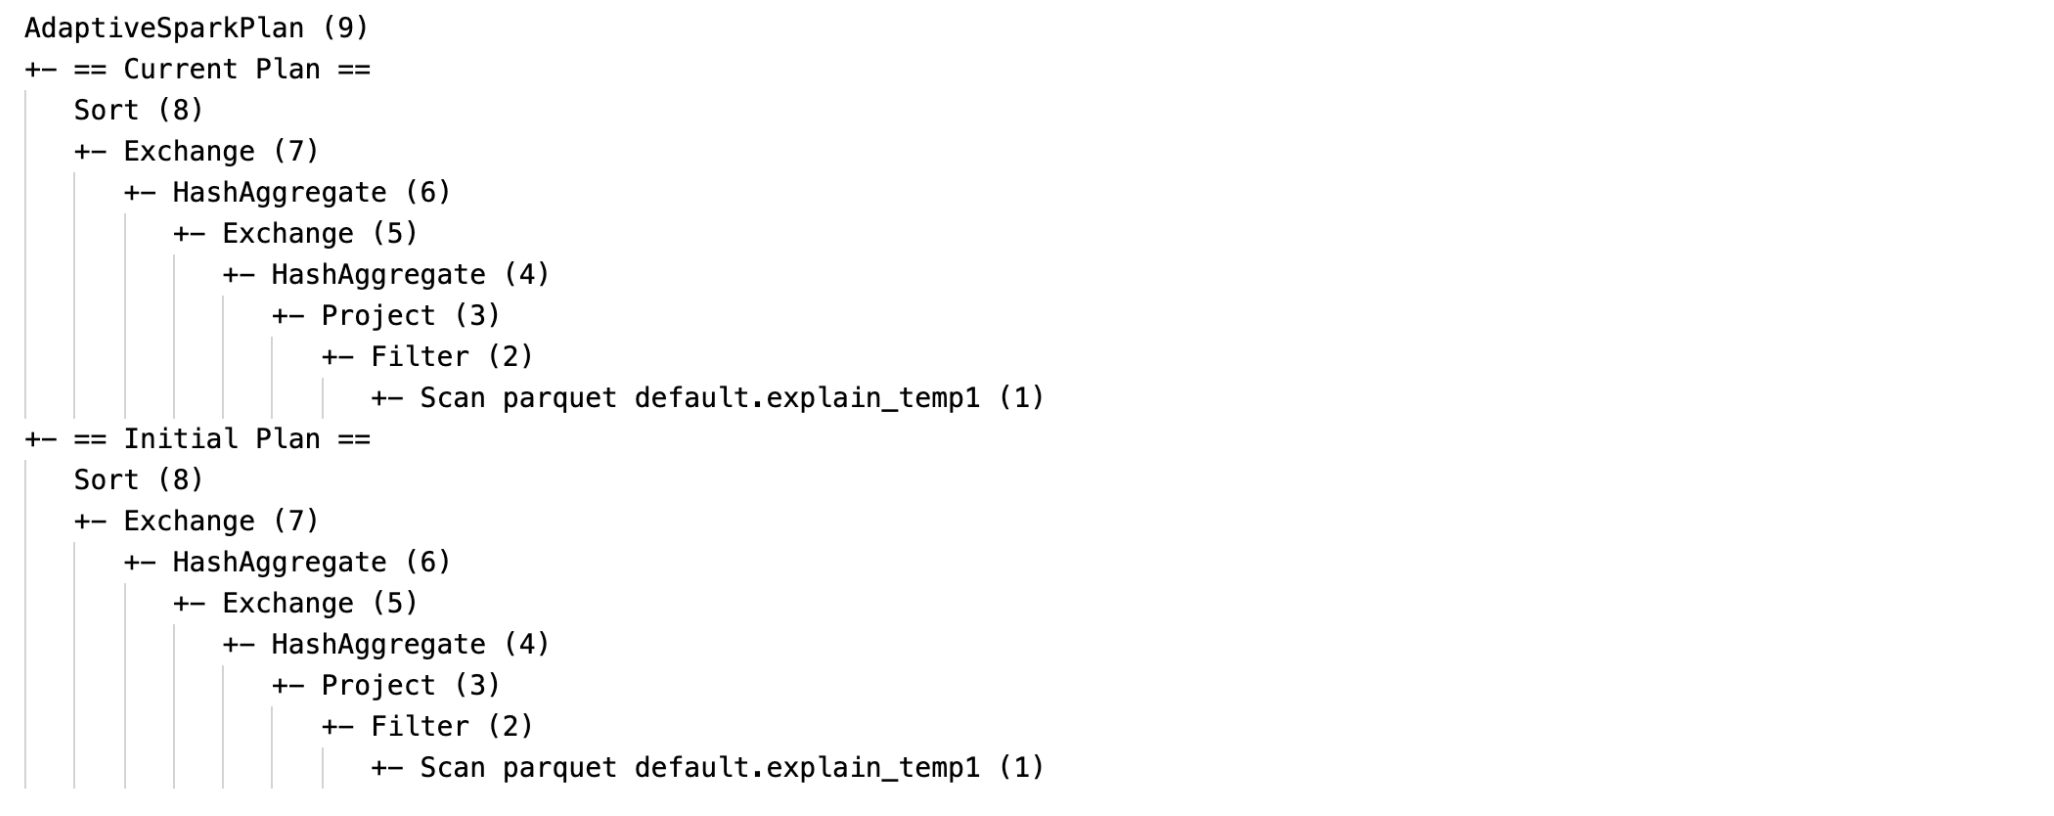
SQL EXPLAIN no ejecuta la consulta, así que AQE no puede reoptimizarla. El resultado muestra solo el plan inicial, que podría diferir del plan que ejecuta AQE.
Este ejemplo muestra SQL EXPLAIN la salida:
Identificar optimizaciones aplicadas en un plan de consulta
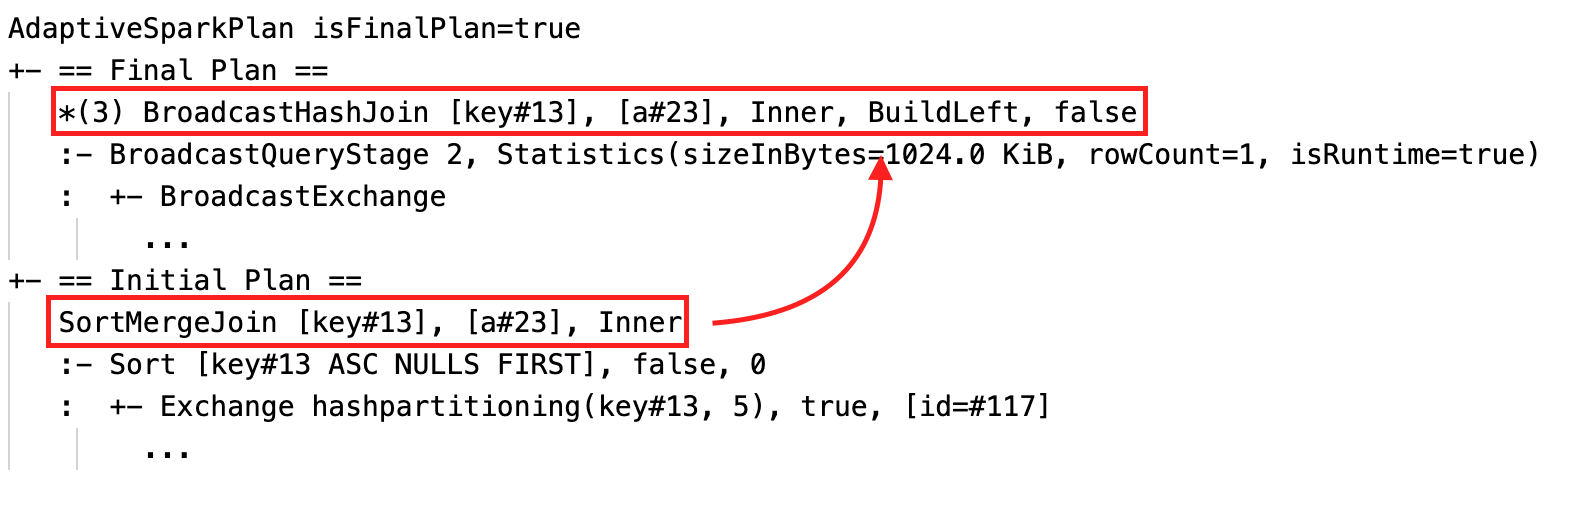
Cuando AQE aplica una optimización, el plan de consulta cambia. Para identificar qué optimizaciones tuvieron efecto, compara el plan actual o final con el plan inicial. Cada optimización cambia el plan de una manera específica:
Cambio de estrategia de unión. El plan actual o final tiene un nodo físico de unión diferente al plan inicial.
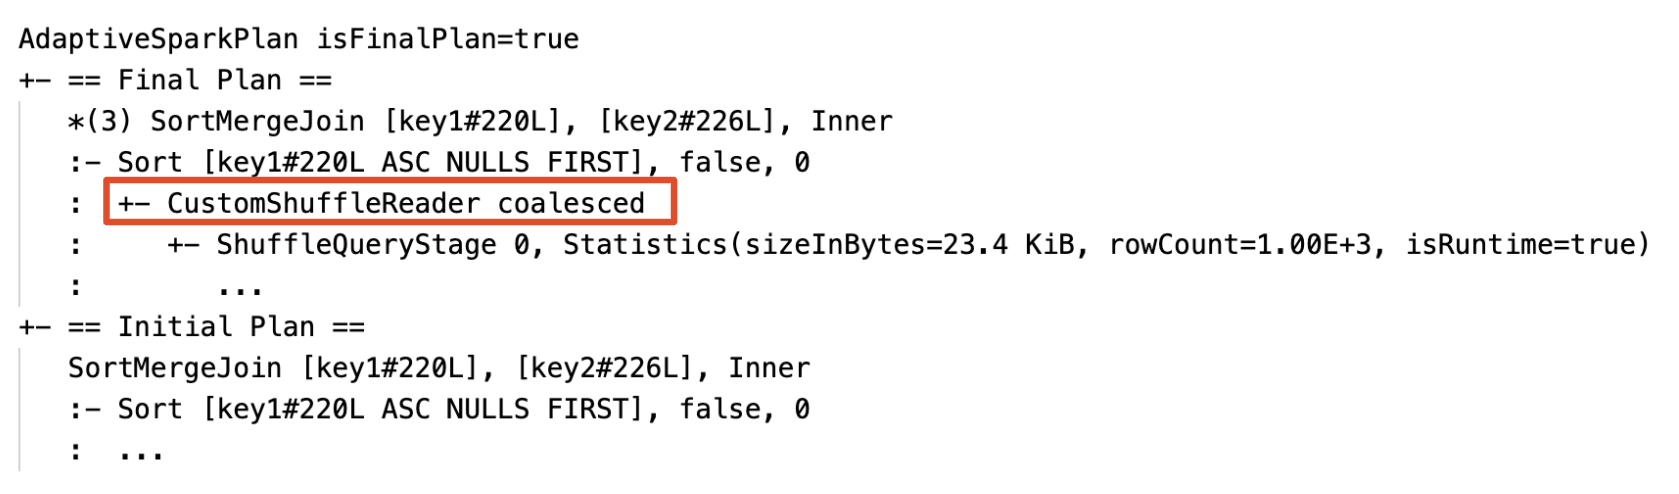
Consolidación de particiones. El plan contiene un nodo
CustomShuffleReadercon la propiedadCoalesced.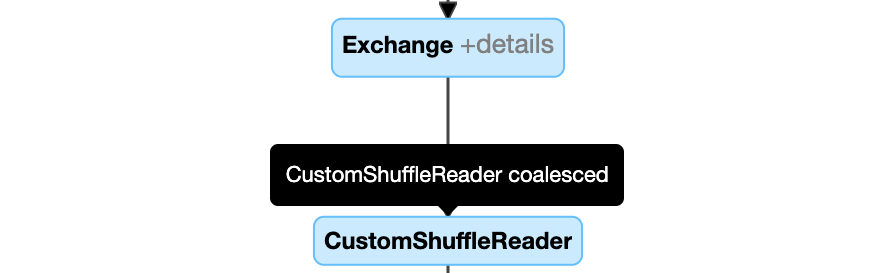
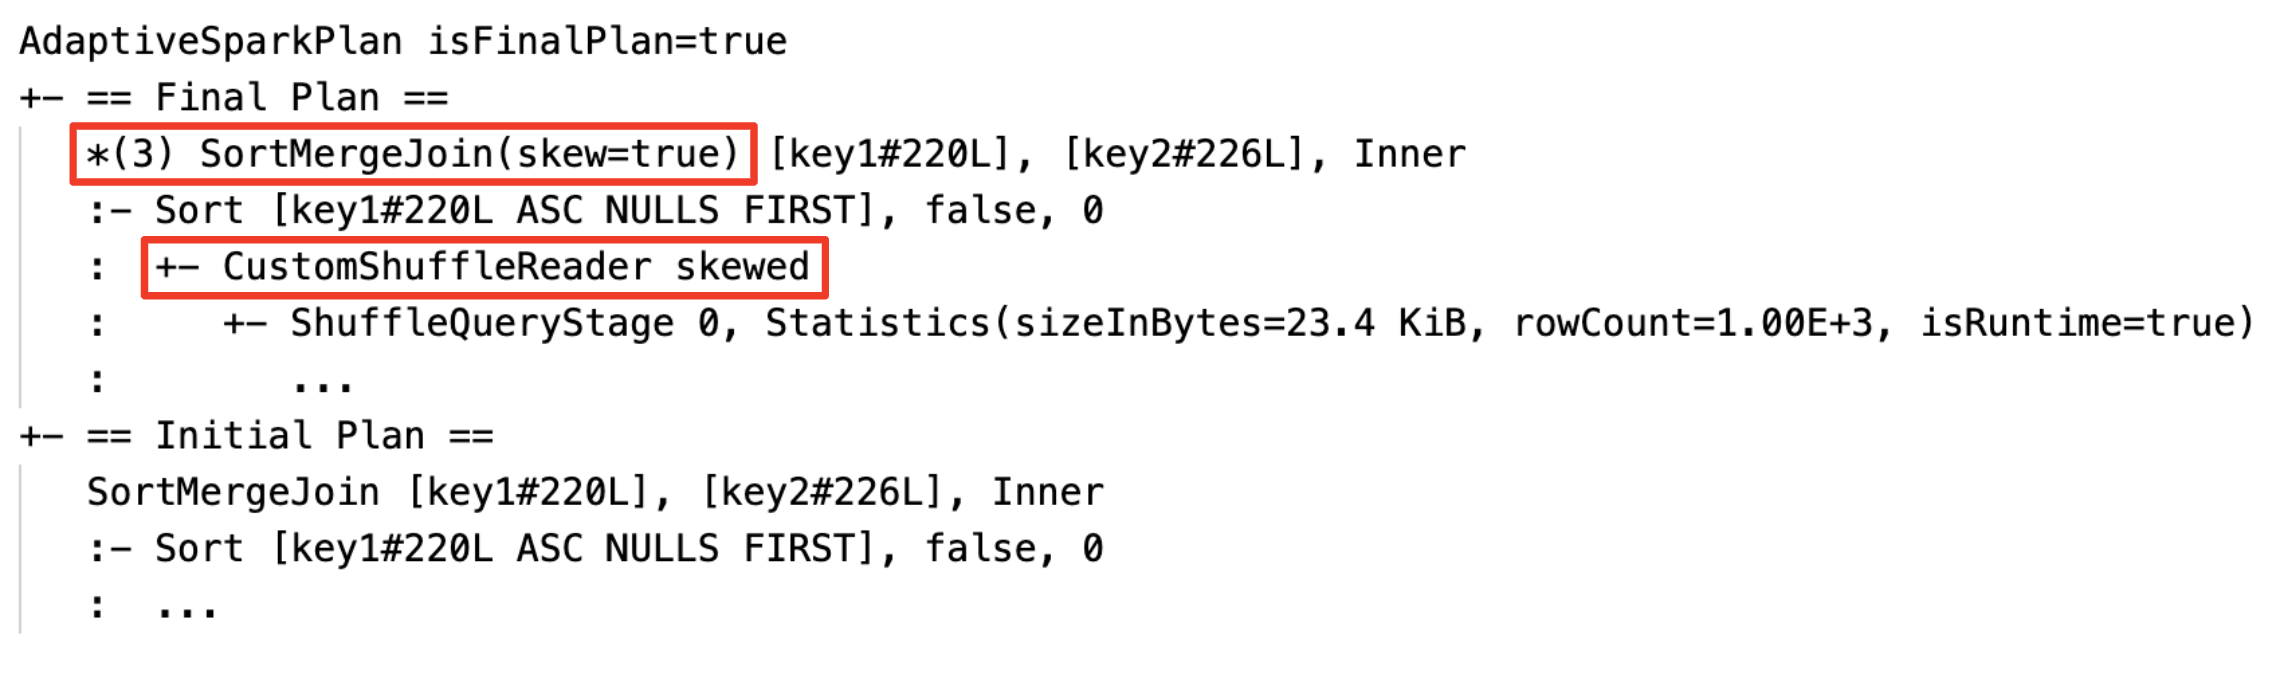
Manejo del join sesgado. El plan contiene un
SortMergeJoinnodo con elisSkewcampo establecido entrue.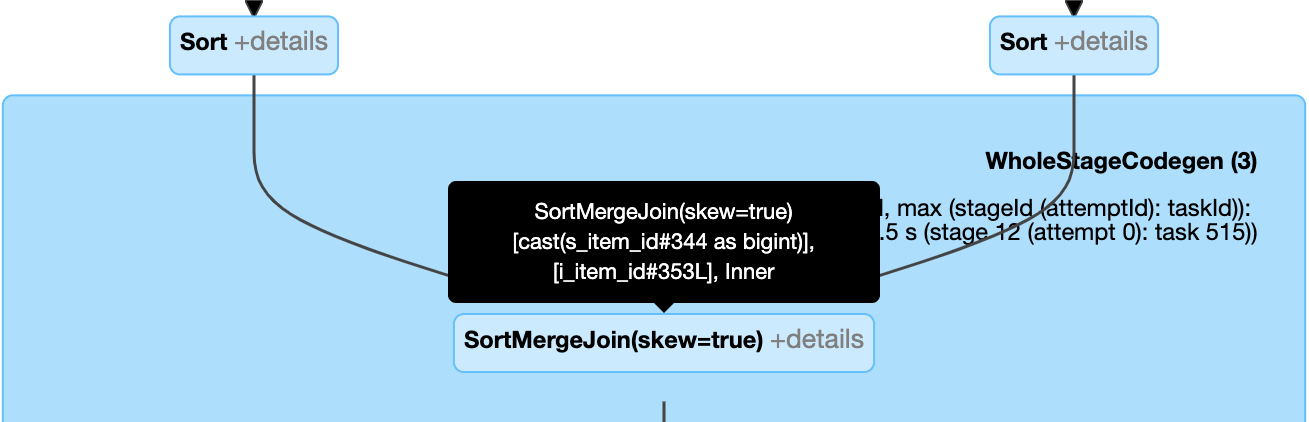
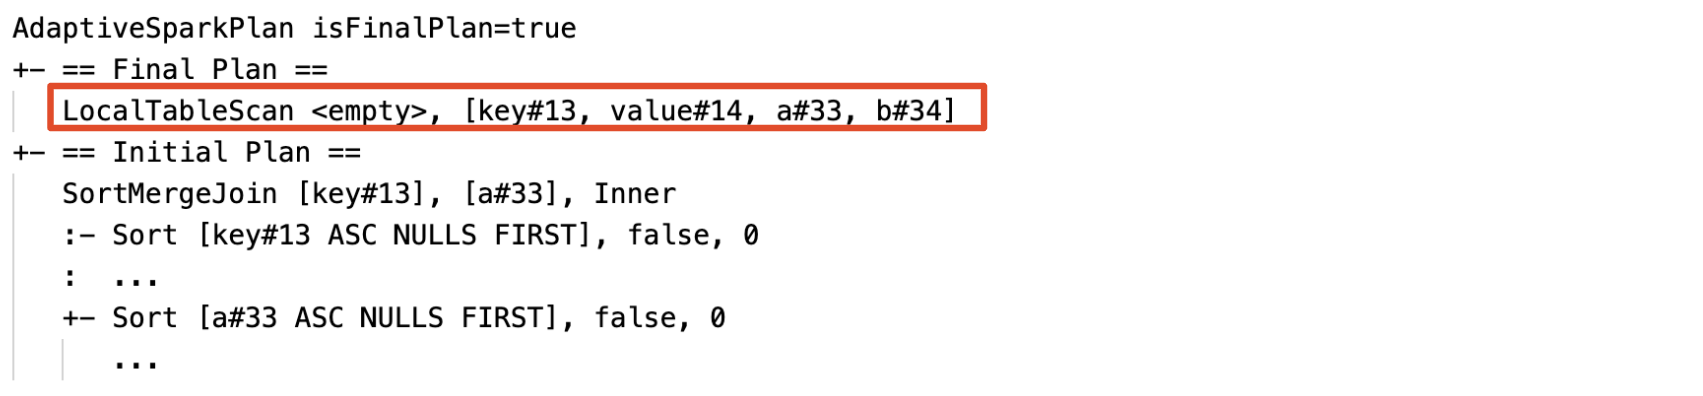
Propagación de relación vacía. Un
LocalTableScannodo con un campo de relación vacío reemplaza parte o la totalidad del plan.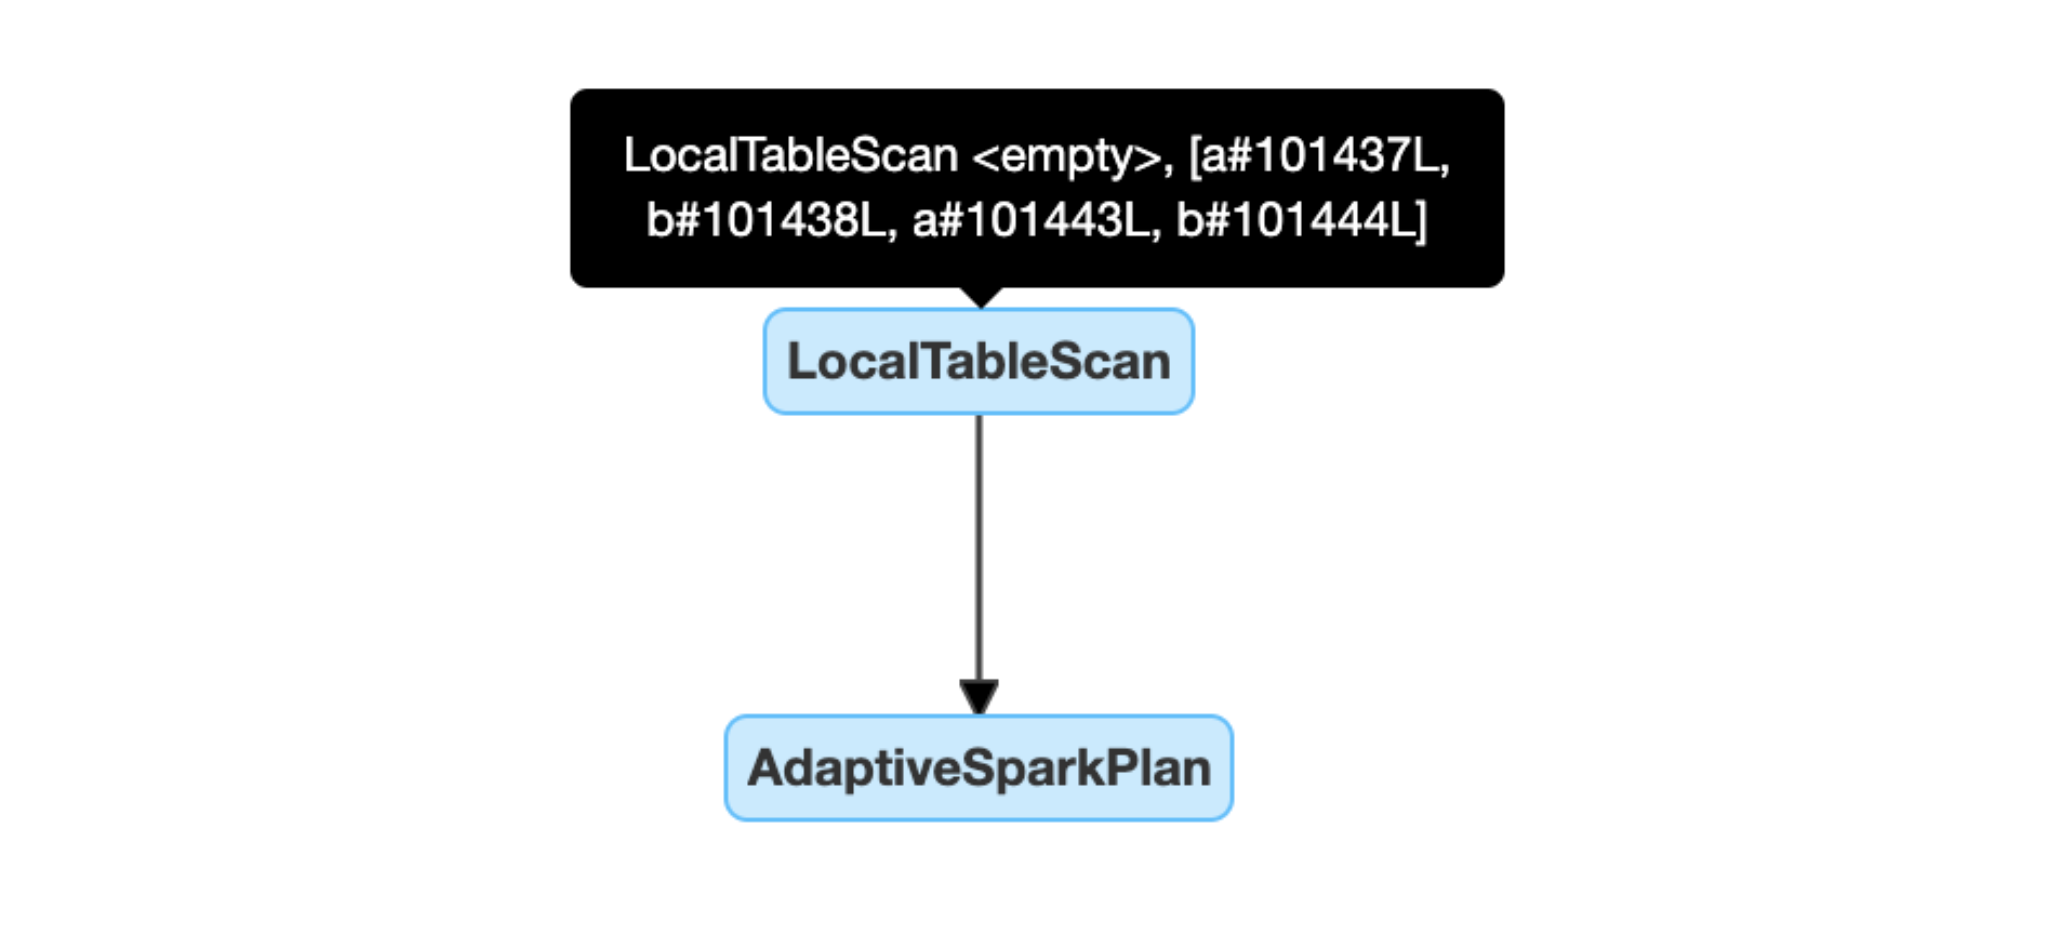
Configuración
Estas propiedades de configuración de Apache Spark controlan el AQE. La mayoría de las cargas de trabajo no necesitan cambiar los valores predeterminados.
Habilitar AQE y ajustar optimizaciones individuales
Utiliza estas propiedades para activar o desactivar AQE y para ajustar el shuffle optimizado automáticamente, el cambio de joins broadcast y la propagación de relaciones vacías:
| Propiedad | Type | Predeterminado | Description |
|---|---|---|---|
spark.databricks.optimizer.adaptive.enabled |
Boolean |
true |
Activa o desactiva la ejecución adaptativa de consultas. |
spark.sql.shuffle.partitions |
Integer |
200 |
Número predeterminado de particiones que se van a usar al ordenar aleatoriamente datos para combinaciones o agregaciones. Configúralo en auto para habilitar el barajado optimizado automático, que establece este número en función del plan de consulta y del tamaño de los datos de entrada de la consulta.Para Structured Streaming, no puedes cambiar este valor entre reinicios de consulta desde la misma ubicación de punto de control. |
spark.databricks.adaptive.autoBroadcastJoinThreshold |
Byte String |
30MB |
El umbral de tamaño para cambiar una combinación por mezcla ordenada a una combinación hash por difusión en tiempo de ejecución. |
spark.databricks.adaptive.emptyRelationPropagation.enabled |
Boolean |
true |
Activa o desactiva la propagación de relaciones vacías dinámicas. |
Fusión dinámica de particiones
| Propiedad | Type | Predeterminado | Description |
|---|---|---|---|
spark.sql.adaptive.coalescePartitions.enabled |
Boolean |
true |
Activa o desactiva la coalescencia de particiones. |
spark.sql.adaptive.advisoryPartitionSizeInBytes |
Byte String |
64MB |
Tamaño de destino después de la fusión. Las particiones coalescidas tienen un tamaño cercano a este, pero no lo superan. |
spark.sql.adaptive.coalescePartitions.minPartitionSize |
Byte String |
1MB |
Tamaño mínimo de las particiones después de la fusión. Las particiones coalescidas no son más pequeñas que este tamaño. |
spark.sql.adaptive.coalescePartitions.minPartitionNum |
Integer |
El doble de núcleos de clúster | Número mínimo de particiones después de la fusión. No pongas esta propiedad, porque al establecerla se anula spark.sql.adaptive.coalescePartitions.minPartitionSize. |
Control dinámico de la combinación de sesgo
| Propiedad | Type | Predeterminado | Description |
|---|---|---|---|
spark.sql.adaptive.skewJoin.enabled |
Boolean |
true |
Activa o desactiva la manipulación de skew join. |
spark.sql.adaptive.skewJoin.skewedPartitionFactor |
Integer |
5 |
El multiplicador para el tamaño mediano de la partición que una partición debe superar para que se la considere sesgada. |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes |
Byte String |
256MB |
El tamaño mínimo que debe superar una partición para considerarse sesgada. |
AQE trata una partición como sesgada solo cuando ambas condiciones son ciertas: (partition size > skewedPartitionFactor * median partition size) y (partition size > skewedPartitionThresholdInBytes).
Preguntas más frecuentes (FAQ)
¿Por qué AQE no ha difundido una tabla de unión pequeña?
Si la tabla es más pequeña que spark.databricks.adaptive.autoBroadcastJoinThreshold pero AQE no la emite, comprueba estas causas:
- El tipo de unión no soporta broadcast. Algunos tipos de unión no pueden replicar uno de los lados. Por ejemplo, AQE no puede transmitir el lado izquierdo de un
LEFT OUTER JOIN. - La tabla tiene muchas particiones vacías. La mayoría de las tareas en la operación de sort-merge join terminan rápido, o el tratamiento de skew join optimiza la operación. AQE no cambia una sort-merge join por una broadcast hash join si el porcentaje de particiones no vacías es menor que
spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin.
¿Debería seguir usando un hint de unión a broadcast con AQE activado?
Sí, si conoces bien tu consulta. Una unión broadcast que el optimizador planea antes de que se ejecute la consulta suele rendir mejor que una que AQE planea en tiempo de ejecución. AQE puede no cambiar a un broadcast join hasta después de barajar ambos lados de la unión, que es cuando conoce los tamaños reales de las tablas.
AQE respeta las pistas de consulta igual que la optimización estática, y sigue aplicando las optimizaciones dinámicas a las que no afectan las pistas.
¿Debería usar el skew join hint o el manejo de skew join de AQE?
Usa skew join handling de AQE. Es automático y normalmente rinde mejor que la sugerencia de unión skew.
¿Por qué AQE no reordenó mis joins?
AQE no reordena las uniones en tiempo de ejecución. Para mejorar el orden de combinación, recopila estadísticas de tablas para que el optimizador basado en costes pueda elegir un plan mejor. Consulta Optimizador basado en costes.
¿Por qué AQE no detectó mi asimetría de datos?
AQE trata una partición como sesgada solo cuando ambas condiciones son ciertas:
- La partición es más grande que
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(por defecto256MB). - La partición es mayor que
spark.sql.adaptive.skewJoin.skewedPartitionFactorveces el tamaño mediano de la partición (por defecto5).
AQE también maneja el sesgo solo en joins basados en shuffle, que son joins de mezcla por ordenación y joins hash con shuffle. Nunca optimiza el sesgo en las uniones de broadcast. Para uniones basadas en mezcla/shuffle, el tipo de unión determina qué lado puede optimizar AQE:
| Tipo de combinación | Inclinación optimizada en el lado izquierdo | Optimización del sesgo en el lado derecho |
|---|---|---|
INNER |
Yes | Yes |
CROSS |
Yes | Yes |
LEFT OUTER |
Yes | No |
RIGHT OUTER |
No | Yes |
LEFT SEMI |
Yes | No |
LEFT ANTI |
Yes | No |
FULL OUTER |
No | No |
Legado
Spark 1.6 introdujo una función llamada ejecución adaptativa, pero AQE en Spark 3.0 es una característica diferente. La ejecución adaptativa de Spark 1.6 solo fusiona las particiones dinámicamente. AQE es un framework que planifica y replanifica consultas basándose en estadísticas de tiempo de ejecución, y soporta todas las optimizaciones de esta página.