Nota
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
Eventstream en Microsoft Fabric es un servicio totalmente gestionado de gestión y streaming de eventos que permite el procesamiento y análisis de datos en tiempo real. Puedes integrar eventstream con notebooks Fabric usando Spark Structured Streaming para procesar y analizar datos de streaming en tiempo real.
Esta integración te permite explorar los flujos de eventos y otras fuentes en tiempo real a través del hub de Real-Time, directamente desde tus Fabric cuadernos. También puedes crear nuevos flujos de eventos y empezar a absorber datos de casi 30 (y en aumento) fuentes de streaming, incluyendo bases de datos habilitadas por CDC, brokers de mensajes, servicios de streaming y feeds públicos. El nuevo modelo de programación permite conectarte fácilmente a eventstream, leer datos en streaming y realizar análisis en tiempo real usando las conocidas APIs de Spark sin cadenas de conexión ni credenciales, haciendo más seguro construir aplicaciones en tiempo real
Prerrequisitos
Antes de comenzar, asegúrese de que tiene los siguientes requisitos previos:
- Un espacio de trabajo de Fabric con event stream activado.
- Un entorno de cuadernos configurado en Fabric.
- Conocimientos básicos de Spark Structured Streaming y PySpark o Scala.
Pasos para consultar eventstream desde un cuaderno
Detectar y agregar eventstream a Notebook:
Abra el cuaderno de Microsoft Fabric.
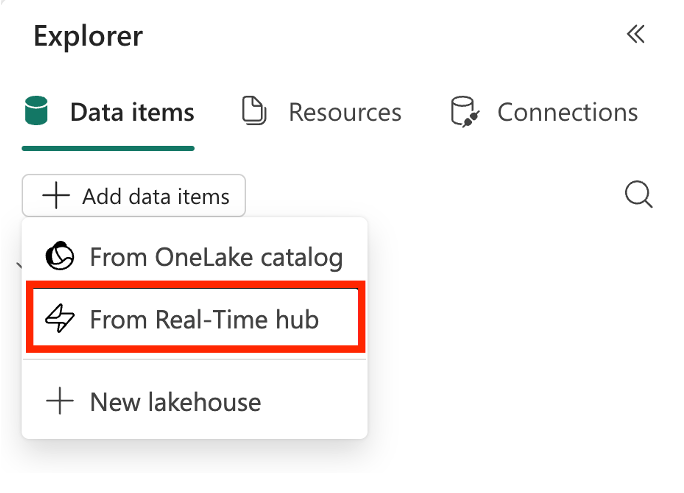
Seleccione Agregar elementos de datos en la pestaña Elementos de datos y, después, seleccione Desde el hub de datos en tiempo real en el menú desplegable.
En el cuadro de diálogo del centro de Real-Time, busque la secuencia de eventos de destino que desea consultar con diferentes opciones de búsqueda y filtro.
Agregue la secuencia de eventos al entorno del cuaderno.
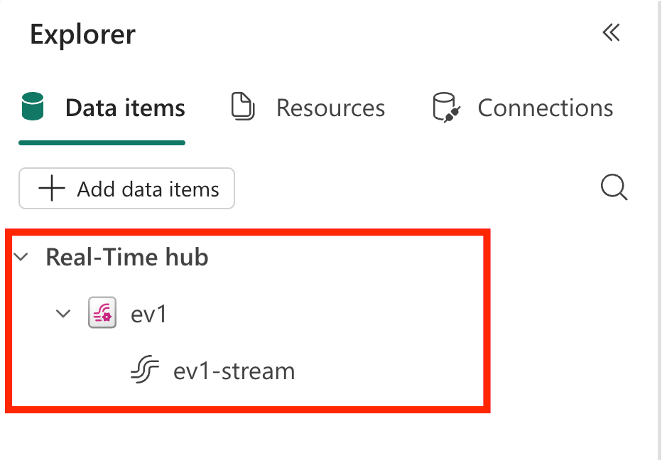
Después de agregar el elemento eventstream, aparecerá en el nodo central Real-Time en el explorador de objetos del cuaderno con el nombre del elemento; después de expandir el nodo, verá la secuencia predeterminada o derivada en el interior del elemento de eventstream.
Lee los datos de streaming de eventstream:
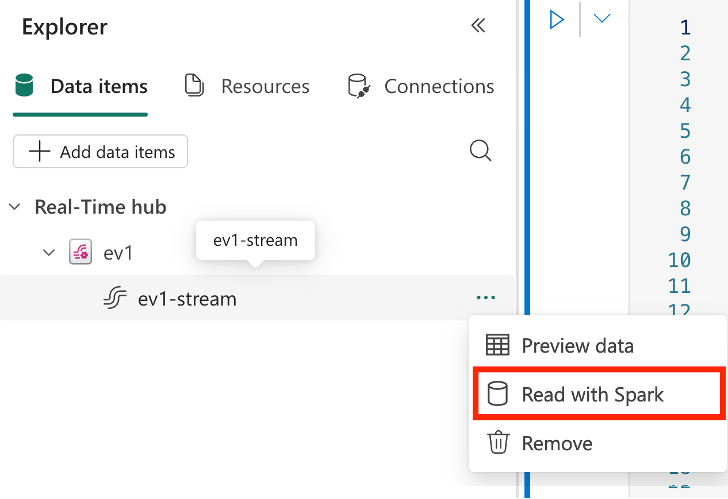
En el menú contextual del elemento eventstream del explorador de objetos, seleccione Leer con Spark para crear una celda de código preconfigurada para leer desde la secuencia de eventos seleccionada.
En la celda de código recién creada, puede usar el siguiente fragmento de código de PySpark para leer datos de streaming desde el flujo de eventos:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col
from pyspark.sql.types import StringType
from pyspark.sql.dataframe import DataFrame

eventstream_options = {
    "eventstream.itemid": __in_eventstream_item_id,
    "eventstream.datasourceid": __in_eventstream_datasource_id
}

# Read from Kafka using the config map
df_raw = spark.readStream.format("kafka").options(**eventstream_options).load()

decoded_df = df_raw.select(
    col("key").cast(StringType()).alias("key"),
    col("value").cast(StringType()).alias("value"),
    col("partition"),
    col("offset")
)

def showDf(x:DataFrame, y:int):
    x.show()

# Print messages to the console
query = decoded_df.writeStream.foreachBatch(showDf).outputMode("append").start()
query.awaitTermination()
El valor de las opciones
eventstream.itemidyeventstream.datasourceidse rellenan automáticamente en la celda de código de parámetro encima de esta celda de código.Nota:
Para cada selección en Lectura con Spark, se genera una nueva celda de código con los parámetros necesarios rellenados automáticamente y se crea un nuevo destino de Notebook para el elemento Eventstream, donde
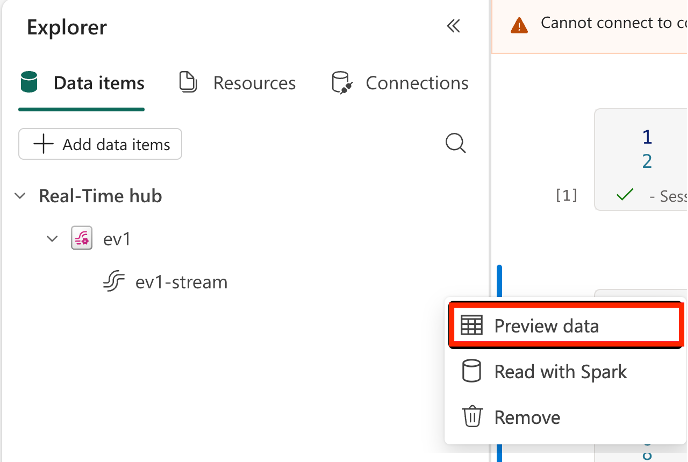
eventstream.datasourceides único para cada destino de Notebook. Para un elemento de cuaderno, se recomienda establecerlo una vez como destino para un elemento Eventstream para evitar crear varios destinos.Antes de ejecutar cualquier trabajo, también puede obtener una vista previa de los datos de streaming haciendo clic en el botón Vista previa de datos en el menú contextual del elemento Eventstream. Se abre un panel lateral para mostrar una instantánea de los datos de streaming junto al cuaderno.
Agregar cuaderno como destino: también puede agregar el cuaderno como destino de Eventstream para empezar a ingerir datos en Eventstream desde dentro del cuaderno. Para obtener más información, consulte Incorporación de un destino de Spark Notebook a una secuencia de eventos.
Conclusión
Integrar eventstream en Fabric con cuadernos usando Spark Structured Streaming te permite procesar y analizar datos en tiempo real de forma fluida. Siguiendo los pasos descritos en este artículo, puedes conectarte fácilmente a eventstream, leer datos en streaming y realizar análisis en tiempo real usando las conocidas APIs de Spark. Esta integración abre nuevas posibilidades para construir aplicaciones en tiempo real y obtener información a partir de datos en streaming dentro del ecosistema Fabric.
Contenido relacionado
Para saber más sobre cómo trabajar con eventstreams y cuadernos en Fabric, consulta los siguientes recursos