Nota
El acceso a esta página requiere autorización. Puede intentar iniciar sesión o cambiar directorios.
El acceso a esta página requiere autorización. Puede intentar cambiar los directorios.
La API SpeechRecognition es una API web estándar que permite convertir la voz desde un origen de audio, como un archivo multimedia o el micrófono de un dispositivo, en texto, directamente desde el código JavaScript de un sitio web o de las extensiones del explorador. Este artículo se centra en el uso de la API SpeechRecognition con el modelo de reconocimiento de voz en el dispositivo (o local) integrado en Microsoft Edge.
Para más información sobre la API, consulte Web Speech API, en MDN.
Contenido detallado:
- Disponibilidad del modelo de reconocimiento de voz local
- Ventajas del modelo de reconocimiento de voz local
- Habilitar el reconocimiento de voz local en Microsoft Edge
- Vea un ejemplo práctico
- Usar la API SpeechRecognition con reconocimiento local en el sitio web
- Enviar comentarios
- Ver también
Disponibilidad del modelo de reconocimiento de voz local
El modelo de reconocimiento de voz local está disponible en Microsoft Edge Canary o Dev (versión 150.0.4076 o posterior). Consulta Conviértete en un participante de Microsoft Edge Insider.
Ventajas del modelo de reconocimiento de voz local
Cuando se usa la API SpeechRecognition con el modelo local en Microsoft Edge, el reconocimiento de voz se produce en el mismo dispositivo donde se captura la voz. Este enfoque tiene las siguientes ventajas en comparación con las soluciones basadas en la nube:
Costo reducido: El uso de un servicio de reconocimiento en la nube no tiene ningún costo.
Independencia de la red: Más allá de la descarga inicial del modelo, no hay latencia de red al usar esta API para convertir voz, y la API también se puede usar cuando el dispositivo está sin conexión.
Privacidad mejorada: La entrada de voz en el modelo nunca abandona el dispositivo y no se recopila para entrenar modelos de inteligencia artificial.
Disponibilidad de modelos
Se requiere una descarga inicial del modelo la primera vez que un sitio web usa el modelo de reconocimiento de voz local con la API SpeechRecognition.
Puede supervisar la descarga del modelo mediante la promesa que devuelve el método de la API install() SpeechRecognition. Consulte Comprobar si el modelo local ya está instalado a continuación.
Habilitar el reconocimiento de voz local en Microsoft Edge
Para usar el modelo de reconocimiento de voz local con la API SpeechRecognition, debe habilitar la función en Microsoft Edge Canary o Dev. Para habilitar el reconocimiento de voz con el modelo en el dispositivo:
Asegúrese de que usa Microsoft Edge Canary o Dev (versión 150.0.4076 o posterior). Consulta Conviértete en un participante de Microsoft Edge Insider.
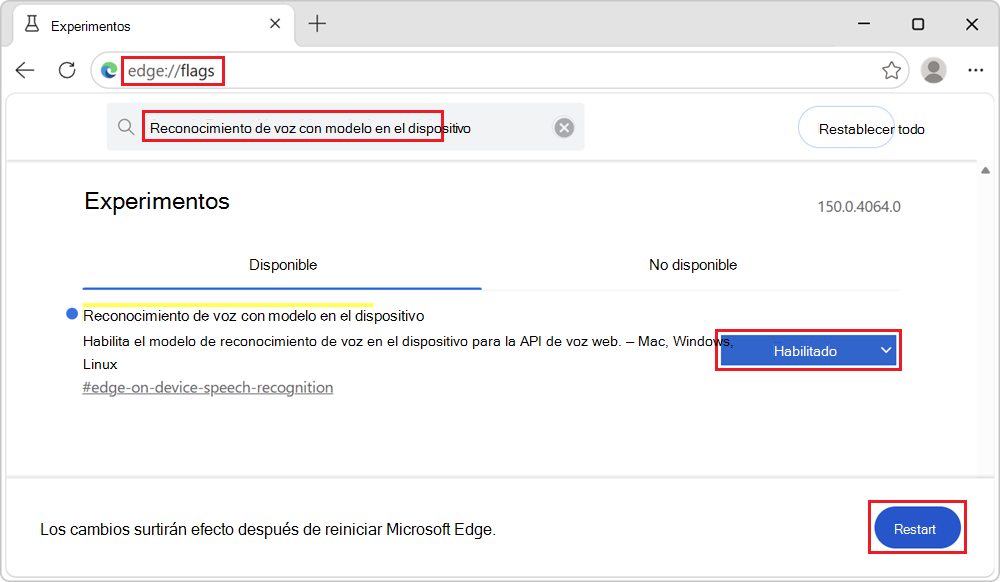
En Microsoft Edge Canary o Dev, abre una nueva pestaña o ventana y ve a
edge://flags.En el cuadro de búsqueda de la parte superior de la página, escriba Reconocimiento de voz con el modelo en el dispositivo.
En la lista desplegable Reconocimiento de voz con el modelo en el dispositivo , seleccione Habilitado y, a continuación, haga clic en el botón Reiniciar en la esquina inferior derecha:
Vea un ejemplo práctico
Para ver la API SpeechRecognition en acción y ver el código de demostración:
Habilite el reconocimiento de voz local en Microsoft Edge, como se ha descrito anteriormente.
En Microsoft Edge Canary o Dev, abre una pestaña o ventana y ve al área de juegos de la API de reconocimiento de voz.
En el banner de información en la parte superior, comprueba el estado: inicialmente indica SpeechRecognition API. Haga clic en Iniciar para comenzar.
En la lista desplegable Idioma de entrada , seleccione el idioma que desea usar para el reconocimiento de voz.
En la lista desplegable Origen de audio , seleccione un origen de audio para el reconocimiento de voz:
- Selecciona Micrófono para usar el micrófono del dispositivo como fuente de audio.
- Seleccione Archivo para usar un archivo de audio o vídeo del dispositivo como origen de audio.
Si ha seleccionado Archivo como origen de audio, se mostrará una sección de archivo multimedia . Haga clic en el botón Elegir archivo y, a continuación, seleccione un archivo de audio o vídeo del dispositivo.
Haga clic en el botón de Inicio.
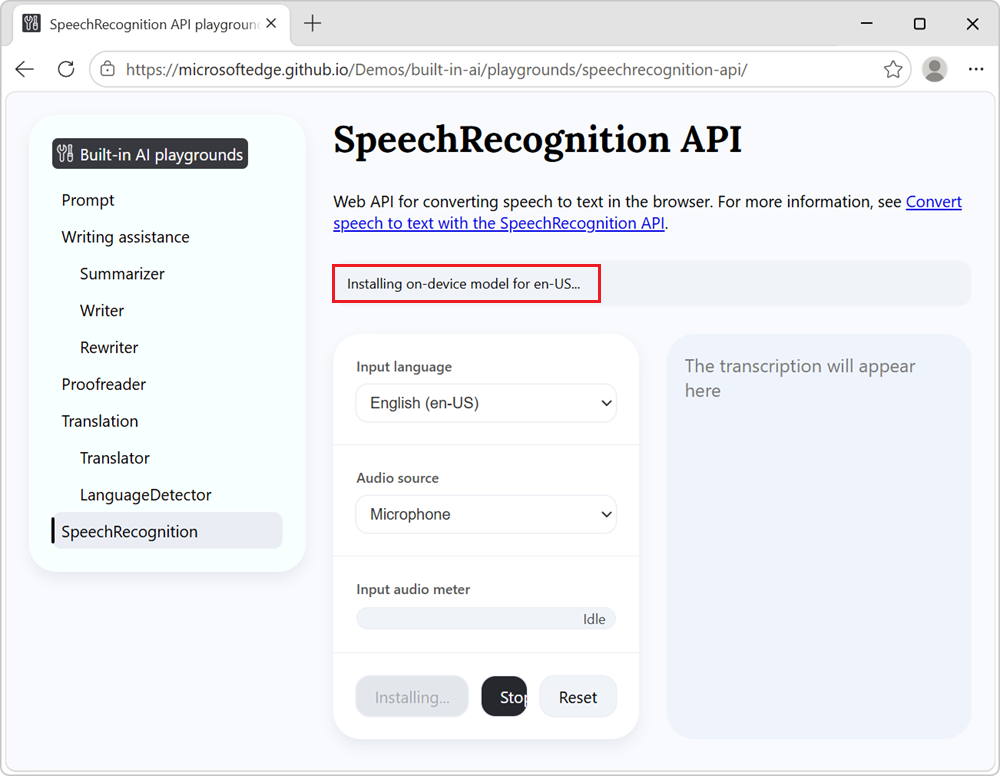
Si aún no ha descargado el modelo de reconocimiento de voz local para el idioma seleccionado, se inicia la descarga y el banner de información dice Instalación del modelo en el dispositivo para en-US...:
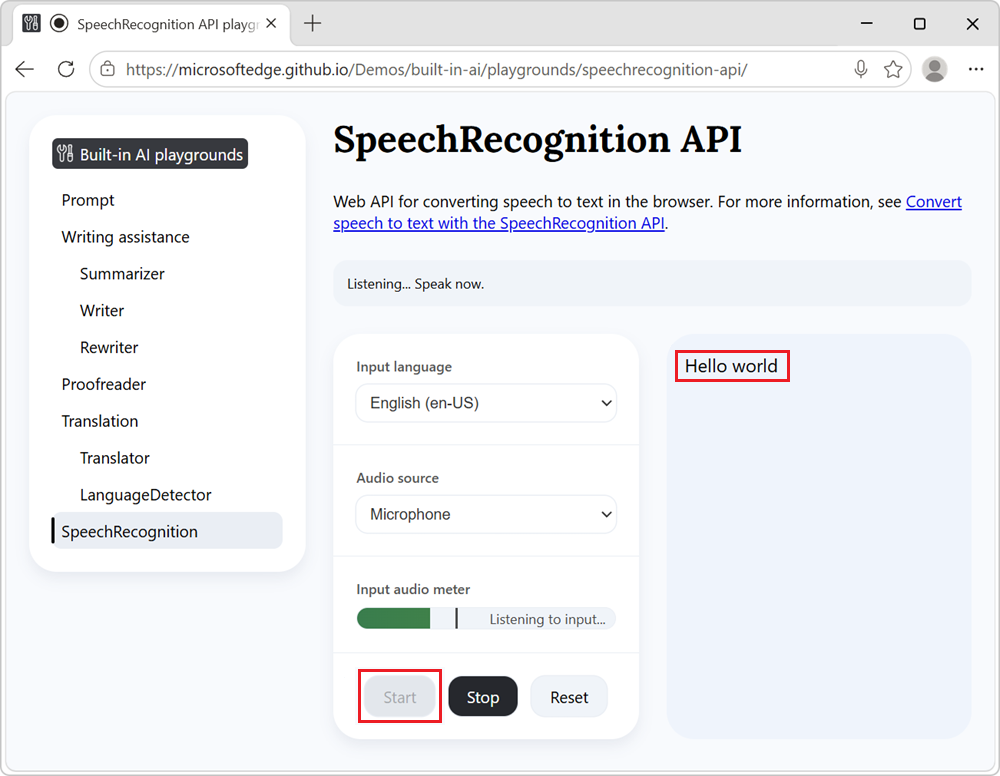
Una vez instalado el modelo, la transcripción de texto se muestra en la página:
Para detener la conversión de voz en texto, haga clic en el botón Detener en cualquier momento.
La transcripción también puede detenerse automáticamente después de un largo período de silencio en el audio de entrada.
Vea también:
- /built-in-ai/playgrounds/speechrecognition-api/ : código fuente de la demostración del área de juegos de la API de reconocimiento de voz.
Usar la API SpeechRecognition con reconocimiento local en el sitio web
En las secciones siguientes se describe cómo usar la API SpeechRecognition con el reconocimiento de voz local en el código del sitio web. Para obtener más detalles sobre la API en sí, consulte Web Speech API, en MDN.
Compruebe si la API es compatible y cree una instancia de un objeto SpeechRecognition
Para asegurarse de que la API SpeechRecognition es compatible con el explorador, pruebe si el SpeechRecognition objeto está disponible:
if (!window.SpeechRecognition) {
  console.log("The SpeechRecognition API is not available in this browser.");
} else {
  console.log("The SpeechRecognition API is available.");
}
Si la API es compatible, cree una nueva SpeechRecognition instancia para empezar a usar la API:
const recognition = new SpeechRecognition();
Vea también:
- SpeechRecognition, en MDN.
Elegir un idioma de entrada y optar por el reconocimiento local
Para configurar el reconocimiento de voz mediante un modelo local, especifique un idioma de entrada y configure la processLocally opción:
recognition.lang = "en-US";
recognition.processLocally = true;
Los siguientes idiomas de entrada son compatibles con el reconocimiento de voz local:
- Inglés (en-US)
- Alemán (de-DE)
- Italiano (it-IT)
- Portugués (pt-PT)
- Español (es-es)
- Coreano (ko-KR)
Se espera que la compatibilidad con idiomas se amplíe en versiones futuras.
Configure también las continuous opciones and interimResults para true transcribir sesiones de audio largas sin detenerse y recibir resultados provisionales:
recognition.continuous = true;
recognition.interimResults = true;
Vea también:
- SpeechRecognition: propiedad lang, en MDN.
- SpeechRecognition: propiedad processLocally en MDN.
- SpeechRecognition: propiedad continua, en MDN.
- SpeechRecognition: propiedad interimResults, en MDN.
Compruebe si el modelo local ya está instalado
Antes de iniciar el reconocimiento, compruebe si el modelo local está disponible para el idioma seleccionado mediante el SpeechRecognition.available() método.
Si el modelo aún no está instalado, desencadene la instalación mediante el método y espere a que el modelo se complete antes de iniciar el SpeechRecognition.install() reconocimiento:
async function ensureModelReady(lang) {
  // Check if the model is already available.
  const availability = await SpeechRecognition.available({
    langs: [lang],
    processLocally: true,
  });

  // If the model is already available, proceed to recognition.
  if (availability === "available") {
    return true;
  }

  // If the model is not available but can be downloaded,
  // trigger the installation and wait for it to complete
  // before proceeding to recognition.
  if (availability === "downloadable" || availability === "downloading") {
    const installed = await SpeechRecognition.install({
      langs: [lang],
      processLocally: true,
    });

    if (!installed) {
      throw new Error(`Failed to install local model for ${lang}.`);
    }

    return true;
  }

   return false;
}
La promesa devuelta por SpeechRecognition.install() se resuelve cuando la instalación se realiza correctamente o se produce un error.
Vea también:
- SpeechRecognition: método estático available(), en MDN.
- SpeechRecognition: install() static method, at MDN.
Iniciar reconocimiento de voz
Cuando se haya asegurado de que la API y el modelo están listos para iniciar el reconocimiento, use el start() método.
Cuando se llama sin un parámetro, el método reconoce el start() audio del micrófono del usuario:
recognition.start();
Para reconocer el audio de un archivo multimedia en lugar del micrófono del usuario, pase una MediaStreamTrack instancia como argumento al start() método. Por ejemplo, puede crear una MediaStreamTrack instancia creando una MediaStreamDestinationNode instancia mediante la API WebAudio:
const audioContext = new AudioContext();
const mediaStreamDestination = audioContext.createMediaStreamDestination();
recognition.start(mediaStreamDestination.stream.getAudioTracks()[0]);
Vea también:
- SpeechRecognition: start(), en MDN.
- API de audio web, en MDN.
Detener el reconocimiento explícitamente y en el extremo de los medios
Para detener el reconocimiento, utilice el stop() método:
recognition.stop();
También puede optar por detener el reconocimiento cuando finaliza la entrada multimedia, mediante el onended controlador de eventos del elemento multimedia que está usando como entrada. Por ejemplo, si usa un HTMLAudioElement o HTMLVideoElement como origen de audio, puede configurar el controlador de eventos de la siguiente manera:
mediaElement.onended = () => recognition.stop();
Vea también:
- SpeechRecognition: stop(), en MDN.
Enviar comentarios
Nos interesa conocer sus comentarios sobre:
- El modelo de reconocimiento de voz local.
- El rendimiento del modelo de reconocimiento de voz local.
- Cualquier otra mejora que te gustaría ver en tus casos de uso.
Agregue un comentario al problema de comentarios de la API SpeechRecognition.
Vea también
Microsoft:
MDN:
-
Reconocimiento de voz
- SpeechRecognition: método estático available()
- SpeechRecognition: propiedad continua
- SpeechRecognition: install() método estático
- SpeechRecognition: propiedad interimResults
- SpeechRecognition: propiedad lang
- SpeechRecognition: propiedad processLocally
- SpeechRecognition: método start()
- SpeechRecognition: método stop()
- Web Audio API
- Web Speech API
GitHub: