Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
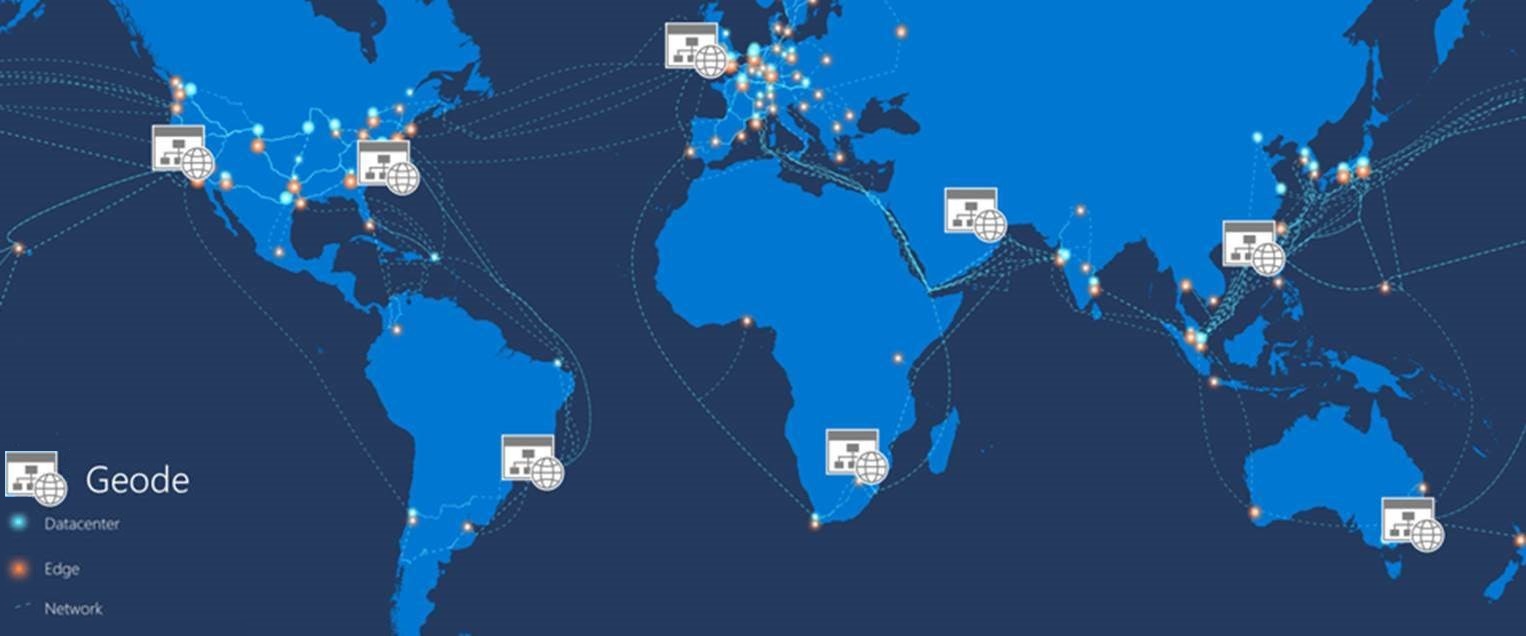
Déployez une collection de services back-end dans un ensemble de nœuds géographiques, chacun pouvant traiter une demande client dans n’importe quelle région. Cette approche active-active distribue le traitement des demandes dans le monde entier afin d’améliorer la latence et d’augmenter la disponibilité.
Contexte et problème
De nombreux services à grande échelle sont confrontés à des défis liés à la disponibilité géographique et à la mise à l’échelle. Les conceptions classiques amènent souvent les données vers le traitement en stockant des données dans un serveur SQL distant qui traite également les données. Ils s’appuient sur le scale-up pour gérer la croissance.
L’approche classique peut entraîner les problèmes suivants :
- Les utilisateurs des régions distantes peuvent rencontrer une latence réseau lorsqu’ils se connectent au point de terminaison d’hébergement.
- Les rafales de demande peuvent submerger les services dans une seule région.
- Le déploiement de copies de l’infrastructure d’application dans plusieurs régions pour assurer un service disponible 24 h/24 peut ajouter de la complexité et des coûts.
L’infrastructure cloud prend en charge le routage global et la réplication des données géographiques. Pour réduire la latence d’une base d’utilisateurs distribuée géographiquement, colocalisez le calcul avec les réplicas de données régionaux que le calcul traite. Le modèle Geode transmet le calcul aux données.
Solution
Déployez le service sur plusieurs emplacements géographiques. Chaque déploiement est appelé géode. Utilisez un service de routage global pour distribuer les demandes en fonction des stratégies de routage et des vérifications d’intégrité. Chaque géode accède à un magasin de données géorépliqué.
Configurez la couche Données afin que chaque géode puisse traiter les mêmes opérations d’application conformément aux exigences de cohérence éventuelle de la charge de travail. Les Geodes peuvent observer différentes versions d’un élément pendant que la réplication est en cours. L’application doit tenir compte du décalage de réplication et des écritures simultanées, en particulier lorsque les requêtes se déplacent entre les géodes.
Par exemple, un compte Azure Cosmos DB pour NoSQL configuré avec plusieurs régions en écriture peut servir des lectures et des écritures dans la région de chaque géode. Les écritures multirégions d’Azure Cosmos DB répliquent les données de façon asynchrone.
Dans une architecture d’unité de déploiement, chaque unité de déploiement sert un sous-ensemble affecté d’utilisateurs ou de locataires. Dans une architecture de géode, chaque géode peut servir les mêmes opérations d’application pour n’importe quel utilisateur et accéder aux données nécessaires pour ces opérations. Les deux modèles utilisent plusieurs déploiements ; choisissez entre eux en fonction de l’éligibilité de la demande et du placement des données.
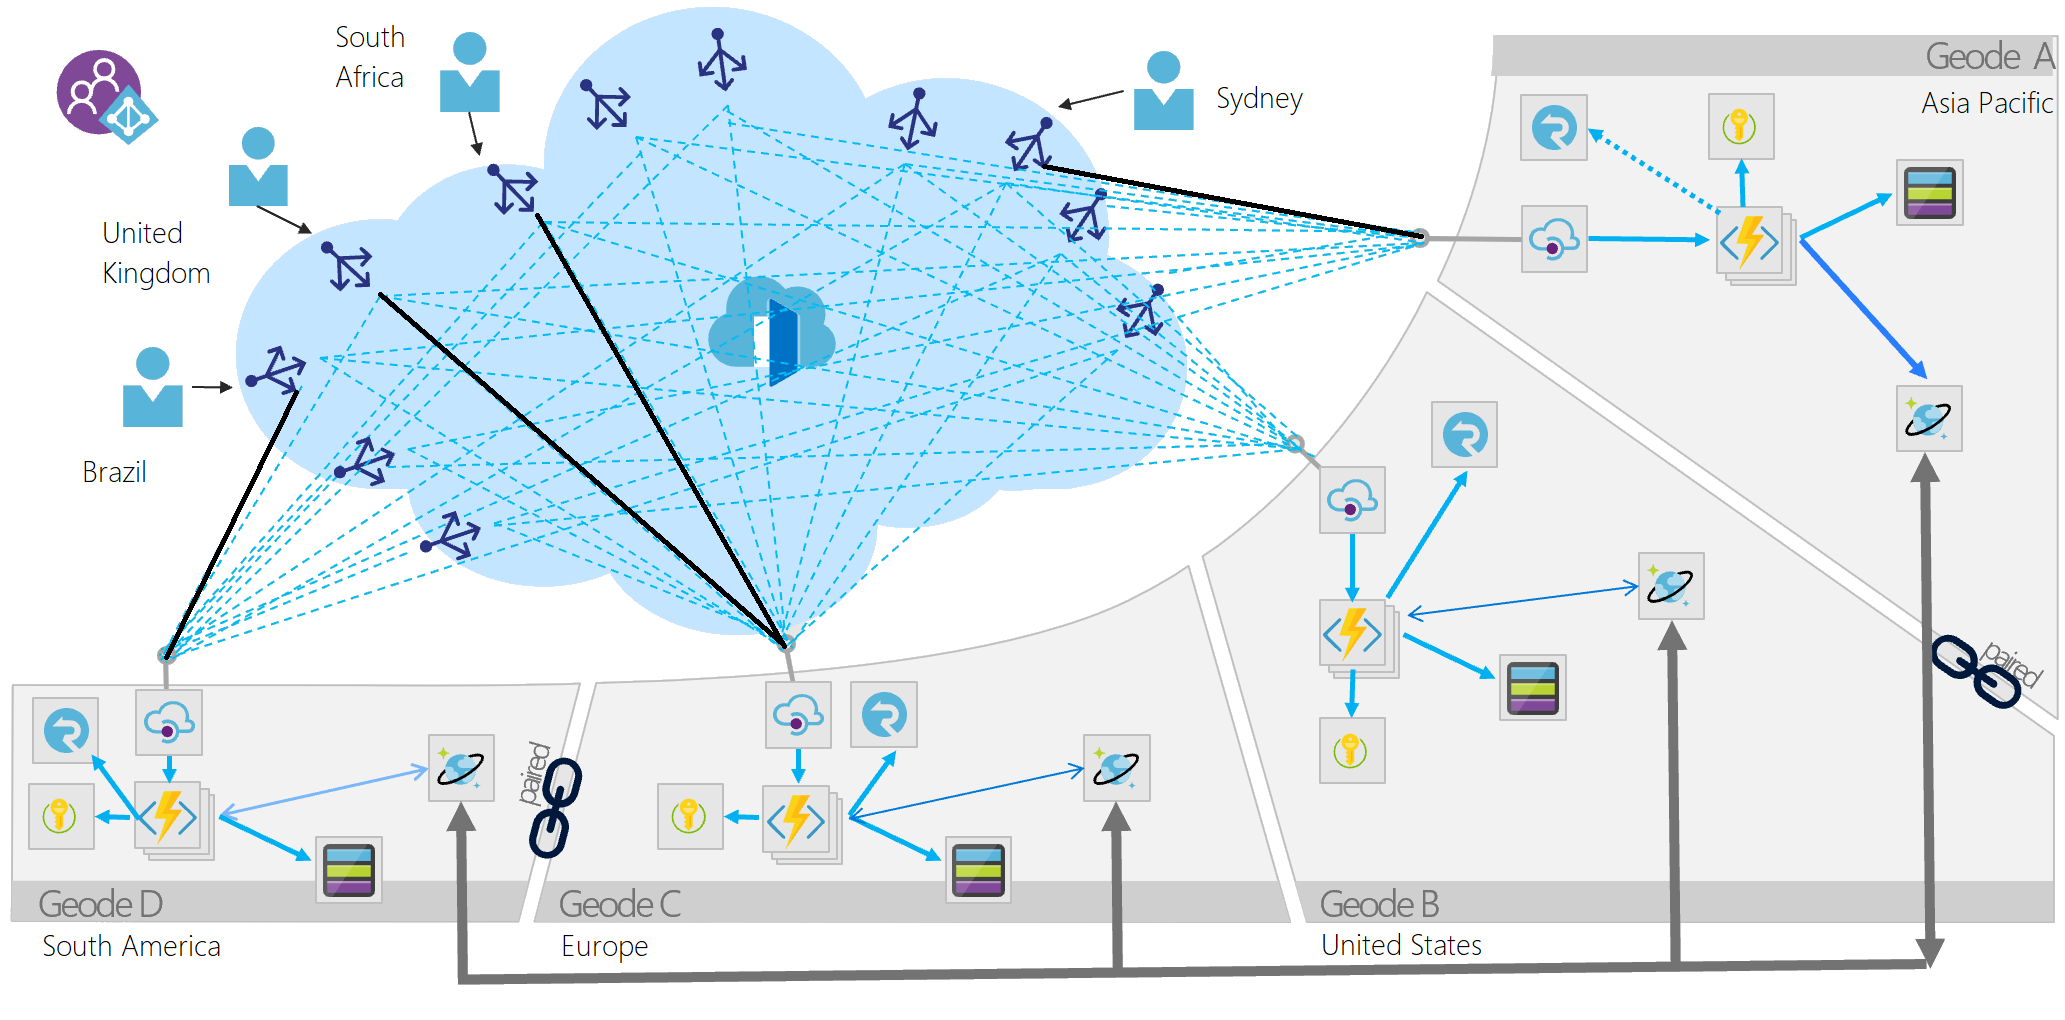
Les géodes présentent les caractéristiques suivantes :
- Chaque géode se compose d’une collection de types de ressources, souvent définie dans un modèle de déploiement.
- Chaque géode contient les ressources régionales nécessaires pour traiter les demandes sans dépendre de la couche applicative d’une autre géode. Le routage partagé et les services de données peuvent toujours exister dans l’architecture.
- Les géodes sont faiblement couplées via le routage global et un backplane de réplication. Le niveau de routage dirige les requêtes vers les géodes disponibles, et le niveau de données réplique les mises à jour entre elles. L’application a encore besoin d’un modèle de cohérence approprié et d’une stratégie de gestion des conflits.
Le modèle de géode se retrouve dans les architectures Big Data qui utilisent du matériel standard pour traiter les données colocalisées sur le même ordinateur et MapReduce pour consolider les résultats entre les machines. Il est également utilisé pour l'Edge Computing à proximité, ce qui rapproche la capacité de calcul du réseau en vue de réduire le temps de réponse.
Choisissez le nombre et le placement de géodes en fonction des défaillances régionales que votre charge de travail doit tolérer. La disponibilité dépend de dépendances partagées saines et d’une capacité de calcul et de base de données suffisante dans les géodes survivantes pour gérer le trafic redirigé.
Problèmes et considérations
Utilisez les techniques et technologies suivantes pour l’implémentation de ce modèle :
- Utilisez les pratiques et outils DevOps pour créer et déployer des géodes identiques dans différentes régions ou instances.
- Utilisez la mise à l’échelle automatique pour effectuer un scale-out du débit de calcul et de base de données dans chaque géode, sous réserve de contraintes de backplane partagées.
- Pour une implémentation d’API HTTP, Azure Front Door fournit une accélération du trafic via son réseau de périphérie et fractionne les connexions TCP.
- Utilisez un magasin de données géorépliqué pour contrôler la cohérence des données. Pour l’exemple d’écriture multirégion Cosmos DB, configurez le routage régional du Kit de développement logiciel (SDK) afin que chaque géode lise et écrive dans sa région de base de données locale et puisse utiliser des régions de secours configurées.
- Envisagez le calcul à la consommation pour réduire les coûts liés à la capacité inutilisée lorsque la charge passe d’une géode à l’autre. Cette stratégie pourrait permettre à de nombreuses géodes d’être déployées avec un investissement minimal supplémentaire. Les économies dépendent de la charge de travail et du plan d’hébergement.
- Gestion des API Azure est facultatif. Placez-la devant l'application de fonction de chaque géode quand vous avez besoin de fonctionnalités de gestion des API, telles que la limitation de débit.
Prenez en compte les points suivants lorsque vous choisissez comment implémenter ce modèle :
Choisissez un niveau de cohérence qui répond à vos exigences de lecture lorsque les requêtes se déplacent entre les géodes.
Avec la cohérence de session d’Azure Cosmos DB, retournez le jeton de session au client et faites en sorte que le client l’inclue avec les demandes de lecture suivantes afin que la garantie de lire ses propres écritures survive au routage vers un autre géode. Dans les comptes d’écriture multirégion, utilisez ces jetons partagés uniquement pour les demandes de lecture.
Sélectionnez une stratégie de résolution de conflit pour les écritures simultanées.
Définissez les modes de défaillance que la charge de travail doit tolérer, y compris les pannes régionales et les défaillances des dépendances partagées. Dimensionnez les géodes survivantes pour la charge de pointe redirigée.
Test du basculement régional et de la récupération sous charge représentative dans un environnement contrôlé. Incluez les échecs de dépendance partagée et le basculement arrière.
Choisissez de traiter les données localement dans chaque région, ou de calculer des agrégations dans une seule géode et de répliquer les résultats dans le monde. Le processeur de flux de modification Azure Cosmos DB propose un contrôle granulaire par l’utilisation de son concept de conteneur de bail et de
LeaseContainerPrefixdans la liaison Azure Functions correspondante. Chaque approche présente des avantages et des inconvénients distincts.Les géodes peuvent travailler ensemble à l’aide du flux de modification Azure Cosmos DB et d’une plateforme de communication en temps réel comme SignalR. Ils peuvent communiquer avec des utilisateurs distants via d’autres géodes dans un modèle de maillage sans connaître ni se soucier de l’emplacement de ces utilisateurs.
Suivez les composants d’une même requête, car ils pourraient s’exécuter de manière asynchrone sur des instances ou géodes différentes. Surveillez les dépendances partagées ainsi que les ressources régionales afin de pouvoir identifier les défaillances corrélées. Les Azure Front Door et les Azure Cosmos DB peuvent s’intégrer à Log Analytics, et Azure Functions peuvent utiliser Application Insights pour la supervision des applications.
Sécuriser les points d’entrée à chaque couche du déploiement distribué.
- Limitez l’accès à Azure Cosmos DB aux applications de fonction.
- Pour les origines d’une application de fonction publique derrière Azure Front Door, configurez les restrictions d’accès qui combinent l'étiquette de service
AzureFrontDoor.Backendet un filtre d’en-têteX-Azure-FDIDcorrespondant à votre ID de profil Front Door dans la même règle d’autorisation. Refuser les demandes sans correspondance.
Conservez l’authentification de l’appelant d’API séparément de ces contrôles d’accès d’origine.
Assurez-vous que chaque géode peut accéder aux secrets dont elle a besoin à partir de Key Vault, et coordonnez l’approvisionnement et la rotation des secrets partagés.
Les performances dépendent du nombre de géodes et du modèle d’hébergement de calcul utilisé pour l’API de chaque géode. Vous devez évaluer la différence de coût entre l’ajout de géodes et l’augmentation de la capacité de chaque géode.
Utilisez des ressources redondantes interzone là où elles sont prises en charge pour réduire l’effet des défaillances de zone de disponibilité dans la région de chaque géode. Choisissez des régions en fonction de la latence, de la résidence des données, de la disponibilité du service et des exigences de récupération.
Utilisez l’arbre de décision d’équilibrage de charge pour sélectionner un serveur frontal pour votre API.
Pour Front Door, configurez la sélection d’origine pour qu’elle corresponde à la conception active/active. Donnez simultanément aux géodes actives la même priorité, puis configurez la sensibilité de latence et les pondérations.
Quand utiliser ce modèle
Utilisez ce modèle dans les situations suivantes :
- Vous avez besoin d’une plateforme à grande échelle pour les utilisateurs répartis dans une vaste zone géographique.
- Votre charge de travail doit continuer à traiter les demandes critiques pendant les pannes régionales prévues dans son modèle de défaillance.
Ce modèle peut ne pas convenir dans les scénarios suivants :
- Votre architecture limite les données ou les utilisateurs à des déploiements particuliers, par exemple pour répondre aux exigences régionales de résidence des données. Tenez compte des unités de déploiement avec routage tenant compte des données quand seuls certains déploiements peuvent servir un utilisateur donné.
- Votre charge de travail peut répondre à ses exigences dans une seule région. Envisagez les déploiements redondants interzones où ils sont pris en charge et évaluez séparément la récupération d’urgence régionale.
- L’état de session ou les dépendances de données de votre application lient les requêtes à une seule région. Les applications existantes peuvent avoir besoin de modifications apportées à la gestion de l’état, à la réplication des données et à l’automatisation du déploiement avant que leurs déploiements régionaux puissent servir les mêmes opérations.
- Vos exigences en matière de disponibilité et de latence ne justifient pas la géo-distribution, par exemple lorsque la plupart des utilisateurs et des données se trouvent dans une région.
Conception de la charge de travail
Un architecte doit évaluer de quelle façon le modèle Geode peut être utilisé dans la conception de leur charge de travail pour répondre aux objectifs et principes couverts par les piliers d’Azure Well-Architected Framework. Par exemple:
| Pilier | Comment ce modèle soutient les objectifs des piliers. |
|---|---|
| Les décisions relatives à la fiabilité contribuent à rendre votre charge de travail résiliente aux dysfonctionnements et à s’assurer qu’elle retrouve un état de fonctionnement optimal après une défaillance. | Les déploiements régionaux et la réplication des données peuvent aider votre charge de travail à tolérer une ou plusieurs pannes régionales. - RE :05 Redondance - Régions et zones de disponibilité |
| L’efficacité des performances permet à votre charge de travail de répondre efficacement aux demandes par le biais d’optimisations de la mise à l’échelle, des données et du code. | Le traitement local et l’accès aux données peuvent réduire la latence des requêtes pour une base d’utilisateurs distribuée. Cela permet de réduire la latence en éliminant le trafic longue distance et en ne partageant l’infrastructure qu’avec les utilisateurs qui utilisent actuellement le même géode. - PE :03 Sélection de services |
Comme pour toute autre décision de conception, il convient de prendre en compte les compromis par rapport aux objectifs des autres piliers qui pourraient être introduits avec ce modèle.
Examples
services de domaine Active Directory (AD DS) dans Windows Server illustre une variante partielle de ce modèle. Les contrôleurs de domaine accessibles en écriture utilisent la réplication multimaître pour les partitions d’annuaire qu’ils hébergent. Certaines opérations nécessitent un titulaire de rôle FSMO (Flexible Single Master Operations) désigné. Par conséquent, les contrôleurs de domaine ne sont pas interchangeables pour chaque opération.
Les services Azure suivants illustrent l’interchangeabilité géographique des requêtes :
- Azure Cosmos DB pour NoSQL : avec les écritures multirégions activées, chaque région configurée contient toutes les partitions de données d’un conteneur et peut servir des lectures et des écritures. Ces déploiements régionaux de service de données illustrent les géodes de ce compte.
- Azure Managed Redis : avec la géoréplication active, chaque instance régionale liée peut accepter des lectures et des écritures sur le même cache logique.
- Azure Front Door : chaque point de présence Front Door peut répondre à n’importe quelle demande. Ces emplacements de périphérie illustrent des gestionnaires de requêtes HTTP géographiquement interchangeables.
Étape suivante
Passez en revue la base de référence AKS pour les clusters multirégions pour obtenir des conseils connexes sur le calcul régional actif-actif et le routage global.