Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
GQL (Langage de requête Graph) est le langage de requête normalisé ISO pour les bases de données de graphe. Utilisez GQL pour interroger, analyser et utiliser efficacement les données de graphe avec le graphe dans Microsoft Fabric.
Le même groupe de travail ISO qui normalise SQL développe GQL. Par conséquent, GQL partage de nombreux concepts avec SQL, notamment les expressions, les prédicats et les types de données. Si vous avez une expérience SQL, vous pouvez appliquer une grande partie de ces connaissances à GQL.
Cet article est le guide complet du GQL en graphes. Il explique comment le langage s’imbrique et renvoie à des références ciblées pour des détails complets sur la syntaxe et le type. Il couvre :
- Concepts fondamentaux : structures de données, modèles et notions de base des requêtes graphes
-
Énoncés essentiels :
MATCH,FILTER,LET,WHEN,ORDER BY,LIMIT, etRETURN - Types de données et expressions : types de valeur, opérateurs et fonctions intégrées
- Techniques avancées : composition multi-instructions, étendue variable et stratégies d’agrégation
Note
La norme internationale officielle pour GQL est ISO/IEC 39075 Information Technology - Database Languages - GQL.
Si vous cherchez des conseils orientés tâches plutôt qu’un guide linguistique, consultez les guides pratiques :
- Écrire des requêtes GQL courantes : voisins, traversées multi-tronçons, connexions partagées et vérifications de l’existence d’entités
- Filtrer et agréger des données de graphique : FILTRE, WHERE, GROUP BY et fonctions d’agrégation
- Écrire des requêtes de modèles de graphique : modèles à plusieurs tronçons, modes de chemin, réutilisation des variables et CORRESPONDANCE FACULTATIVE
- Optimiser les performances des requêtes GQL : stratégie de filtrage, limites de traversée et recommandations de contraintes clés
Utilisez les articles de référence ciblés lorsque vous avez besoin de détails complets :
| Informations requises | Article définitif |
|---|---|
| Syntaxe en un clin d’œil | Référence rapide GQL |
| Syntaxe de composition de nœuds, arêtes, chemins et motifs | Modèles de graphique GQL |
| Opérateurs, prédicats et fonctions | Expressions, prédicats et fonctions GQL |
| Syntaxe littérale, comportement de valeur et conversions de types | Valeurs et types de valeurs GQL |
| Définitions et contraintes de types de graphes | Types de graphiques GQL |
| Couverture actuelle des fonctionnalités ISO GQL | Conformité à la norme GQL |
| Restrictions et limites actuelles spécifiques à Fabric | Limites actuelles |
Prerequisites
Avant de commencer, vérifiez que vous êtes familiarisé avec ces concepts :
- Basic understanding of databases - Experience with any database system as relational (SQL), NoSQL ou graph est utile.
- Concepts du graphique : compréhension des nœuds, des arêtes et des relations dans les données connectées.
- Principes fondamentaux de la requête : connaissance des concepts de base de requête tels que le filtrage, le tri et l’agrégation.
Arrière-plan recommandé :
- L’expérience avec les langages SQL ou openCypher facilite l’apprentissage de la syntaxe GQL (il s’agit des racines de GQL).
- La connaissance de la modélisation des données permet de concevoir des schémas de graphe.
- Compréhension de votre cas d’usage spécifique pour les données de graphe.
Ce dont vous avez besoin :
- Accès à un espace de travail de graphe avec des fonctionnalités de requête.
- Exemples de données ou de volonté d’utiliser nos exemples de réseaux sociaux.
- Éditeur de texte de base pour l’écriture de requêtes.
Conseil / Astuce
Si vous débutez avec les bases de données de graphe, commencez par la vue d’ensemble des modèles de données de graphe avant de continuer avec ce guide.
Ce qui rend GQL spécial
GQL est conçu spécifiquement pour les données de graphes, donc sa syntaxe exprime directement comment les entités sont connectées. Alors que SQL exprime couramment des relations via des jointures entre tables, GQL utilise des motifs graphiques qui ressemblent à des diagrammes des données.
Par exemple, la requête suivante trouve des paires de personnes qui se connaissent et qui sont toutes deux nées avant 1999 :
MATCH (person:Person)-[:knows]-(friend:Person)
WHERE person.birthday < 19990101
  AND friend.birthday < 19990101
RETURN person.firstName || ' ' || person.lastName AS person_name,
       friend.firstName || ' ' || friend.lastName AS friend_name
Le schéma (person:Person)-[:knows]-(friend:Person) montre la structure de la relation correspondante. Les variables lient les deux personnes afin que la requête puisse filtrer et retourner leurs propriétés.
Principes fondamentaux de GQL
Ces concepts forment la base du GQL :
- Les graphes contiennent des nœuds et des arêtes avec des étiquettes et des propriétés.
- Les types de graphes définissent formellement les types de nœuds, les types d’arêtes et les contraintes autorisées dans un graphe.
-
Les requêtes utilisent des instructions telles que
MATCH,FILTER, etRETURNpour traiter les données et produire des résultats. - Les motifs décrivent les structures de graphes correspondantes.
- Les expressions calculent, transforment et comparent les valeurs.
- Les prédicats sont des expressions booléennes utilisées pour tester les conditions.
- Les types de valeurs définissent les types de valeurs que les requêtes peuvent traiter et les propriétés du graphe peuvent stocker.
Comprendre les données graphiques
Pour travailler avec GQL, il faut comprendre la structure du graphe de propriétés étiqueté que le langage interroge.
Nœuds et arêtes : blocs de construction
Un graphe de propriétés étiquetées contient deux types d’éléments de graphe :
- Les nœuds représentent généralement des entités, telles que des personnes, des organisations, des publications ou des produits.
- Les arêtes représentent des connexions entre les nœuds, comme une personne qui connaît une autre personne ou travaille dans une entreprise.
Chaque élément de graphe possède une identité interne, une ou plusieurs étiquettes, et un ensemble de propriétés. Les étiquettes classifient les éléments, tels que Person ou knows. Les propriétés sont des paires nom-valeur, telles que firstName: 'Alice' ou birthday: 19730108u. Dans Graph, une arête a toujours exactement une étiquette.
Chaque arête relie exactement deux nœuds : une origine et une cible. La direction des arêtes fait partie de la structure du graphe. Par exemple, une workAt arête peut relier une Person origine à une Company cible.
Note
Graph ne supporte actuellement pas la création d’arêtes non orientées. Vous pouvez interroger une arête dirigée existante dans l’une ou l’autre direction en utilisant un motif d’arêtes orientées n’importe quelle comme -[:knows]-.
Les graphes sont bien formés : chaque arête relie deux nœuds qui existent dans le même graphe.
Modèles de graphe et types de graphiques
Un modèle de graphe Fabric définit les types de nœuds, les types d’arêtes, les propriétés, les correspondances sources et les clés disponibles dans un graphe. Il précise quelles lignes de la table source deviennent des nœuds et des arêtes et comment ces éléments se connectent. Pour des conseils de modélisation, voir Concevoir un schéma de graphe.
La norme GQL utilise un type de graphe pour décrire formellement les types de nœuds autorisés, les types d’arêtes, les propriétés et les contraintes. Les types de graphes sont l'équivalent au niveau du langage de la structure représentée par un modèle de graphe Fabric, mais Graph n'accepte actuellement pas directement les déclarations de type graphe GQL. Pour la syntaxe formelle et les concepts, voir types de graphes GQL.
Exemple de graphe utilisé dans ce guide
Des exemples utilisent le jeu de données d’échantillons des réseaux sociaux, qui inclut les personnes, les lieux, les organisations, les messages, les tags et les contours qui les relient.
Le graphe exemple relie ces zones :
- Les gens connaissent d’autres personnes, travaillent dans des entreprises et étudient à l’université.
- Les villes, pays ou régions, et continents forment une hiérarchie géographique.
- Les forums contiennent des publications, et les gens créent des publications et des commentaires.
- Les tags catégorisent le contenu et représentent les intérêts des gens.
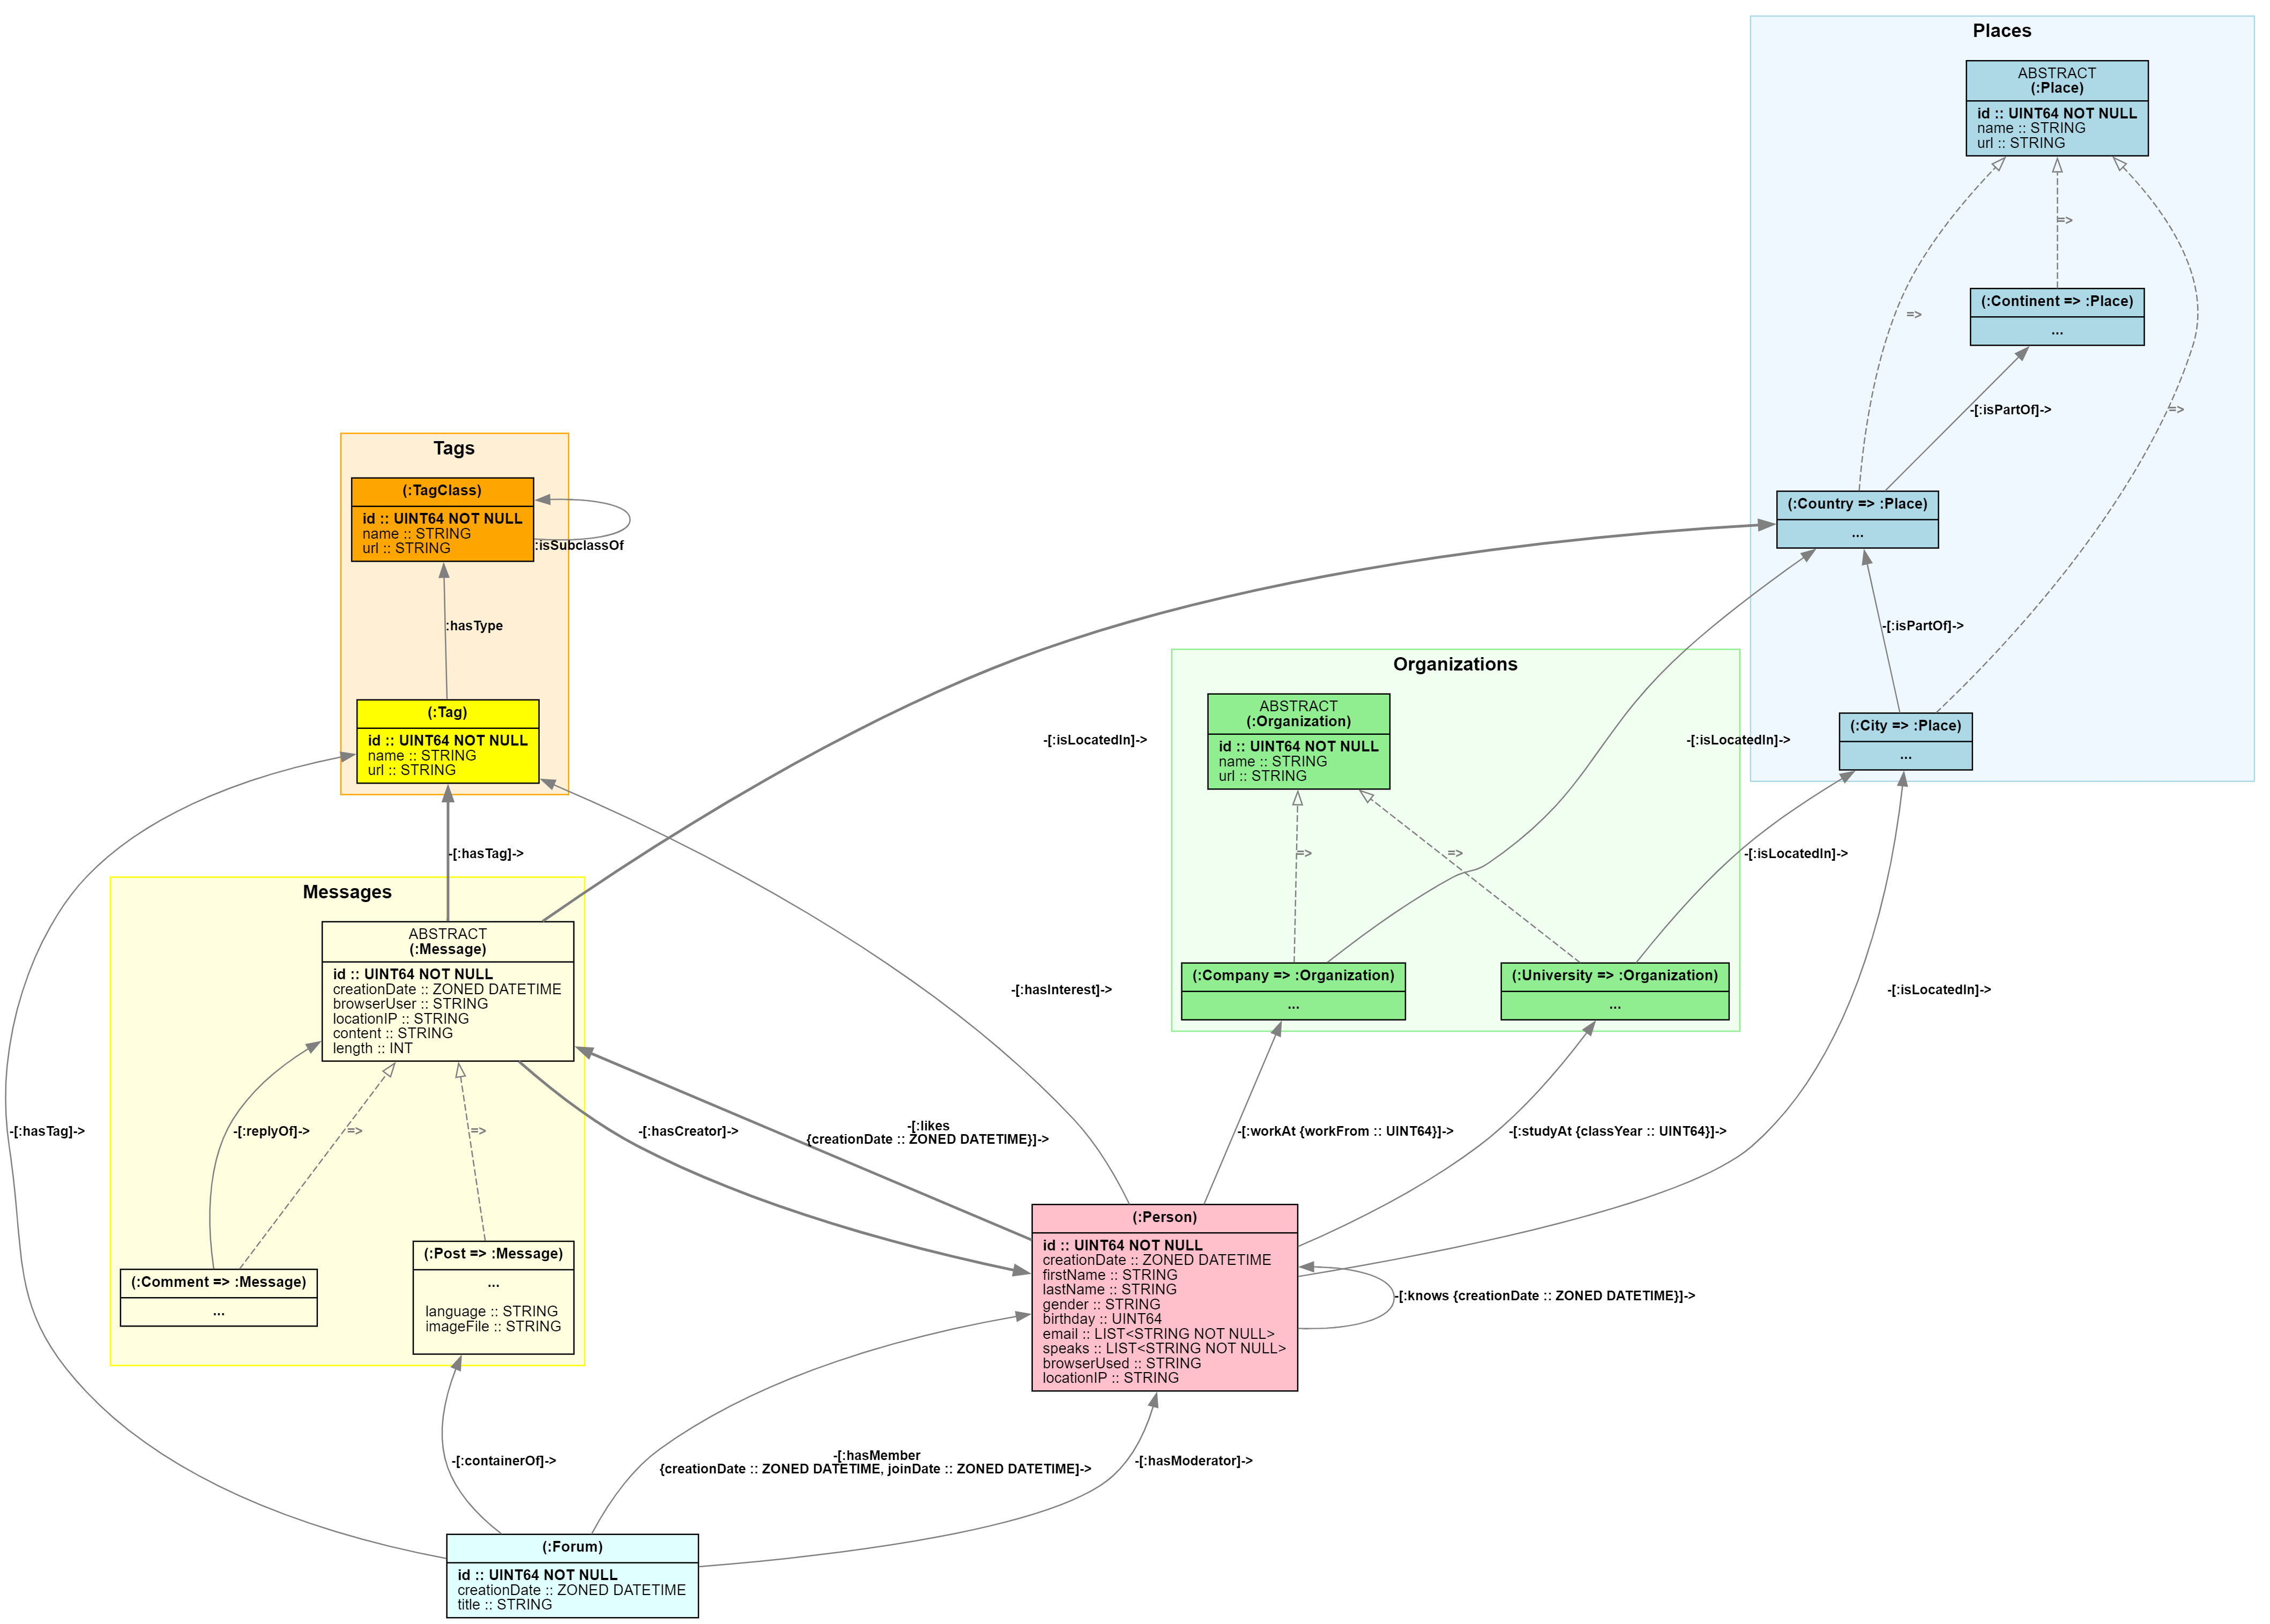
Pour la structure complète de l’exemple, voir l’exemple du schéma des réseaux sociaux. Pour des concepts généraux de graphes, voir Graphes de propriétés étiquetés.
Vos premières requêtes GQL
Maintenant que vous comprenez les principes de base du graphique, voyons comment interroger des données de graphe à l’aide de GQL. Ces exemples proviennent de simples à complexes, montrant comment l’approche de GQL rend les requêtes graphiques intuitives et puissantes.
Démarrer simple : trouver toutes les personnes
Commencez par la requête la plus simple possible. Recherchez les noms (prénom, nom) de toutes les personnes (:Persons) dans le graphique.
MATCH (p:Person)
RETURN p.firstName, p.lastName
Cette requête s’exécute comme suit :
-
MATCHrecherche tous les nœuds étiquetésPerson. -
RETURNaffiche leur prénom et leur nom.
Ajouter un filtrage : rechercher des personnes spécifiques
Maintenant, trouvez des personnes avec des caractéristiques spécifiques. Dans ce cas, recherchez tout le monde nommé Alice et affichez leurs noms et leurs anniversaires.
MATCH (p:Person)
FILTER p.firstName = 'Alice'
RETURN p.firstName, p.lastName, p.birthday
Cette requête s’exécute comme suit :
-
MATCHrecherche tous les nœuds (p) étiquetés Person. -
FILTERnœuds (p) dont le prénom est Alice. -
RETURNaffiche son prénom, son nom et son anniversaire.
Structure de requête de base
Les requêtes GQL de base suivent tous un modèle cohérent : une séquence d’instructions qui fonctionnent ensemble pour rechercher, filtrer et retourner des données.
La plupart des requêtes commencent par MATCH trouver des motifs dans le graphe et se terminent par RETURN spécifier la sortie.
Voici une requête simple qui trouve des paires de personnes qui se connaissent et ont la même date de naissance, puis retourne le total de ces paires d’amis.
MATCH (n:Person)-[:knows]-(m:Person)
FILTER n.birthday = m.birthday
RETURN count(*) AS same_age_friends
Cette requête s’exécute comme suit :
-
MATCHrecherche toutes les paires dePersonnœuds qui se connaissent mutuellement. -
FILTERgarde uniquement les paires où les deux personnes ont le même anniversaire. -
RETURNcompte combien de paires d’amis existent.
Conseil / Astuce
Vous pouvez aussi filtrer directement dans un motif en ajoutant une WHERE clause. Par exemple, ne MATCH (n:Person WHERE n.birthday < 19900101) correspond qu’aux Person nœuds ayant une birthday valeur antérieure à 1990.
GQL prend en charge les commentaires de ligne de style // C, les commentaires de ligne de style -- SQL et les commentaires de bloc de style /* */ C.
Énoncés courants
-
MATCH: Identifie le motif graphique à rechercher — c’est là que vous définissez la structure des données qui vous intéressent. -
LET: Attribue de nouvelles variables ou des valeurs calculées en fonction de données appariées — ajoute des colonnes dérivées au résultat. -
FOR: Développe une liste en lignes, avec une position ordinale optionnelle basée sur un décalage zéro ou une base. -
CALL: Exécute une sous-requête en ligne pour chaque ligne d’entrée et ajoute les colonnes retournées par la sous-requête. -
FILTER: Réduit les résultats en appliquant des conditions — supprime les lignes qui ne remplissent pas les critères. -
ORDER BY: Trie les données filtrées — aide à organiser la sortie selon un ou plusieurs champs. -
OFFSETetLIMIT: Restreignez le nombre de lignes retournées — utile pour la pagination ou les requêtes top-k. -
RETURN: Spécifie la sortie finale — définit quelles données doivent être incluses dans l’ensemble de résultats et effectue l’agrégation. -
NEXT: Démarre une autre étape de requête en utilisant les colonnes retournées de l’étape précédente.
Fonctionnement des instructions
Les instructions GQL forment un pipeline, où chaque instruction traite la sortie de la précédente. Cette exécution séquentielle facilite la lecture et le débogage des requêtes car l’ordre d’exécution correspond à l’ordre de lecture.
Points clés :
- Les instructions s’exécutent efficacement de manière séquentielle.
- Chaque instruction transforme les données et les transmet à la suivante.
- Ce processus crée un flux de données clair et prévisible qui simplifie les requêtes complexes.
-
NEXTCommence une nouvelle étape de requête. Seules les colonnes projetées par l’énoncéRETURNprécédent sont disponibles à l’étape suivante. -
UNION,UNION DISTINCT, etUNION ALLcombinons les résultats des blocs complets de requête.
Note
Les énoncés ont un ordre logique défini. Écrivez les requêtes selon ce flux de données plutôt que de vous fier à une stratégie d’exécution physique particulière.
Exemple de composition d’instructions
La requête GQL suivante montre les 10 premières personnes travaillant dans les entreprises avec « Air » dans leur nom, les trie par nom complet, puis retourne leur nom complet ainsi que celui de leur entreprise.
-- Data flows: Match → Let → Filter → Order → Limit → Return
MATCH (p:Person)-[:workAt]->(c:Company)           -- Input: unit table, Output: (p, c) table
LET fullName = p.firstName || ' ' || p.lastName   -- Input: (p, c) table, Output: (p, c, fullName) table
FILTER c.name CONTAINS 'Air'                      -- Input: (p, c, fullName) table, Output: filtered table
ORDER BY fullName                                 -- Input: filtered table, Output: sorted table
LIMIT 10                                          -- Input: sorted table, Output: top 10 rows table
RETURN fullName, c.name AS companyName            -- Input: top 10 rows table
                                                  -- Output: projected (fullName, companyName) result table
Cette requête s’exécute comme suit :
-
MATCHTrouve des personnes qui travaillent dans des entreprises. -
LETcrée des noms complets en combinant les prénoms et les noms de famille. -
FILTERne garde que les employés des entreprises ayant « Air » dans leur nom d’entreprise. -
ORDER BYtrie par nom complet. -
LIMITprend les 10 premiers résultats. -
RETURNRetour des noms complets et des noms de l’entreprise.
Les variables connectent vos données
Les variables, telles que p, cet fullName dans les exemples précédents, portent des données entre des instructions. Lorsque vous réutilisez un nom de variable, GQL garantit automatiquement qu’il fait référence aux mêmes données, créant des conditions de jointure puissantes. Les variables sont parfois également appelées variables de liaison.
Vous pouvez catégoriser les variables de différentes façons :
Par source de liaison :
- Variables de modèle - liées par des modèles de graphique correspondants
- Variables régulières - liées par d’autres constructions de langage
Types de variables de modèle :
-
Variables d’élément : liaison à des valeurs de référence d’élément de graphe
- Variables de nœud : liaison à des nœuds individuels
- Variables de périphérie : liaison à des arêtes individuelles
- Variables de chemin d’accès : liaison à des valeurs de chemin représentant des chemins correspondants
Par degré de référence :
- Variables Singleton : liaison à des valeurs de référence d’élément individuelles à partir de modèles
- Variables de groupe - lier à des listes de valeurs de référence d’éléments issues de motifs à longueur variable. Pour plus de détails, voir Fonctions agrégées.
Résultats et résultats d’exécution
Lorsque vous exécutez une requête, vous obtenez un résultat d’exécution composé des éléments suivants :
-
Un résultat, normalement un tableau de résultats avec les données de votre
RETURNénoncé. - Informations d’état qui indiquent si la requête a réussi ou non.
Tables de résultats
La table de résultats ( le cas échéant) est le résultat réel de l’exécution de la requête.
Une table de résultats inclut des informations sur le nom et le type de ses colonnes, une séquence de noms de colonne préférée à utiliser pour afficher les résultats, si la table est ordonnée et les lignes réelles elles-mêmes.
Note
En cas d’échec de l’exécution, aucune table de résultats n’est incluse dans le résultat d’exécution.
Résultats omis
GQL définit également un résultat omis pour les énoncés qui ne produisent jamais de lignes, indépendamment des données ou du résultat d’évaluation. Un résultat omis a un code 00001de statut de réussite .
Un résultat omis diffère d’un tableau de résultats vide. Une table vide signifie qu’une requête générant des lignes a été évaluée mais n’a produit aucune ligne. L’API de requête peut représenter un résultat omis avec le type NOTHINGde résultat .
Graph reserves a omis les résultats pour le support futur des instructions du langage de définition de données (DDL) et du langage de manipulation de données (DML). Les instructions de requête actuelles produisent des résultats de tables, y compris des tables vides.
Informations d’état
Pendant l’exécution de la requête, le processus détecte différentes conditions notables, telles que des erreurs ou des avertissements. Chaque condition est enregistrée par un objet d’état dans les informations d’état du résultat d’exécution.
Les informations d’état se composent d’un objet d’état principal et d’une liste (éventuellement vide) d’autres objets d’état. L’objet d’état principal existe toujours et indique si l’exécution de la requête a réussi ou échoué.
Chaque objet d’état inclut un code alphanumérique de cinq caractères et une description de la condition enregistrée.
L’API de requête utilise les codes de statut principaux suivants :
| Code d’état API | Sens |
|---|---|
00000 |
Réussite avec au moins une ligne. |
00001 |
Réussite avec un résultat omis. Réservé pour un futur support DDL et DML. |
01000 |
Un avertissement ou une information sur la situation. |
02000 |
Aucune ligne n’est actuellement disponible à partir d’une requête de production de lignes. |
42000 |
Une erreur de requête corrigable par l’utilisateur. |
50000 |
Une erreur système ou non classifiée. |
L’API conserve l’état GQL canonique rapporté par le moteur de requête dans le _graphaneGqlStatus membre de l’enregistrement de diagnostic. Par exemple, le dépassement numérique utilise le GQLSTATUS 22003canonique , tandis que la division par zéro utilise 22012; les deux sont représentés par 42000 dans le champ public status.code .
Important
Dans le code applicatif, utilisez status.code pour un succès large et une gestion des erreurs. Utilisez le diagnostic canonique GQLSTATUS lorsque vous devez distinguer une condition de requête spécifique. Ne testez pas le texte de la description car cela peut varier.
En outre, les objets d’état peuvent contenir un objet d’état de cause sous-jacent et un enregistrement de diagnostic avec d’autres informations qui caractérisent la condition enregistrée.
Concepts et instructions essentiels
Cette section couvre les blocs de construction principaux dont vous avez besoin pour écrire des requêtes GQL effectives. Chaque concept s’appuie sur des compétences pratiques en écriture de requêtes.
Motifs graphiques : trouver la structure
Un motif graphique décrit les nœuds, arêtes et chemins à correspondre. Lier les variables lorsque les instructions ultérieures doivent se référer à des éléments appariés :
MATCH (person:Person)-[employment:workAt]->(company:Company)
RETURN person.firstName, company.name, employment.workFrom
Place un prédicat en ligne lorsqu’il définit quel nœud ou arête peut participer au motif :
MATCH (person:Person WHERE person.firstName = 'Alice')
      -[:knows]->(friend:Person)
RETURN friend.firstName, friend.lastName
Réutiliser une variable pour nécessiter deux positions de motif afin de lier le même élément.
Séparer les motifs avec des virgules pour composer des structures de graphes plus grandes. Utilisez un quantificateur par {1,4} exemple pour répéter un motif d’arêtes et faire correspondre des chemins de longueur variable.
Les modes de chemin contrôlent la réutilisation des éléments à l’intérieur d’un chemin :
| Mode chemin | Comportement |
|---|---|
WALK |
Autorise les nœuds et les arêtes répétés. Ce mode est la valeur par défaut. |
TRAIL |
Ça empêche les bords répétés. |
SIMPLE |
Empêche la répétition des nœuds sauf pour un premier et un dernier nœud partagés. |
ACYCLIC |
Empêche tous les nœuds répétés. |
Un préfixe de recherche de chemin détermine quels chemins correspondants sont retournés.
ALL est la valeur par défaut.
ANY SHORTEST renvoie un chemin le plus court pour chaque paire source-destination :
MATCH path = ANY SHORTEST
  (source:Person WHERE source.id = 123u)-[:knows]->{1,4}(target:Person)
RETURN target.id, path_length(path) AS hopCount
Les prédicats en ligne limitent l’éligibilité des chemins avant la sélection des chemins.
Les opérations au niveau MATCH ... WHERE de l’instruction et les opérations ultérieures FILTER sont des postfiltres.
Cette distinction peut modifier ANY SHORTEST les résultats.
Pour la sémantique définitive des nœuds, arêtes, chemins, compositions, quantificateurs et de placement des prédicats, voir les motifs de graphes GQL. Pour les restrictions de chemin actuelles, voir Limitations actuelles.
Instructions principales
GQL fournit des types d’instructions spécifiques qui fonctionnent ensemble pour traiter vos données de graphe pas à pas. La compréhension de ces instructions est essentielle pour générer des requêtes efficaces.
Instruction MATCH
Syntaxe :
MATCH <graph pattern>, <graph pattern>, ... [ WHERE <predicate> ]
L’instruction MATCH prend des données d’entrée et recherche des modèles de graphique. Il joint des variables d’entrée avec des variables de modèle et génère toutes les combinaisons correspondantes.
Variables d’entrée et de sortie :
-- Input: unit table (no columns, one row)
-- Pattern variables: p, c
-- Output: table with (p, c) columns for each person-company match
MATCH (p:Person)-[:workAt]->(c:Company)
Filtrage au niveau de l’instruction à l’aide de WHERE :
-- Filter pattern matches
MATCH (p:Person)-[:workAt]->(c:Company) WHERE p.lastName = c.name
Vous pouvez publier le filtrage de toutes les correspondances à l’aide WHEREde . Cette approche évite une instruction distincte FILTER . Avec un préfixe de recherche de chemin tel que ANY SHORTEST, le niveau WHERE d’instruction s’applique après la sélection de chemin. Les prédicats en ligne contraignent plutôt quels chemins sont éligibles à la sélection. Pour plus d’informations, voir Place prédicats avant ou après la sélection du chemin.
Jointure à l’aide de variables d’entrée :
Quand MATCH n’est pas la première instruction, elle joint les données d’entrée avec des correspondances de modèle :
...
-- Input: table with 'targetCompany' column
-- Implicit join: targetCompany (equality join)
-- Output: table with (targetCompany, p, r) columns
MATCH (p:Person)-[r:workAt]->(targetCompany)
Important
Graph prend en compte la composition d’énoncés linéaires de base et complète, incluant NEXT. Vous pouvez aussi combiner des blocs de requête avec UNION, UNION DISTINCT, et UNION ALL. Les EXCEPTopérations , INTERSECT, et OTHERWISE set ne sont pas encore prises en charge. Pour plus d’informations, consultez l’article sur les limitations actuelles.
Comportements de jointure de clés :
Comment MATCH gère la jonction de données :
- Égalité des variables : jointure de variables d’entrée avec des variables de modèle à l’aide de la correspondance d’égalité
-
Jointure interne : les lignes d’entrée sans correspondances de modèle sont ignorées. Utiliser
OPTIONAL MATCHpour le comportement de jointure externe gauche. -
Ordre de filtrage : Filtres au niveau
WHEREde l’instruction après la correspondance de motifs et la sélection de chemin terminée - Composition du motif : Les variables partagées contraignent les motifs au même élément. Les motifs déconnectés forment un produit cartésien.
Important
Un motif déconnecté est valide, mais son produit cartésien peut créer de nombreuses lignes. Utilisez des variables partagées lorsque les motifs devraient se référer aux mêmes éléments du graphe.
Combinez des motifs avec des variables partagées :
-- Shared variable 'p' joins the two patterns
-- Output: people with both workplace and residence data
MATCH (p:Person)-[:workAt]->(c:Company),
      (p)-[:isLocatedIn]->(city:City)
Instruction OPTIONAL MATCH
Syntaxe :
OPTIONAL MATCH <graph pattern> [ WHERE <predicate> ]
OPTIONAL MATCH fonctionne comme MATCH mais utilise la sémantique de jointure externe gauche. Si le modèle ne trouve aucune correspondance pour une ligne d’entrée, la requête conserve la ligne avec NULL des valeurs pour les variables sans correspondance au lieu de l’ignorer.
Exemple :
-- Find all people and, if available, their workplace
MATCH (p:Person)
OPTIONAL MATCH (p)-[:workAt]->(c:Company)
RETURN p.firstName, p.lastName, c.name AS company_name
Les personnes qui ne travaillent pas dans une entreprise apparaissent toujours dans les résultats avec NULLcompany_name.
Conseil / Astuce
Utilisez OPTIONAL MATCH quand vous souhaitez inclure des entités qui n’ont peut-être pas de relation particulière, similaires à sql LEFT JOIN.
Instruction LET
Syntaxe :
LET <variable> = <expression>, <variable> = <expression>, ...
L’instruction LET crée des variables calculées et active la transformation des données dans votre pipeline de requête.
Création de variables de base :
MATCH (p:Person)
LET fullName = p.firstName || ' ' || p.lastName
RETURN *
LIMIT 1000
Calculs complexes :
MATCH (p:Person)
LET adjustedAge = 2000 - (p.birthday / 10000),
    fullProfile = p.firstName || ' ' || p.lastName || ' (' || p.gender || ')'
RETURN *
LIMIT 1000
Comportements clés :
- Le moteur de requête évalue les expressions pour chaque ligne d’entrée.
- Les résultats deviennent de nouvelles colonnes dans la table de sortie.
- Les variables peuvent uniquement référencer des variables existantes à partir d’instructions précédentes.
- Plusieurs affectations dans une
LETinstruction utilisent la même portée d’entrée, donc une assignation ne peut pas référencer une autre assignation à partir de cette instruction.
Instruction FOR
Syntaxe :
FOR <variable> IN <list_expression>
  [ WITH OFFSET <offset_variable> | WITH ORDINALITY <ordinality_variable> ]
L’instruction FOR élargit une liste en lignes. Pour chaque ligne d’entrée, elle émet une ligne de sortie pour chaque élément de liste et lie cet élément à la variable spécifiée. D’autres variables issues de la ligne d’entrée restent disponibles.
Utiliser WITH OFFSET pour lier un indice à base de zéros, ou pour WITH ORDINALITY lier une position à base d’un ?
LET cities = ['Seattle', 'London', 'Tokyo']
FOR city IN cities WITH ORDINALITY position
RETURN city, position
Cette requête renvoie une ligne pour chaque ville. Les position valeurs sont 1, 2, et 3. Si vous remplacez WITH ORDINALITY position par WITH OFFSET position, les valeurs sont 0, 1, et 2.
L’expression source doit être évaluée à une liste. Une valeur non listée provoque l’échec de la requête.
Instruction CALL
À utiliser CALL pour lancer une sous-requête en ligne pour chaque ligne d’entrée :
CALL {
  <query statements>
  RETURN <columns>
}
Les variables déjà dans le champ d’application sont implicitement disponibles à l’intérieur de la sous-requête. Parmi les variables créées à l’intérieur de la sous-requête, seules les colonnes de sa déclaration finale RETURN deviennent disponibles en dehors de celle-ci. Les variables créées dans la sous-requête mais non retournées restent locales.
La sous-requête corrélée suivante calcule un nombre d’employeurs pour chaque personne :
MATCH (p:Person)
CALL {
  MATCH (p)-[:workAt]->(company:Company)
  RETURN count(*) AS employerCount
}
RETURN p.firstName, p.lastName, employerCount
ORDER BY employerCount DESC
Un ordinaire CALL agit comme une jonction intérieure dépendante. Il produit une ligne de sortie pour chaque ligne retournée par la sous-requête. Si la sous-requête ne retourne aucune ligne, la ligne externe correspondante n’est pas retournée. Si elle retourne plusieurs lignes, la ligne extérieure apparaît une fois pour chaque ligne de sous-requête.
L’exemple count(*) précédent retourne toujours une ligne de sous-requête car il utilise un agrégat non groupé. Une personne sans employeur correspondant a donc un employerCount .0
À utiliser OPTIONAL CALL comme une jonction à gauche dépendante. Lorsque la sous-requête ne retourne aucune ligne, elle préserve une ligne extérieure et fixe les colonnes de sous-requête retournées à NULL. Lorsque la sous-requête retourne plusieurs lignes, elle produit une ligne de sortie pour chaque ligne de sous-requête.
MATCH (p:Person)
OPTIONAL CALL {
  MATCH (p)-[:workAt]->(company:Company)
  RETURN company.name AS companyName
}
RETURN p.firstName, p.lastName, companyName
Vous pouvez imbriquer des sous-requêtes en ligne CALL . Une sous-requête imbriquée peut référencer des variables à partir de ses péripéties de requête entourantes.
Important
Terminez chaque corps en ligne CALL par RETURN. Graph ne supporte pas les appels de procédures nommées ni les listes d’importation explicites de variables telles que CALL (p) { ... }.
Instruction FILTER
Syntaxe :
FILTER [ WHERE ] <predicate>
L’instruction FILTER fournit un contrôle précis sur les données qui transitent par votre pipeline de requête.
Filtrage de base :
MATCH (p:Person)
FILTER p.birthday < 19980101 AND p.gender = 'female'
RETURN *
Conditions logiques complexes :
MATCH (p:Person)
FILTER (p.gender = 'male' AND p.birthday < 19940101)
  OR (p.gender = 'female' AND p.birthday < 19990101)
  OR p.browserUsed = 'Edge'
RETURN *
Modèles de filtrage prenant en compte les valeurs Null :
Utilisez ces modèles pour gérer les valeurs Null en toute sécurité :
-
Rechercher les valeurs :
p.firstName IS NOT NULL- a un prénom -
Valider les données :
p.id > 0- ID valide -
Gérer les données manquantes : -
NOT coalesce(p.locationIP, '10.x.x.x') STARTS WITH '10.x.x.x'n’a pas été connecté à partir du réseau local -
Combiner des conditions : Utiliser
AND/ORavec des vérifications null explicites pour une logique complexe
Caution
N’oubliez pas que les conditions impliquant des valeurs Null retournent UNKNOWN, ce qui filtre ces lignes. Utilisez des vérifications explicites IS NULL lorsque vous avez besoin d’une logique inclusive null.
Instruction ORDER BY
Syntaxe :
ORDER BY <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ],
         <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ], ...
Tri à plusieurs niveaux avec des expressions calculées :
MATCH (p:Person)
RETURN *
ORDER BY p.firstName DESC,               -- Primary: by first name (Z-A)
         p.birthday ASC,                 -- Secondary: by age (oldest first)
         p.id DESC                       -- Tertiary: by ID (highest first)
Gestion des valeurs Null dans le tri :
MATCH (p:Person)
RETURN p.firstName, p.birthday
ORDER BY p.birthday DESC NULLS LAST, p.firstName ASC
Détails du comportement de tri :
ORDER BY Présentation du fonctionnement :
- Le moteur de requête évalue les expressions pour chaque ligne, puis les résultats déterminent l’ordre des lignes.
- Plusieurs clés de tri créent un ordre hiérarchique (primaire, secondaire, tertiaire, etc.).
-
NULLS FIRSTplace les valeurs nulles avant les valeurs non nulles.NULLS LASTles place après des valeurs non nulles. - Le placement nul est indépendant de la direction de tri. Si vous ne spécifiez pas l’ordre nul,
NULLS LASTest la valeur par défaut pour les deuxASCetDESC. -
ASC(croissant) est l’ordre par défaut, et vous devez spécifierDESCexplicitement (décroissant). - Vous pouvez trier en fonction des valeurs calculées, pas seulement des propriétés stockées.
| Spécification de tri | Ordre résultant |
|---|---|
ASC ou ASC NULLS LAST |
Valeurs non nulles dans l’ordre croissant, suivies de valeurs nulles. |
ASC NULLS FIRST |
Valeurs nulles, suivies de valeurs non nulles dans l’ordre croissant. |
DESC ou DESC NULLS LAST |
Valeurs non nulles dans l’ordre décroissant, suivies de valeurs nulles. |
DESC NULLS FIRST |
Valeurs nulles, suivies de valeurs non nulles dans l’ordre décroissant. |
Caution
Seule l’instruction immédiatement suivante peut voir l’ordre de tri qui ORDER BY établit.
Par conséquent, ORDER BY suivi RETURN * de ne produit pas de résultat ordonné.
Comparer:
MATCH (a:Person)-[r:knows]->(b:Person)
LET aName = a.firstName || ' ' || a.lastName
LET bName = b.firstName || ' ' || b.lastName
ORDER BY r.creationDate DESC
/* intermediary result _IS_ guaranteed to be ordered here */
RETURN aName, bName, r.creationDate AS since
/* final result _IS_ _NOT_ guaranteed to be ordered here  */
avec :
MATCH (a:Person)-[r:knows]->(b:Person)
LET aName = a.firstName || ' ' || a.lastName
LET bName = b.firstName || ' ' || b.lastName
/* intermediary result _IS_ _NOT_ guaranteed to be ordered here */
RETURN aName, bName, r.creationDate AS since
ORDER BY r.creationDate DESC
/* final result _IS_ guaranteed to be ordered here              */
Cette différence a des conséquences immédiates pour les requêtes « Top-k » : LIMIT doit toujours suivre l’instruction ORDER BY qui établit l’ordre de tri prévu.
Déclarations OFFSET et LIMIT
Syntaxe :
  OFFSET <offset> [ LIMIT <limit> ]
| LIMIT <limit>
Modèles courants :
-- Basic top-N query
MATCH (p:Person)
RETURN *
ORDER BY p.id DESC
LIMIT 10                                 -- Top 10 by ID
Important
Pour les résultats de pagination prévisibles, utilisez ORDER BY toujours avant OFFSET et LIMIT pour garantir l’ordre cohérent des lignes entre les requêtes.
RETURN: projection de résultats de base
Syntaxe :
RETURN [ DISTINCT ] <expression> [ AS <alias> ], <expression> [ AS <alias> ], ...
[ ORDER BY <expression> [ ASC | DESC ] [ NULLS FIRST | NULLS LAST ], ... ]
[ OFFSET <offset> ]
[ LIMIT <limit> ]
L’instruction RETURN produit la sortie finale de votre requête en spécifiant les données qui apparaissent dans la table de résultats.
Sortie de base :
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName || ' ' || p.lastName AS name,
       p.birthday,
       c.name
Utilisation d’alias pour plus de clarté :
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName AS first_name,
       p.lastName AS last_name,
       c.name AS company_name
Combiner avec le tri et le top-k :
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName || ' ' || p.lastName AS name,
       p.birthday AS birth_year,
       c.name AS company
ORDER BY birth_year ASC
LIMIT 10
Gestion dupliquée à l’aide de DISTINCT :
-- Remove duplicate combinations
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN DISTINCT p.gender, p.browserUsed, p.birthday AS birth_year
ORDER BY p.gender, p.browserUsed, birth_year
Combiner avec l’agrégation :
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN count(DISTINCT p) AS employee_count
RETURN avec GROUP BY: projection de résultat groupée
Syntaxe :
RETURN [ DISTINCT ] <expression> [ AS <alias> ], <expression> [ AS <alias> ], ...
GROUP BY <variable>, <variable>, ...
[ ORDER BY <expression> [ ASC | DESC ], <expression> [ ASC | DESC ], ... ]
[ OFFSET <offset> ]
[ LIMIT <limit> ]
Permet GROUP BY de regrouper des lignes par valeurs partagées et de calculer des fonctions d’agrégation au sein de chaque groupe.
Regroupement de base avec agrégation :
MATCH (p:Person)-[:workAt]->(c:Company)
LET companyId = c.id, companyName = c.name
RETURN companyId,
       companyName,
       count(*) AS employeeCount,
       avg(p.birthday) AS avg_birth_year
GROUP BY companyId, companyName
ORDER BY employeeCount DESC
Regroupement à plusieurs colonnes :
MATCH (p:Person)
LET gender = p.gender
LET browser = p.browserUsed
RETURN gender,
       browser,
       count(*) AS person_count,
       avg(p.birthday) AS avg_birth_year,
       min(p.creationDate) AS first_joined,
       max(p.id) AS highest_id
GROUP BY gender, browser
ORDER BY avg_birth_year DESC
LIMIT 10
Note
Pour l’agrégation horizontale sur des motifs de longueur variable, voir Fonctions agrégées.
Valeurs et types de valeurs
Les valeurs GQL incluent Booléen, chaîne, numérique, temporal, liste, nœud, arête, chemin, nul et rien. Les types sont nullables sauf si vous spécifiez NOT NULL.
Les propriétés utilisent un sous-ensemble supporté du système complet de valeurs de requête.
RETURN 42 AS integerValue,
       'Alice' AS stringValue,
       TRUE AS booleanValue,
       [1, 2, 3] AS listValue
Les comparaisons avec null évaluent à UNKNOWN; utilisent IS NULL et IS NOT NULL pour les tests nuls. Les opérations numériques peuvent appliquer des conversions implicites entre types numériques compatibles.
Note
Tous les types de valeur GQL ne sont pas pris en charge dans tous les contextes de graphes. Pour les restrictions actuelles de propriété et de requête, voir Types de données.
Pour la syntaxe littérale, le comportement de comparaison, les conversions de types et la hiérarchie de types, voir valeurs GQL et types de valeurs.
Expressions
Les expressions calculent, comparent, agrégent et transforment les valeurs. Les formes courantes incluent les références de propriétés, les opérateurs arithmétiques et logiques, les prédicats, les appels de fonction, les expressions simples CASE et les sous-requêtes :
MATCH (person:Person)
FILTER person.birthday < 19900101
RETURN person.firstName,
       CASE person.gender
         WHEN 'female' THEN 'F'
         WHEN 'male' THEN 'M'
         ELSE 'Other'
       END AS genderCode
GQL utilise une logique à trois valeurs : les expressions booléennes peuvent évaluer à TRUE, FALSE, ou UNKNOWN. A FILTER ne conserve que les lignes pour lesquelles son prédicat est TRUE.
Agréger des fonctions telles que COUNT, SUM, AVG, MIN, et MAX résumer les lignes. Listez des prédicats tels que ALL, ANY, NONE, et SINGLE évaluez un prédicat pour les éléments de liste. Les sous-requêtes de procédure EXISTS testent si une requête imbriquée retourne une ligne.
Pour le comportement complet des opérateurs, prédicats, agrégats et fonctions, voir expressions, prédicats et fonctions GQL. Pour des exemples de filtrage et de regroupement orientés tâches, voir Filtrer et agréger les données de graphes.
Techniques avancées de requête
Cette section traite des modèles et techniques sophistiqués pour la création de requêtes graphiques complexes et efficaces. Ces modèles vont au-delà de l’utilisation des instructions de base pour vous aider à composer de puissantes requêtes analytiques.
Composition multi-état complexe
Important
Graph prend en charge la composition d’instructions linéaires de base et complète. Les EXCEPTopérations , INTERSECT, et OTHERWISE set ne sont pas encore prises en charge. Pour plus d’informations, consultez l’article sur les limitations actuelles.
Comprendre comment composer efficacement des requêtes complexes est essentiel pour l’interrogation de graphiques avancées.
UNION et UNION ALL
Utilisez UNION, UNION DISTINCT, ou UNION ALL pour combiner les résultats de deux blocs de requête linéaires ou plus :
<query block>
UNION [ DISTINCT | ALL ]
<query block>
-- Combine results from two separate pattern matches
MATCH (p:Person)-[:workAt]->(c:Company)
RETURN p.firstName AS name, c.name AS affiliation
UNION DISTINCT
MATCH (p:Person)-[:studyAt]->(u:University)
RETURN p.firstName AS name, u.name AS affiliation
À nu UNION équivaut à UNION DISTINCT; les deux suppriment les lignes dupliquées.
UNION ALL conserve toutes les lignes, y compris les doublons.
Chaque bloc de requête doit retourner le même ensemble de noms de colonnes. L’ordre des colonnes peut différer selon les blocs, et les types de données doivent être compatibles.
NEXT
À utiliser NEXT pour exécuter une autre étape de requête sur la table retournée par l’étape précédente :
<query stage>
RETURN <columns>
NEXT
<query stage>
La requête suivante trouve les employés et leurs entreprises, puis utilise les nœuds employés retournés dans une autre correspondance de motifs :
MATCH (person:Person)-[:workAt]->(company:Company)
RETURN person, company.name AS companyName
NEXT
MATCH (person)-[:isLocatedIn]->(city:City)
RETURN person.firstName AS employee, companyName, city.name AS city
Seules les colonnes retournées par l’étape précédente sont dans le champ de vision après NEXT. Vous pouvez utiliser plusieurs NEXT séparateurs pour construire une séquence plus longue d’étapes de requête.
Chaque étape peut contenir une union de blocs de requête. Une union est évaluée dans son étage avant que la sortie de l’étape ne franchisse la NEXT frontière. Si , , et C représentent des blocs de requête, A UNION B NEXT C groupe comme (A UNION B) NEXT C, tandis A NEXT B UNION C que groupe comme A NEXT (B UNION C). BA
Instructions conditionnelles
Utilisez une instruction conditionnelle pour acheminer chaque ligne entrante vers la première branche dont le prédicat évalue :TRUE
WHEN <predicate> THEN <linear query statement or { query statements }>
[ WHEN <predicate> THEN <linear query statement or { query statements }> ... ]
[ ELSE <linear query statement or { query statements }> ]
Pour router les lignes d’une étape de requête précédente, retournez les colonnes requises et utilisez NEXT avant l’instruction conditionnelle :
MATCH (p:Person)
RETURN p.firstName AS name, p.birthday AS birthday
NEXT
WHEN birthday < 19800101u THEN
  RETURN name, 'Before 1980' AS era
WHEN birthday < 20000101u THEN
  RETURN name, '1980-1999' AS era
ELSE
  RETURN name, '2000 or later' AS era
Chaque WHEN prédicat doit être booléen. Le moteur de requête évalue les prédicats dans l’ordre de chaque ligne d’entrée. Un prédicat qui évalue ou FALSEUNKNOWN ne sélectionne pas sa branche. Après qu’un prédicat évalue à TRUE, les prédicats ultérieurs et les corps de branches non sélectionnés ne sont pas évalués. Si aucun prédicat n’évalue et TRUE qu’il n’y a pas ELSE, la ligne d’entrée n’est pas retournée.
Les prédicats et les corps de branches peuvent référencer des colonnes de l’étape précédente. Une branche peut être une seule instruction linéaire, ou une procédure imbriquée enfermée entre les crochets. Utilisez une procédure imbriquée lorsqu’une branche nécessite plusieurs étapes ou instructions telles que CALL:
MATCH (p:Person)
RETURN p, p.firstName AS name
NEXT
WHEN p.gender = 'female' THEN {
  CALL {
    MATCH (p)-[:knows]->(friend:Person)
    RETURN count(*) AS friendCount
  }
  RETURN name, friendCount
}
ELSE
  RETURN name, 0u AS friendCount
Chaque branche a son propre champ d’application local. Les branches sœurs ne voient pas les variables créées par une autre branche, et seules les colonnes de la branche finale RETURN de la branche sélectionnée continuent après l’instruction conditionnelle. Chaque branche doit retourner les mêmes noms de colonnes, et les types de résultats correspondants doivent être compatibles. Le moteur de requête contraint les types compatibles à un type de sortie commun. Une colonne de branchement retournée peut utiliser le même nom qu’une colonne entrante ; la valeur de branchement remplace la valeur entrante dans la sortie conditionnelle.
Les énoncés conditionnels sont différents des CASE expressions. Graph supporte des expressions simples CASE <expression> WHEN <value>, mais non recherchées CASE WHEN <predicate> . Pour plus d’informations, voir Expressions conditionnelles.
Étendue variable et contrôle de flux avancé
Les variables connectent les données entre les instructions de requête et activent des traversées de graphique complexes. La compréhension des règles d’étendue avancée vous permet d’écrire des requêtes multi-instructions sophistiquées.
Liaisons de variables et modèles d’étendue
-- Variables flow forward through subsequent statements
MATCH (p:Person)                                    -- Bind p
LET fullName = p.firstName || ' ' || p.lastName     -- Bind concatenation of p.firstName and p.lastName as fullName
FILTER fullName CONTAINS 'Smith'                    -- Filter for fullNames with “Smith” substring (p is still bound)
RETURN p.id, fullName                               -- Only return p.id and fullName (p is dropped from scope)
Réutilisation des variables pour les jointures entre les instructions
-- Multi-statement joins using variable reuse
MATCH (p:Person)-[:workAt]->(:Company)          -- Find people with jobs
MATCH (p)-[:isLocatedIn]->(:City)               -- Same p: people with both job and residence
MATCH (p)-[:knows]->(friend:Person)             -- Same p: their social connections
RETURN *
Règles et limitations d’étendue critiques
-- ✅ Backward references work
MATCH (p:Person)
LET adult = p.birthday < 20061231  -- Can reference p from previous statement
RETURN *

-- ❌ Forward references don't work
LET adult = p.birthday < 20061231  -- Error: p not yet defined
MATCH (p:Person)
RETURN *

-- ❌ Variables in same LET statement can't reference each other
MATCH (p:Person)
LET name = p.firstName || ' ' || p.lastName,
    greeting = 'Hello, ' || name     -- Error: name not visible yet
RETURN *

-- ✅ Use separate statements for dependent variables
MATCH (p:Person)
LET name = p.firstName || ' ' || p.lastName
LET greeting = 'Hello, ' || name     -- Works: name now available
RETURN *
Visibilité des variables dans les requêtes complexes
-- Variables remain visible until overridden or query ends
MATCH (p:Person)                     -- p available from here
LET gender = p.gender                -- gender available from here
MATCH (p)-[:knows]->(e:Person)       -- p still refers to original person
                                     -- e is a new variable for the friend
RETURN p.firstName AS manager, e.firstName AS friend, gender
Caution
Les variables de la même instruction ne peuvent pas se référencer les unes les autres, sauf dans les modèles de graphique. Utilisez des instructions distinctes pour la création de variables dépendantes.
Lignes agrégées et éléments de chemin
GQL prend en charge deux contextes d’agrégation :
-
L’agrégation verticale résume les lignes d’entrée, éventuellement partitionnées par
GROUP BYvariables. - L’agrégation horizontale résume une liste de groupes délimitée par un motif d’arêtes de longueur variable dans un seul chemin correspondant.
MATCH (person:Person)-[:workAt]->(company:Company)
LET companyId = company.id, companyName = company.name
RETURN companyId, companyName, count(*) AS employeeCount
GROUP BY companyId, companyName
MATCH (:Person)-[connections:knows]->{1,4}(:Person)
RETURN count(connections) AS pathLength
Pour les requêtes groupées, les filtres spécifiques à l’agrégat, les agrégats de collection et le routage conditionnel, voir Filtrer et agréger les données de graphes. Pour des règles complètes de résultats agrégés, voir Fonctions agrégées.
Gérer les nulls et les erreurs de requête
Utilisez des tests nuls explicites lorsque les valeurs manquantes nécessitent une gestion distincte :
MATCH (person:Person)
FILTER person.browserUsed IS NULL
RETURN person.firstName
Une comparaison avec null évalue à UNKNOWN, que a FILTER ne conserve pas.
Utilisez-les coalesce() quand vous avez besoin d’une valeur de secours.
Les résultats de requête incluent des informations sur l’état des succès, des avertissements, des conditions sans données, des erreurs corrigables par l’utilisateur et des erreurs système. Utilisez le code d’état public pour un flux de contrôle large et le diagnostic canonique de GQLSTATUS pour une condition spécifique. Voir Résultats et résultats d’exécution ainsi que la référence des codes d’état GQL.
Mots réservés
GQL réserve certains mots clés que vous ne pouvez pas utiliser comme identificateurs tels que des variables, des noms de propriétés ou des noms d’étiquettes. Consultez la référence des mots réservés GQL pour la liste complète.
Si vous devez utiliser des mots réservés en tant qu’identificateurs, placez-les en échappement avec des backticks : `match`, `return`.
Pour éviter d’échapper aux mots réservés, utilisez cette convention d’affectation de noms :
- Pour les identificateurs à mot unique, ajoutez un trait de soulignement :
:Product_ - Pour les identificateurs à plusieurs mots, utilisez camelCase ou PascalCase :
:MyEntity,:hasAttribute,textColor
Étapes suivantes
- Suivez le tutoriel de démarrage rapide ou GQL pour une introduction pratique.
- Utilisez les requêtes GQL courantes Write pour les tâches de graphes prêtes à s’adapter.
- Utilisez les motifs de graphes GQL, les expressions GQL, les prédicats et fonctions, ainsi que les valeurs et types de valeurs GQL pour une référence détaillée.
- Utilisez Design a Graph Scheme pour le flux de travail de modélisation Fabric supporté.