Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Utilisez le kit de traitement par lots pour compléter et effectuer un scale-out des charges de travail sur des conteneurs Speech. Disponible en tant que conteneur, cet utilitaire open source permet de faciliter la transcription par lot pour un grand nombre de fichiers audio, sur des points de terminaison de conteneur Speech locaux et basés sur le cloud.
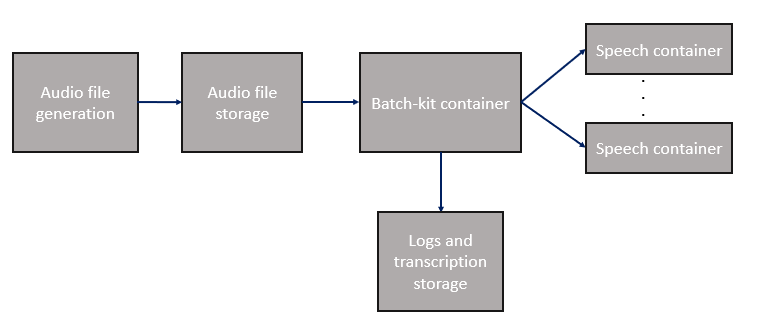
Le conteneur de kits par lots est disponible gratuitement sur GitHub et Docker Hub. Vous n’êtes facturé que pour les conteneurs Speech que vous utilisez.
| Fonctionnalité | Descriptif |
|---|---|
| Distribution de fichiers audio par lot | Distribuer automatiquement un grand nombre de fichiers vers des points de terminaison de conteneur Speech locaux ou basés sur le cloud. Les fichiers peuvent se trouver sur n’importe quel volume compatible POSIX, y compris les systèmes de fichiers réseau. |
| Intégration du Kit de développement logiciel (SDK) Speech | Transmettez les indicateurs courants au kit de développement logiciel (SDK) Speech, notamment : les n meilleures hypothèses, la diarisation, le langage, le masquage des grossièretés. |
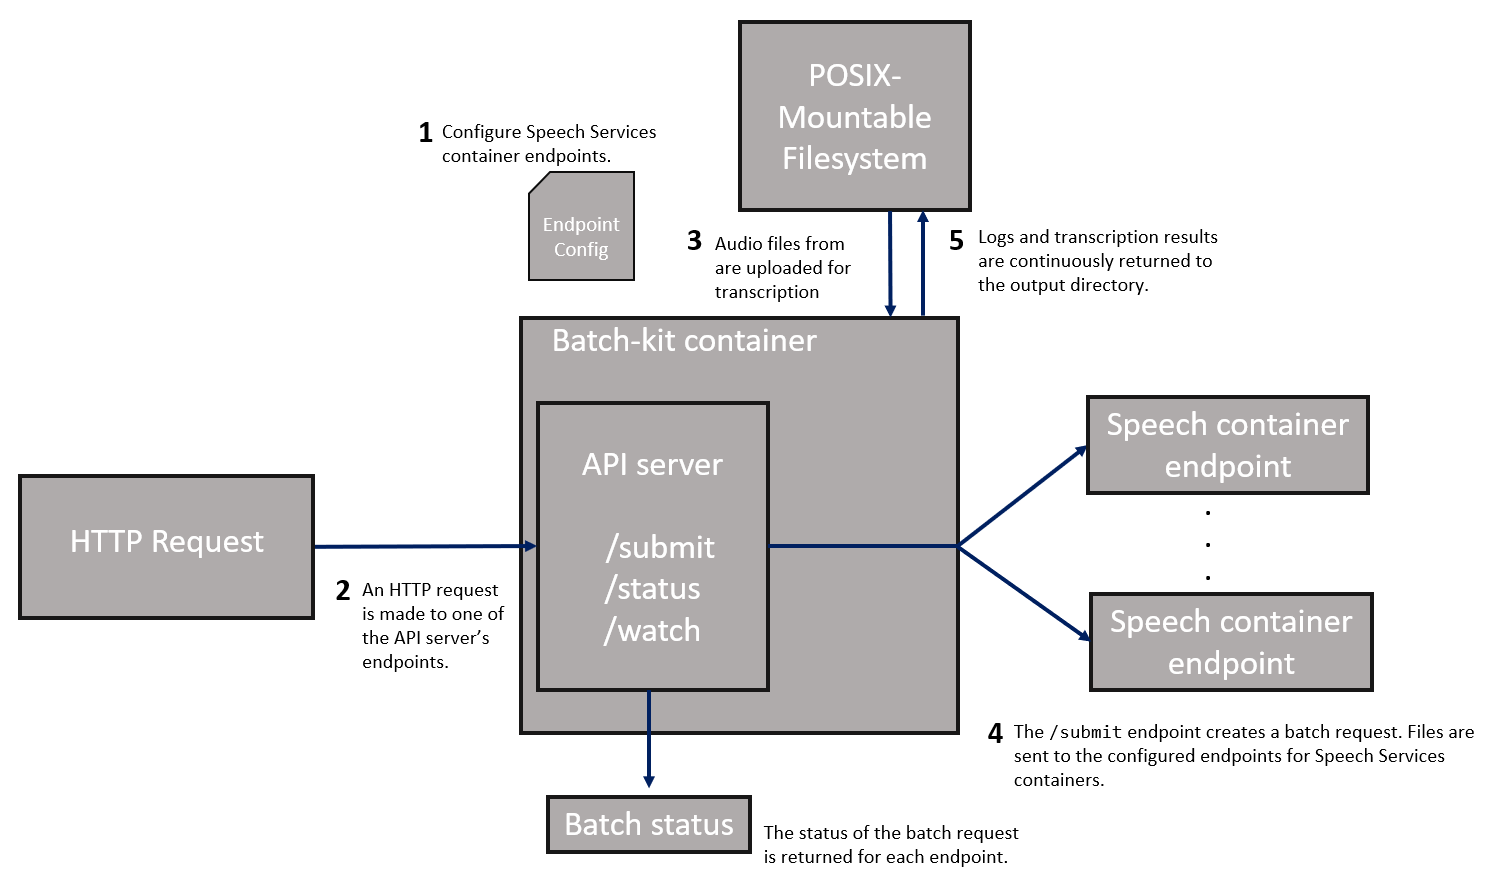
| Exécuter des modes | Exécutez le client Batch une seule fois, en continu en arrière-plan ou créez des points de terminaison HTTP pour les fichiers audio. |
| Tolérance de panne | Procédez automatiquement à une nouvelle tentative et poursuivez la transcription sans perdre la progression et différenciez les erreurs qui peuvent être retentées et celles qui ne le peuvent pas. |
| Détection de la disponibilité du point de terminaison | Si un point de terminaison devient indisponible, le client par lot continue la transcription à l’aide d’autres points de terminaison du conteneur. Lorsque le client est disponible, il commence automatiquement à utiliser le point de terminaison. |
| Échange à chaud du point de terminaison | Ajoutez, supprimez ou modifiez des points de terminaison de conteneur Speech au cours de l’exécution sans interrompre l’avancement du traitement. Les mises à jour sont immédiates. |
| Journalisation en temps réel | Journalisation en temps réel des requêtes tentées, des timestamps et des motifs d’échec, avec les fichiers journaux du kit de développement logiciel (SDK) Speech pour chaque fichier audio. |
Traiter les longs fichiers audio en toute sécurité
Les conteneurs de reconnaissance vocale prennent en charge les fichiers audio d’une durée maximale de 24 heures. Segmentez tout fichier audio de plus de 24 heures avant de le soumettre à la transcription. La taille du fichier n’est pas un substitut fiable pour la durée, car l’encodage, le taux d’échantillonnage, la profondeur du bit et le nombre de canaux déterminent le nombre d’octets. Par exemple, 1 Go n’est pas un seuil de segmentation universel.
Certains pipelines audio utilisent un compteur 32 bits pour calculer la durée. Au bout d’environ 37,3 heures, le compteur peut subir un dépassement de capacité et produire une durée plus courte mais d’apparence valide. Dans ce cas, la transcription peut signaler la réussite sans avertissement indiquant que le résultat est tronqué. L’emplacement exact du code de ce dépassement de capacité n’est pas connu.
Après la transcription, comparez la durée audio d’origine avec le décalage de transcription final ou l’horodatage reconnu le plus récent. Traitez comme incomplet un résultat qui se termine nettement avant l’audio source, même si la transcription indique une réussite.
Si vous convertissez l’audio source en RIFF/WAV, utilisez ces valeurs pour vous aider à identifier l’endroit où un dépassement de capacité s’est produit :
- Une longueur convertie de bloc de données WAV de
274,568,704octets indique un débordement pendant la conversion ou l’écriture du fichier. - Une longueur de bloc de données d’octets
4,569,536,000ou un fichier de plus de 4 Go avec un en-tête correct indique que le fichier a été écrit correctement et que le dépassement s’est produit plus tard dans le pipeline de traitement. Contactez le support Microsoft pour faire intervenir l’équipe d’ingénierie sur ce dossier.
RF64 et Wave64 (W64) ne sont pas des solutions de remplacement immédiat à ce problème. Chaque lecteur et chaque parcours de vérification de la durée du pipeline doit prendre en charge le format sélectionné. Par exemple, le module intégré wave Python rejette les fichiers RF64.
Obtenir l’image conteneur avec docker pull
Utilisez la commande docker pull pour télécharger le dernier conteneur du kit par lot.
Remarque
L’exemple suivant tire (pull) une image conteneur publique à partir de Docker Hub. Nous vous recommandons de vous authentifier avec votre compte Docker Hub (docker login) au lieu de créer une demande de tirage (pull request) anonyme. Pour une plus grande fiabilité lors de l’utilisation de contenu public, importez et gérez l’image dans un registre de conteneurs Azure privé.
En savoir plus sur l’utilisation des images publiques.
docker pull docker.io/batchkit/speech-batch-kit:latest
Configuration du point de terminaison
Le client batch utilise un fichier de configuration YAML qui spécifie les points de terminaison de conteneur locaux. Écrivez l’exemple suivant dans /mnt/my_nfs/config.yaml, qui est utilisé dans les exemples suivants.
MyContainer1:
  concurrency: 5
  host: 192.168.0.100
  port: 5000
  rtf: 3
MyContainer2:
  concurrency: 5
  host: BatchVM0.corp.redmond.microsoft.com
  port: 5000
  rtf: 2
MyContainer3:
  concurrency: 10
  host: localhost
  port: 6001
  rtf: 4
Cet exemple YAML spécifie trois conteneurs speech sur trois hôtes. Le premier hôte est spécifié par une adresse IPv4, le deuxième hôte s’exécute sur la même machine virtuelle que le client batch, et le troisième conteneur est spécifié par le nom d’hôte DNS d’une autre machine virtuelle. La valeur concurrency spécifie le nombre maximal de transcriptions de fichiers simultanées pouvant s’exécuter sur le même conteneur. La valeur rtf (facteur en temps réel) est facultative et sert à ajuster les performances.
Le client par lot peut détecter de manière dynamique si un point de terminaison devient indisponible (par exemple en raison d’un redémarrage du conteneur ou d’un problème réseau) et lorsqu’il redevient disponible. Les requêtes de transcription ne sont pas envoyées aux conteneurs qui ne sont pas disponibles et le client continue à utiliser d’autres conteneurs disponibles. Vous pouvez ajouter, supprimer ou modifier des points de terminaison à tout moment sans interrompre la progression de votre lot.
Exécuter le conteneur de traitement par lots
Remarque
- Cet exemple utilise le même répertoire (
/my_nfs) pour le fichier de configuration et les répertoires d’entrées, de sorties et de journaux. Vous pouvez utiliser des répertoires hébergés ou montés sur NFS pour ces dossiers. - L’exécution du client avec l’indicateur
–hrépertorie les paramètres de ligne de commande disponibles et leurs valeurs par défaut. - Le conteneur de traitement par lots est uniquement pris en charge sur Linux.
Utilisez la commande run de Docker pour exécuter le conteneur. Cette commande lance un interpréteur de commandes interactif à l’intérieur du conteneur.
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs --entrypoint /bin/bash /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest
Pour exécuter le client par lot :
run-batch-client -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs -file_log_level DEBUG -nbest 1 -m ONESHOT -diarization None -language en-US -strict_config
Pour exécuter le client et le conteneur par lot dans une commande unique :
docker run --network host --rm -ti -v /mnt/my_nfs:/my_nfs docker.io/batchkit/speech-batch-kit:latest -config /my_nfs/config.yaml -input_folder /my_nfs/audio_files -output_folder /my_nfs/transcriptions -log_folder /my_nfs/logs
Le client démarre l’exécution. Si un fichier audio a été transcrit dans une exécution précédente, le client ignore automatiquement le fichier. Les fichiers sont envoyés avec une nouvelle tentative automatique si des erreurs temporaires se produisent et vous pouvez différencier les erreurs pour lesquelles le client peut procéder à une nouvelle tentative et les autres. Dans le cas d’une erreur de transcription, le client continue la transcription et peut procéder à une nouvelle tentative sans perdre la progression.
Exécuter des modes
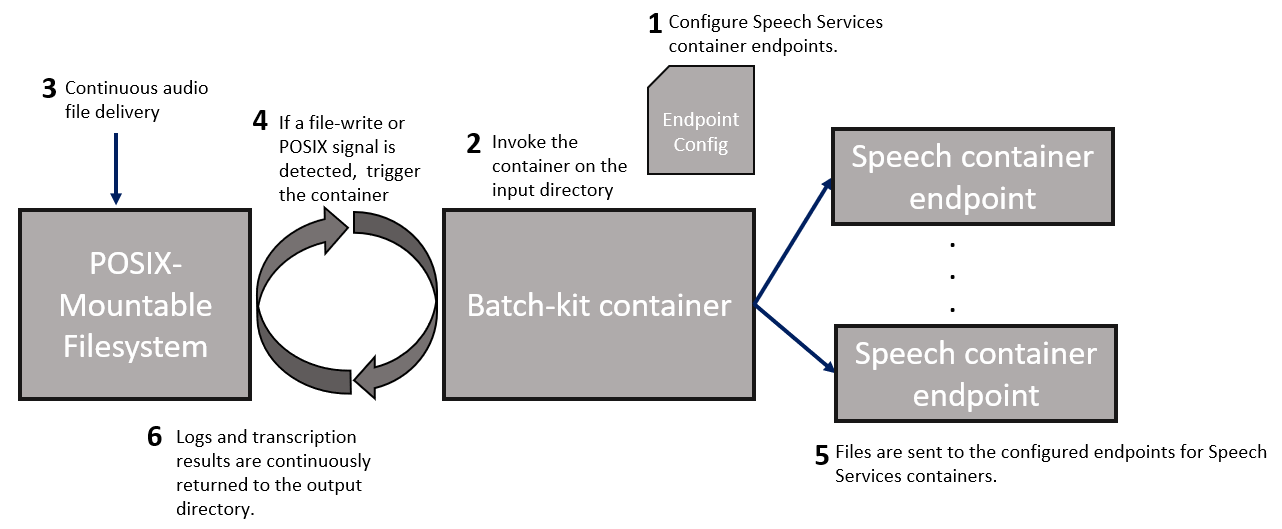
Le kit de traitement par lots propose trois modes, à l’aide du paramètre --run-mode.
Le mode ONESHOT retranscrit un seul lot de fichiers audio (à partir d’un répertoire d’entrée et d’une liste de fichiers facultative) dans un dossier de sortie.
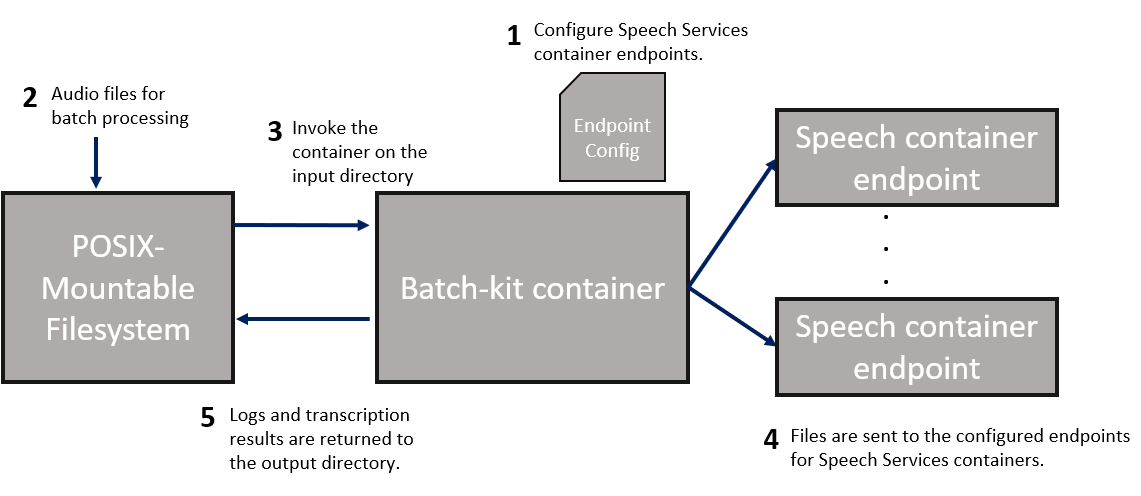
- Définissez les points de terminaison de conteneur Speech que le client par lot utilise dans le fichier
config.yaml. - Placez les fichiers audio pour transcription dans un répertoire d’entrée.
- Appelez le conteneur sur le répertoire, pour commencer le traitement des fichiers. Si le fichier audio est déjà retranscrit dans une exécution précédente avec le même répertoire de sortie (même nom de fichier et somme de contrôle), le client ignore le fichier.
- Les fichiers sont distribués aux points de terminaison de conteneur à partir de l’étape 1.
- Les journaux et la sortie du conteneur Speech sont retournés au répertoire de sortie spécifié.
Journalisation
Remarque
Le client par lot peut remplacer périodiquement le fichier run.log s’il est trop volumineux.
Le client crée un fichier run.log dans le répertoire spécifié par l’argument -log_folder dans la commande run du Docker. Les journaux sont capturés au niveau DEBUG par défaut. Les mêmes journaux sont envoyés au stdout/stderr et filtrés en fonction des arguments -file_log_level ou console_log_level. Ce journal est uniquement nécessaire pour le débogage ou si vous devez envoyer une trace pour le support. Le dossier de journalisation contient également les journaux du kit de développement logiciel (SDK) Speech pour chaque fichier audio.
Le répertoire de sortie spécifié par -output_folder contient un fichier run_summary.json, régulièrement réécrit toutes les 30 secondes ou chaque fois que de nouvelles transcriptions sont terminées. Vous pouvez utiliser ce fichier pour vérifier la progression de l’exécution du lot. Il contient également les statistiques d’exécution finale et l’état final de chaque fichier lorsque le lot est terminé. Le traitement est terminé lorsque le processus a une sortie normale.