Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Important
De nouveaux déploiements de Azure Cosmos DB pour PostgreSQL sont bloqués, car le service se trouve sur un chemin de mise hors service.
Les clusters existants, y compris les réplicas en lecture, restent pris en charge.
Pour les migrations de test, utilisez la fonctionnalité d'exécution sèche du service de migration lorsque vous migrez vers des clusters élastiques Azure Database pour PostgreSQL. Vous n'avez donc pas besoin de créer un environnement de test distinct. Si vous avez toujours besoin d’un environnement distinct, utilisez la restauration à un instant dans le passé (PITR).
L’expérience de migration Azure Database pour PostgreSQL sépare la création de cluster élastique cible de la migration de base de données. Cette séparation est utile lorsque votre organisation provisionne l’infrastructure séparément de l’exécution de la migration (en raison de raisons techniques ou organisationnelles), nécessite un contrôle supplémentaire sur la préparation du réseau et du pare-feu, ou utilise des outils d’infrastructure en tant que code pour créer des ressources cibles avant la migration.
Par défaut, le flux de travail de migration crée un cluster élastique avant de commencer la migration. Si vous avez déjà créé un cluster élastique compatible, vous pouvez désactiver la création du cluster, sélectionner la cible existante et exécuter la migration sur ce cluster. Cette option vous permet également de réduire le temps d’arrêt à la seule fenêtre de migration, soit moins de 10 minutes dans la plupart des cas.
Quand utiliser cette option
Utilisez le flux par défaut lorsque vous souhaitez que le flux de travail de migration crée le cluster élastique cible et poursuivez la migration en une seule expérience.
Utilisez un cluster élastique existant lorsque votre équipe plateforme ou votre équipe d’infrastructure crée le cluster à l’avance.
Utilisez un cluster élastique existant lorsque vous devez terminer la mise en réseau, le pare-feu, l’identité ou la validation du déploiement avant de planifier la fenêtre de migration.
Utilisez un cluster élastique existant lorsque vous approvisionnez des ressources Azure via des outils d’automatisation et souhaitez que l’exécution de la migration reste distincte du déploiement de l’infrastructure.
Conditions préalables à l’utilisation d’un cluster élastique existant
Avant de sélectionner un cluster élastique existant comme cible de migration, vérifiez qu’il répond aux exigences suivantes :
La cible doit être un cluster élastique de serveur flexible Azure Database pour PostgreSQL, et non un serveur flexible standard.
Le cluster cible doit se trouver dans la même région Azure que le cluster CPG source.
La taille du nœud cible doit être au moins la taille du nœud de cluster CPG source.
La taille de stockage cible doit être au moins la taille de stockage du cluster CPG source et au moins aussi grande que la plus grande taille de disque dans le cluster CPG source.
Les noms de base de données cibles doivent correspondre à la configuration du CPG.
La version principale de PostgreSQL cible doit être PostgreSQL 16. Créez un serveur à l’aide de PG 17, mais, dans la balise Resource, ajoutez la balise cpg-migration : true (elle crée la cible avec PG16)
La migration ne peut pas avoir lieu sur un serveur déjà migré.
Le paramètre d’authentification Microsoft Entra sur la cible, le cas échéant, doit correspondre au paramètre source.
La haute disponibilité, les réplicas en lecture et les points de terminaison privés ne doivent pas être activés sur la cible avant la migration. Vous pouvez configurer ces fonctionnalités une fois la migration terminée, si elles sont prises en charge.
Les disques SSDV2 ne sont pas pris en charge pour les migrations.
Exécuter la migration vers un cluster élastique existant
Utilisez ce flux lorsque le cluster élastique cible est déjà approvisionné et validé.
Démarrez le flux de travail de migration.
Sélectionnez Utiliser le serveur existant pour l’option Serveur.
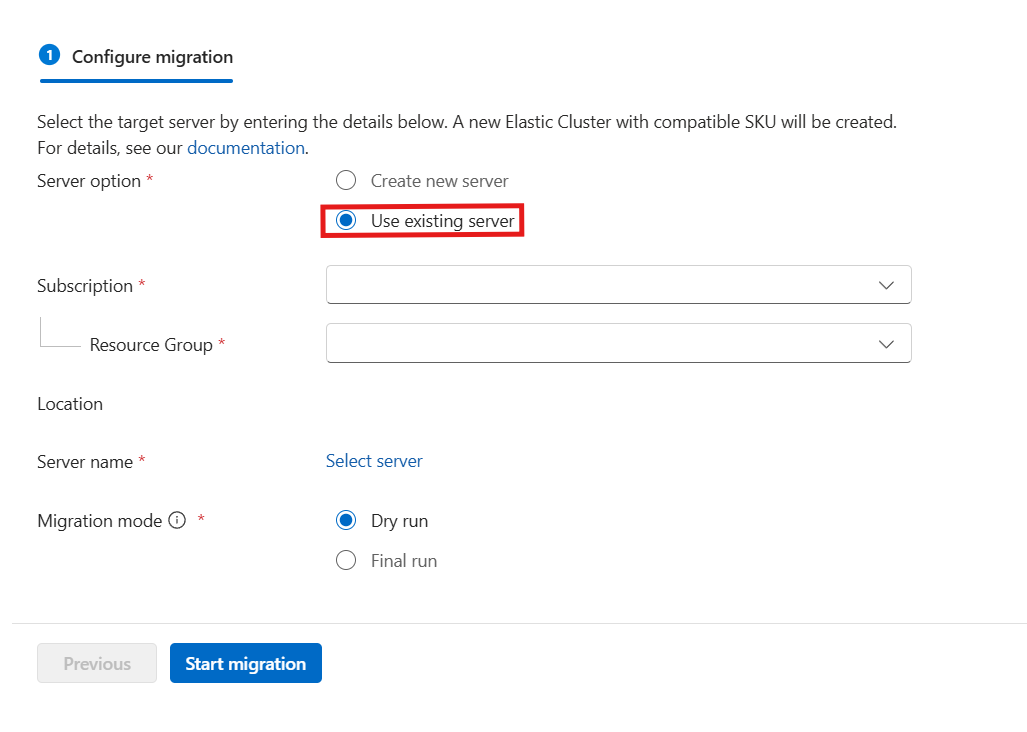
Sélectionnez l’abonnement, la région et le groupe de ressources contenant le cluster élastique cible.
Utilisez le lien Select server pour choisir parmi les clusters élastiques disponibles dans l’étendue sélectionnée.
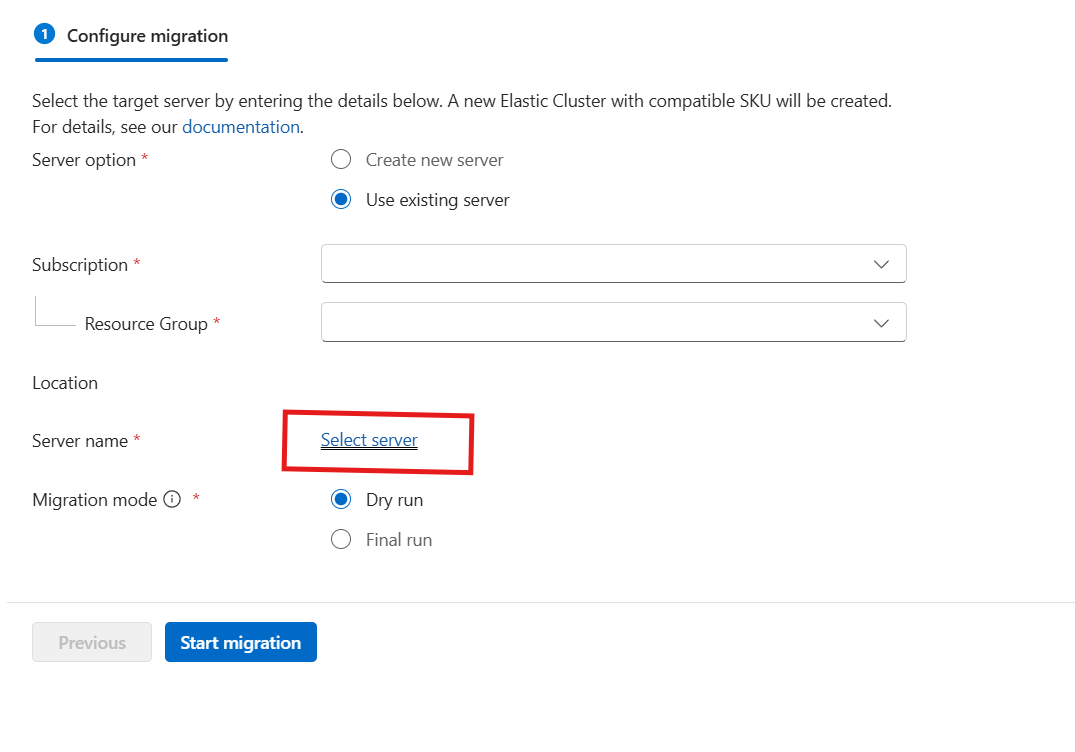
Passez en revue le mode de migration.
Démarrez la migration.
Lorsque vous sélectionnez l’option Utiliser le serveur existant , le flux de travail ignore la création du cluster élastique et la création de règles de pare-feu. Le flux de travail se connecte au cluster élastique sélectionné et migre la base de données.
Prise en charge de l’automatisation
Vous pouvez approvisionner le cluster élastique cible avant la migration à l’aide de méthodes de déploiement Azure prises en charge, telles que Azure portail, Azure CLI, Bicep, modèles ARM ou Terraform, selon les normes de déploiement de votre organisation. Vous pouvez ensuite exécuter la migration sur le cluster élastique cible existant à partir du flux de travail de migration.
La prise en charge des outils de migration basés sur le SDK est prévue pour une phase ultérieure. Tant que l’exécution de la migration basée sur le SDK n’est pas disponible, utilisez l’expérience de migration prise en charge pour l’exécution de la migration après la création du cluster élastique cible.