Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
L’ingestion des journaux est le processus de collecte, de transformation et de préparation des données de journal à partir d’applications, de serveurs, de conteneurs et de services cloud afin de pouvoir stocker, analyser et surveiller les données de journal. Les journaux capturent des informations telles que les erreurs, les avertissements, les modèles d’utilisation et les performances du système. L’ingestion fiable des logs garantit que les données opérationnelles et de sécurité sont disponibles en quasi temps réel pour la résolution des problèmes et les analyses. Cet article explique comment envoyer des journaux d’activité de Fluentd à Azure Data Explorer (Kusto), notamment les étapes d’installation, de configuration et de validation.
Aperçu
Qu’est-ce que Fluentd ?
Fluentd est un collecteur de données open source que vous pouvez utiliser pour unifier la collecte et le routage des fichiers journaux sur plusieurs systèmes. Il prend en charge plus de 1 000 plug-ins et fournit des options flexibles pour le filtrage, la mise en mémoire tampon et la transformation des données. Vous pouvez utiliser Fluentd dans les environnements natifs cloud et d’entreprise pour l’agrégation et le transfert de journaux centralisés.
Qu’est-ce que l’Explorateur de données Azure ?
Azure Data Explorer (ADX) est un service d’analytique rapide et entièrement managé optimisé pour l’analyse en temps réel de grands volumes de données structurées, semi-structurées et non structurées. ADX utilise kusto Query Language (KQL) et est largement utilisé pour la télémétrie, la surveillance, les diagnostics et l’exploration interactive des données.
Prerequisites
- Ruby installé sur le nœud où les journaux doivent être ingérés. Pour installer des dépendances fluentd à l’aide du gestionnaire de package gem, consultez les instructions d’installation de Ruby
- Accès à un cluster et une base de données Azure Data Explorer.
- Application Azure Active Directory avec des autorisations pour ingérer des données.
Prise en main de Fluentd et d’Azure Data Explorer
Installez Fluentd à l’aide de RubyGems :
gem install fluentdInstallez le plug-in Fluentd Kusto :
gem install fluent-plugin-kustoConfigurez Fluentd en créant un fichier de configuration (par exemple)
fluent.confavec le contenu suivant. Remplacez les espaces réservés par vos valeurs d’Azure et de plug-in :<match <tag-from-source-logs>> @type kusto endpoint https://<your-cluster>.<region>.kusto.windows.net database_name <your-database> table_name <your-table> logger_path <your-fluentd-log-file-path> # Authentication options auth_type <your-authentication-type> # AAD authentication tenant_id <your-tenant-id> client_id <your-client-id> client_secret <your-client-secret> # Managed identity authentication (optional) managed_identity_client_id <your-managed-identity-client-id> # Workload identity authentication (optional) workload_identity_tenant_id <your-workload-identity-tenant-id> workload_identity_client_id <your-workload-identity-client-id> # Non-buffered mode buffered false delayed false # Buffered mode # buffered true # delayed <true/false> <buffer> @type memory timekey 1m flush_interval 10s </buffer> </match>
Pour plus d’informations sur la configuration et l’authentification, consultez la documentation du plug-in Fluentd Kusto
Préparez Azure Data Explorer pour l’ingestion :
Créez un cluster et une base de données ADX. Consultez Créer un cluster et une base de données Azure Data Explorer.
Créez une application Azure Active Directory et accordez des autorisations pour ingérer des données dans la base de données ADX. Consultez Créer une inscription d’application Microsoft Entra dans Azure Data Explorer.
Note
Enregistrez la clé d’application et l’ID d’application pour une utilisation ultérieure.
Créez une table pour l’ingestion de logs. Par exemple:
.create table LogTable (
  tag:string,
  timestamp:datetime,
  record:dynamic
)
Exécutez Fluentd avec le fichier de configuration :
fluentd -c fluent.confValidez l’ingestion de journal par :
Vérification du fichier journal Fluentd, confirmant qu’il n’y a aucune erreur et que les demandes d’ingestion sont envoyées avec succès.
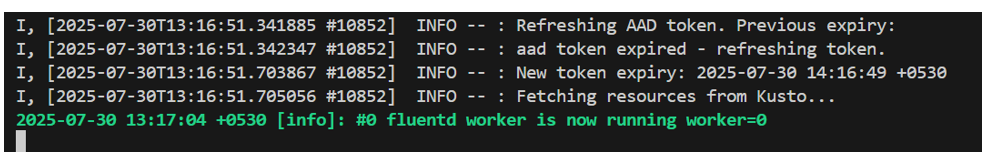
Interrogation de la table ADX pour vérifier que les journaux sont ingérés correctement :
LogTable
| take 10
Mappage d’ingestion : utilisez les mappages d’ingestion prédéfinis dans Kusto pour transformer les données au format de 3 colonnes par défaut en schéma souhaité. Pour plus d’informations, consultez le support des mappages d’ingestion.