Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Azure Data Explorer (ADX) est une plateforme d’analytique entièrement managée pour l’analyse en temps réel des données de télémétrie et de journal à grande échelle. Cet article explique comment le coût par Go ingéré est calculé dans Azure Data Explorer, quels facteurs le pilotent et comment vous pouvez optimiser votre cluster pour optimiser l’efficacité des coûts. Les plateformes d’analytique Big Data utilisent différents modèles tarifaires. De nombreuses plateformes basent la tarification sur des facteurs tels que le volume de requêtes, l’ingestion de données, la durée de stockage et les ressources de calcul. Cette complexité rend difficile la comparaison des prix entre les produits.
Pour mieux comprendre le coût d’utilisation d’Azure Data Explorer, cet article utilise le coût de métrique par Go ingéré. Cette métrique correspond au coût total du cluster (calcul, stockage, mise en réseau et balisage de service) divisé par le total des données de taille d’origine ingérées pendant cette période.
Un instantané représentatif des clusters ADX en juin 2025 est utilisé pour baser l’exemple d’analyse. Les sections suivantes montrent les principaux résultats de l’analyse, expliquent les variations de coût et expliquent comment les utilisateurs peuvent optimiser le coût par Go ingéré sans compromettre les performances.
Remarque
- Tous les chiffres de coût de cet article montrent les prix de liste et n’incluent pas de remises ou d’économies basées sur l’engagement.
- Dans le cadre de cet exemple d’analyse, le coût par Go est exprimé en unités de coût d’exemple (SKU), où chaque SCU représente une unité de coût générique, par exemple, un cent us.
- Pour connaître les prix de liste et comment les calculer, consultez la calculatrice de prix Azure Data Explorer.
Analyse du coût par Go ingéré
Le graphique ci-dessous montre la médiane quotidienne de Go consommés en taille originale (axe Y) par rapport au coût médian par Go consommé (axe X) pour chaque groupe de coûts. La taille des bulles représente la part du groupe dans la totalité des données ingérées dans le service.
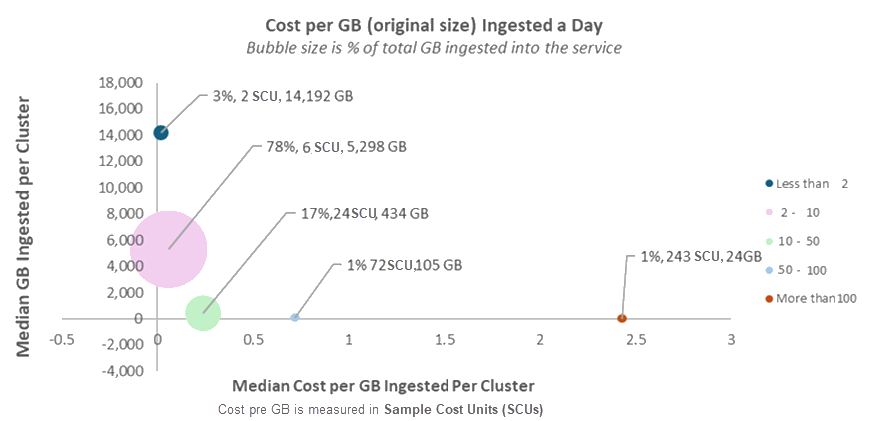
Le coût par GB ingéré varie d'un cluster à l'autre, mais plusieurs tendances se dégagent :
La plupart des données (>75%) sont ingérées à un coût compris entre 2 et 10 SCU par Go (avant réductions).
Moins de 5 % des données sont ingérées à moins de 2 SCU par Go.
Même dans la même catégorie d’utilisation (ou « bulle »), vous voyez une variation significative. Par exemple, dans la plus grande bulle, un cluster ingère à 2 SCU par Go, tandis qu’un autre atteint 10 SCU par Go. C’est une différence de 5X. Les sections suivantes expliquent les principales raisons de cette variation.
Les clusters avec un coût plus élevé par Go sont moins courants et ont généralement des volumes d’ingestion inférieurs. En général, les volumes de données plus petits signifient un coût plus élevé par Go.
Importante
Le graphique en bulles montre que le coût par GB ingéré varie à travers les clusters. Cette variante n’indique pas de bonnes ou mauvaises pratiques. Il reflète différents scénarios, configurations et modèles d’utilisation pour le service.
Par exemple, un cluster peut conserver les données plus longtemps pour la conformité, ce qui augmente les coûts de stockage. Une autre peut utiliser des stratégies de mise à jour qui traitent les données pendant l’ingestion, ce qui déclenche l’utilisation du calcul. Ces scénarios sont des choix de conception intentionnels alignés sur des objectifs spécifiques, et ils affectent naturellement le coût par Go.
Quels sont les facteurs qui déterminent le coût par Go ingéré ?
Ces facteurs clés sont derrière les variations de coût par Go ingérées par cluster :
Durée de stockage : plus vous stockez des données, plus le coût est élevé. Consultez la stratégie de rétention.
Utilisation élevée du processeur : les actions telles que les requêtes lourdes, le traitement des données ou les transformations entraînent une utilisation élevée du processeur.
Paramètres de cache : la mise en cache d’un plus grand nombre de données améliore les performances, mais peut augmenter les coûts. Consultez la stratégie de cache.
Utilisation des données à froid : Les requêtes qui accèdent aux données à froid déclenchent des transactions de lecture et ajoutent au coût. Consultez le cache chaud et froid.
Transformation et optimisation des données : fonctionnalités telles que les stratégies de mise à jour, les vues matérialisées et le partitionnement consomment des ressources processeur et peuvent augmenter les coûts. Consultez les politiques de mise à jour, les vues matérialisées et les partitions.
Volume d’ingestion : les clusters fonctionnent plus efficacement à des volumes d’ingestion plus élevés.
Diffusion en continu et ingestion mise en file d’attente : chacun a un profil de coût différent en fonction du cas d’usage. Consultez la diffusion en continu et la file d’attente.
Conception de schéma : les tables larges avec de nombreuses colonnes nécessitent davantage de ressources de calcul et de stockage, ce qui entraîne des coûts.
Fonctionnalités avancées : les options telles que les abonnés, les points de terminaison privés et les bacs à sable Python consomment davantage de ressources et peuvent ajouter des coûts.
Choix du pipeline de données : certains chemins d’ingestion coûtent moins cher. Par exemple, l’ingestion Event Grid est généralement moins coûteuse que Event Hubs.
Mise à l’échelle automatique : les clusters sans mise à l’échelle automatique coûtent souvent plus cher, car ils n’ajustent pas leur taille en fonction de la demande.
Vous pouvez configurer la plupart de ces facteurs pour optimiser les performances et les coûts.
Un examen plus approfondi des principaux facteurs de coût
Cette section explore les facteurs clés qui influencent le coût par Go ingérés dans Azure Data Explorer, fournissant des informations sur la façon dont vous pouvez gérer et optimiser ces coûts.
Impact sur la rétention des données sur les coûts
Dans ADX, toutes les données ingérées sont stockées dans un stockage persistant. Chaque table et vue matérialisée a une stratégie de rétention qui définit la durée pendant laquelle les données sont conservées. Plus les données sont conservées, plus le coût est élevé, en fonction de la tarification du stockage Azure. Lorsque vous avez besoin d’un stockage à long terme, comme pour la conformité, le coût par Go ingéré augmente, car il inclut les dépenses de stockage en cours.
En plus de la taille d’étendue signalée par le cluster, il existe deux facteurs de coût supplémentaires :
- Mémoire tampon de rétention : 7 jours supplémentaires de données sont stockés par défaut pour vous protéger contre la perte accidentelle de données.
- Surcharge de récupération : pour les tables où le paramètre de récupération est activé (par défaut), les données sont conservées pendant 14 jours supplémentaires. Cela inclut les objets blob intermédiaires générés pendant les opérations de fusion et de reconstruction.
Taille du cluster
La taille du cluster est le nombre de machines (nœuds) dans le cluster. Chaque machine ajoute des coûts, en fonction de son type (référence SKU). La mise à l’échelle automatique ajuste la taille du cluster en fonction de l’utilisation du processeur, afin que le système puisse optimiser les coûts et les performances en évitant les ressources inactives ou redondantes.
La mise à l’échelle automatique ajuste la taille du cluster pour garantir que les données mises en cache s’intègrent dans l’espace SSD disponible. Par conséquent, un grand cache peut augmenter la taille du cluster et si l’utilisation du processeur est faible, cela peut entraîner un coût plus élevé par Go. Pour plus d’informations sur l’optimisation de la taille du cache, consultez l’outil Clusters Insight de l’onglet Cache.
Les clusters qui exécutent de nombreuses requêtes ou effectuent des tâches gourmandes en ressources CPU, telles que les vues matérialisées, les stratégies de mise à jour ou le partitionnement, peuvent faire évoluer le cluster, ce qui augmente le coût par Go. Notez que ces fonctionnalités peuvent augmenter considérablement les performances des requêtes et réduire l’utilisation du processeur des requêtes et améliorer ainsi l’efficacité globale.
Volume de données ingérées
À mesure qu’un cluster augmente, plus de nœuds sont ajoutés, ce qui augmente le coût total. Ce coût est réparti sur toutes les données ingérées, de sorte que plus vous ingérez de données, plus le coût par Go est faible.
Utilisation des données à froid
Lorsque les requêtes accèdent fréquemment aux données froides stockées sur le disque, elles entraînent des transactions de lecture qui utilisent plus de ressources et peuvent augmenter le coût global du cluster.
Diffusion en continu contre ingestion mise en file d’attente
Chaque méthode d’ingestion a des caractéristiques de coût, de latence et de fonctionnalité différentes. Chaque méthode d’ingestion est donc meilleure pour différents scénarios. En termes de coût, l’ingestion en streaming est moins coûteuse lorsque vous ingérez de nombreuses petites tables contenant des données au compte-gouttes, tandis que l’ingestion en file d’attente est plus rentable pour les tables volumineuses.
Conseil / Astuce
Optimiser le coût par Go d'ingestion
Vérifiez les configurations des principaux facteurs de coût pour vous assurer qu’ils répondent aux besoins de votre cluster et aux exigences de service en matière d’efficacité. En particulier:
- Réduisez les requêtes sur les données froides pour réduire les transactions de lecture.
- Activez la mise à l’échelle automatique pour correspondre dynamiquement à la taille du cluster à la demande.