Remarque
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de vous connecter ou de modifier des répertoires.
L’accès à cette page nécessite une autorisation. Vous pouvez essayer de modifier des répertoires.
Migrez vos charges de travail du calcul classique vers le calcul serverless. Le calcul serverless gère automatiquement l’approvisionnement, la mise à l’échelle, les mises à niveau du runtime et l’optimisation.
La plupart des charges de travail classiques peuvent migrer avec un minimum ou aucun changement de code. Par exemple, des charges de travail qui utilisent df.cache() et df.persist() migrent principalement sans modification de code. Cette page se concentre sur ces charges de travail. Certaines charges de travail qui dépendent des notebooks R ou Scala nécessitent un compute classique et ne peuvent pas migrer vers le serverless. Pour obtenir la liste complète des limitations actuelles, consultez les limitations de calcul sans serveur.
Migrer avec Genie Migrate pour Serverless
Important
Cette fonctionnalité est en version bêta. Les administrateurs de l’espace de travail peuvent l’activer depuis la page Aperçu en s’inscrivant à l’aperçu de l’Agent de calcul . Consultez Gérer les préversions d’Azure Databricks.
Genie Migrate for Serverless est un agent qui permet de migrer un seul notebook ou une seule tâche vers un calcul sans serveur. L’agent examine l’environnement de la charge de travail, les bibliothèques, les configurations Spark, les tags et le code, puis propose chaque modification comme une suggestion individuelle à accepter ou rejeter. Les changements acceptés sont appliqués en place et peuvent être annulés.
Utilisez Genie Code pour migrer de manière interactive un notebook ou une tâche, ou utilisez Databricks CLI pour migrer des tâches en arrière-plan, y compris un grand nombre de tâches à partir d’un script. Voir Migrer les tâches avec Databricks CLI.
Ce que l’agent examine et modifie
| Area | Ce que fait l’agent |
|---|---|
| Environnement et bibliothèques | Traduit les installations de bibliothèques en une spécification d’environnement sans serveur, y compris les installations %pip, les scripts d’initialisation du cluster, les bibliothèques de cluster utilisées dans les jobs et les références à un index privé de paquets. |
| Variables d’environnement | Traduit les variables d’environnement du cluster vers leurs équivalents serverless, préservant les références secrètes de l’espace de travail et omettant les valeurs gérées par la plateforme. |
| Accès aux données et au stockage | Réécrit les chemins incompatibles avec Serverless, tels que le disque local, dbfs:/, et les chemins de montage, en volumes Unity Catalog. L’agent applique automatiquement des réécritures non ambiguës et vous demande de choisir un volume lorsque la cible est ambiguë. |
| Configurations de Spark | Classe chaque configuration Spark, commente celles qui peuvent être supprimées sans risque, et signale et supprime les configurations qui ne sont pas prises en charge par le mode serverless. Couvre à la fois les configurations associées au cluster et celles dans le notebook. |
| Code de charge de travail | Réécrit du code que le serverless ne supporte pas en équivalents compatibles, comme les opérations RDD réécrites en opérations DataFrame, et ajuste le code pour le comportement SQL en mode ANSI sur serverless. |
| Balises | Traduit les balises de cluster personnalisées, telles qu’une balise de centre de coûts, vers leurs équivalents sans serveur. |
| Mode de performance | Il suggère un mode performance basé sur la configuration du cluster. Voir Choisir un mode de performances. |
Exigences
L’accès administrateur de l’espace de travail est recommandé pour garantir une migration complète. Cela s’explique par le fait que l’agent inspecte également les scripts d’init globaux au niveau de l’espace de travail au-delà de la charge de travail cible. Vous pourrez peut-être effectuer la migration si vous disposez de l’autorisation
CAN MANAGEpour la charge de travail, mais sans autorisations d’administrateur, cela peut entraîner l’absence de bibliothèques, de paramètres d’environnement ou de balises.Confirmez que vous avez accès à l’agent. Tapez
/computedans Genie Code./computedevrait apparaître dans le menu d’autocomplétion. Si elle n’apparaît pas, un administrateur de l’espace de travail doit activer l’aperçu dans votre espace de travail.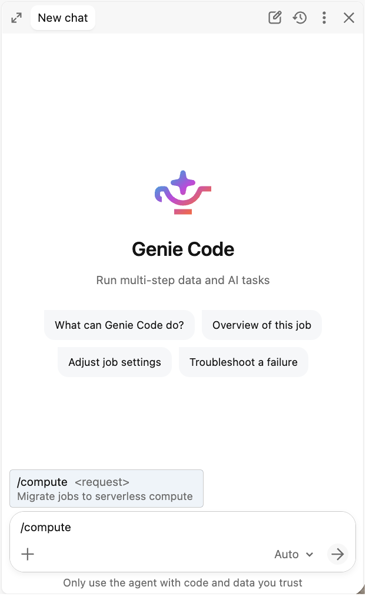
Migrer un bloc-notes
- Ouvrez le notebook que vous souhaitez migrer.
- Ouvre le code Genie et lance
/compute migrate to serverlessdepuis la/palette de commandes. - Examinez les conclusions de l’agent. L’agent analyse l’environnement, les bibliothèques et le code du carnet, et propose une modification pour chaque élément qui en nécessite une, par exemple en déplaçant l’installation d’une bibliothèque dans une spécification d’environnement ou en réécrivant une cellule de code pour qu’elle s’exécute en mode serverless.
- Accepter ou rejeter chaque changement proposé.
- Appliquez les modifications que vous avez acceptées. Elles sont écrites directement dans le notebook.
- Associez le notebook à Serverless et exécutez-le pour vérifier qu’il se comporte comme prévu. Voir Vérifier une charge de travail migrée.
Migrer une tâche
- Ouvrez la tâche que vous souhaitez migrer.
- Ouvre le code Genie et lance
/compute migrate to serverlessdepuis la/palette de commandes. - L’agent clone votre tâche et tente ensuite de migrer la tâche clonée vers un environnement serverless.
- Examinez les conclusions de l’agent. Pour une tâche multitâche, l’agent énumère chaque tâche ainsi que sa configuration de cluster par tâche, et propose des modifications pour chacune tout en préservant le planning du travail.
- Accepter ou rejeter chaque modification proposée sur la surface de migration : environnement et bibliothèques, configurations Spark, et tout code de charge de travail devant changer.
- Appliquez les modifications que vous avez acceptées. Les ressources de calcul de la tâche passent en mode serverless.
- Exécutez la tâche sur une infrastructure serverless et confirmez les résultats. Voir Vérifier une charge de travail migrée.
- Optionnellement, en dernière étape, l’agent promeut le clone migré. Il copie la configuration et les carnets du clone sur votre job original en place (en gardant le même ID de job, le même planning et les permissions), puis supprime le clone. Si vous ignorez la promotion, votre job d’origine garde son planning et continue de fonctionner sur le compute classique. Le clone n’a ni planning ni déclencheurs, donc il ne s’exécute que lorsque vous le démarrez.
Migrer les tâches avec l’interface de commande de commande Databricks
Utilisez le compute-migrations groupe de commandes dans l’interface de commande Databricks pour exécuter Genie Migrate for Serverless sur une tâche en arrière-plan, sans session Genie Code ouverte. Vous pouvez lancer des migrations pour de nombreuses tâches à partir d’un script et examiner chacune d’elles lorsqu’elle est prête.
Le chemin de l’interface de commande Databricks a les exigences suivantes :
- Un administrateur d’espace de travail a activé l’aperçu du Compute Agent. Sans elle, chaque commande
compute-migrationséchoue avecPERMISSION_DENIED. - Databricks CLI version 1.24.0 ou ultérieure. Consultez Installer ou mettre à jour l’interface CLI Databricks.
-
CAN MANAGEl’autorisation sur chaque job que vous migrez.
L’agent sauvegarde le job, puis construit une copie de travail sans serveur. La copie de travail est un nouveau job nommé [Serverless Migration - <timestamp>] <job name> qui exécute des copies des notebooks et fichiers du job. Il n’a ni planning ni déclencheurs, donc il ne s’exécute que lorsque vous le lancez ou quand Azure Databricks l’exécute pour validation. Votre tâche d’origine n’est pas modifiée tant que vous n’avez pas approuvé la migration.
Avertissement
Une exécution de validation n’est pas isolée. La copie de travail s’exécute sur les mêmes tables, volumes, points de contrôle et systèmes externes que la tâche originale. Si le travail écrit dans des tables de production, envoie des notifications, appelle des API externes ou avance les checkpoints de streaming, la validation le fait aussi. Définissez run_validation uniquement pour les tâches où une exécution supplémentaire est sûre. Vous ne pouvez pas modifier ce paramètre après avoir créé la migration.
Ne modifiez pas la tâche d’origine ni la copie de travail pendant qu’une migration est en cours. L’approbation de la migration remplace les paramètres et fichiers du travail d’origine par ceux de la copie de travail.
Lancer une migration pour la tâche :
databricks compute-migrations create -o json --request-id "<uuid>" --json '{
  "asset_type": "JOB",
  "asset_uri": "jobs/<job-id>",
  "auto_approve": false,
  "run_validation": false
}'
La réponse inclut l’ID de migration. Utilisez une nouvelle
request-idpour chaque tâche, et réutilisez-la si vous réessayez après un délai d’expiration, afin d’éviter de créer une migration en double. Vous ne pouvez pas modifierauto_approveourun_validationaprès avoir créé la migration.Vérifiez l’état de la migration avec
databricks compute-migrations get <migration-id> -o json. La planification et la construction de la copie de travail prennent généralement plusieurs minutes. Pour vérifier de nombreuses migrations, utilisezlist, puis confirmez chacune d’elles avecgetavant d’agir.Lorsque la migration atteint
TRANSLATION_READY, examinez la copie de travail.migration_report.primary_asset.idest l’ID du job de la copie de travail. Comparez ses paramètres et son code avec la tâche d’origine, puis lancezapprove-migration-translationoureject-migration-translationavec le--etagdepuis votre dernier fichierget.Si vous définissez
run_validation, Azure Databricks exécute la copie de travail une seule fois et enregistre le résultat dansvalidation_report. La migration passe àMIGRATION_REVIEWsi l’exécution réussit ou échoue, donc vérifiezvalidation_report.passedavant d’approuver.Lorsque la migration atteint
MIGRATION_REVIEW, examinez la copie de travail et le résultat de validation, puis lancezapprove-migration-executionoureject-migration-executionavec le--etagdepuis votre dernierget. L’approbation applique les paramètres et fichiers de la copie de travail au job d’origine, en conservant son ID du job, son planning et ses permissions.Lorsque la migration atteint
MIGRATION_COMPLETE, la tâche d’origine a été modifiée. Vérifiez-le immédiatement. Voir Vérifier une charge de travail migrée.Après avoir vérifié la tâche originale, supprimez la tâche de copie de travail.
migration_report.secondary_assetsliste les carnets qu’exécute la copie de travail. Supprime-les seulement après avoir confirmé que la tâche d’origine n’y fait pas référence.
Chaque commande reject nécessite une raison de rejet, que vous transmettez après l’ID de migration. Par exemple:
databricks compute-migrations reject-migration-translation <migration-id> "Keep the existing output table names." --etag <etag>
Donnez une raison précise. L’agent révise la copie de travail et la renvoie pour examen. Si vous rejetez une migration à plusieurs reprises, elle échoue.
Le tableau suivant liste les compute-migrations commandes :
| Command | Description |
|---|---|
create |
Démarre une migration pour une tâche. Échoue avec ALREADY_EXISTS si le travail a une migration en cours ou une migration déjà réussie. |
get, list |
Renvoie l’état, les rapports et etag d’une seule migration ou de toutes les migrations. |
approve-migration-translation, reject-migration-translation |
Approuve ou rejette la copie de travail dans l’État TRANSLATION_READY . Le paramètre auto_approve à la création ignore cette révision. |
approve-migration-execution, reject-migration-execution |
Approuve ou rejette la migration dans l’État MIGRATION_REVIEW . Approuver modifie la tâche d’origine. |
cancel-migration |
Arrête une migration. L’annulation n’annule pas les modifications déjà appliquées à la tâche originale ni les effets secondaires d’une exécution de validation. |
delete |
Supprime l’enregistrement de migration. N'annule pas les modifications et ne supprime pas la copie de travail ni la sauvegarde. Une migration qui a échoué ou qui a été annulée libère déjà la tâche, donc vous n’avez pas besoin de la supprimer avant de commencer une nouvelle migration. |
Passez --etag à partir de votre dernière get avec chaque commande d’approbation, de rejet ou d’annulation. Si la migration a changé depuis votre lecture, la commande échoue avec ABORTED au lieu d’agir sur un état que vous n’avez pas examiné. Si l’agent ne peut pas migrer la tâche, la migration se déplace vers NOT_SUPPORTED ou FAILED, et state_history explique pourquoi.
Vérifier une charge de travail migrée
L’agent propose et applique des modifications, mais ne vérifie pas la sortie de votre charge de travail. Une exécution de validation avec l’interface de commande Databricks vérifie uniquement que l’exécution réussit. Exécutez toujours une charge de travail migrée sur serverless et confirmez les résultats avant de vous y fier, surtout pour les charges qui écrivent dans des tables de production. Si l’agent propose un changement qui semble erroné, rejetez-le et envoyez-nous un retour afin que nous puissions améliorer l’agent. Consultez Envoyer des commentaires sur le produit.
Tip
Pendant que vous validez une charge de travail migrée, exécutez-la en mode optimisé en termes de performance. Il démarre plus vite que le mode standard, donc vous obtenez un retour plus rapide en confirmant les résultats. Passe au mode qui correspond le mieux à la charge de travail avant de le lancer en production. Voir Choisir un mode de performances.
Lorsque l’agent trouve quelque chose qu’il ne peut pas migrer en toute sécurité, il signale un bloqueur et s’arrête par défaut. Vous pouvez explicitement demander de passer outre certains bloqueurs de compatibilité ou de dépendances, mais cela implique d’accepter le risque que ces dépendances, l’attribution des coûts ou le comportement à l’exécution ne soient pas conservés, et que la charge de travail puisse échouer dans un environnement serverless.
Annuler les modifications de migration
Les modifications appliquées par l’agent sont réversibles.
Pour un carnet, ouvrez-le et restaurez la révision juste avant la migration. Consultez Historique des versions dans les notebooks Databricks.
Pour un poste, si vous n’avez pas promu le clone migré dans Genie Code ni approuvé la migration avec l’interface de commande Databricks, votre poste d’origine n’a jamais été modifié. Lancez-le comme avant et supprimez le clone ou la copie de travail. Sinon, restaurez depuis la sauvegarde que l’agent a écrite avant d’apporter la moindre modification :
- Ouvrez le dossier de sauvegarde :
/Workspace/Users/<username>/serverless-migration/backups/job-<job-id>/<timestamp>/. La sauvegarde se trouve dans le dossier personnel de l’utilisateur qui a lancé la migration, qui pour l’interface de commande Databricks est l’utilisateur qui l’a créée. Dans Genie Code, l’agent affiche également ce chemin lors de la migration. S’il y a plusieurs horodatages, choisissez celui juste avant la migration. - Ouvrez
job.yaml, qui contient les paramètres de votre tâche avant la migration, puis réappliquez ces paramètres à la même tâche au moyen d’une requêtePOST /api/2.2/jobs/reset, qui remplace les paramètres de la tâche par ceux que vous fournissez. Vous pouvez aussi les coller dans la définition JSON du poste dans l’interface utilisateur. Cela ramène la tâche au calcul classique. - Ouvre
mapping.yaml, qui liste chaque fichier sauvegardé et le chemin d’origine d’où il provienne. Copiez chaque fichier de sauvegarde sur son chemin d’origine pour annuler les réécritures de code. - Exécutez la tâche pour confirmer qu’elle fonctionne comme avant la migration.
La migration ne supprime jamais cette sauvegarde. Les tâches que l’agent n’a pas modifiées, comme les tâches issues de Git, SQL ou dbt, sont enregistrées dans job.yaml, mais leurs fichiers ne sont pas copiés dans la sauvegarde ; restaurez-les donc depuis votre source de référence si nécessaire.
Limitations connues
- Les éléments suivants sont signalés comme des éléments bloquants : images personnalisées, variantes de ML Runtime, versions de Databricks Runtime antérieures à 13, configurations Spark qui ne peuvent pas être ignorées en toute sécurité dans un environnement serverless, et dépendances telles que les eggs, les fichiers JAR et les bibliothèques Maven. Un blocage signifie que l’agent s’arrête au lieu de migrer cet élément. Vous pouvez soit résoudre vous-même et relancer la migration, soit dire à l’agent de migrer quand même, ce qui laisse cet élément non résolu et peut entraîner l’échec de la charge de travail en serverless.
- L’agent lit les scripts d’init stockés dans des fichiers workspace ou des volumes du catalogue Unity. Les scripts d’initiation stockés dans ABFSS ou DBFS ne peuvent pas être lus et sont signalés comme des bloqueurs.
- L’agent n’inspecte pas tous les attributs classiques de calcul. La livraison de logs de cluster et les clés SSH ne sont pas modélisées, et bien qu’il détecte de nombreuses dépendances de montage DBFS à partir du code de charge de travail, il n’énumère ni ne résout chaque montage.
- Les API de cache et de points de contrôle, les vues temporaires globales, les appels de gestion de montage DBFS, ainsi que le code Scala ou R sont des blocages durs par défaut. Vous pouvez demander à l’agent de continuer, mais la fonctionnalité non résolue reste inchangée et peut échouer en serverless.
- Les jobs comportant plus de 10 tâches migrables ne peuvent pas être migrés.
- L’agent dans Genie Code migre une charge de travail à la fois. Pour migrer plusieurs tâches, créez une migration par tâche avec Databricks CLI. Il n’existe pas de flux de découverte ou d’approbation administratif à l’échelle de la flotte.
- Avec l’interface de commande Databricks, l’agent migre uniquement les jobs. Un job qui comporte un notebook ou une tâche Python provenant d’un référentiel Git distant échoue à migrer.
- L’agent propose des modifications et applique celles que vous acceptez, mais il ne vérifie pas la correction de la sortie. Vérifiez une charge de travail migrée avant de vous y fier pour les données de production.
- Si la source de vérité de votre charge de travail est un Databricks Asset Bundle ou un dossier Git, l’agent applique des modifications à l’objet workspace en place. Réconciliez ces modifications avec votre bundle ou dépôt afin qu’un déploiement ultérieur ne remplace pas la migration.
Migrer manuellement au sans serveur
Pour migrer vos charges de travail du calcul classique vers le calcul serverless, procédez comme suit :
- Vérifiez les prérequis : Vérifiez que votre espace de travail, votre accès réseau et votre stockage cloud répondent aux exigences. Voir Conditions préalables.
- Mettre à jour le code : Effectuez les modifications nécessaires au code et à la configuration. Consultez Mettre à jour votre code.
- Testez vos charges de travail : validez la compatibilité et la justesse avant de basculer. Consultez Tester vos charges de travail.
- Choisissez un mode de performance : Sélectionnez le mode de performance qui correspond le mieux aux exigences de votre charge de travail. Voir Choisir un mode de performances.
- Migrez par étapes : déployez le sans serveur de manière incrémentale, en commençant par des charges de travail nouvelles et à faible risque. Consultez Migrer en phases.
- Surveillez les coûts : Suivez la consommation des DBU sans serveur et configurez les alertes. Consultez Surveiller les coûts.
Prerequisites
Avant de commencer la migration, vous devrez peut-être mettre à jour certaines configurations héritées dans votre espace de travail.
| Conditions préalables | Action | Détails |
|---|---|---|
| L’espace de travail est activé pour le catalogue Unity | Migrer à partir du metastore Hive si nécessaire | Mettre à niveau un espace de travail Azure Databricks vers le catalogue Unity |
| Mise en réseau configurée | Remplacer le peering VPC par des NCC (Network Connectivity Centers), des Private Links ou des règles de pare-feu | Mise en réseau du plan de calcul sans serveur |
| Accès au stockage cloud | Remplacer les modèles d’accès aux données héritées par les emplacements externes du Catalogue Unity | Connectez-vous au stockage d’objets cloud à l’aide de Unity Catalog |
Vérifiez que votre espace de travail se trouve dans une région prise en charge.
Mettre à jour votre code
Les sections suivantes répertorient les modifications de code et de configuration requises pour rendre vos charges de travail compatibles avec serverless.
Accès aux données
Les modèles d’accès aux données hérités ne sont pas pris en charge sur serverless. Mettez à jour votre code pour utiliser le catalogue Unity à la place.
| Modèle classique | Remplacement sans serveur | Détails |
|---|---|---|
Chemins DBFS (dbfs:/...) |
Volumes de Catalogue Unity | Présentation des volumes Unity Catalog |
| Tables Hive Metastore | Tables du catalogue Unity (ou HMS Federation) | Mettre à niveau un espace de travail Azure Databricks vers Unity Catalog |
| Informations d’identification du compte de stockage | Emplacements externes du catalogue Unity | Connectez-vous au stockage d’objets cloud à l’aide de Unity Catalog |
| JARs JDBC personnalisés | Fédération de Lakehouse | Qu’est-ce que la fédération des requêtes ? |
Avertissement
L’accès DBFS est limité sur serverless. Mettez à jour tous les dbfs:/ chemins d’accès aux volumes catalogue Unity avant de migrer. Pour plus d’informations, consultez Migrer des fichiers stockés dans DBFS.
Exemple : remplacer les chemins DBFS et les références à Hive Metastore
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
API et code
Certaines API et modèles de code ne sont pas pris en charge sur serverless. Référencez ce tableau pour voir si votre code doit être mis à jour.
| Modèle classique | Remplacement sans serveur | Détails |
|---|---|---|
API RDD (sc.parallelize, rdd.map) |
API DataFrame | Comparer Spark Connect à Spark Classic |
spark.sparkContext, sqlContext |
Utiliser spark (SparkSession) directement |
Comparer Spark Connect à Spark Classic |
Variables Hive (${var}) |
SQL DECLARE VARIABLE ou Python f-strings |
DECLARE VARIABLE |
| Configurations Spark non prises en charge | Supprimez les configurations non prises en charge. La configuration serverless ajuste automatiquement la plupart des paramètres. | Configurer les propriétés Spark pour les notebooks et les tâches sans serveur |
Exemple : remplacer les opérations RDD par des DataFrames
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Exemple : Remplacer les API SparkContext
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")
Différences de comportement SQL
Le calcul sans serveur active le mode ANSI par défaut. Databricks Runtime active le mode ANSI par défaut dans la version 17.0 et ultérieure. Si votre calcul classique exécute une version antérieure, certaines requêtes qui réussissent sur celui-ci génèrent des erreurs d’exécution sur serverless.
Genie Migrate for Serverless ajuste automatiquement le code pour le comportement du mode ANSI. Si vous migrez manuellement, examinez les opérations suivantes, qui changent le plus souvent de comportement :
| Operation | Calcul classique avec mode ANSI désactivé | Informatique sans serveur |
|---|---|---|
Transtypage non valide, comme CAST('abc' AS INT) |
Retourne NULL. |
Génère CAST_INVALID_INPUT |
| Débordement arithmétique entier | S’enroule autour. Par exemple, 2147483647 + 1 retourne -2147483648. |
Lève ARITHMETIC_OVERFLOW |
| Dépassement de capacité en arithmétique décimale | Retourne NULL. |
Génère NUMERIC_VALUE_OUT_OF_RANGE |
| Division par zéro | Retourne NULL. |
Génère DIVIDE_BY_ZERO |
| URL mal formée dans parse_url | Retourne NULL. |
Augmentations de salaire INVALID_URL |
Pour retourner NULL au lieu de générer une erreur, remplacez l’opération par son try_* équivalent, comme try_cast, try_add, try_divide ou try_parse_url. Databricks recommande cette approche plutôt que de désactiver le mode ANSI, car le mode ANSI met en lumière des problèmes de qualité des données qu’un mode silencieux NULL dissimule.
Pour ne pas utiliser le mode ANSI pour les casts, l’arithmétique et l’analyse, réglez spark.sql.ansi.enabled sur false. Le calcul serverless applique des règles ANSI aux conversions implicites lors des insertions dans les tables, quel que soit ce paramètre, car spark.sql.storeAssignmentPolicy ne peut pas être modifié sur le calcul serverless. Pour une description complète du comportement ANSI, voir conformité ANSI dans Databricks Runtime.
Bibliothèques et environnements
Vous pouvez gérer des bibliothèques et des environnements au niveau de l’espace de travail à l’aide d’environnements de base et au niveau du notebook à l’aide de l’environnement serverless du notebook.
| Modèle classique | Remplacement sans serveur | Détails |
|---|---|---|
| Scripts d’initialisation | Environnements sans serveur | Configuration de l'environnement serverless |
| Bibliothèques au niveau d'un cluster | Bibliothèques spécifiques au notebook ou d’environnement | Configuration de l'environnement serverless |
| Bibliothèques Maven/JAR | Prise en charge des tâches JAR pour les travaux ; PyPI pour les notebooks | Tâche JAR pour les jobs |
| Conteneurs Docker | Environnements serverless pour les besoins de la bibliothèque | Configuration de l'environnement serverless |
Épinglez des packages Python dans requirements.txt pour les environnements reproductibles. Consultez Spécifier les versions des packages Python.
Diffusion en continu
Les charges de travail de streaming sont prises en charge sur les infrastructures serverless, mais certains déclencheurs ne le sont pas. Mettez à jour votre code pour utiliser les déclencheurs pris en charge.
| Déclencheur Spark | Soutenu | Remarques |
|---|---|---|
Trigger.AvailableNow() |
Oui | Recommandé |
Trigger.Once() |
Oui | Cet élément est obsolète. Utilisez Trigger.AvailableNow() à la place. |
Trigger.ProcessingTime(interval) |
Non | Retourne INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED. |
Trigger.Continuous(interval) |
Non | Utiliser le mode continu des pipelines Lakeflow à la place |
Valeur par défaut (non paramétré .trigger()) |
Non | Omettre .trigger() revient à utiliser ProcessingTime("0 seconds"), ce qui n'est pas pris en charge en mode sans serveur. Toujours défini .trigger(availableNow=True) explicitement. |
Pour le streaming en continu, migrez vers les pipelines déclaratifs Spark en mode continu ou utilisez des tâches à horaire continu avec AvailableNow. Pour les sources volumineuses, définissez maxFilesPerTrigger ou maxBytesPerTrigger, pour empêcher les erreurs de mémoire insuffisante.
Exemple : Corriger les déclencheurs de streaming
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Tester vos charges de travail
- Test rapide de compatibilité : exécutez la charge de travail en calcul classique avec mode d’accès standard et Databricks Runtime 14.3 ou supérieur. Si l’exécution réussit, la charge de travail peut migrer vers serverless sans aucune modification du code.
- Comparaison A/B (recommandée pour la production) : exécutez la même charge de travail en mode classique (contrôle) et serverless (expériment). Comparer les tableaux de résultats et vérifier l'exactitude. Itérer jusqu’à ce que les sorties correspondent.
- Configurations temporaires : Vous pouvez configurer temporairement les configurations Spark prises en charge pendant les tests. Supprimez-les lorsque les conditions sont stables.
Choisir un mode de performance
Les travaux et pipelines serverless prennent en charge deux modes de performance : standard et optimisé pour les performances. Le mode de performances que vous choisissez dépend des besoins de votre charge de travail.
| Mode | Disponibilité | Jeune entreprise | Idéal pour |
|---|---|---|---|
| Norme | Travaux, pipelines Lakeflow | En général, 4 à 6 minutes | Lot sensible aux coûts |
| Optimisé pour les performances | Travaux, pipelines Lakeflow | En général moins d’une minute | Interactive, sensible à la latence |
Le mode standard consomme moins de DBU que le mode optimisé en performance, donc il coûte moins cher. Pour comparer les modes et choisir le mode d’une tâche ou d’un pipeline migré, voir Choisir un mode de performance pour les tâches et pipelines sans serveur.
Migrer en phases
- Nouvelles charges de travail : Démarrez tous les nouveaux notebooks et tâches en mode serverless.
- Charges de travail à faible risque : Migrez les charges de travail PySpark/SQL déjà en mode d’accès standard et Databricks Runtime 14.3 ou supérieur.
- Charges de travail complexes : Migrer les charges de travail nécessitant des modifications de code (réécritures RDD, mises à jour DBFS, correctifs de déclencheurs).
- Charges de travail restantes : Révisez périodiquement à mesure que les capacités s’étendent.
Superviser les coûts
La facturation serverless est basée sur la consommation DBU, et non sur le temps d’activité du cluster. Validez les attentes en matière de coûts avec les charges de travail représentatives avant de migrer à grande échelle. Pour connaître les outils et stratégies permettant de surveiller les coûts liés au serverless, voir Surveiller le coût du calcul serverless.
Ressources additionnelles
- Bonnes pratiques pour le calcul serverless : conseils d’optimisation pour les charges de travail serverless
- Limitations de calcul sans serveur : liste complète des limitations actuelles et des fonctionnalités non prises en charge
- Configurer l’environnement sans serveur: gérer les bibliothèques et les dépendances
- Configurations Spark prises en charge: configurations Spark disponibles en environnement serverless
- Spark Connect vs. Spark classique : différences comportementales dans l’architecture serverless
-
Mettre en cache les DataFrames sur le calcul serverless : mettre en cache les DataFrames avec
df.cache()etdf.persist() - Sécurité réseau sans serveur : NCC, Private Link et configuration du pare-feu
- Notes de version du calcul sans serveur : Suivez les nouvelles capacités au fur et à mesure de leur livraison
- Guide de mise à niveau d’Unity Catalog : Migrer de Hive Metastore vers Unity Catalog
Vous pouvez également consulter les billets de blog suivants pour plus d’informations :
- Qu’est-ce que l’informatique serverless ? : Aperçu des capacités serverless et des résultats clients
- Évolution de l’ingénierie des données : comment l’informatique serverless transforme les notebooks et les jobs Lakeflow : comment le serverless alimente les jobs et pipelines Lakeflow